

从ChatBot到具身Agent:AI下一代交互入口
纯文本Agent因缺乏在场感与主动引导,在门店、展厅等场景存在天花板。具身Agent通过实时驱动数字人,融合语音、表情和动作,将认知与表达链路打通,降低用户互动门槛,更适合复杂产品讲解与导购场景。
魔珐星云与具身Agent:突破纯文本聊天框的智能交互新范式
最近在研究魔珐星云,原本只是想看看官网、调一下SDK,顺手做个Demo。结果看着看着,问题方向就变了——为什么现在很多Agent明明已经很聪明了,但看起来还是那个聊天框?
过去一年,大家做Agent的方式已经形成固定套路:LLM接知识库,接工具调用,接工作流,最后放进一个输入框。写代码、查资料、整理内容,它确实好用。但一旦放到门店、展厅、客服、培训这类需要"接待感"的场景里,纯文本Agent就显得有点尴尬——用户不一定想主动输入问题。
所以这篇文章要聊的不是数字人好不好看,而是另一个问题:纯文本Agent的天花板在哪里?具身Agent为什么可能成为下一代交互入口?更准确地说,它能不能把理解、回答、表达和互动连成一个更自然的交互过程?
魔珐星云:可实时交互的AI智能具身数字人平台
先打开魔珐星云官网:https://xingyun3d.com
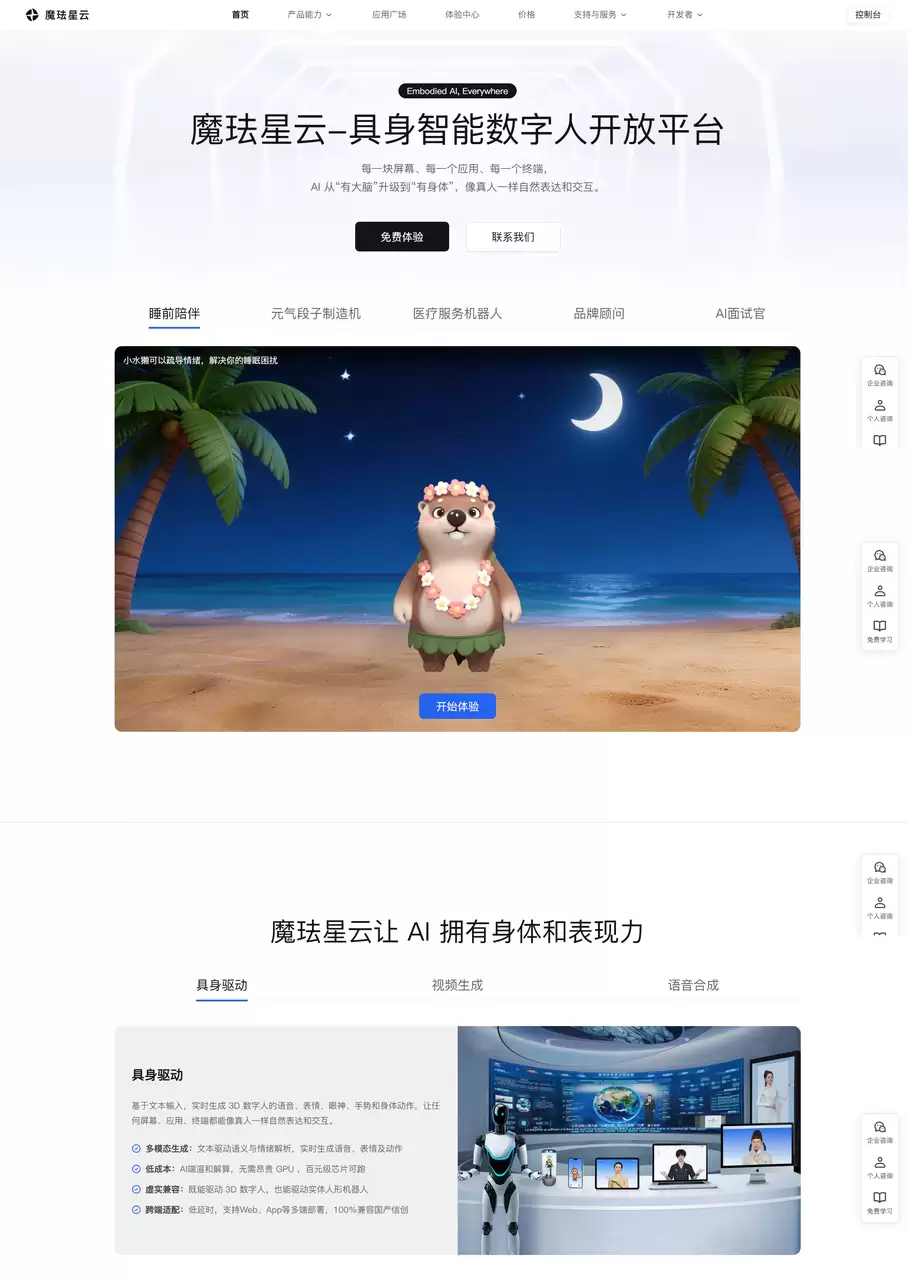
不是单纯让数字人念稿,也不是做一段虚拟人视频就结束。首页下面放的"睡前陪伴"、"医疗服务机器人"、"品牌顾问"、"AI面试官"这些场景,都有一个共同点——需要实时回应,而不是单向播放。
所以后来关注的重点也变了。
不再只关心数字人好不好看,而是开始看它能不能被实时驱动。能不能接文本Agent,能不能根据回答生成语音、表情和动作,能不能让AI从屏幕里的回复框变成屏幕里的交互对象。
这才是这次真正要展开的地方。
纯文本Agent的局限:不是不会回答,是没有在场感
以前也觉得,只要Prompt写得好,Agent就能更像人。比如让它语气温柔一点,少说官话。短期看确实有效,但这只是文字层面的拟人。
真正的人机交互,不只靠文字。你去买东西,店员说"这个款比较适合日常通勤",这句话本身很普通。但他什么时候说、语气是不是肯定、手是不是指向商品、有没有看着你——这些都会影响你愿不愿意继续听。文本Agent没有这些东西。它只能输出句子,最多加几个emoji,或者用括号写个"(微笑)"。
所以纯文本Agent的天花板,主要在于三个维度。
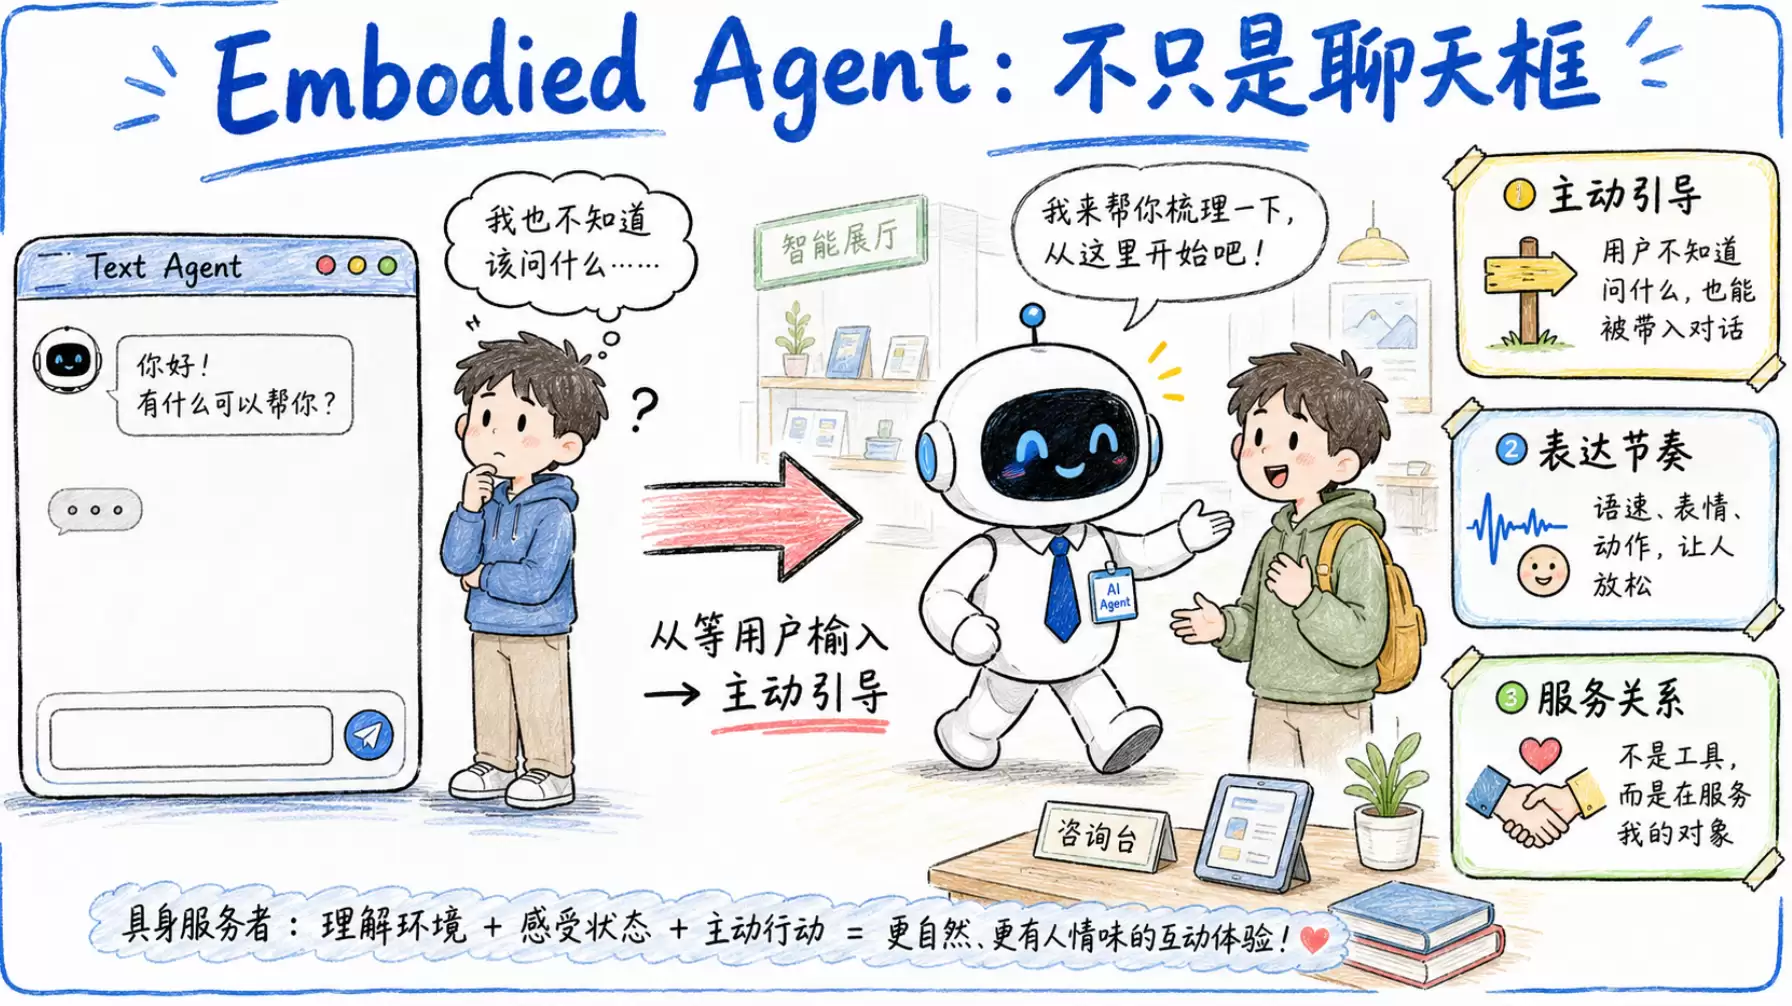
第一,它很难主动出现。聊天框永远在等用户输入,默认用户已经知道自己要问什么。但现实里,很多用户并不知道自己要问什么。门店导购、展厅讲解、医疗咨询、课程辅导——都需要先被引导,而不是被丢给一个输入框。
第二,它没有真正的表达节奏。LLM可以写出"我理解你的困扰",但如果只是文字,力量有限。真正让人放松的,可能是语速慢一点、表情自然一点、动作别太夸张、回答前停半秒。
第三,它很难建立服务关系。文本Agent更像工具,具身Agent更像一个正在服务你的对象。这个差别会影响用户是否停留、是否继续问、是否进入下一步咨询。转化很多时候不是从答案开始的,而是从"我愿意继续聊一下"开始的。
魔珐星云控制台:不是在生成视频,而是在驱动角色
看完官网以后,点进魔珐星云平台里的具身驱动体验页,直接就看到了中间的数字人角色。它可以切换不同角色——比如睡前陪伴、AI男友、金融客服、傲娇女友;也能配置角色类型、语种、人物介绍、音色、AI动作生成开关、ASR模型和大语言模型选项。
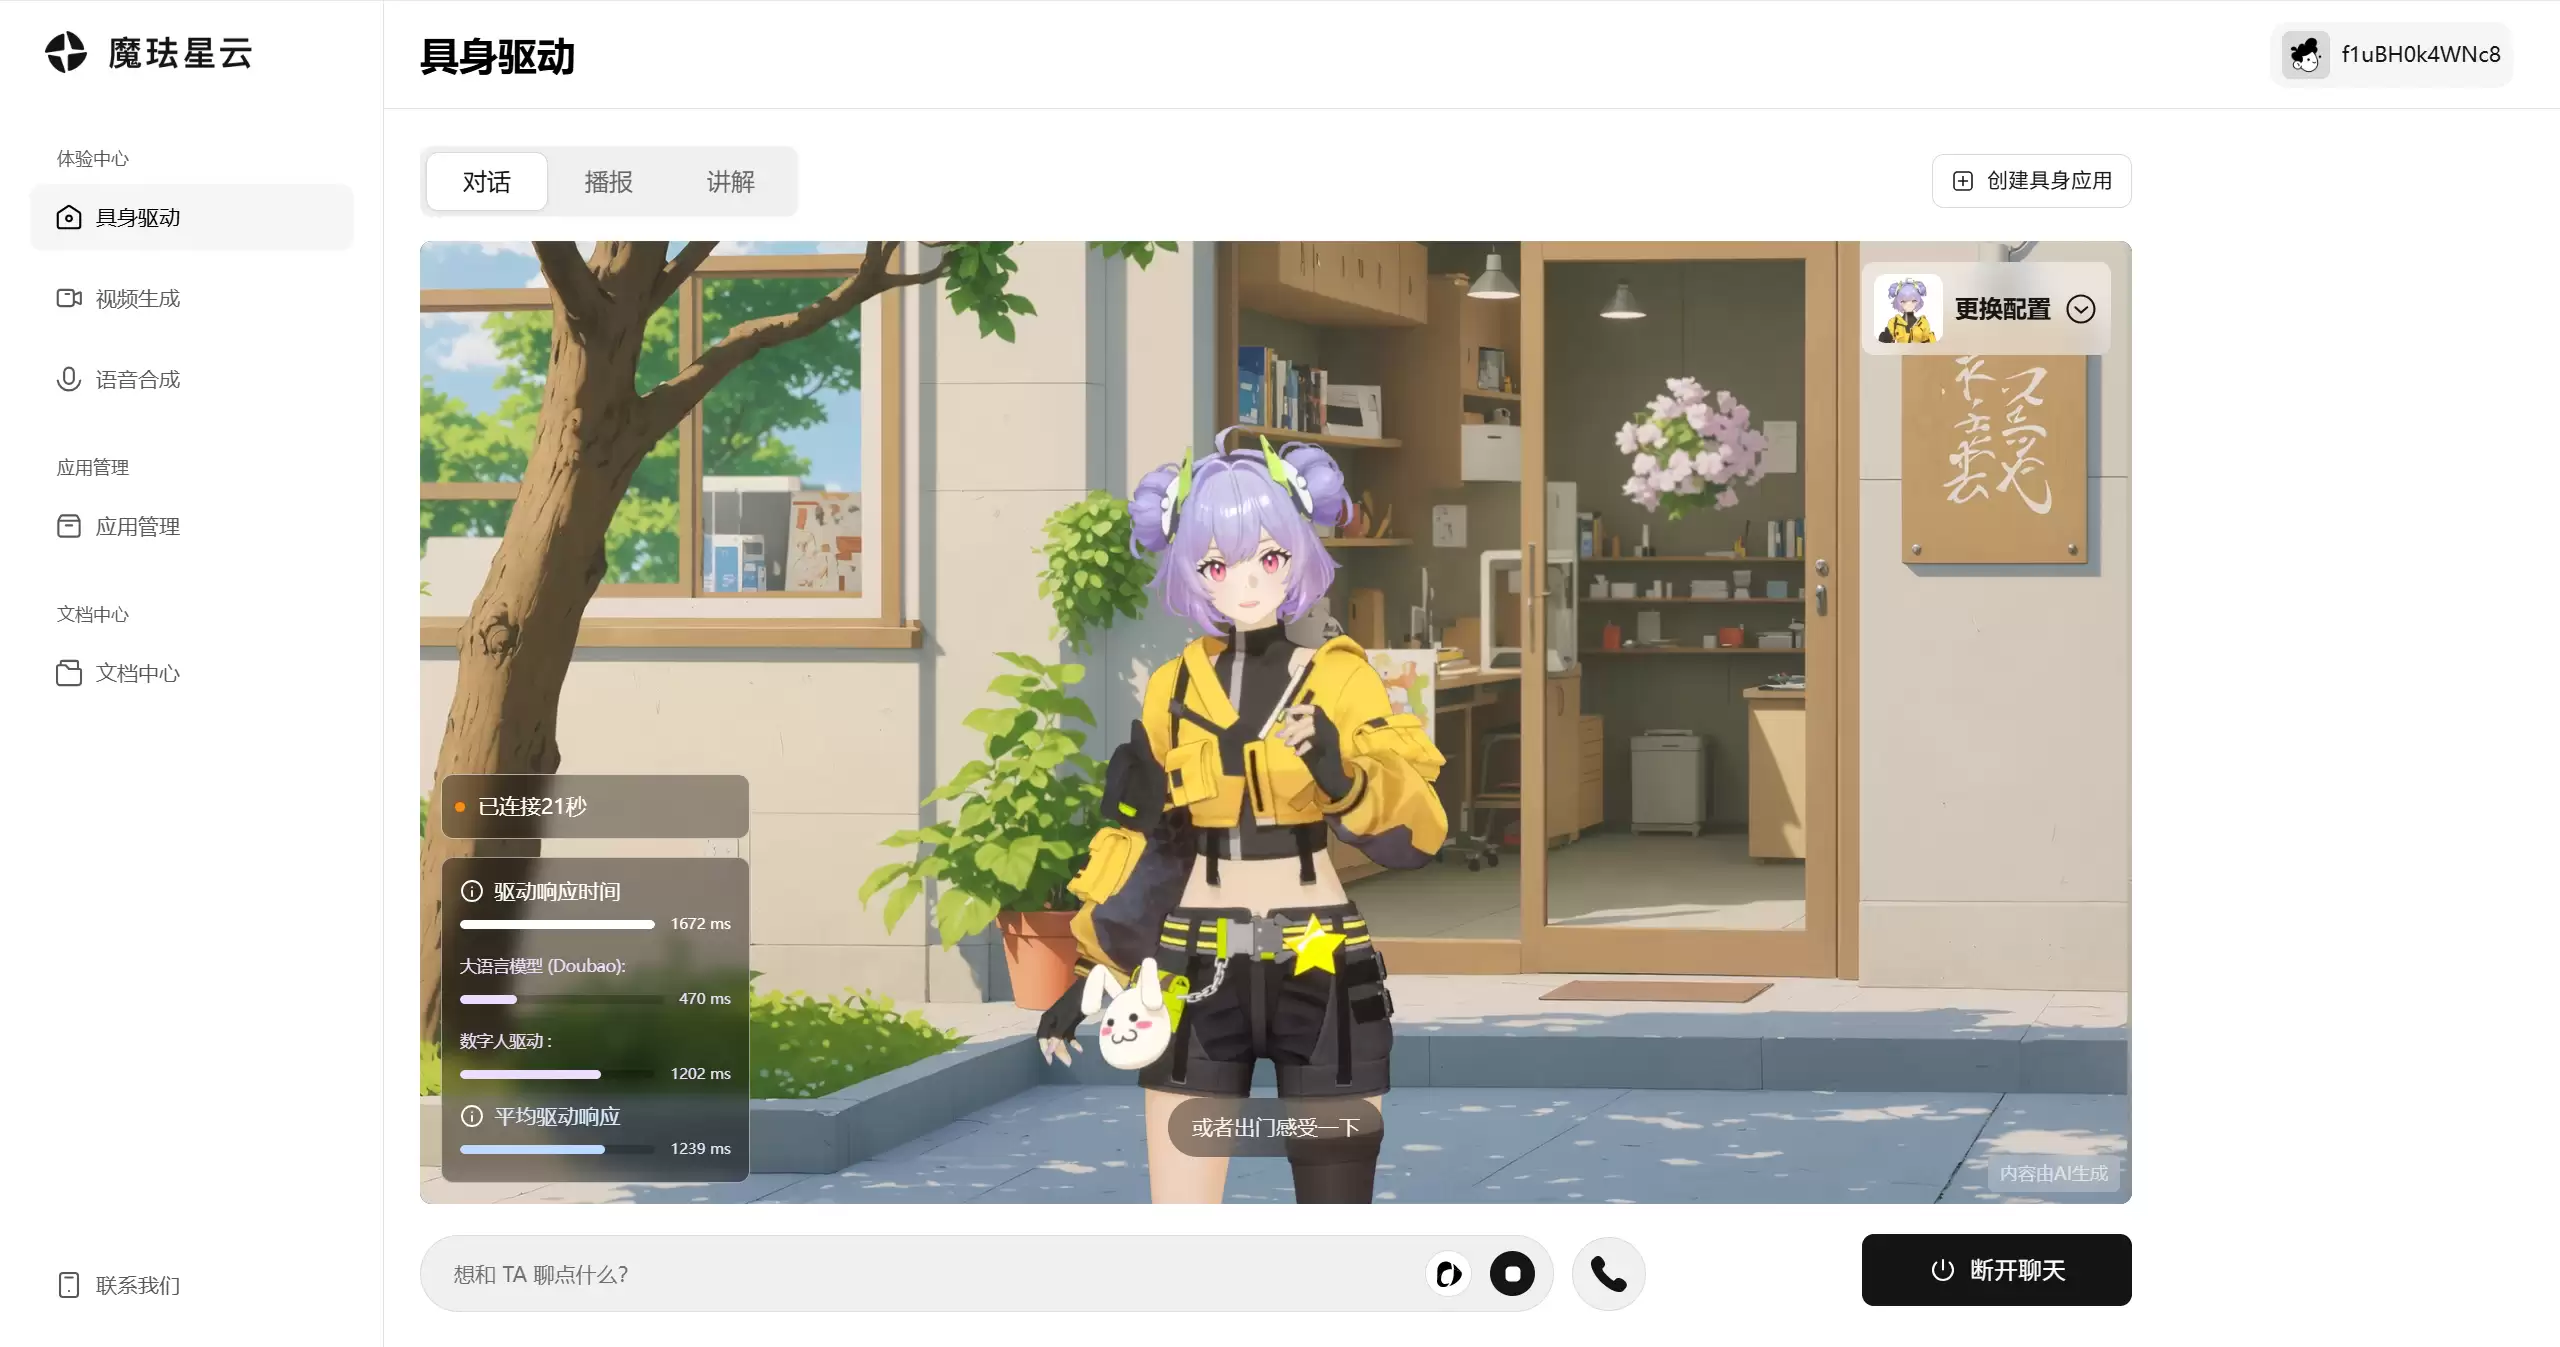
这个页面给人的第一感觉是,它更像一个"角色控制台",而不是视频生成器。视频生成工具通常关心脚本、时长、画面和导出;但魔珐星云这个页面更关心角色怎么被驱动、语音怎么表达、动作怎么生成、对话模型怎么接入,以及用户什么时候可以开始聊天。方向完全不同。
选了"元气段子手"试了一下,这个角色有点二次元,也有点夸张,但它至少不是空白框。你还没输入,它已经站在那里了。哪怕还没说话,屏幕中心已经被一个形象占据住了。
一个输入框是在等你使用,一个数字人是在等你交流。
文档核心关键词:实时驱动
官方文档主要看了两块:一是具身驱动SDK接入说明,另一个是具身驱动KA查询接口使用说明。前者更偏前端接入,后者更偏接口鉴权和服务调用。
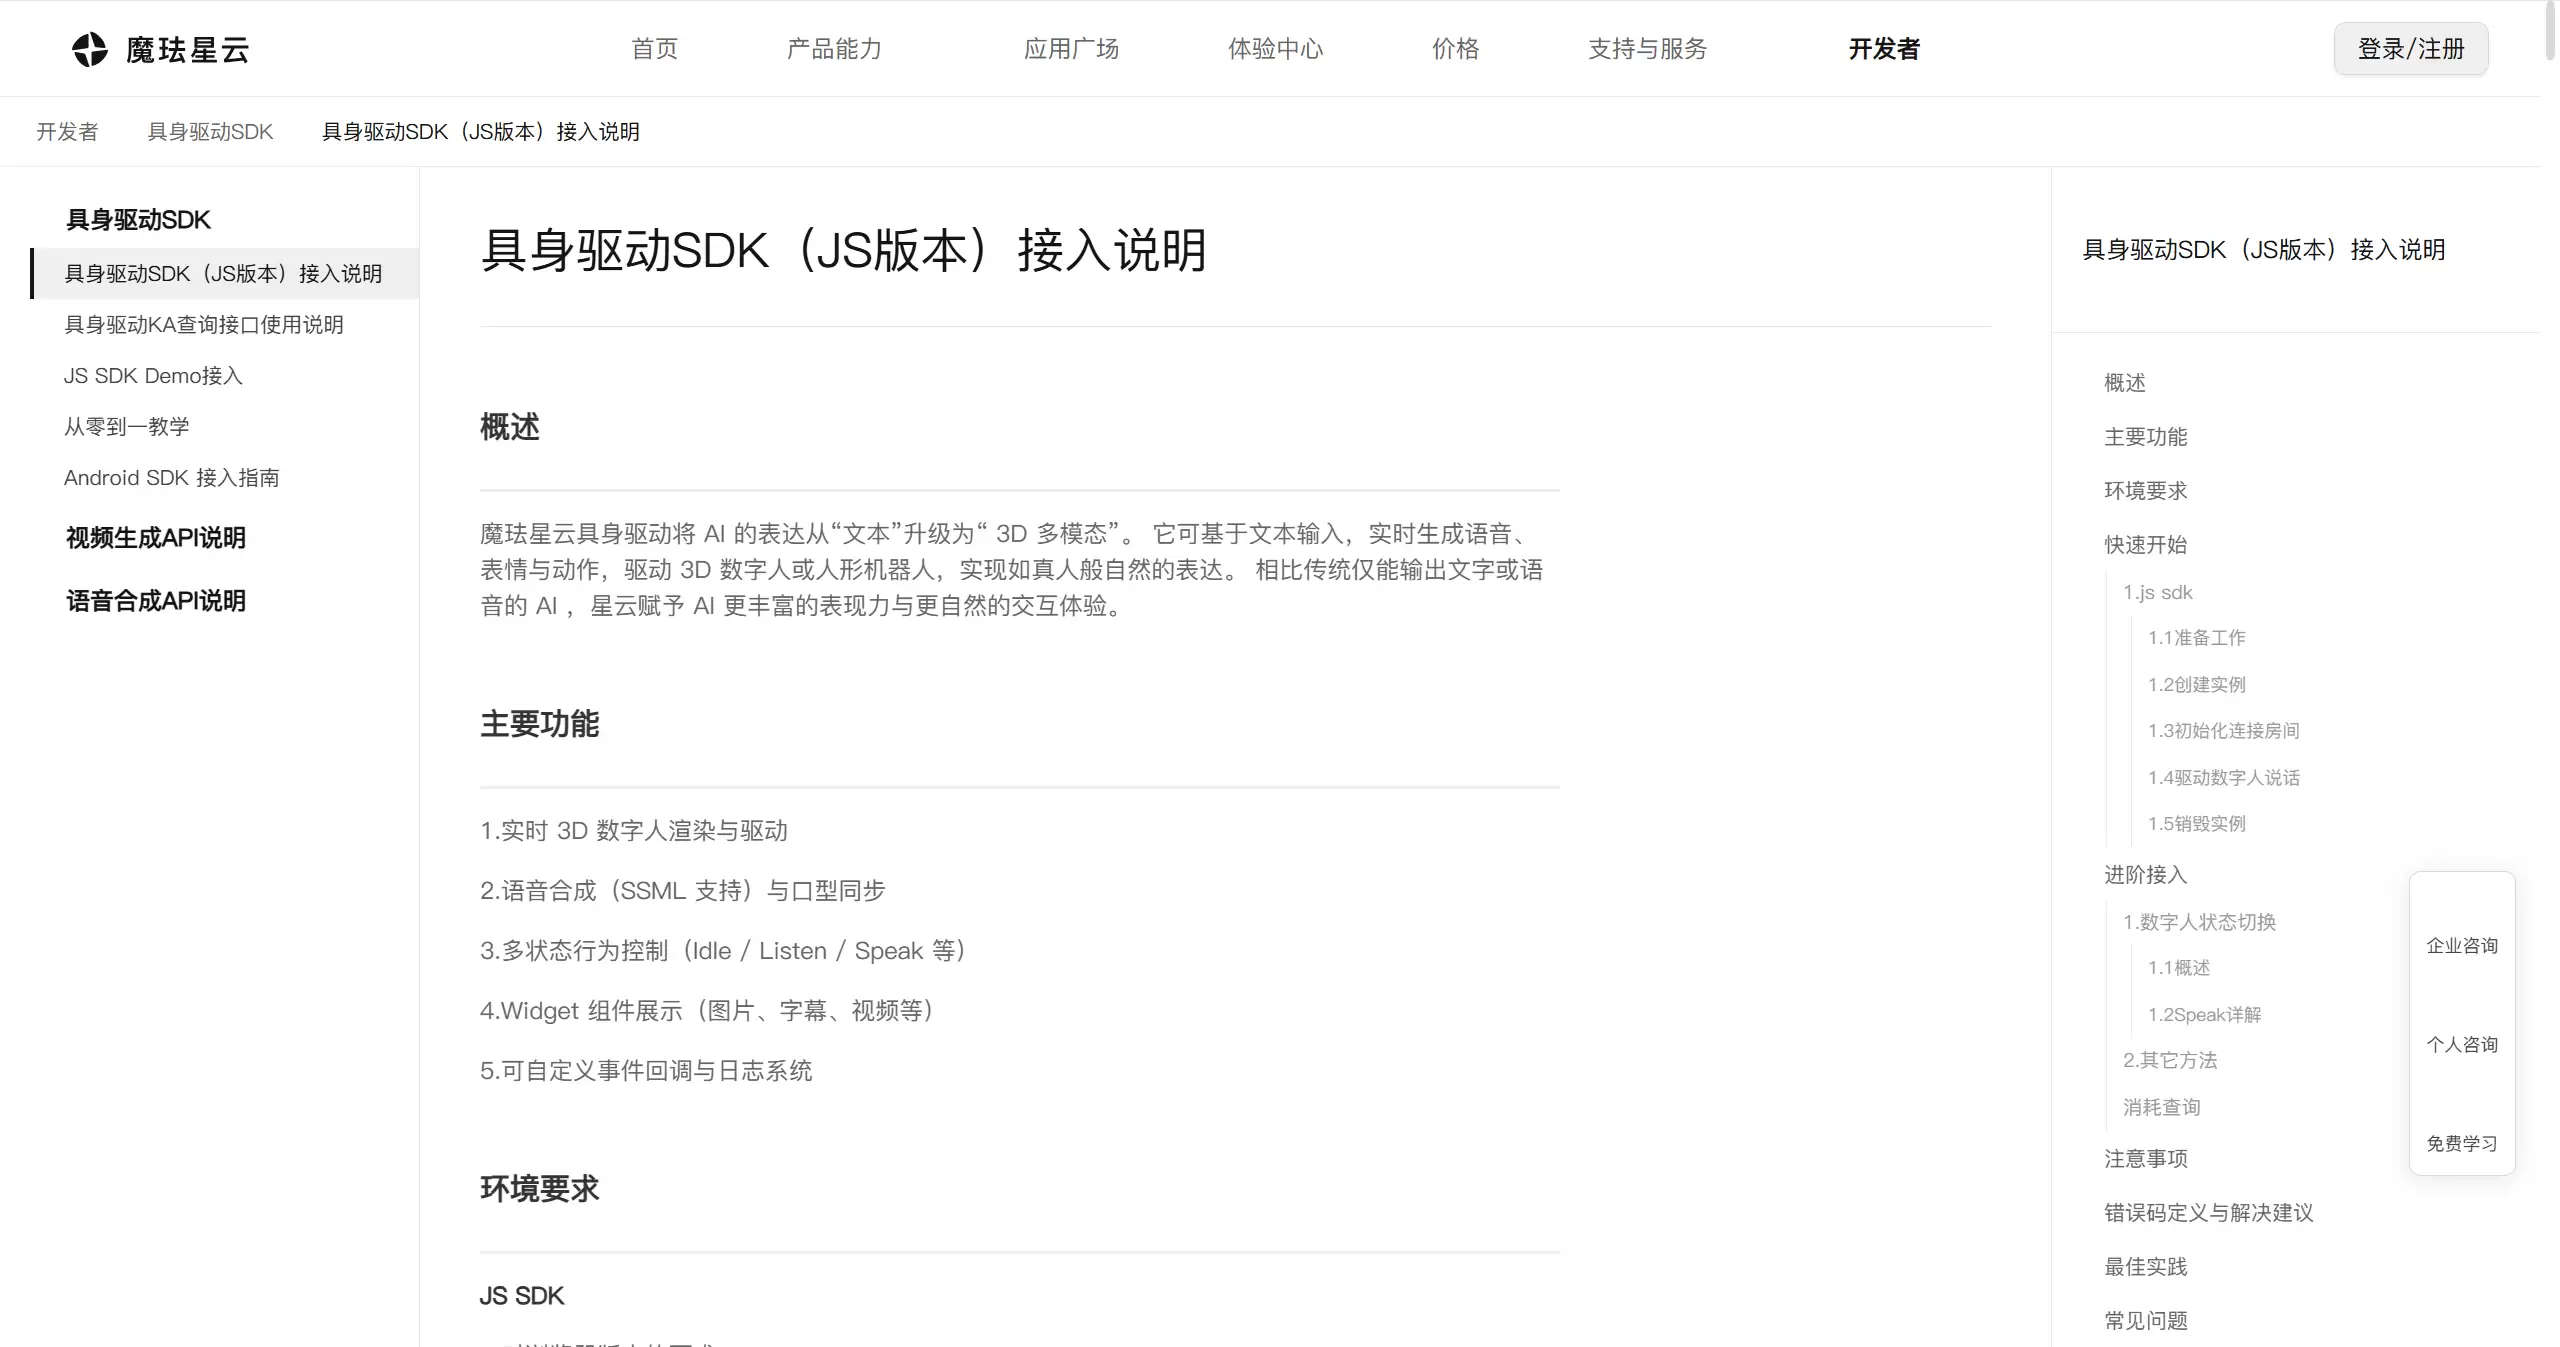
这里最关键的词不是数字人,而是"驱动"。文档里写到它可以做实时3D数字人渲染与驱动、语音合成和口型同步,还支持Idle/Listen/Speak这类状态控制。这说明它不是单纯生成一段数字人视频,而是让数字人能根据输入进入不同状态:等待、倾听、思考、说话。
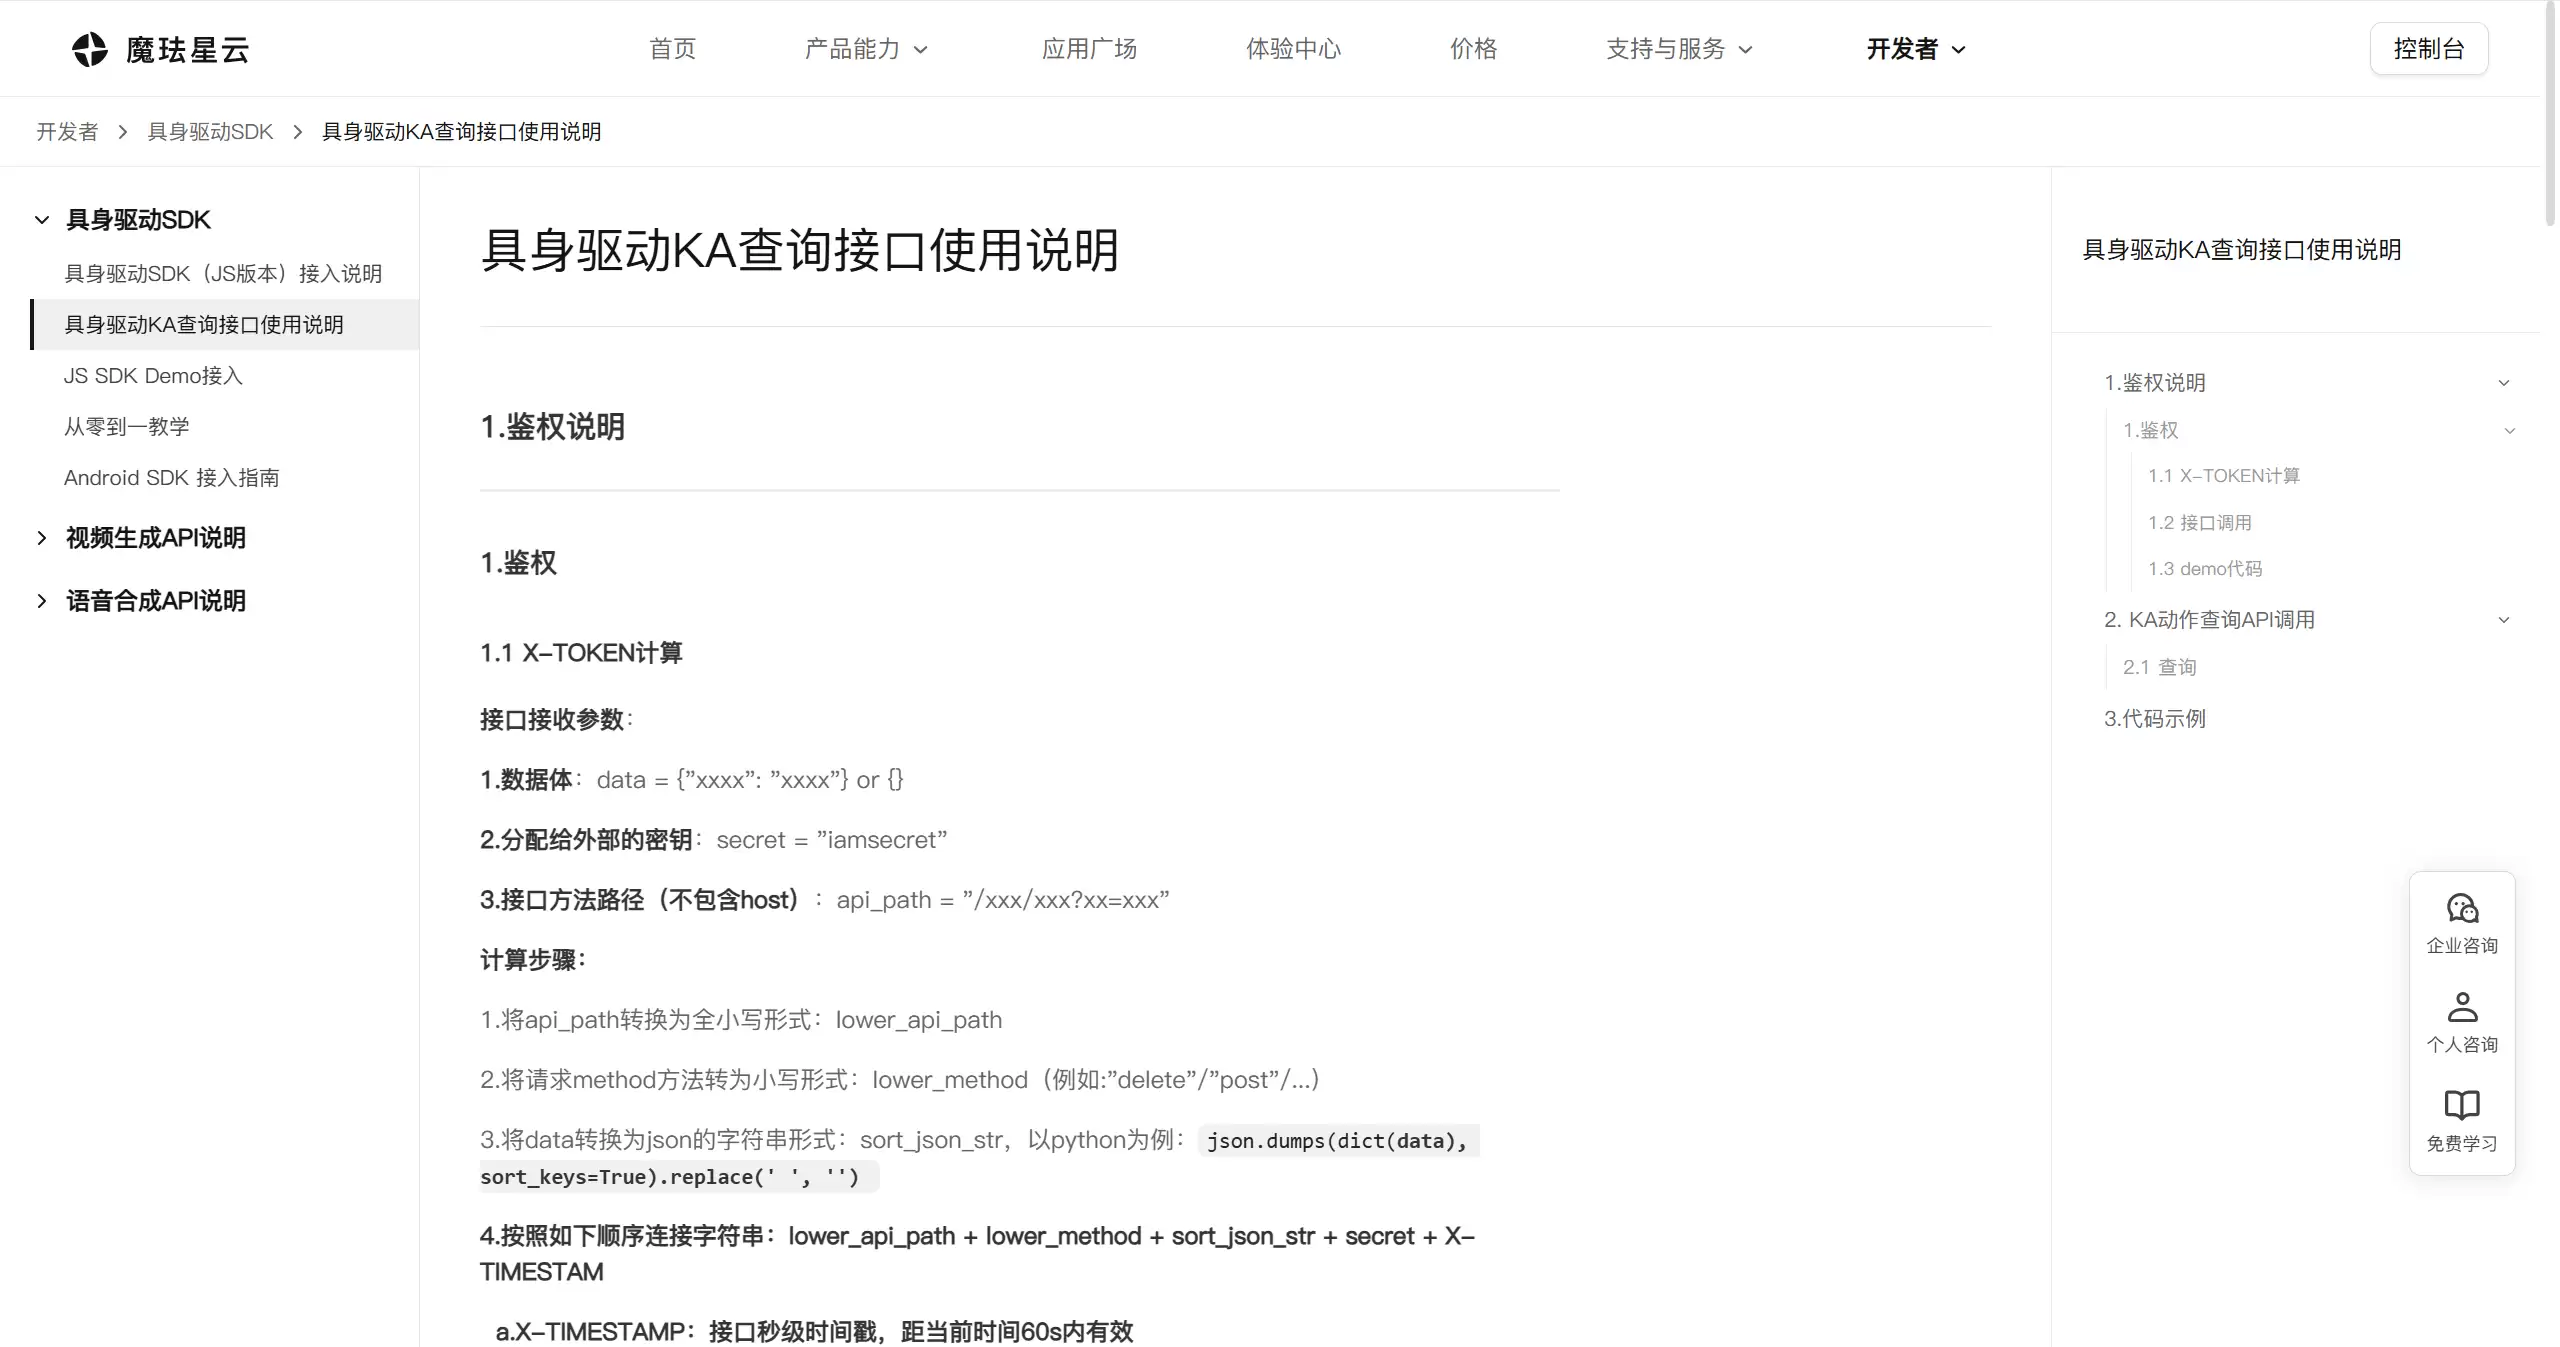
更关键的是,具身Agent不是先生成一段内容,再慢慢播放,而是要尽量把识别、理解、生成、播报和动作反馈压缩在一次连续交互里。如果端到端响应能做到约500ms,用户感受到的就不是在等一个系统处理请求,而是在和屏幕里的角色实时对话。
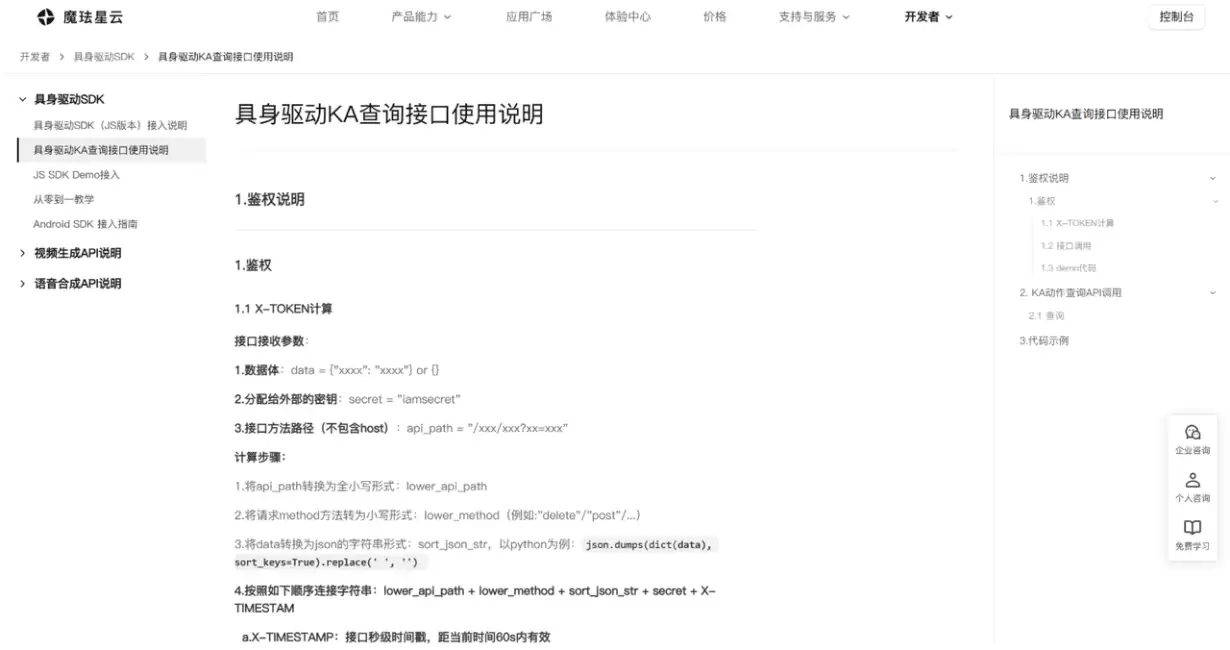
另一个KA查询接口文档则更偏工程化,里面有鉴权说明、X-TOKEN计算、接口调用和Demo代码。这个部分和前面的SDK放在一起看,基本能看出接入思路:前端负责数字人的展示和状态驱动,接口侧负责查询、鉴权和业务能力调用。
判断它是不是适合做具身Agent,主要看这三点:能不能实时驱动,口型和语音能不能同步,状态能不能控制。如果只是TTS+一个数字人形象,很多工具都能做;但如果能把文本回答变成语音、口型、表情、动作和状态切换,那它就更接近一个可以被实时控制、可落地实现的具身智能Agent,而不是一段被动播放的内容。
从零到一接入:先让数字人出现
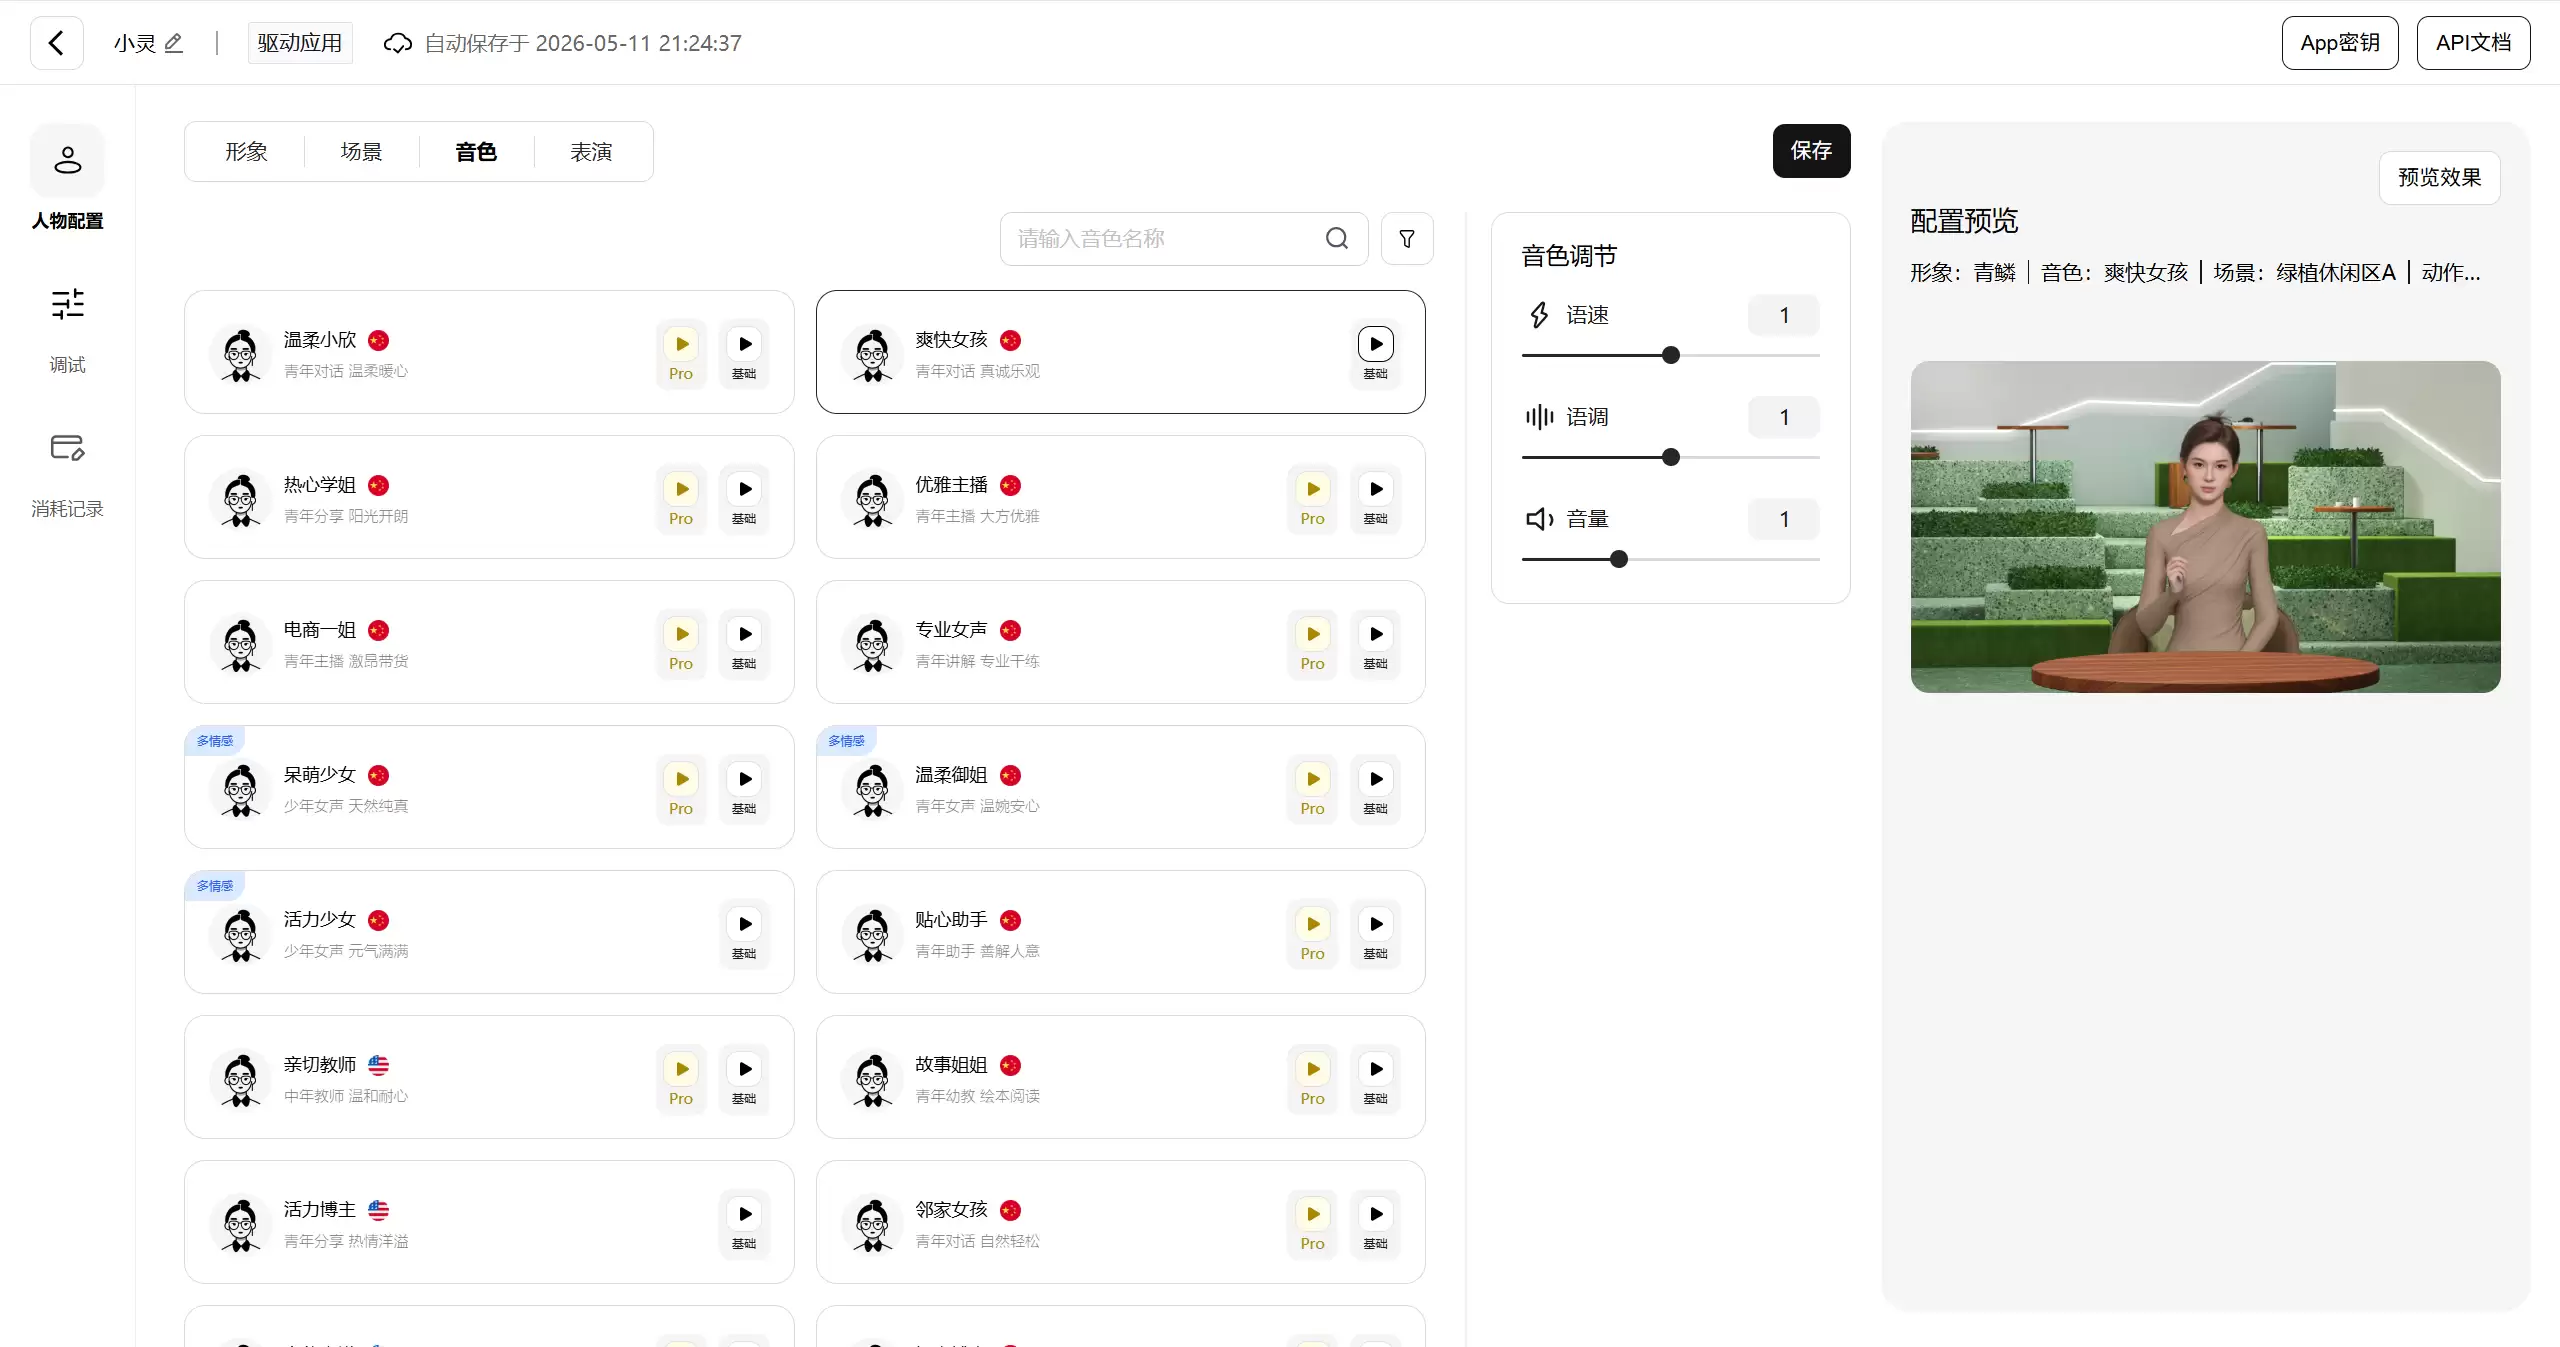
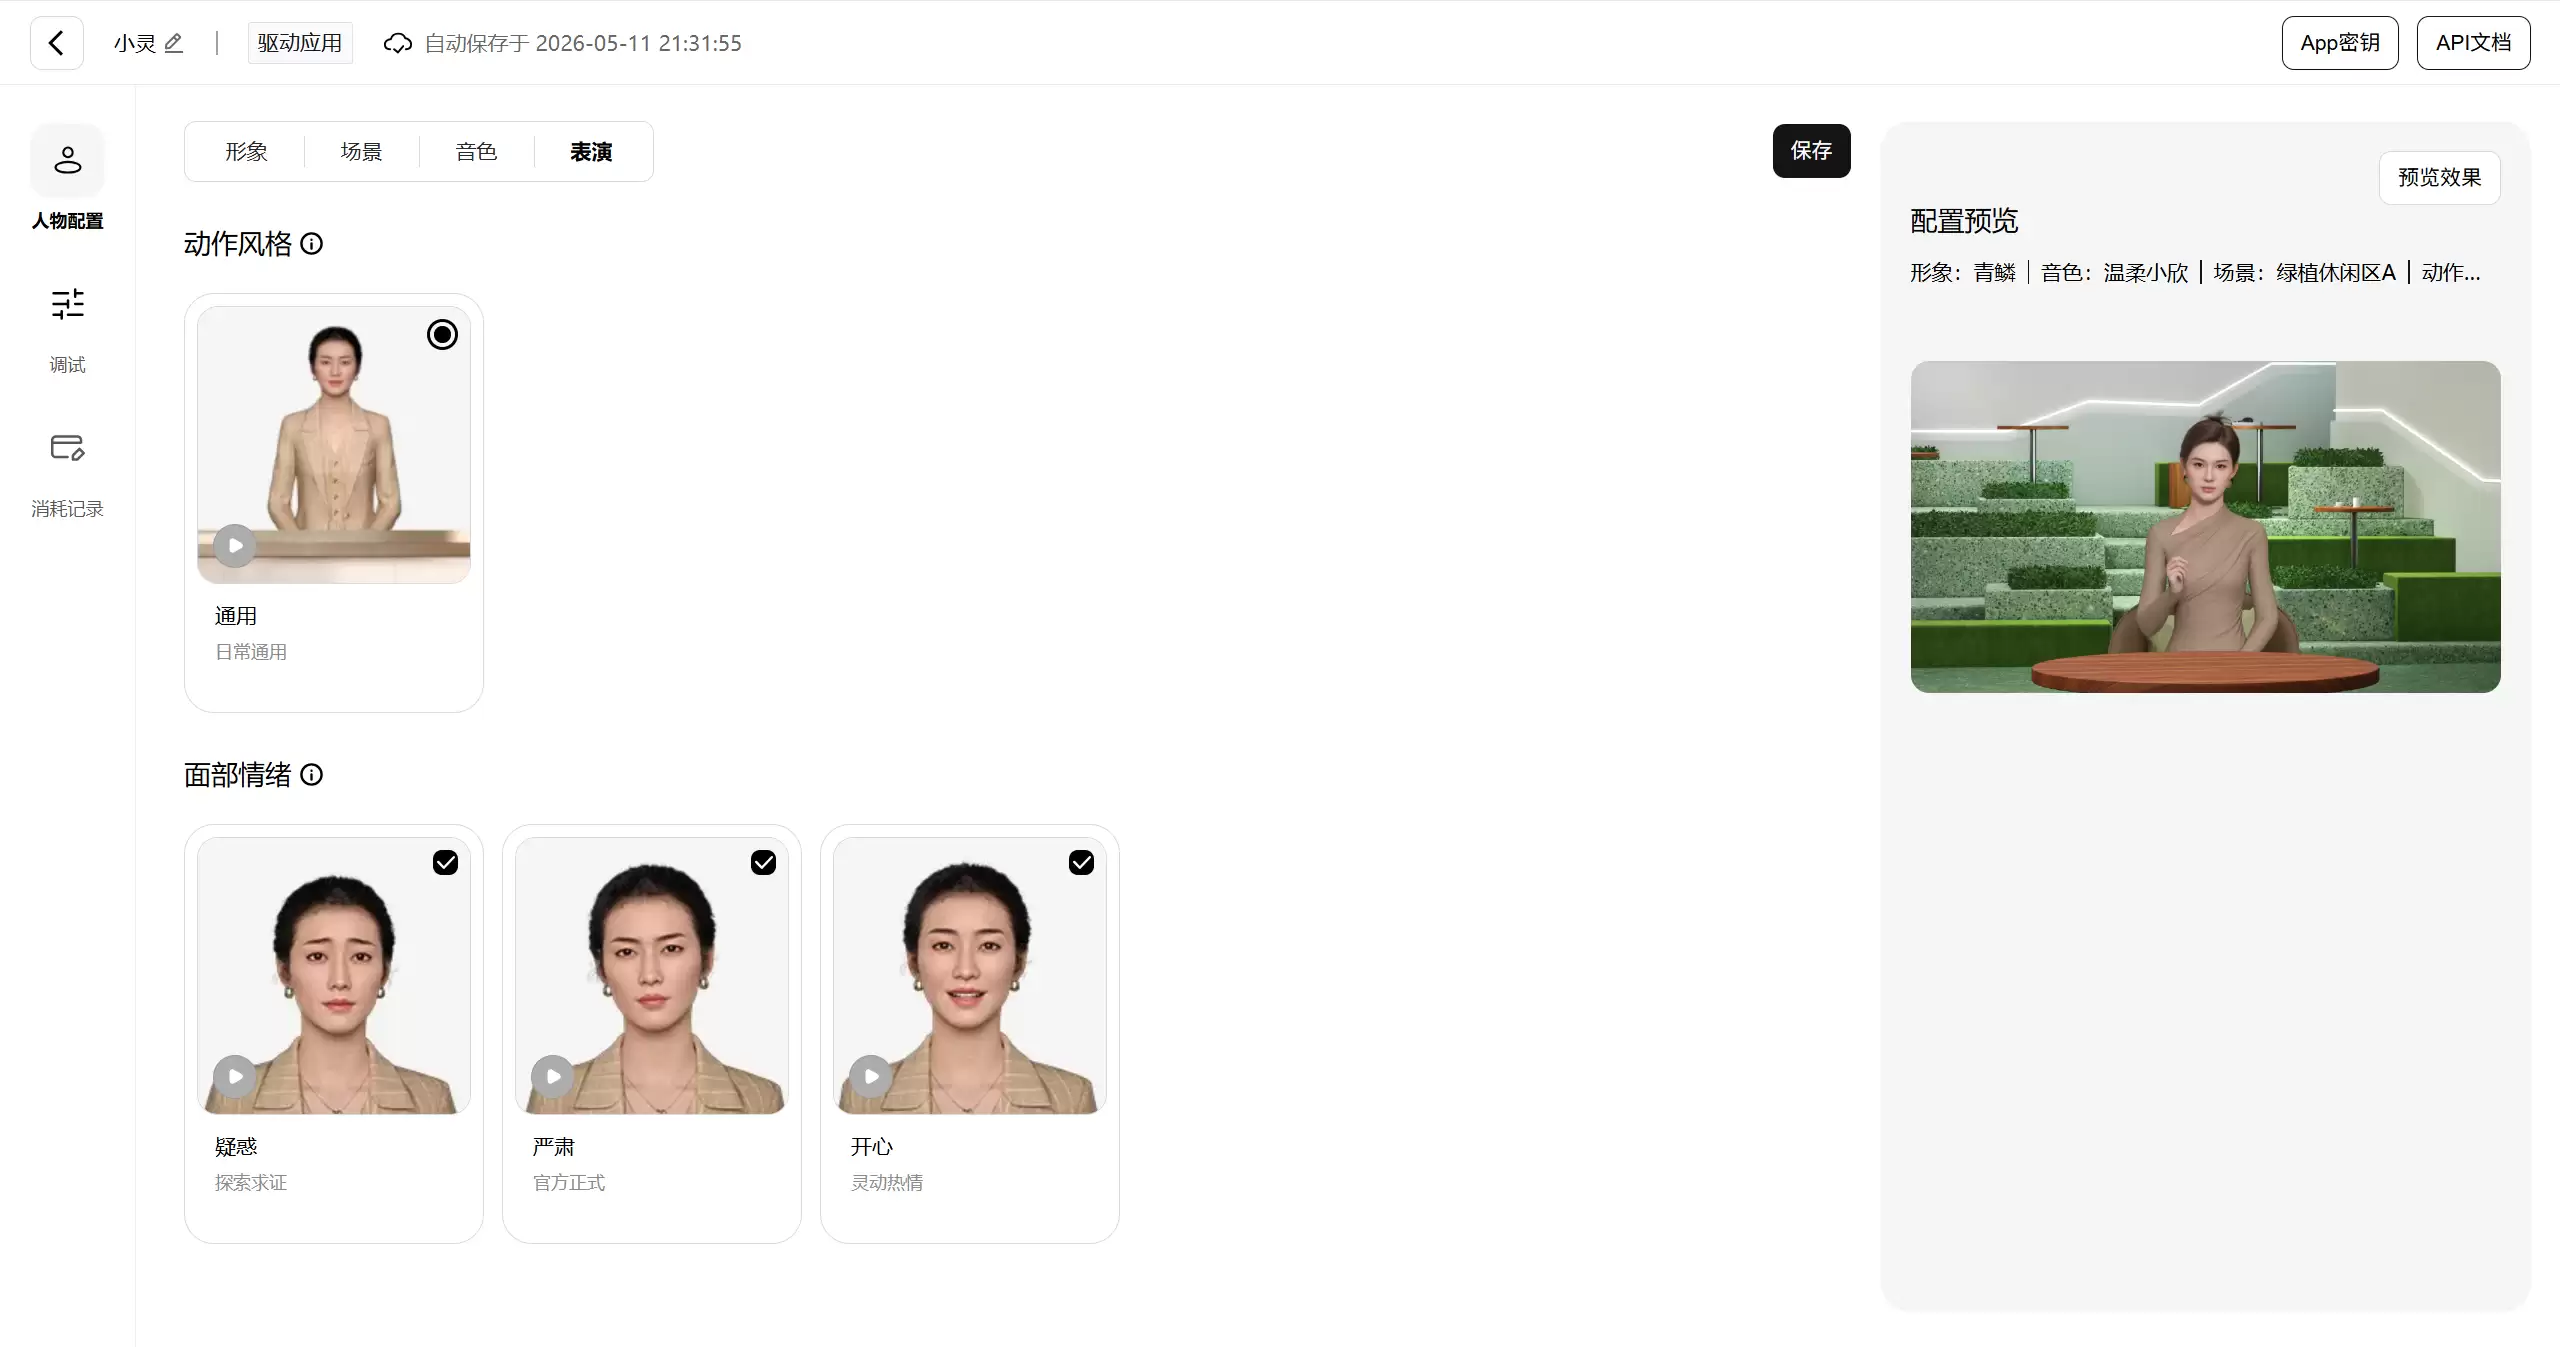
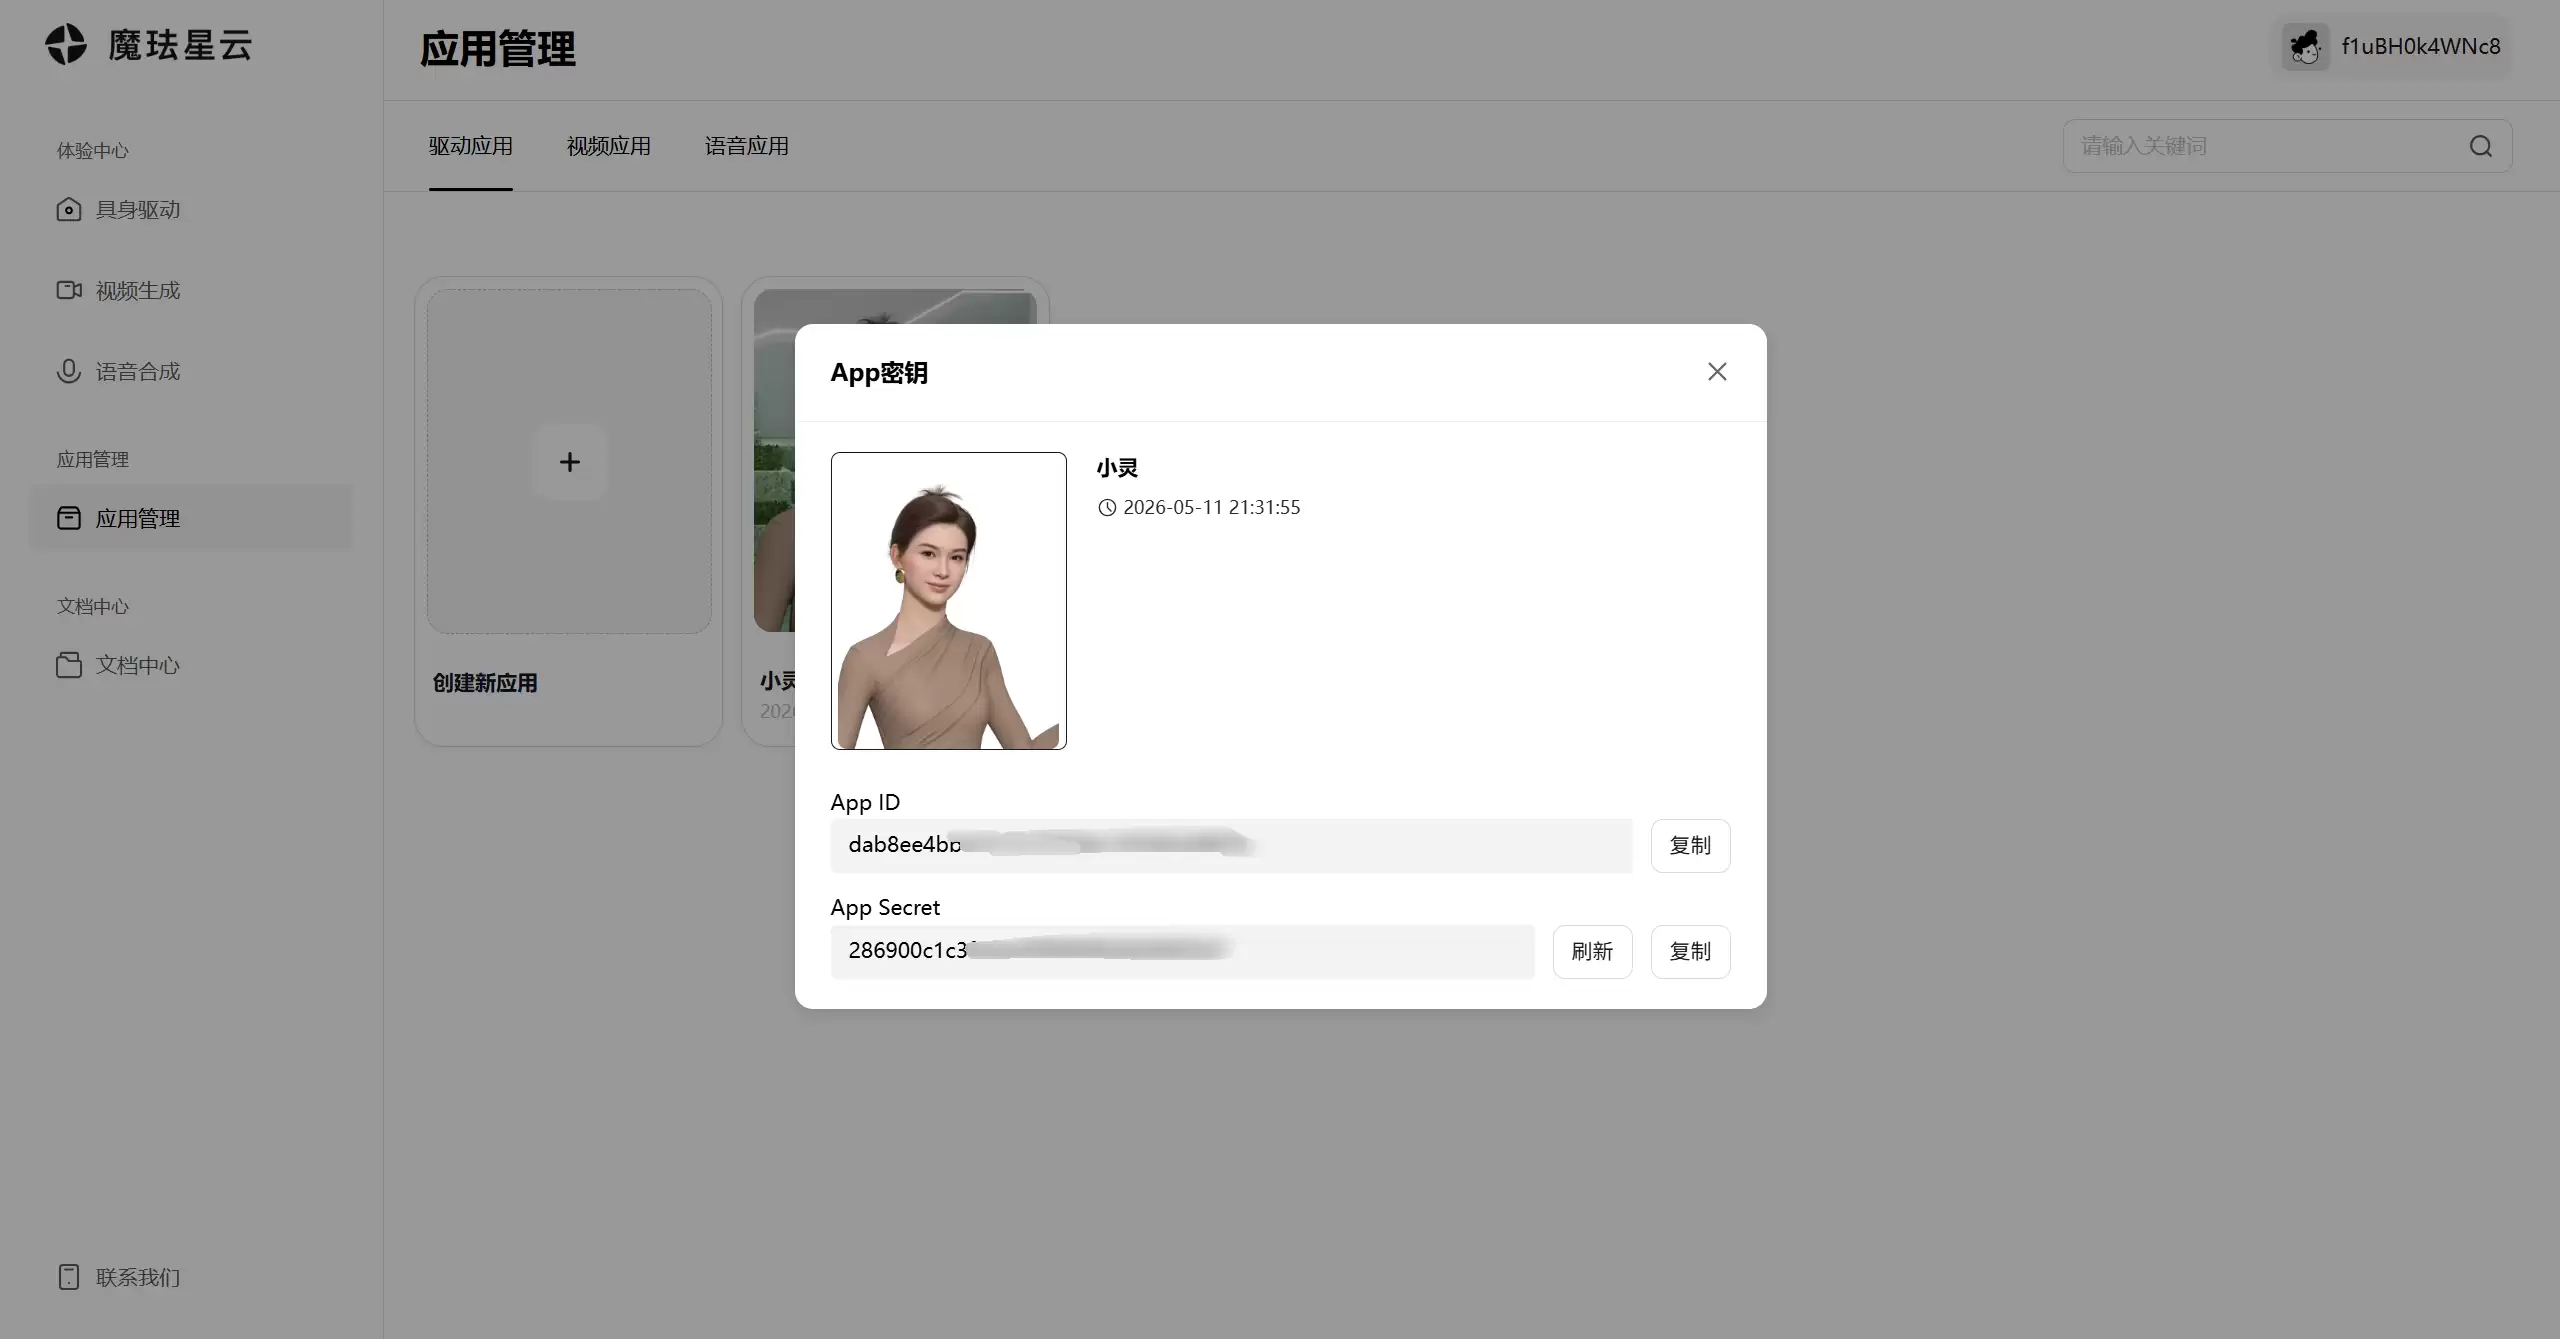
接入前需要先在控制台创建应用,拿到AppID和AppSecret,再配置数字人形象、场景、音色、表演等信息。这个流程和接其他云服务差不多:创建应用,拿密钥,初始化SDK。
创建应用并进行形象、场景、音色、表演的配置
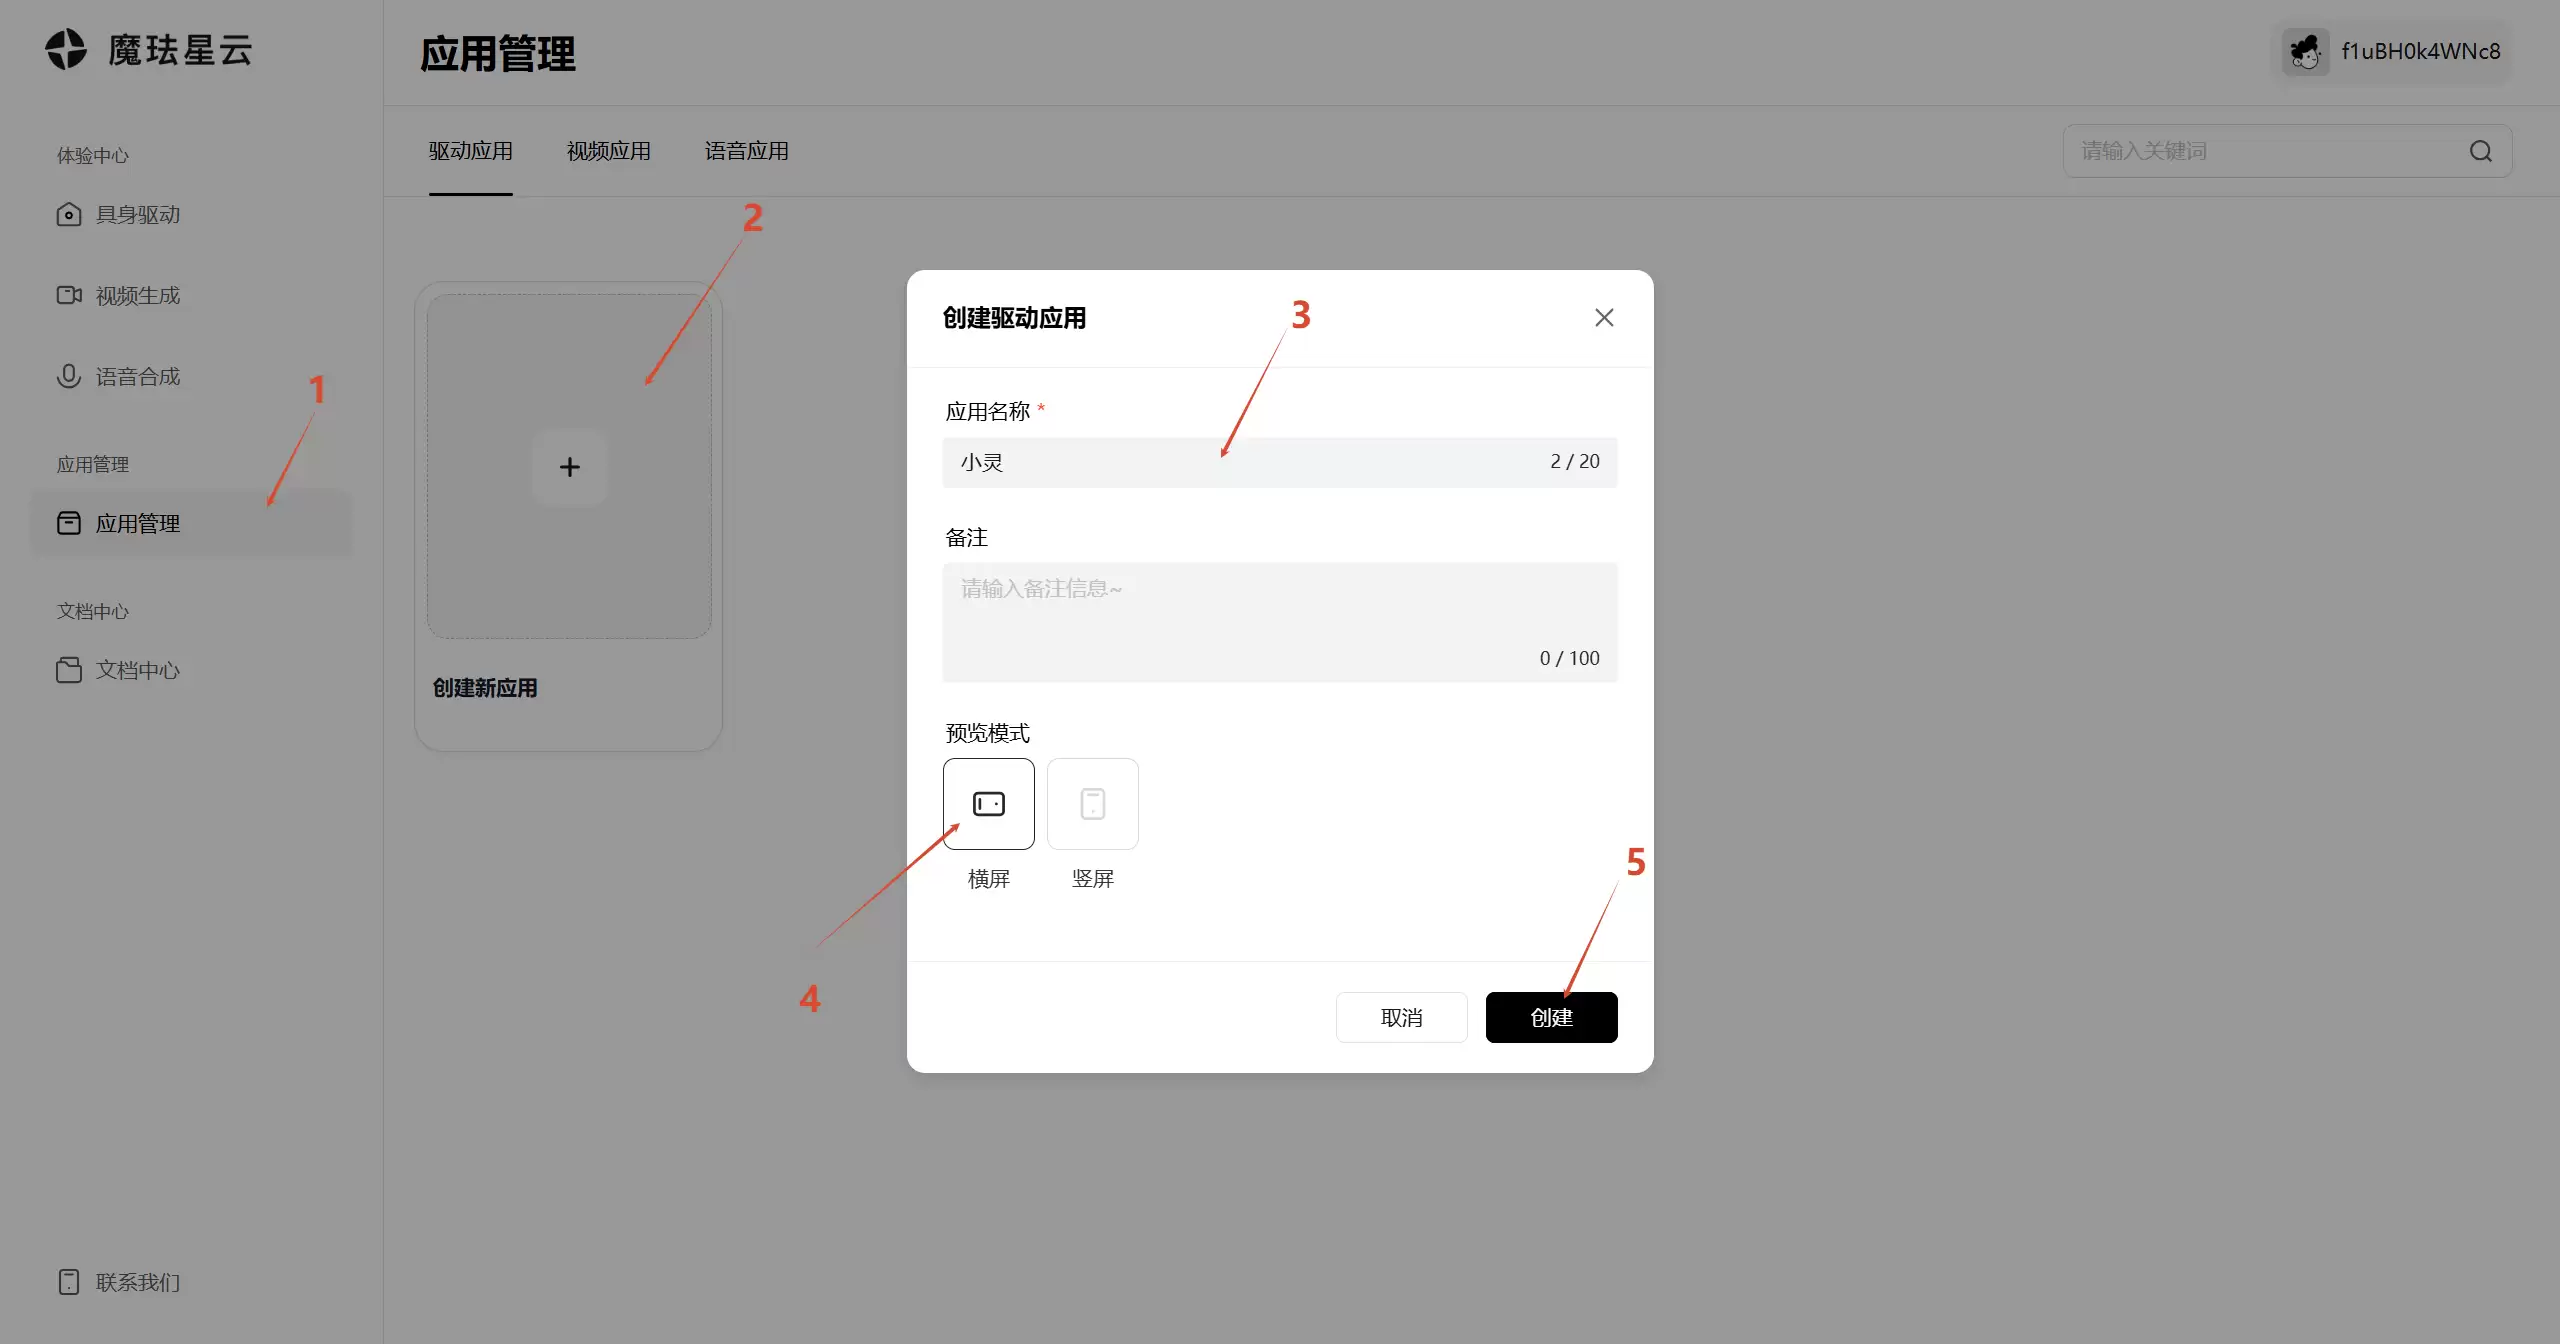
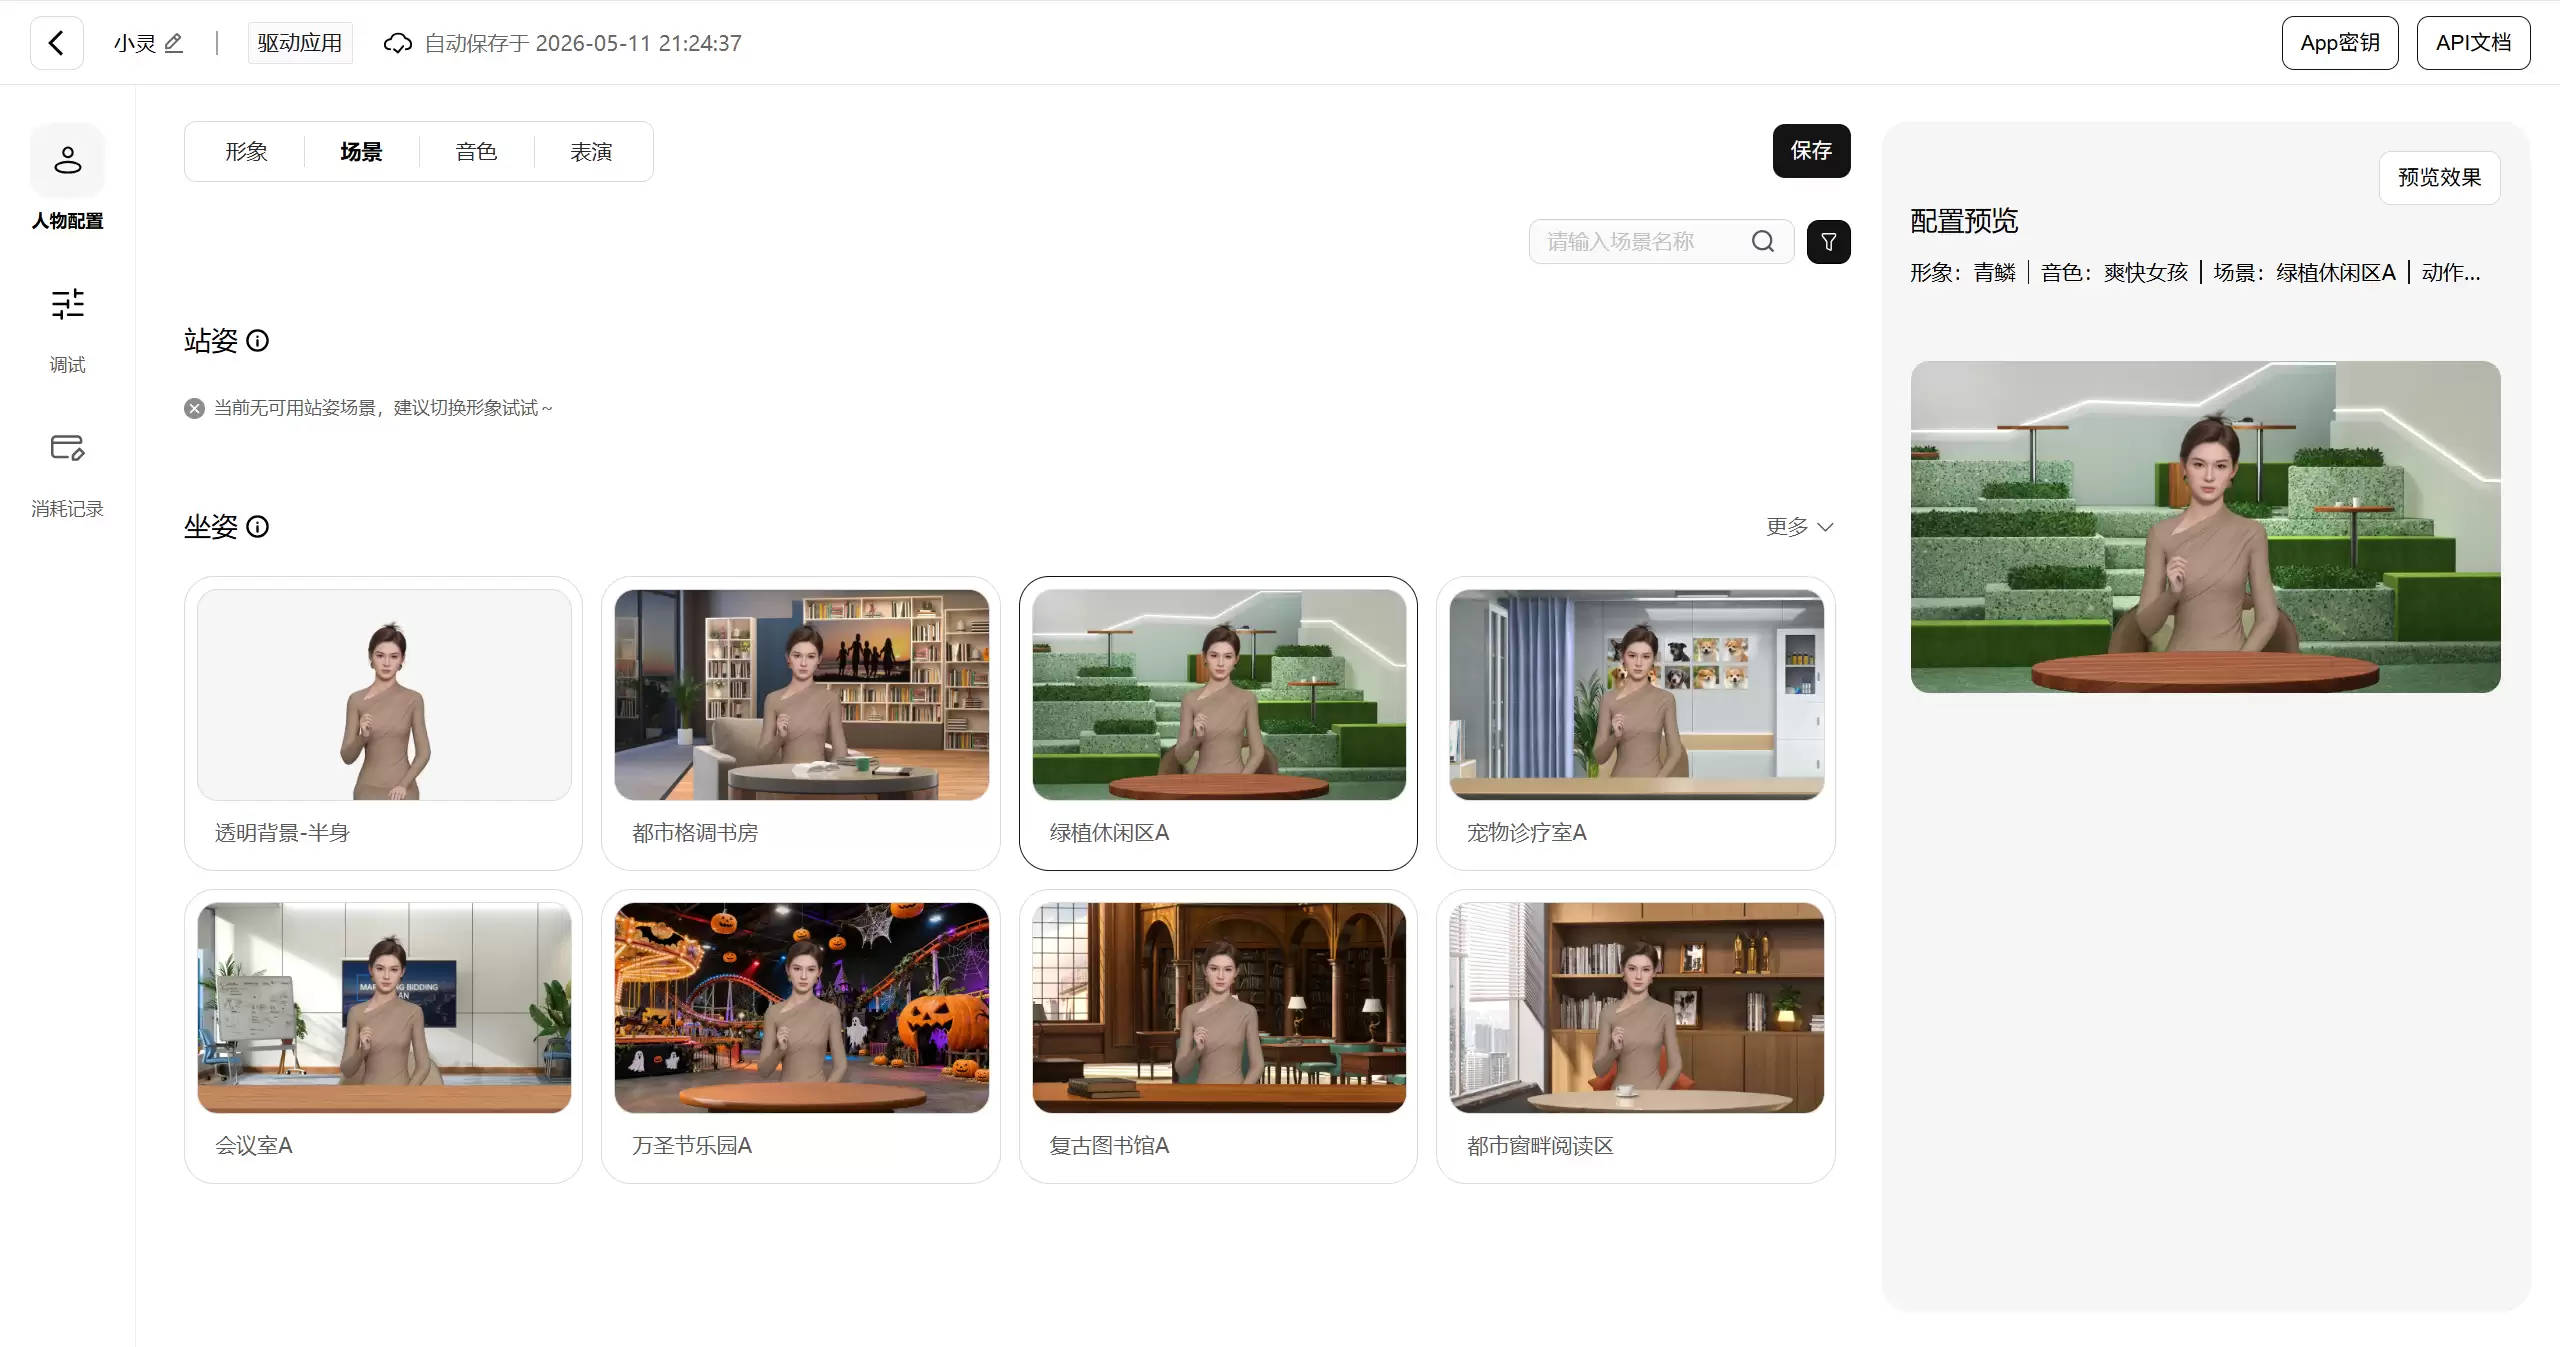
完成配置后获取App ID和App Secret
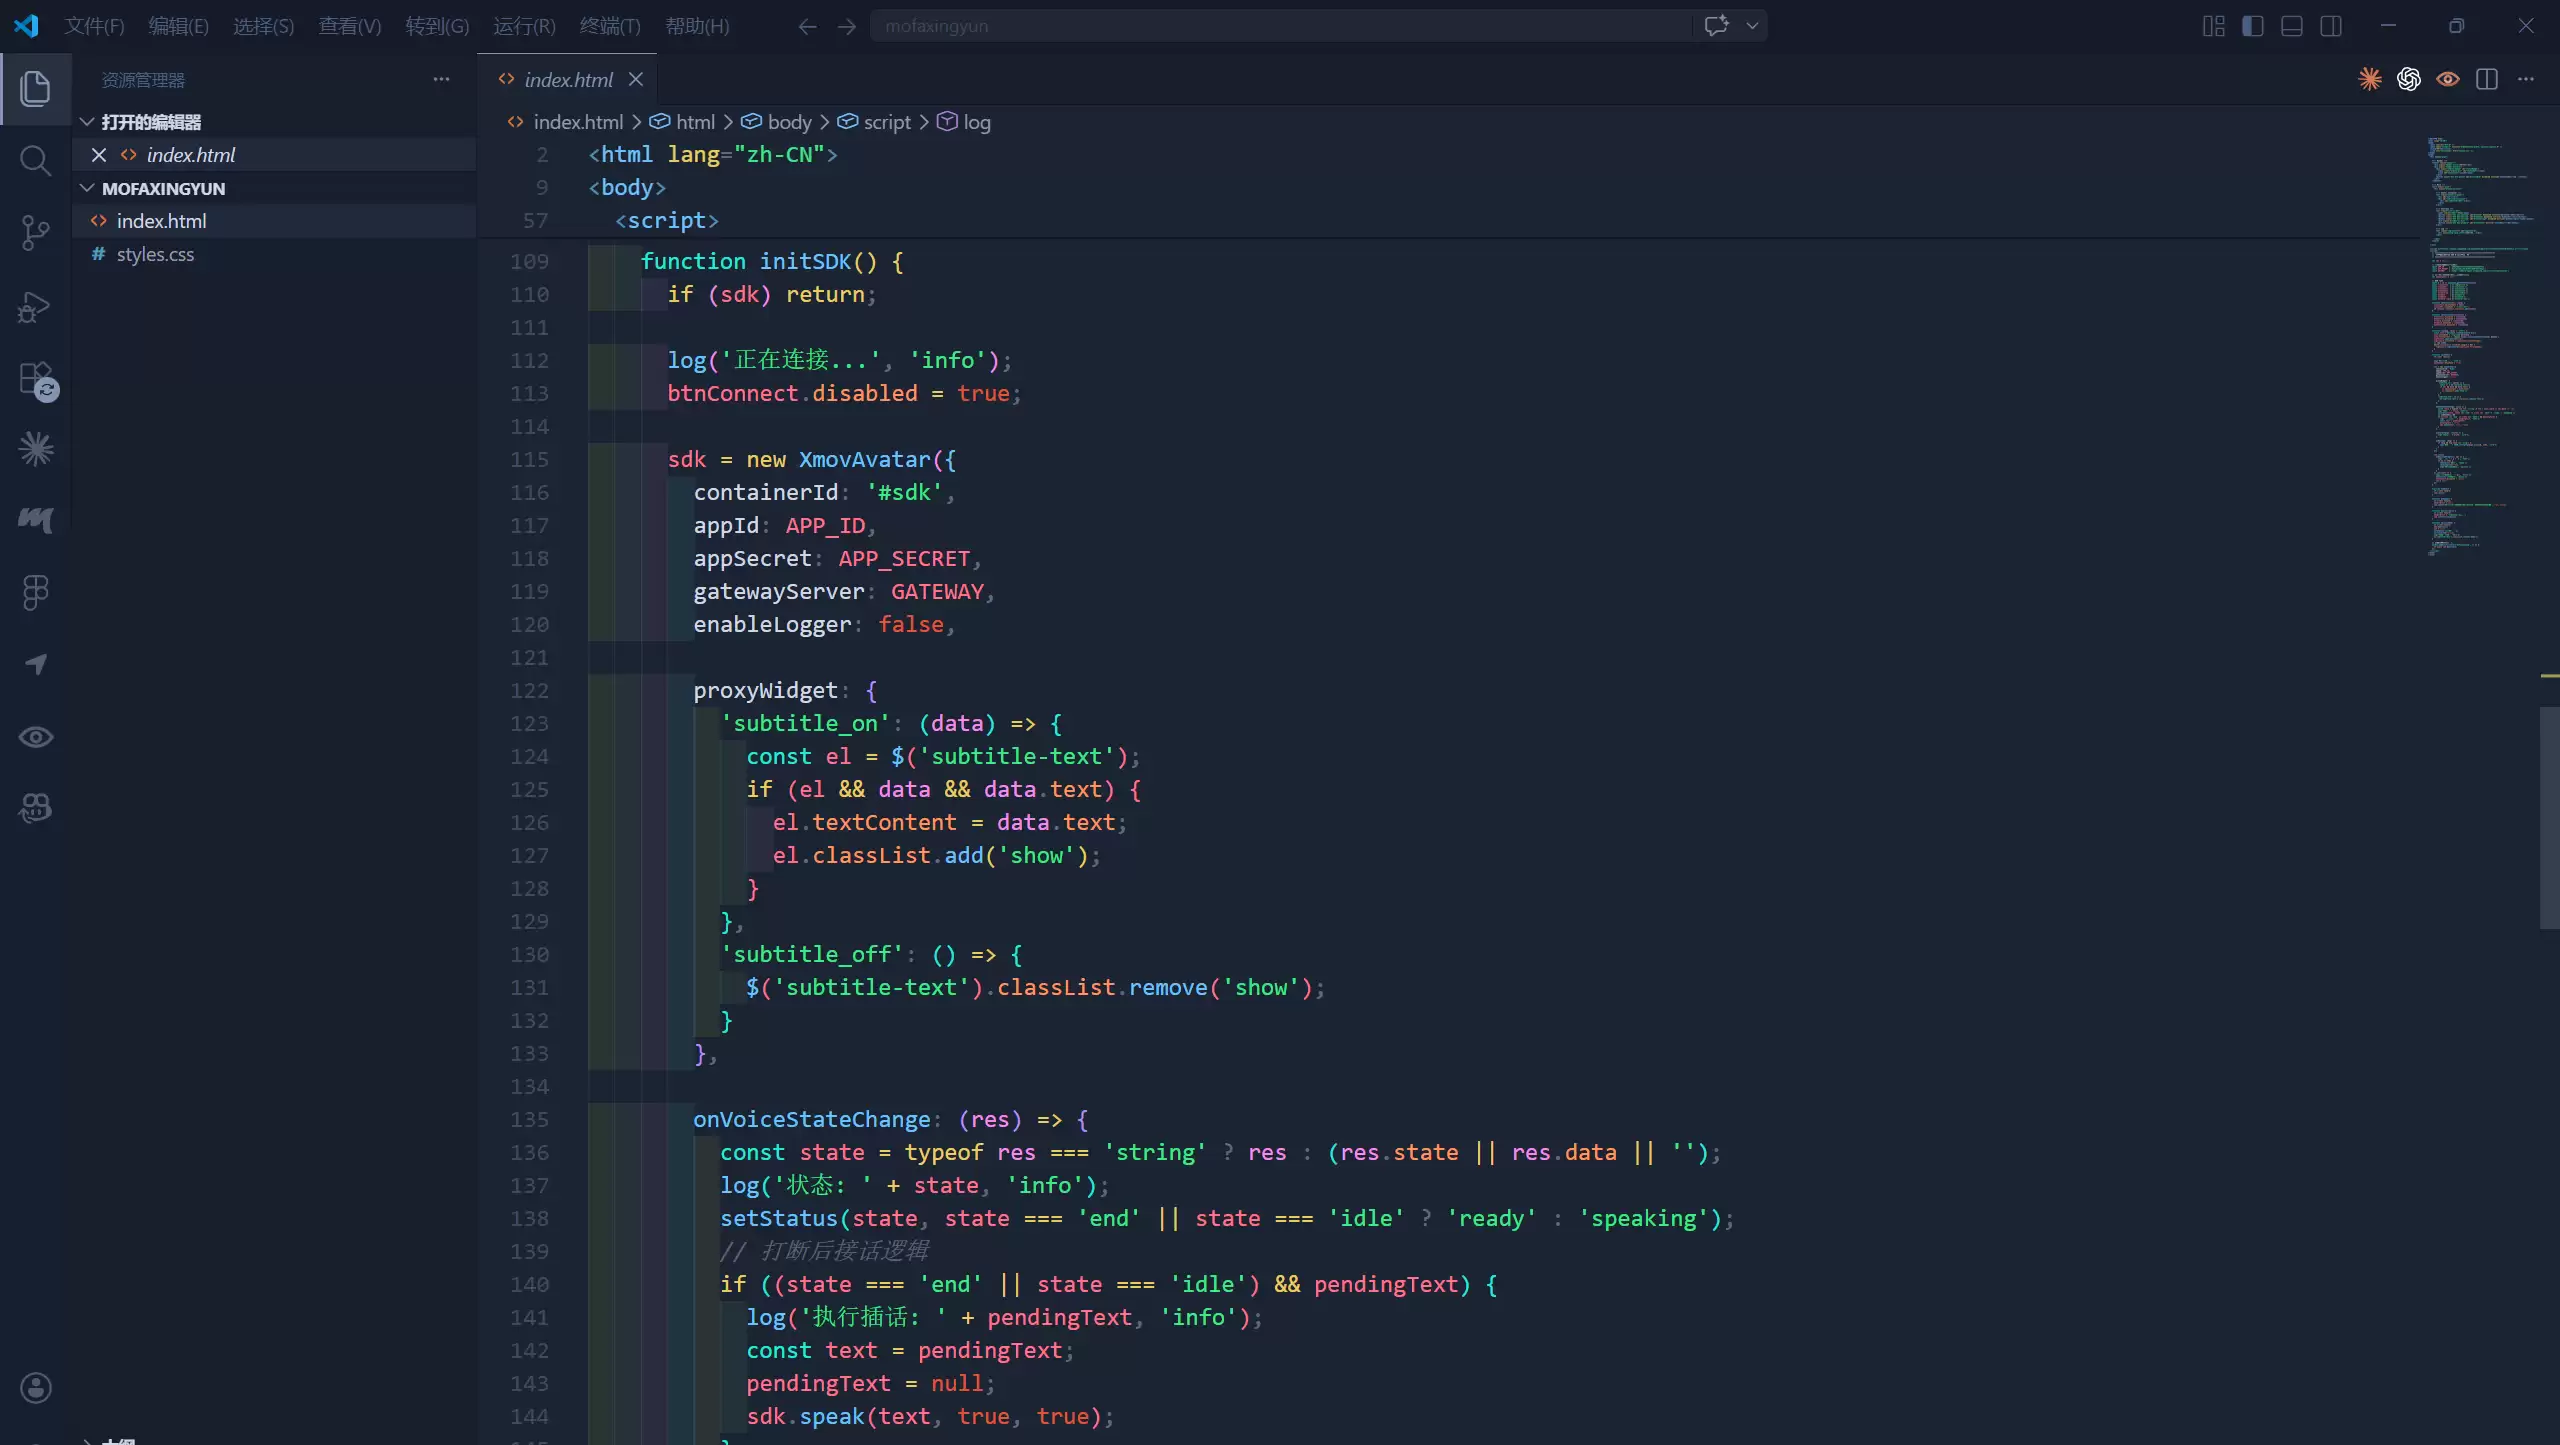
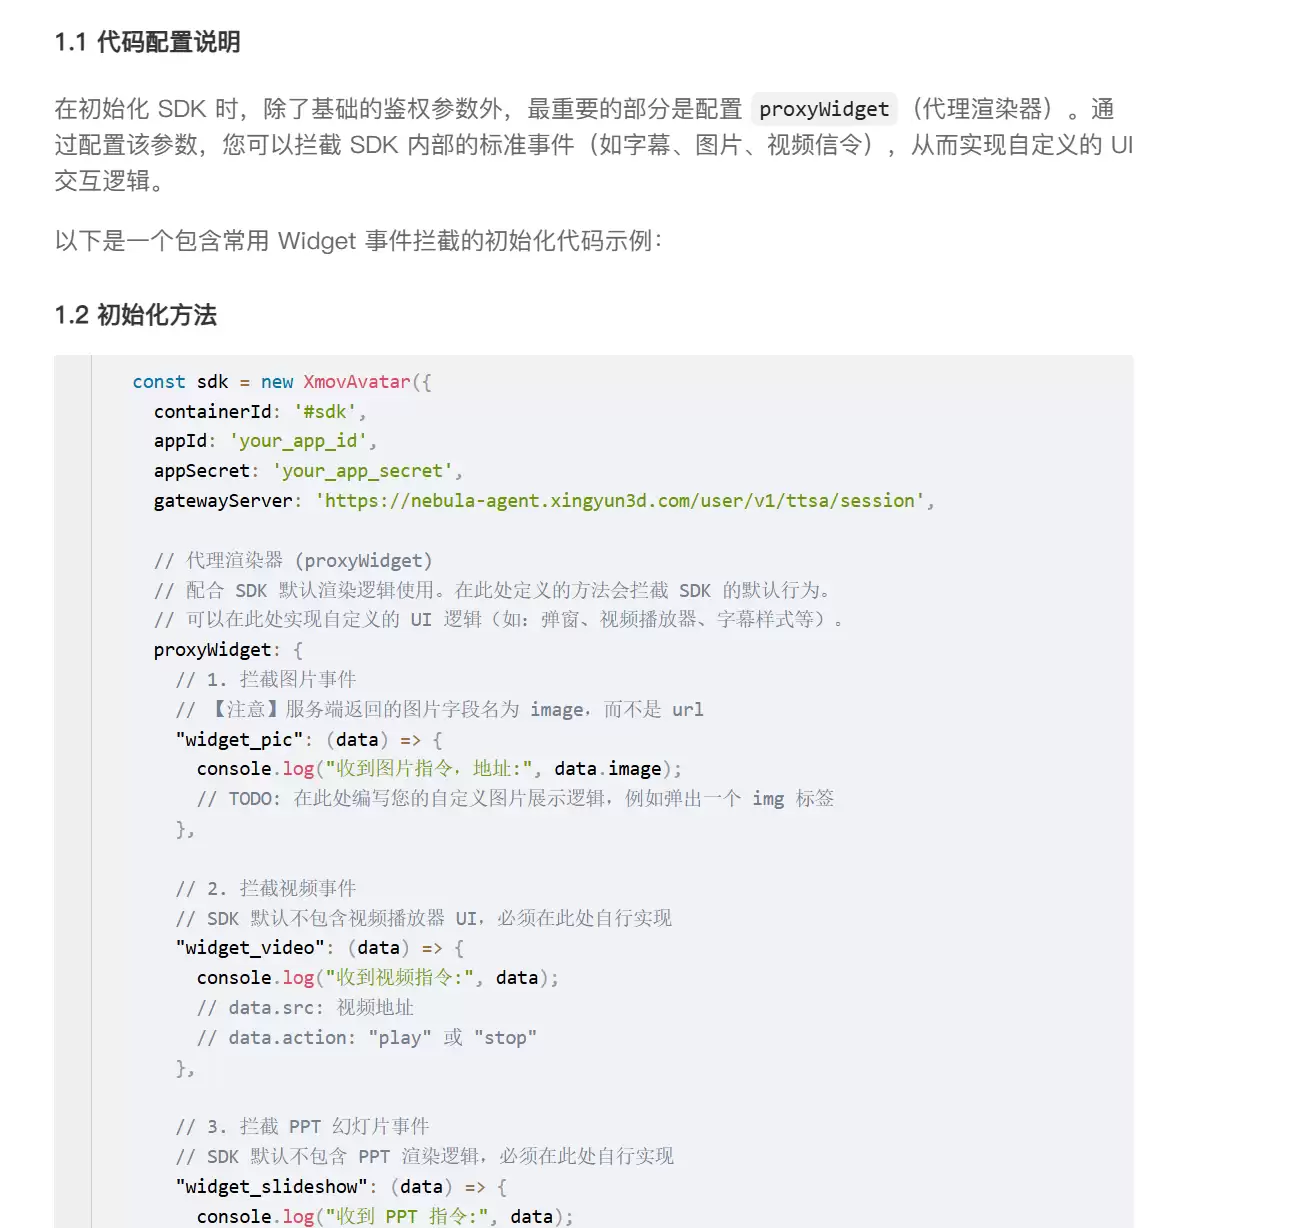
页面准备一个数字人容器,引入JS SDK,然后创建XmovAvatar实例,配置containerId、appId、appSecret、gatewayServer等参数。下面是示意代码,真实项目按官方文档和自己的密钥来写,密钥别公开。
sdk = new XmovAvatar({
  containerId: '#sdk',
  appId: APP_ID,
  appSecret: APP_SECRET,
  gatewayServer: GATEWAY,
  enableLogger: false,
  proxyWidget: {
    'subtitle_on': (data) => {
      const el = $('subtitle-text');
      if (el && data && data.text) {
        el.textContent = data.text;
        el.classList.add('show');
      }
    },
    'subtitle_off': () => {
      $('subtitle-text').classList.remove('show');
    }
  },
});
第一次跑的时候,最先遇到的问题不是SDK,而是容器比例。随手写了个div,数字人出来之后有点挤。这也说明具身Agent的体验不只看模型,前端容器、画面比例、字幕位置、角色大小,都会影响"像不像一个正在服务你的人"。
让数字人开口:最难的不是API,是别让它像PPT
数字人显示出来以后,下一步就是让它说话。官方文档里有interactiveidle()、speak()这类方法,用来切换状态和控制实时表达。技术上不算难,真正难的是内容。
第一次把LLM的回答直接传给数字人,体验很糟糕。不是不能播,是太像PPT。
用户问:"这个东西适合什么场景?"
LLM很自然地答:"该产品适用于展厅接待、智能导购、教育培训、客服售后等多个业务场景……"
文字看着没问题。但数字人一本正经地念出来,像发布会主持人在背稿。这个瞬间大概就明白了:文本Agent的回答,不能原封不动交给具身Agent。
给人看的文本,和给数字人说出来的话,不是一回事。
所以改了Prompt。重点不是让它更完整,而是让它更像人说话。
你是一名AI产品顾问,负责用口语向用户介绍产品。
要求:
1. 不要写成说明书。
2. 每次回答控制在80字以内。
3. 少用"首先、其次、综上"。
4. 可以有轻微停顿感。
5. 如果用户问题很宽泛,先给一个方向,再引导用户继续问。
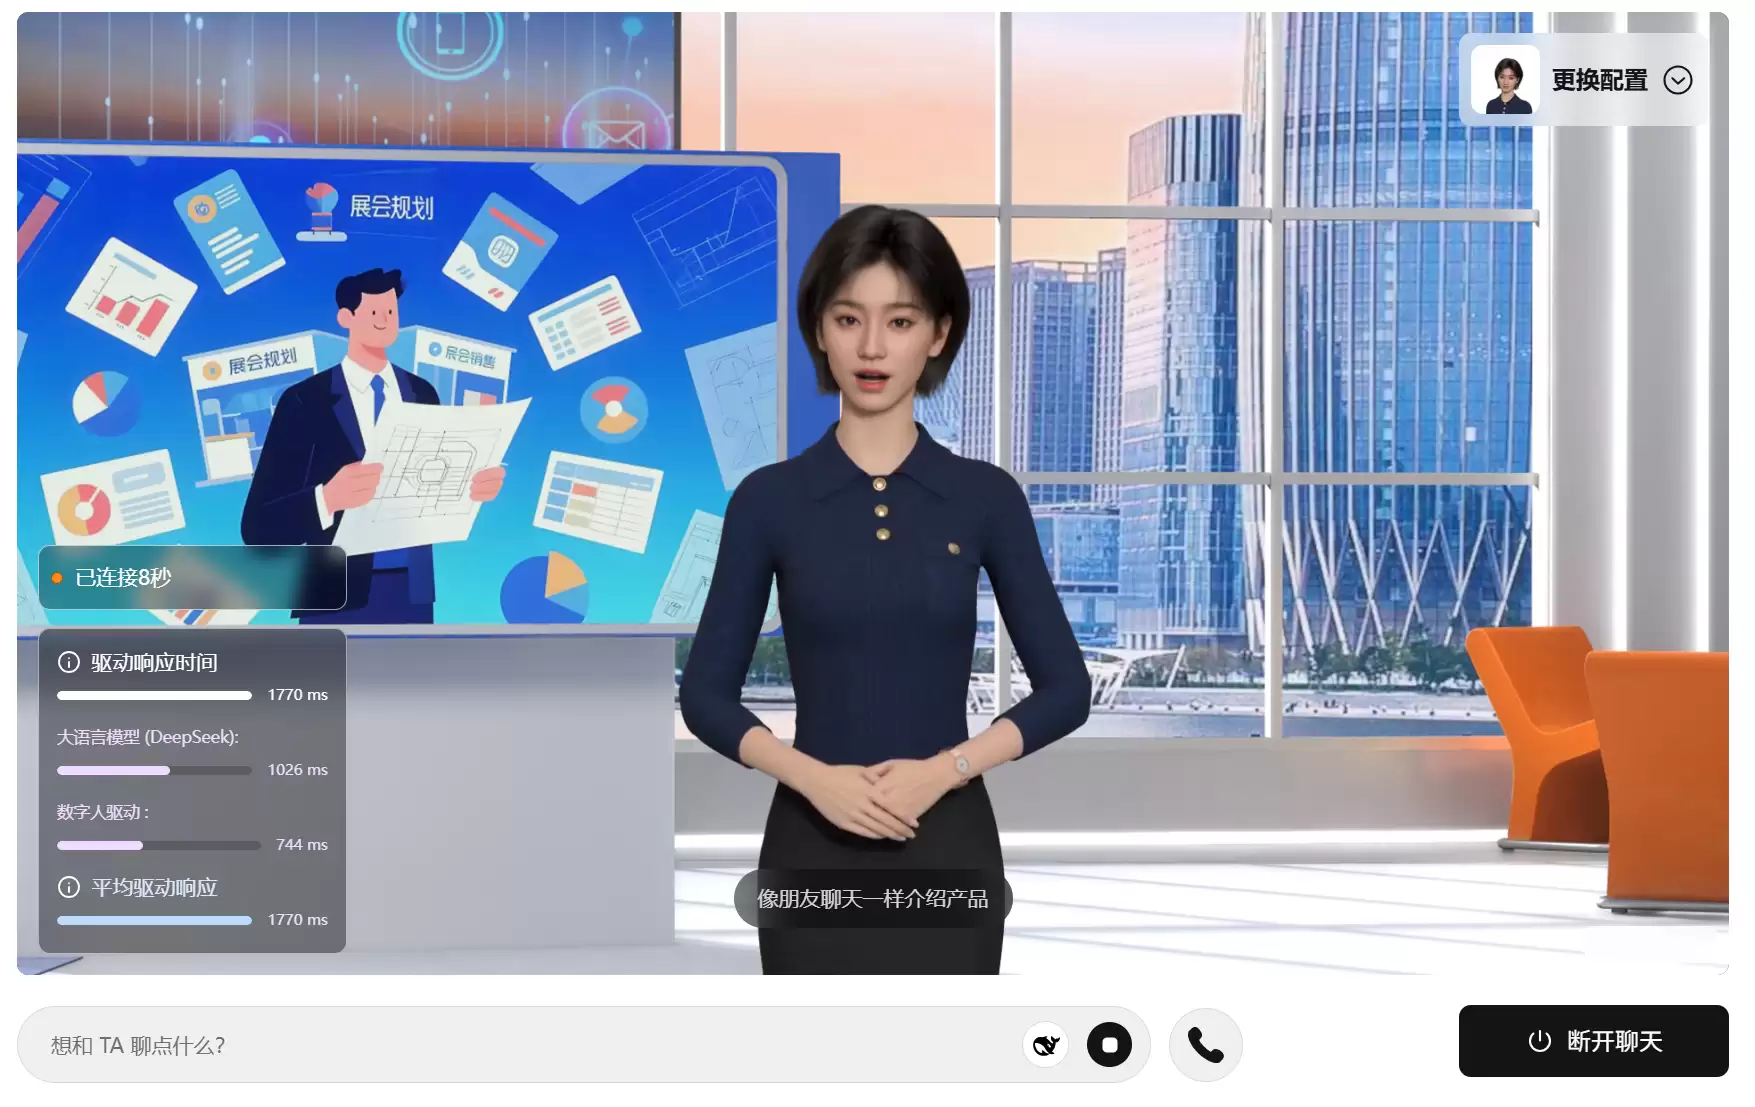
改完后,同一个问题可以变成:"我觉得最适合三类地方:展厅、门店,还有培训屏。因为这些地方不只是展示信息,还需要有人解释、引导。"
这句话不华丽,但数字人说出来顺很多。
还有一个小细节:语速。稍快一点像播报,稍慢一点像卡住。数字人比普通TTS更敏感,因为它多了脸、嘴型和动作。一个普通语音助手念得奇怪,可能还能忍;一个数字人带着表情念得奇怪,尴尬感会被放大。
具身Agent的输出:不应该只有text
做到这里,发现原来的Agent输出结构不够用了。以前只要返回一段answer就行,现在最好能返回一组适合表达的参数:文本、情绪、动作、语气、字幕、是否展示图片,甚至是否需要追问。
比如这样:
{
  "text": "这个方案,我觉得更适合门店导购。",
  "emotion": "friendly",
  "action": "explain",
  "subtitle": true,
  "is_start": true,
  "is_end": true
}
前端再把这组信息交给SDK:
async function avatarSpeak(block) {
  if (!sdk) return
  sdk.interactiveidle()
  await sdk.speak(
    block.text,
    block.is_start  true,
    block.is_end  true
  )
}
这个地方能看出具身Agent和文本ChatBot的分水岭。文本ChatBot追求回答准确、完整、逻辑顺;具身Agent还要考虑怎么说、什么时候说、配什么动作、能不能被打断、字幕怎么出现、用户下一步怎么接。
官方SDK文档里也提到Widget组件展示、自定义事件回调等能力。放到具身Agent里,这些不是简单UI功能,而是表达的一部分。数字人在解释产品时,旁边弹出图卡;讲步骤时出现PPT;回答问题时显示字幕。这些东西一起工作,才像一个完整的交互界面。
LLM+TTS+渲染拼起来,为什么还是不像人?
很多人做数字人Agent,会自然想到三段式:LLM负责回答,TTS负责说话,渲染引擎负责让人物动起来。听起来合理,但真正测下来,问题就出在"拼"上。
LLM说得太书面,TTS像播音腔,口型跟不上,动作和语义没关系,表情一直微笑。每个模块单独看都没错,合在一起就很假。像几个部门在同一个屏幕上轮流上班。
所以,具身Agent的关键不只是多一个数字人形象,而是把认知和表达之间的链路打通。自研文生3D多模态大模型、AI端渲、语音、表情、动作联动,最后都是为了让AI的回答变成一个可感知的表达过程。
当然,具身Agent做不好会更尴尬。文字回答差一点,用户可能只是觉得啰嗦;数字人动作假一点、嘴型慢一点、语音腔重一点,用户会直接出戏。但这也说明,它进入的是更接近真实交互的区域。
测试场景:门店与展厅导购
为了不泛泛而谈,把测试场景定成了"AI产品顾问",更具体一点,就是门店或展厅里的导购讲解员。这个场景刚好适合对比文本Agent和具身Agent,因为它不是单纯查资料,也不是闲聊,而是需要引导用户继续往下走。
纯文本Agent在这里的问题很明显:它等用户问。用户如果不知道问什么,就结束了。
具身Agent的优势也很明显:它可以先开口。
比如:"你可以先告诉我,你更关注价格、效果,还是接入难度?"
这句话很普通,但它降低了用户开始互动的成本。很多转化就发生在这种小地方。用户愿不愿意停下来,愿不愿意问第一句,愿不愿意继续追问,愿不愿意留下联系方式——都不是靠一段完美答案决定的,而是靠整个交互过程决定的。
比方说,向数字人问哪家商品的质量更好,它就会给出合理的建议。
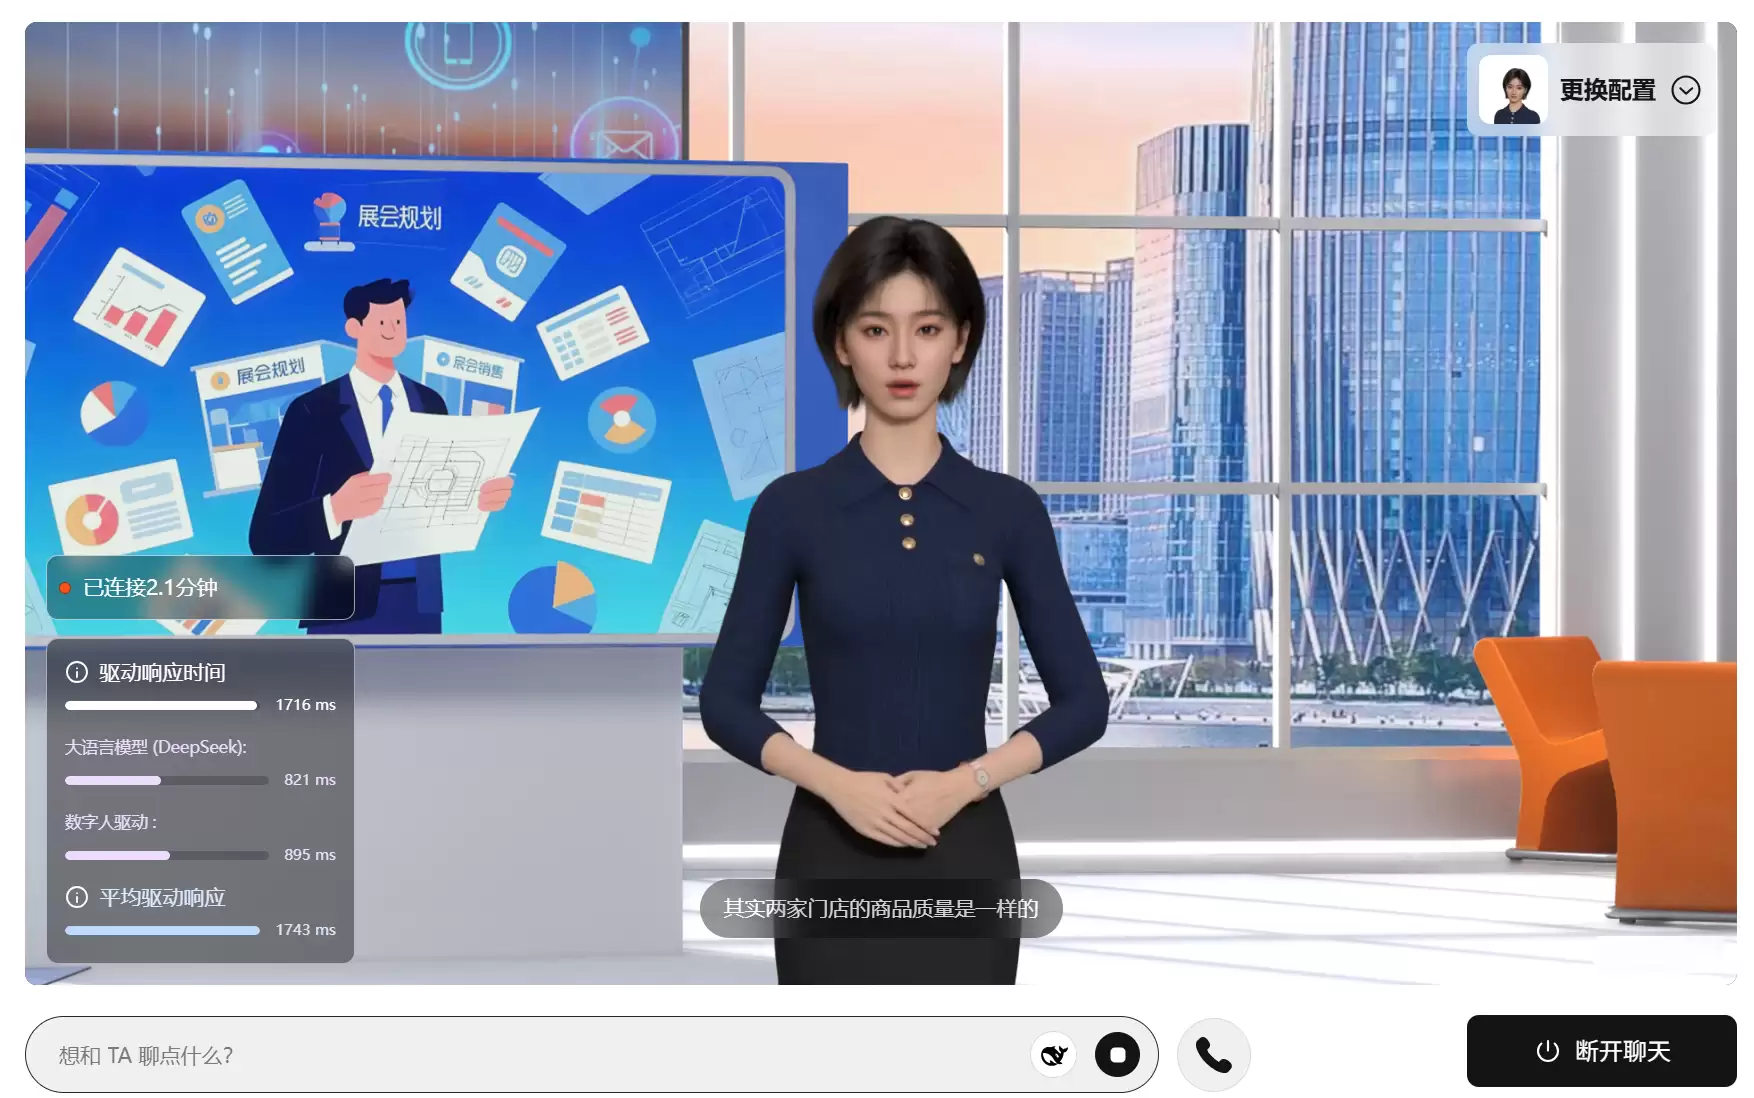
Demo结构大概是这样:
页面左侧:数字人展示区
页面右侧:问题输入区 + 推荐问题
底部:当前状态/日志
后端:LLM生成口语化回答
前端:调用星云SDK驱动数字人播报
推荐问题可以设置成:
1. 这个方案适合什么场景?
2. 和普通ChatBot有什么区别?
3. 开发者接入难吗?
4. 如果我要做一个门店导购,应该怎么设计?
用户问"和普通ChatBot有什么区别?"时,希望数字人不要回答成百科,而是说:"ChatBot更像输入框,你问它才答。具身Agent会主动出现在屏幕里,用语音、表情和动作解释问题。放在门店或展厅里,用户更容易开始第一轮互动。"
这段话不复杂,但更适合被说出来。
具身智能体:为什么同样业务场景转化可能更高?
这里不能简单说"有数字人,所以转化一定更高"。真实转化要看场景、内容、用户意图和产品本身。但从交互机制看,具身智能体确实更容易提高几个关键机会。
第一,它更容易吸引停留。一个会动、会说、会主动出现的角色,比一个输入框更容易让用户多看几秒。很多线下屏幕的第一步不是成交,是让人停下来。
第二,它更容易降低提问门槛。纯文本Agent要求用户组织语言,具身Agent可以先给选项、先引导方向、先抛出问题。用户不需要一开始就知道自己要问什么。
第三,它更容易建立信任感。用户不一定真的相信它是人,但语音、表情、节奏会让服务感更强。尤其是金融、医疗、教育、导购这些需要解释的场景,一段文字和一个"正在讲给你听"的角色,感受不一样。
第四,它更适合复杂产品讲解。文字堆多了没人看,宣传视频又不能互动。具身Agent可以边讲边根据用户反馈调整方向——这一点是它和传统视频的区别。
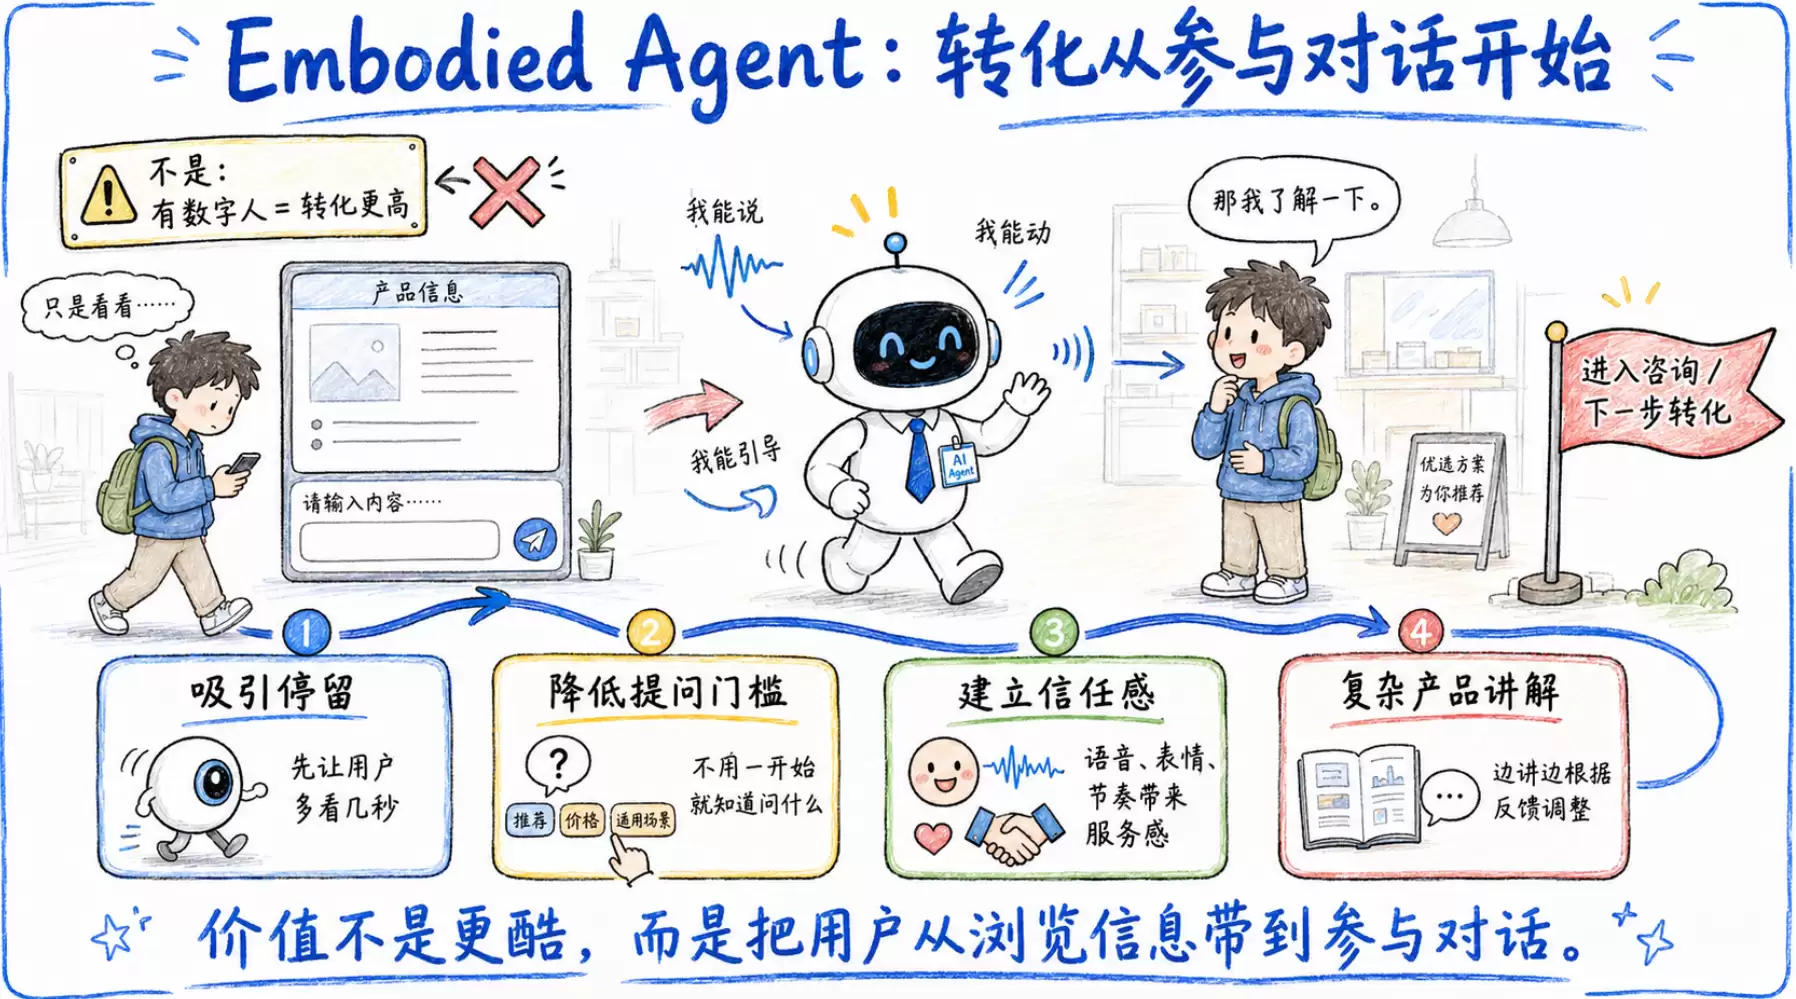
所以具身Agent的价值不是更酷,而是把用户从"浏览信息"带到"参与对话"。这一步如果发生了,后面的转化才有空间。
开发者视角:具身Agent最好能接到现有项目里
从开发者角度看,最关心的不是形象有多酷,而是:能不能接到现有项目里?文档能不能看懂?状态能不能控制?回答能不能被打断?字幕和UI能不能改?
魔珐星云SDK给人的感觉是,它不是要求推翻原来的Agent逻辑,而是把原来文本Agent的输出接到具身表达层。可以继续用自己的LLM、知识库、后端接口,只要最后生成适合播报的内容,再交给数字人表达。
这条路径比较现实。大多数开发者不可能从零做3D数字人、口型同步、动作驱动、端侧渲染。SDK的价值就在这里:把最难自研的具身表达部分封装起来,让开发者把注意力放回业务和交互设计。
不过具身Agent也会带来新的调试问题。以前文本Agent的bug很直接:回答错了、格式错了、接口报错了。具身Agent的bug有时很难描述——比如"不自然"、"太像播音"、"动作多余"、"嘴型慢一点"。这些不是控制台能直接告诉你的,需要反复看、反复听、反复调。
这可能也是这个方向有意思的地方。它不只是写代码,还像在调一个角色。
Agent的下一代入口:可能不是输入框
写到这里,并不是要否定ChatBot。文本Agent依然很重要——写代码、查资料、整理内容,它就是高效。也不希望一个数字人站出来念报错日志,那太慢了。
但聊天框不是所有AI交互的终点。尤其是在那些需要接待、讲解、陪伴、引导、信任建立的场景里,纯文本Agent的表达能力不够。它可以给答案,但很难让用户感觉"有人在服务我"。
具身Agent的核心,不是给AI加一个好看的外壳,而是让AI通过语音、表情、动作和实时反馈出现在用户面前。以前是"我操作工具",现在更像"屏幕里有个角色在接待我"。这个变化放到门店、展厅、培训、客服这些场景里,就不只是体验变化,也可能是转化变化。
最后Demo跑起来的时候,盯着屏幕看了一会儿。数字人站在那里,等着输入问题。它当然不是真的人,也没有真的理解你。但它已经不太像一个聊天框了。
下一次再看到屏幕正中间写着"请输入您的问题",可能会有点不耐烦。
它明明可以先开口的。