FuriosaAI推出16个PCIe插槽AI服务器叫板英伟达
韩国AI芯片公司FuriosaAI开发配备16个PCIe插槽的新一代AI服务器,采用堆叠架构将两个8插槽板组合,性能目标为基于英伟达RTXPRO6000服务器的4倍以上。通过减少交换芯片数量降低延迟,由超微代工,选用AsteraLabs交换芯片。
近日,韩国AI芯片公司FuriosaAI放出了一个有意思的消息:他们正在开发一款配备16个PCIe插槽的新一代AI服务器,这比现有系统通常的8个插槽直接翻了一倍。
这个方向,其实和英伟达、AMD当前的主流策略不太一样。英伟达和AMD更倾向于走机架级架构路线,把GPU、CPU、网络设备和存储打包成一个高度集成的AI系统,让几十个GPU像一台超级计算机一样协同工作,同时尽量把互连延迟压到最低。像英伟达的Vera Rubin NVL72和Helios这类产品,几乎需要主板、CPU、网络和GPU之间做到无缝咬合,才能真正发挥性能。
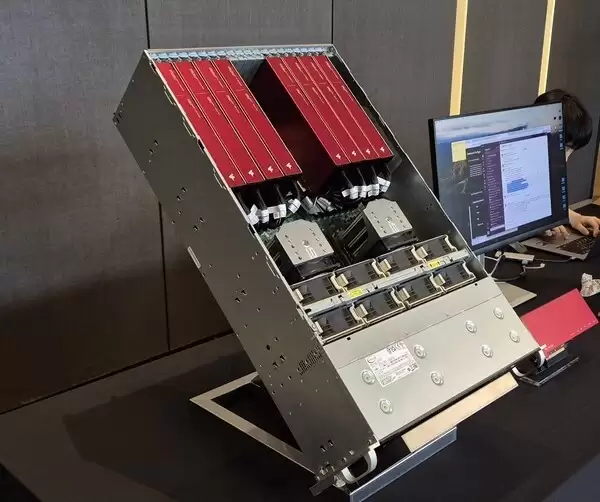
但FuriosaAI偏偏没有走这条路。他们的新服务器采用了一种有点“复古”但很巧妙的堆叠架构:把两个8插槽的PCIe板像三明治一样叠在一起,形成一个16插槽的组合体。更有意思的是,散热风扇从两个压缩到了一个,整个系统的紧凑度大幅提升。
堆叠架构与性能目标
新服务器将支持FuriosaAI现有的第二代RNGD加速卡(配备HBM3内存),以及未来升级版的加速卡(配备HBM3E内存)。这两款PCIe加速卡均由华硕代工制造,品控方面有一定保障。
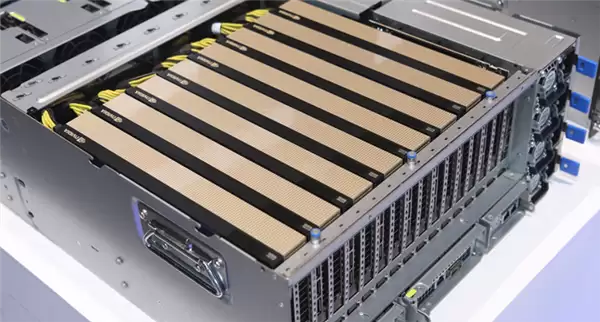
性能方面,FuriosaAI的目标相当激进——新服务器的性能至少要达到基于英伟达RTX PRO 6000 GPU服务器的4倍以上。不过,需要说明的是,这个设计目前仍处于规划阶段,最终的性能目标还有调整的可能,毕竟从纸面到落地,中间还有不少变数。
为了把性能做上去,他们也在延迟优化上想了不少办法。核心思路是减少交换芯片的数量。目前业界常见的做法是,每4个加速卡配1个交换芯片,而FuriosaAI把比例拉到了16个加速卡对1个交换芯片。这样一来,卡与卡之间通信的中间路由跳数大幅减少,延迟自然也就降下来了。
降低延迟与合作伙伴
这台服务器由美国服务器厂商超微(Super Micro Computer)代工制造,供应链上算是借了成熟厂商的力。网络交换芯片则选用了美国初创公司Astera Labs的Scorpio系列——这家公司近年来的产品在AI基础设施领域关注度很高,性能和可靠性都有不错的口碑。