

谷歌机器人进化:成功率提升3倍,新增视觉与自我保护能力
让机器人走进千家万户和现代工厂,仅仅能听懂指令是远远不够的。关键在于,它必须能“看懂”并深刻理解我们身处的、复杂多变的物理世界。 最近,Google DeepMind发布了其最新的机器人大脑——Gemini Robotics ER 1.6模型。 这个新模型将机器人的空间感知、多视角解析与仪表读取精度
让机器人走进千家万户和现代工厂,仅仅能听懂指令是远远不够的。关键在于,它必须能“看懂”并深刻理解我们身处的、复杂多变的物理世界。
最近,Google DeepMind发布了其最新的机器人大脑——Gemini Robotics ER 1.6模型。
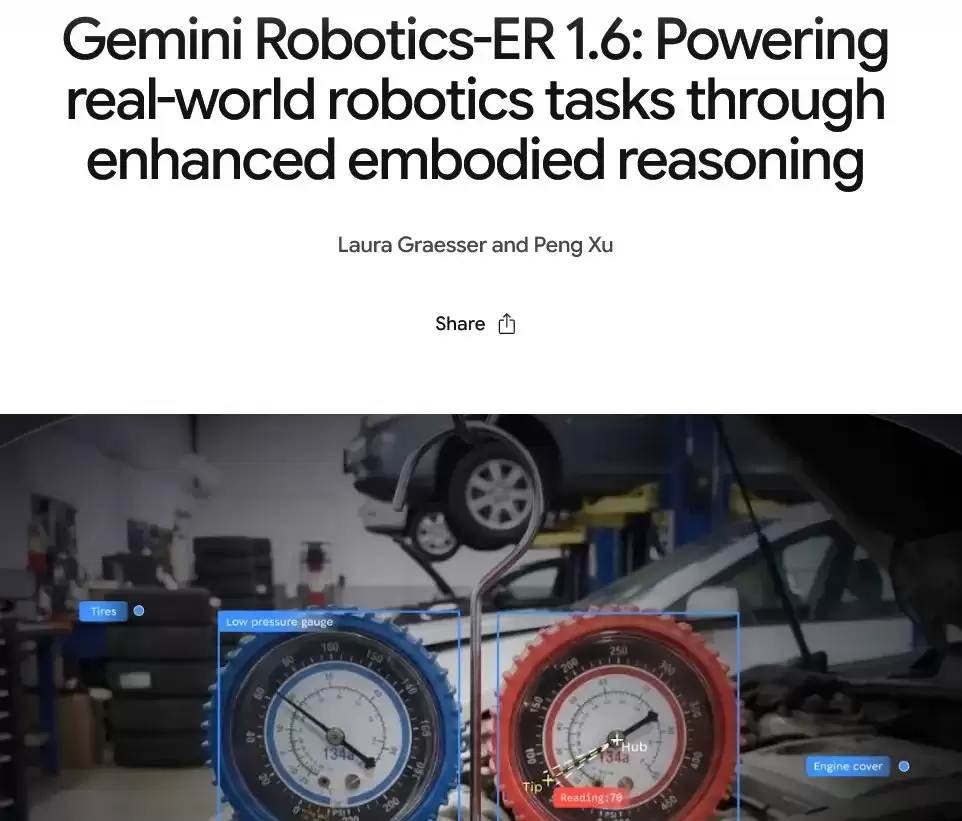
这个新模型将机器人的空间感知、多视角解析与仪表读取精度推上了一个新台阶。它让机器人不仅拥有了精准的“指认”能力,还练就了“读表”的绝活,同时大幅提升了物理操作的安全性与合规性。
空间感与指认
想让机器人在物理世界里真正帮上忙,就必须跨越数字智能与机械动作之间的那道巨大鸿沟。
Gemini Robotics ER 1.6正是为此而生,它专门针对复杂的“具身推理”需求进行训练。当遇到认知难题时,它能随时调用外部工具——不仅是调用Google Search查找实时资料,还能“呼叫”VLA(视觉语言动作模型)或其他用户自定义的功能模块,从而将高级思维转化为具体的、可执行的机械步骤。
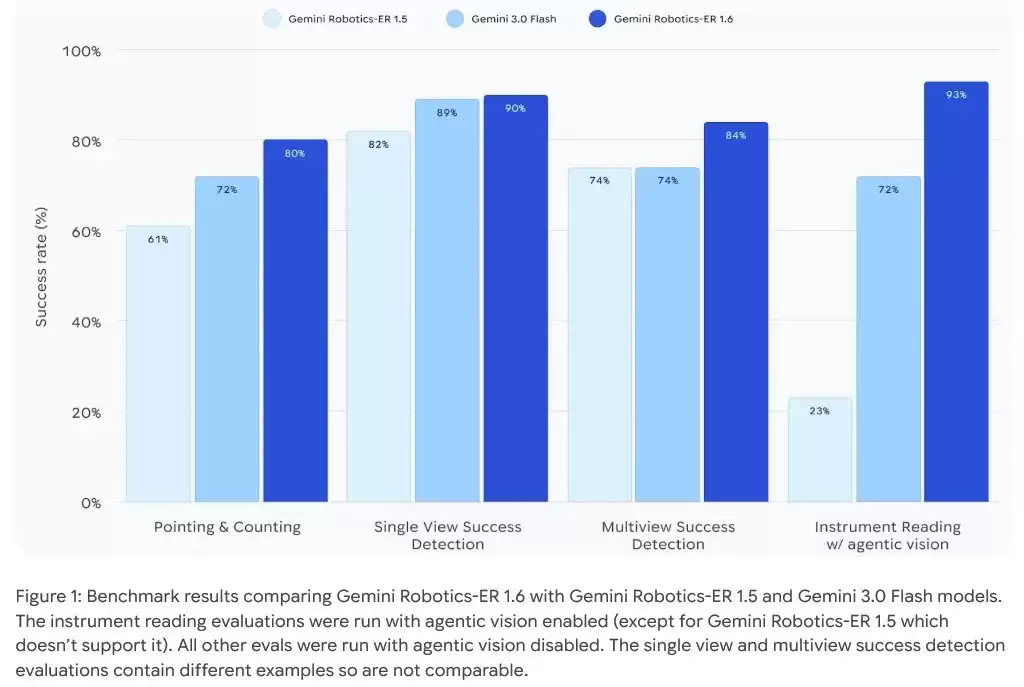
与上一代的Gemini Robotics ER 1.5以及通用大模型Gemini 3.0 Flash相比,新版本在空间与物理推理的准确性上,实现了一次大幅跨越。
“指认”这个动作看似简单,实则是高阶空间推理的绝对基石。人类抬手一指就能表达的模糊意图,在机器人的底层代码里,需要转过无数道弯。
一个指认操作,背后是极度精准的物体检测与数量清点,内部包裹着极其庞杂的关系逻辑推理。举个例子:在杂乱无章的零件盒里挑出体积最小的那颗螺丝钉,系统需要扫描所有物品,计算相对体积并进行全局排序。规划从操作台到流水线的移动轨迹时,它的大脑必须构思出完整的三维路径,并找出最佳的抓取发力点。
机器人还得懂得遵守苛刻的物理约束。比如,在分析视觉画面时,它要能精确估算出一个蓝色杯子的内部容量与杯口直径,进而只去指认那些能顺利塞进杯子的小物件。
新模型把精准的指认功能,当作解决复杂任务的“垫脚石”。系统通过连续的指认动作来清点画面中的物品总数,标记出图像中的关键特征点,借此启动后台的数学运算模块,将目标尺寸和空间距离的估算误差降到极低水平。
拿“寻找维修工具”这个场景来说,就很能说明问题。
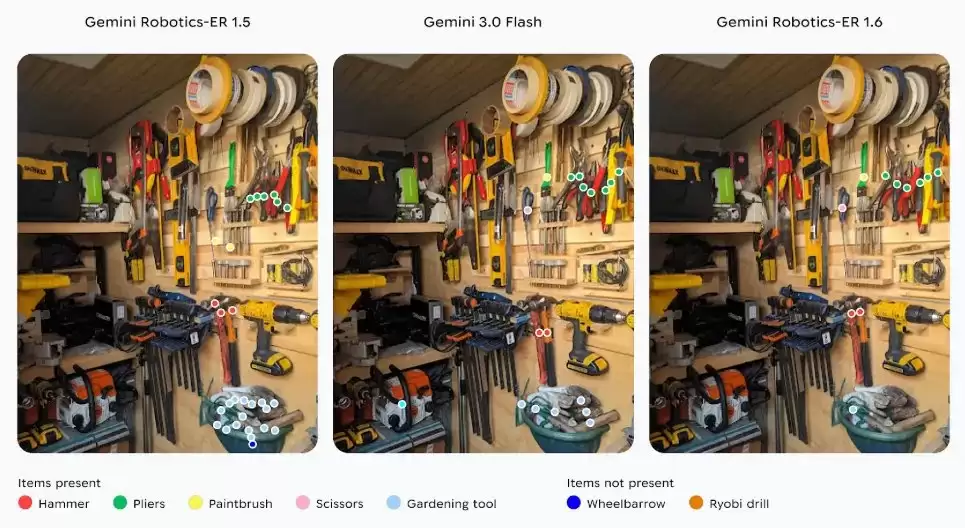
画面里摆着一堆杂乱堆叠的五金件。Gemini Robotics ER 1.6只需一眼,就能精准挑出2把锤子、1把剪刀、1把刷子,以及6把相互掩盖的钳子。
更聪明的一点在于,当接收到“寻找手推车和某特定品牌电钻”的指令时,系统经过严密的视觉排查,发现画面里根本没有匹配的物品。这时,它的大脑保持了极高的“视觉克制力”,绝不胡乱猜测或瞎指。
相比之下,老版本模型在相似场景下就经常犯迷糊:不仅会数错锤子和刷子的数量,完全漏掉处于阴影中的剪刀,有时还会凭空幻想出画面外的手推车。在指认密集摆放的钳子时,坐标偏差也往往很大。
而Gemini 3.0 Flash的表现虽然已非常接近新模型,但在处理成堆钳子这类密集小物件时,依旧稍显吃力。
视角与成功判定
对机器人来说,知道什么时候该“停手”,和知道怎么“动手”一样紧要。
“成功判定”是自主行动的核心驱动引擎。智能体必须在毫秒级的时间窗口里,持续判断当前细微任务是否已彻底完成,从而决定是需要调整姿态重试,还是按计划开启下一个关联动作。
然而,让机器人在嘈杂的物理环境中拥有靠谱的视觉理解力,是一项艰巨挑战。现实环境永远充满变数:角落光线可能忽明忽暗,工具常被防尘布大面积遮挡,人类随口下达的指令也往往模棱两可。
要应对这些海量麻烦,机器人需要将敏锐的光学感知、缜密的逻辑推导链条以及广博的人类常识深度结合起来。
现代机器人通常在机身上挂着好几个不同焦段的摄像头:头顶配置一个全局视角的俯视镜头,机械臂的抓取手腕上还会绑着一个近距离的微距特写镜头。
它的大脑必须把不同空间角度的二维画面实时拼凑起来,在每一个瞬间以及连续的时间轴线上,形成一个完整且连贯的“三维世界观”。
Gemini Robotics ER 1.6大幅度提升了这种多视角联合推理能力。
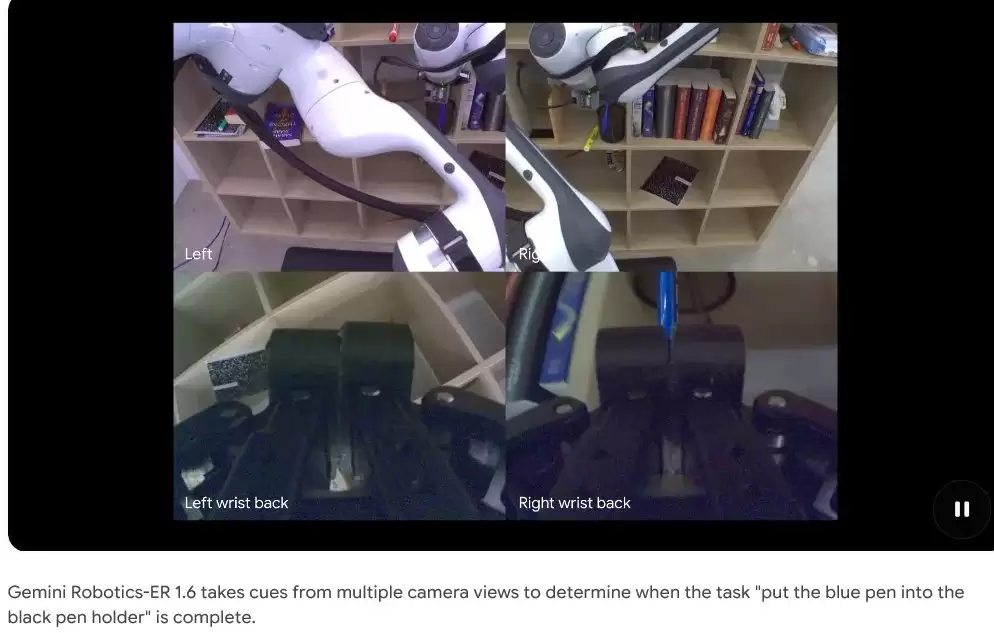
系统能够轻松消化多个摄像头同时传回的高帧率视频流,理清各个镜头画面之间的三维空间映射关系。即便周围光影不断变化,视线偶尔被障碍物遮挡,机器人依然对目标物体的空间坐标“心里有数”。
以“把一支蓝色钢笔放进黑色笔筒”这个精细任务为例:机械爪带着钢笔慢慢靠近目标,俯视镜头负责提供整体方位,手腕镜头则紧盯笔尖与笔筒边缘那毫米级的间隙。大脑同时处理不同角度传入的画面,进行密集的矩阵运算,综合判断出钢笔尖端确实已越过暗色圆筒的物理边界并稳稳落入底部后,便会立刻下达“释放夹爪”与“任务完成”的精准指令。
读表与真实世界
把抽象的空间推理与现实常识结合起来,解决工业级难题,正是新模型的拿手绝活。读取老旧工业仪表盘,就是一个极具代表性的例子。
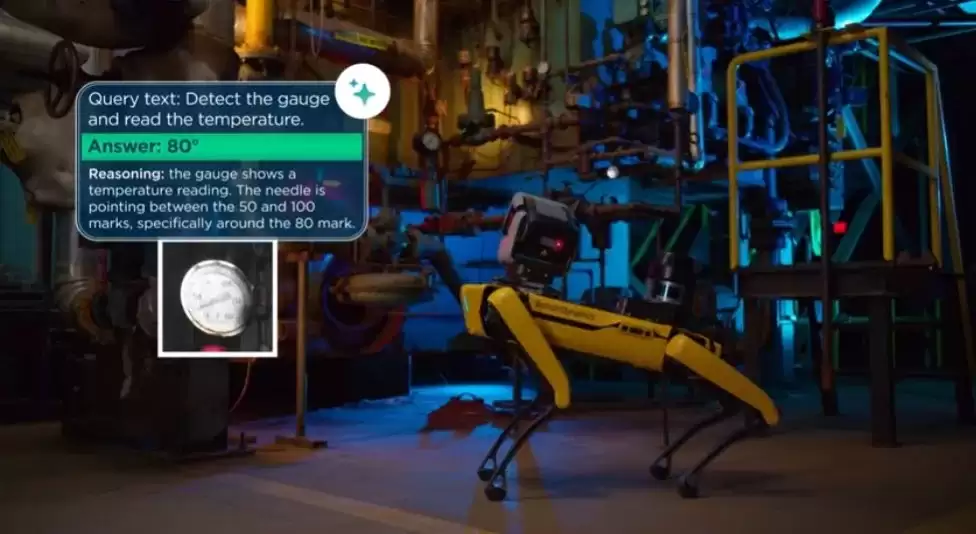
这项技能源于复杂设施巡检的真实需求。知名机器人公司波士顿动力,正是谷歌在该重点领域的深度合作伙伴。
想象一下大型化工厂或老旧制造车间:里面密密麻麻布满了温度计、压力表和化学试剂液位计。各种精密仪器需要全天候不间断监控,一旦读数异常,可能引发巨大的安全风险。
波士顿动力的四足机器狗Spot,能够在这些吵闹危险的厂区里自主巡逻,用随身携带的高清相机拍下各个仪表的实时状况。而Gemini Robotics ER 1.6,则让机器狗真正“看懂”了形形色色的工业仪器。
无论是表面沾满灰尘的圆形机械压力表、固定在倾斜管道上的垂直液位计,还是充满频闪干扰的现代化数字显示屏,系统统统能够准确读取关键数据。
千万别小看“读表”,这是一项对视觉推理要求极高的“大脑重体力活”。机器人不仅要看清纤细指针的微小朝向、透明玻璃管内的液面高低、容器本身的金属边缘以及表盘上的所有刻度线,还要在脑海里理清不同视觉元素之间的几何与数学关系。
例如,读取液位计时,相机镜头和玻璃管的折射效应经常带来严重的视觉畸变,液面会呈现出弯曲的椭圆边缘。这时,模型会在大脑里迅速构建边框,修正这些透视变形,准确估算出真实的液体占比。
压力表盘上通常印着复杂的英文字母和单位标识,机器人依靠光学字符识别技术读出文字,并结合工业常识准确理解。有些精密航空或电力仪表带有多根长短不一的指针,分别代表着成百上千位或者小数点后的不同数值,机器人需要将多根指针逐一读取出来,按照正确的数量级层次进行数学拼接加总。
新模型读表如此精准的秘诀,在于其系统底层全面启用了“智能体视觉”技术。该技术将多模态视觉推理和底层代码直接执行能力完美地交织融合在一起。
当模型在昏暗角落遇到看不清的复杂表盘时,它会像一位经验丰富的老工匠一样,分步骤解决难题:大脑先通过生成特定代码,控制相机对局部画面进行无损放大,看清最微细的刻度线;接着,利用精准指认和数学代码,计算出指针落在两个微小刻度之间的精确比例与物理间隔;最终,调用内置的庞大工业常识库,把冰冷的像素和角度数据,“翻译”成具体的环境压力数值。
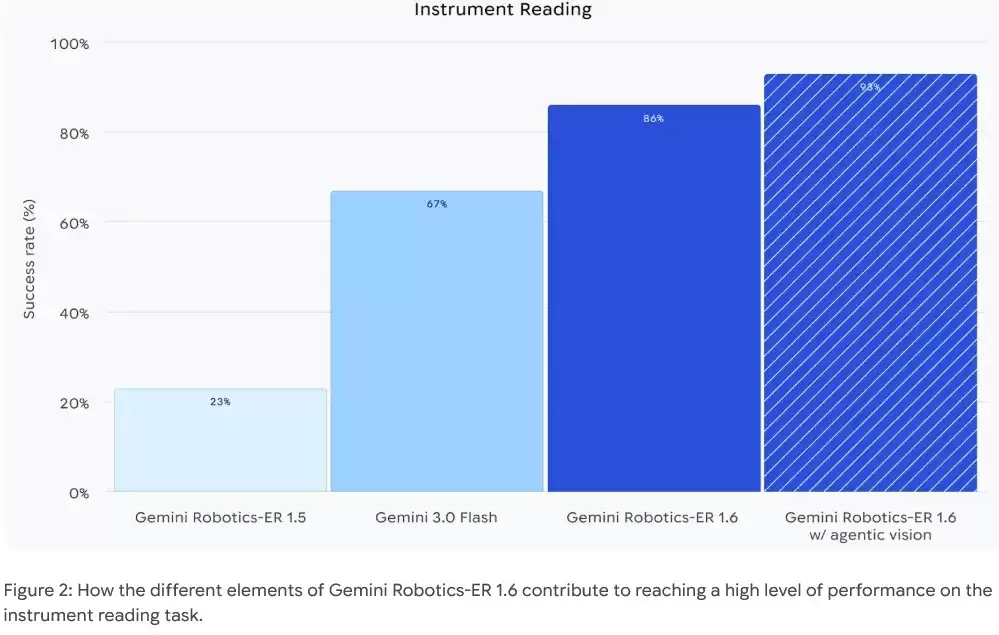
效果是显著的:Gemini Robotics ER 1.6在仪器读取任务中达到了非常高的性能水平。在结合了Agentic Vision技术的仪表读数任务中,其成功率高达93%,相比Gemini Robotics-ER 1.5,性能飙升了3倍。
安全与约束
极致的安全保护机制,深植于这个具身推理模型的基因之中。谷歌团队表示,Gemini Robotics ER 1.6是他们迄今为止打造出的“最安全”的机器人大脑。
在充满对抗性和欺骗性的空间推理极限测试中,新系统展现出了远超历代版本的极高安全合规性,时时刻刻严格遵守着既定的物理法则与人类安全准则。
机器人在动手干活前,会先通过空间指认给出极其安全的预判决策。例如,面对一个带有腐蚀性危险警告标签的瓶子,系统会迅速检索物理规则,严格遵循“禁止接触未知液体”的最高指令。
面对一大块实心铁锭,系统会通过视觉估算体积,并结合铁的密度计算出重量,牢记自身机械臂“绝对不能捡起超过20公斤物体”的红线约束,绝不勉强抓取导致电机超载损坏。
为了做到这一点,研发团队精心收集了海量真实的工伤事故报告,全方位测试了模型在复杂文字指令和动态视频场景中,敏锐察觉安全隐患的能力。
结果令人印象深刻:在关乎人身与财产安全的严格测试中,新模型全面超越了Gemini 3.0 Flash基准线。系统对于文字描述中潜在隐患的识别准确率大幅提升了6%,而在观察动态视频帧、寻找诸如地面漏水或高空坠物等物理隐患时,准确率更是提升了10%。
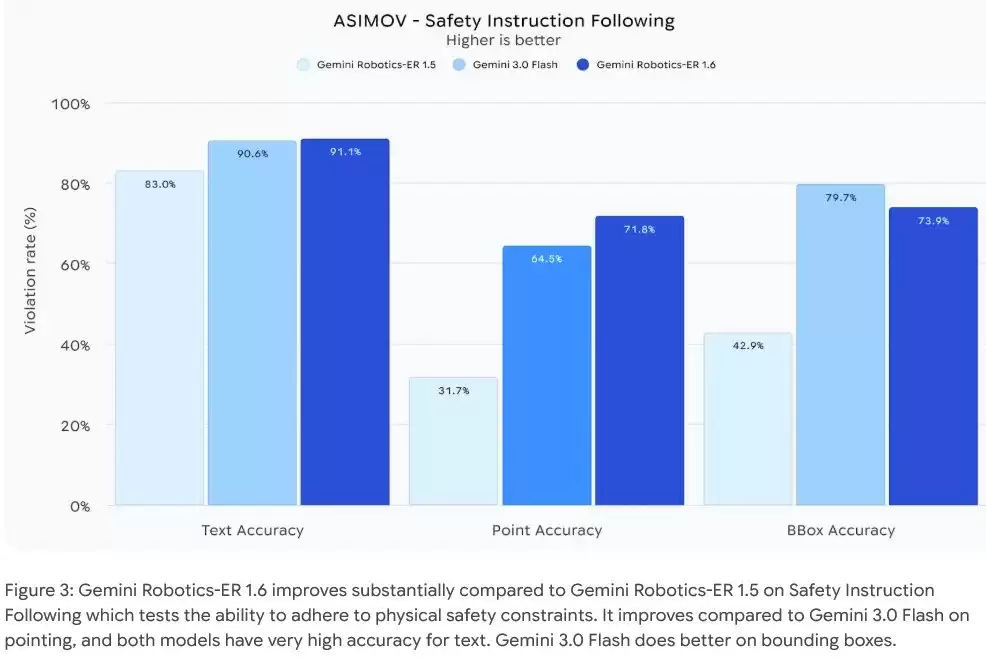
目前,开发者已经可以通过Gemini API和Google AI Studio使用Gemini Robotics-ER 1.6。
前所未有的三维空间感知,加上严丝合缝的安全红线,能指认、能读表、还能保护自己的下一代具身机器人,其黎明已然到来。
本文来源:AIGC开放社区