

pgvector入门实战指南:PostgreSQL向量检索
作者:技术拾光时间:2026-07-25 08:56:09浏览:500
一. 什么是 pgvector?在AI驱动的应用里,向量数据已经成为存储与检索的核心。pgvector正是PostgreSQL为此打造的利器——一个开源的扩展,让数据库能原生处理和搜索高维嵌入向量。核心能力一览 向量存储:把向量数据直接存在普通表里,和标准字段放一起。 距离计算:支持欧氏距离(L2)
一. 什么是 pgvector?
在AI驱动的应用里,向量数据已经成为存储与检索的核心。pgvector正是PostgreSQL为此打造的利器——一个开源的扩展,让数据库能原生处理和搜索高维嵌入向量。
核心能力一览
- 向量存储:把向量数据直接存在普通表里,和标准字段放一起。
- 距离计算:支持欧氏距离(L2)、内积、余弦相似度等主流度量。
- 最近邻搜索:兼顾精确搜索与近似搜索(IVFFlat / HNSW),按需选择。
- SQL兼容:向量列可以直接与其他列一起做过滤、排序、JOIN。
- 可扩展性:从小规模实验到较大数据量的生产环境,都能胜任。
二. 为什么选择 PostgreSQL + pgvector?
聊这个之前,先得问一个问题:为什么非要在一套数据库里搞向量?其实原因很直接。
- 数据整合:向量和原始数据住在一起,省去了部署独立向量数据库的麻烦。
- 事务与安全:直接继承PostgreSQL的全部事务机制、权限控制、备份与复制能力。这套体系久经考验,不用操心。
- 易于扩展:SQL里可以做JOIN、叠加业务过滤,实现真正的混合检索。
- 降低维护成本:只需要维护一个数据库系统,运维复杂度和成本都大大降低。
- 可视化和监控:PostgreSQL现有的工具生态可以直接用,比如pgAdmin、DataGrip等,分析起来很方便。
三. 安装与启用
事情从安装开始。前提是PostgreSQL版本至少13+,然后在系统里装上pgvector。装好后,进数据库执行一句话就能启用:
CREATE EXTENSION IF NOT EXISTS vector;
想确认是否成功?跑一条查询即可:
SELECT * FROM pg_extension WHERE extname='vector';
如果看到结果,恭喜,可以开始创建向量列了。

四. 基本数据结构
向量列的类型是vector,也支持vector(n),其中n就是维度。
举个例子:
CREATE TABLE documents ( id BIGSERIAL PRIMARY KEY, embedding VECTOR(3) -- 假设嵌入向量是3维);
注意一个小要点:向量列的维度是固定的,创建完表后就不能改了,所以建表前想清楚维度。
五. 基本操作
5.1 插入向量
插入数据时,直接用字符串格式的数组就行:
INSERT INTO documents (embedding) VALUES ('[1,2,3]'), ('[4,5,6]'),('[4,0,5]');
5.2 查询向量最近邻
搜索最近邻居的核心是使用距离运算符。最常用的是欧氏距离:
-- 使用 L2 距离SELECT id,embedding <-> '[1,2,3]' as score,embedding FROM documents ORDER BY embedding <-> '[1,2,3]' LIMIT 5;
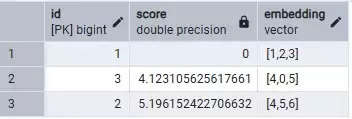
根据score的得分,就能查询出相近的向量,值越小代表越相似,算法如下
公式
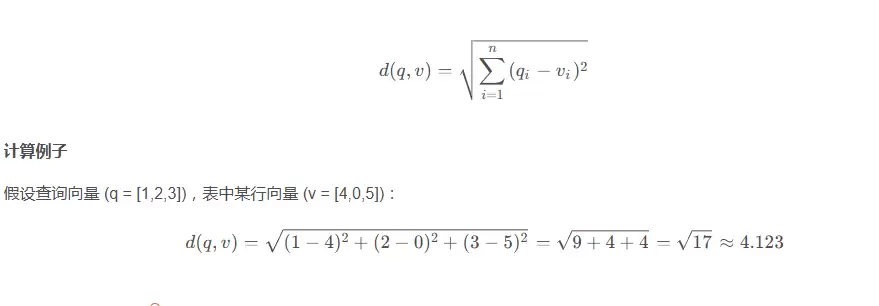
5.3 常用距离运算符
| 操作符 | 相似度度量 | 说明 | 推荐场景 | 值越小代表 |
|---|---|---|---|---|
<-> | 欧氏距离 (L2 Distance) | 计算两个向量之间的几何距离 | 图像、音频、地理数据检索 | 越相似 |
<#> | 负内积 (- Inner Product) | 取负号后的内积,用于最大内积搜索 | 推荐系统、模型打分 | 越相似 |
<=> | 余弦距离 (Cosine Distance) | 1 - 余弦相似度,对向量长度不敏感 | 文本语义检索、跨语言向量匹配 | 越相似 |
5.4 其他操作
除了增删查,还有一些日常维护操作,比如:
# 向现有表中添加向量列ALTER TABLE items ADD COLUMN embedding vector(3);# 更新向量UPDATE items SET embedding = '[1,2,3]' WHERE id = 1;# 删除向量UPDATE items SET embedding = '[1,2,3]' WHERE id = 1;
(注意:第二个UPDATE是删除向量的常见做法——将向量置空或清零。)
六. Python 示例
写段Python代码演示一下使用过程。推荐pgvector-python配合psycopg2。
import numpy as npimport psycopg2from pgvector.psycopg2 import register_vector# 连接数据库conn = psycopg2.connect(host='192.168.1.101', dbname='test-agent', user='postgres', password='123456', port=5433)register_vector(conn) # 注册 vector 类型cur = conn.cursor()# 插入示例向量embedding = np.random.rand(3).astype('float32')print(embedding)cur.execute( "INSERT INTO documents (embedding) VALUES (%s)", (embedding,) # 注意这里的逗号,确保是元组格式)conn.commit()# 查询最近邻query_embedding = np.random.rand(3).astype('float32')print(query_embedding)cur.execute( "SELECT id, embedding,embedding <-> %s as score FROM documents ORDER BY embedding <-> %s LIMIT 5", (query_embedding, query_embedding,))rows = cur.fetchall()for r in rows: print(r)cur.close()conn.close()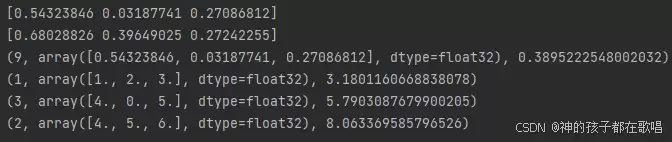
这段代码里有个细节值得注意:cur.execute里传参数时,embedding后面一定要加逗号,这样Python才能正确解析成元组。否则可能会报参数个数不对的错误。
七. 小结
- pgvector 是 PostgreSQL 的向量扩展,支持高维嵌入向量存储与检索。
- 提供精确与近似最近邻查询,并可与 SQL 完美结合。
- 基础操作包括创建表、插入向量、查询最近邻以及选择合适的距离运算符。