

Vivix灵动时刻发布首个实时互动模型 统一多模态参考、交互与流式生成
Vivix发布A1和W1两个实时互动模型,激活参数约30B。A1支持全身数字角色生成与实时交互,W1实现互动叙事。模型采用因果生成架构,结合MJD蒸馏与NVFP4量化,在消费级显卡上实现首帧延迟低于0.6秒,实时生成成本低于每小时1美元。
过去一年,AI领域中被提及频率最高的词汇之一便是“实时”。实时语音、实时换脸、实时风格迁移等技术名词层出不穷,初听之下都颇具吸引力。然而细究之下,绝大多数所谓的“实时”仍停留在加速版的请求-响应循环中:用户提供条件,模型快速返回结果,随后再提供下一个条件。模型输出时,用户无法干预;用户操作时,模型已停止。更精确的技术术语称此为“半双工”。
7月24日,Vivix正式发布两款模型——Vivix-A1(开放世界演员)与Vivix-W1(开放世界剧情),两者激活参数均约为30B。本次发布的核心问题并非“生成能否更快”,而是更进一步:模型在持续生成音视频的过程中,能否随时接收用户的新输入,并立即改变正在生成的内容?
若能实现,AI内容的基本单位将不再是离线生成好的素材,而是一段可被持续改变的实时互动体验。Vivix此次发布覆盖了从基座模型、生成算法、NVFP4量化到实时推理引擎的完整技术栈。在拆解技术细节之前,首先看其实际运行效果。
实际效果:三个场景展示
Vivix通过A1和W1在多个方向上的Demo,直观展示了“实时交互的模型到底长什么样”。
直播电商:数字主播具备生动感
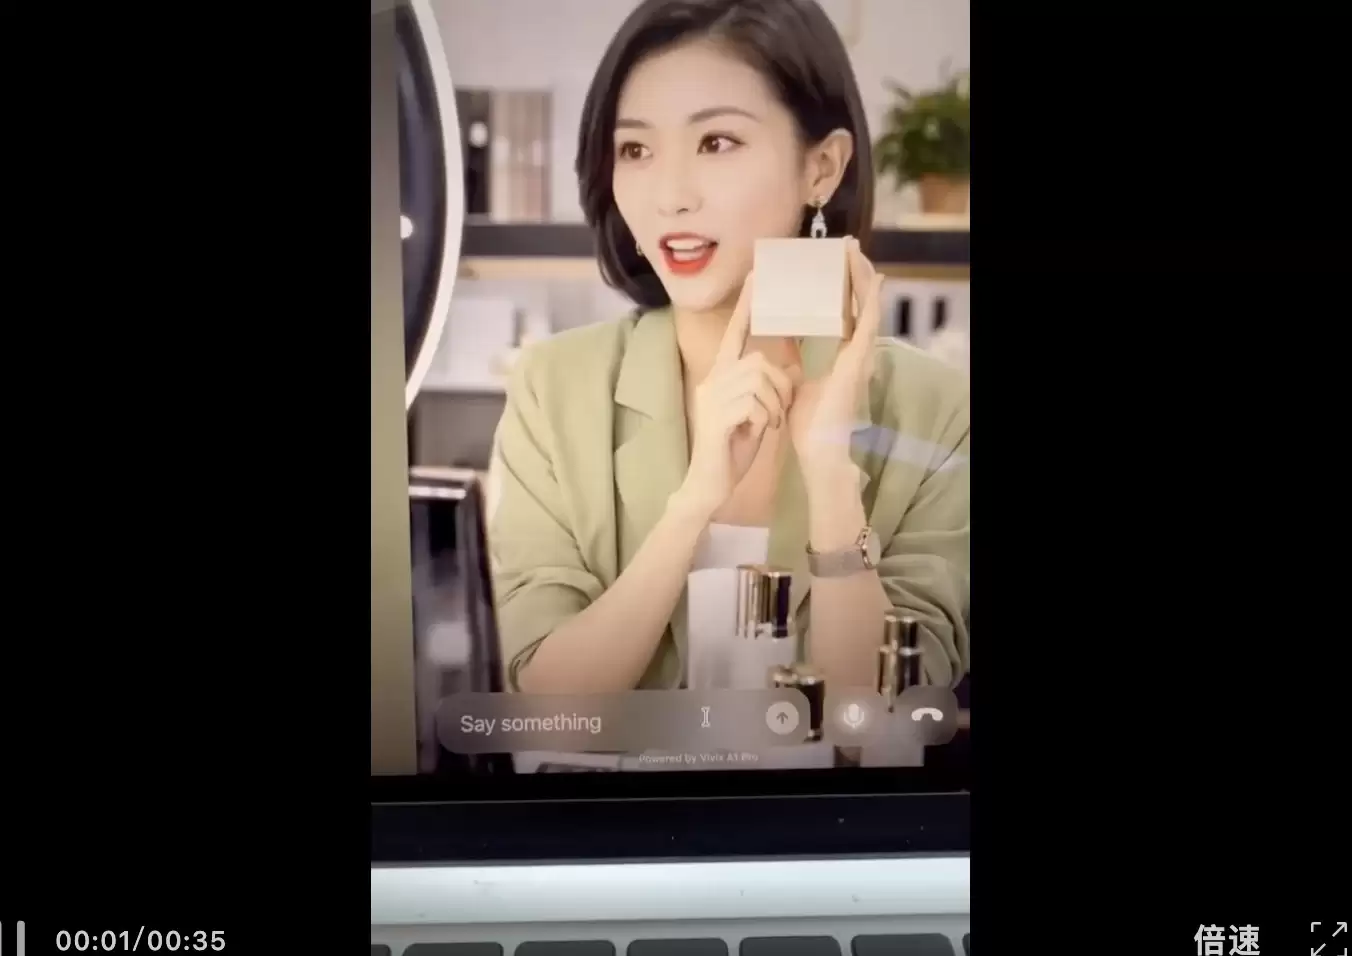
A1生成的数字主播能够自由转身,与商品互动自然逼真,表情丰富,并能即时响应变化。与以往的常见数字人直播相比,最显著的区别在于角色不再被“固定”在机位中对口型——它拥有完整的全身动作,可走动、转向、拿起物体。运营人员可在直播过程中通过语音调整方向,角色在自然的语句间隙完成切换,无需中断重来。
AI女友:动作、表情、语音自然同步
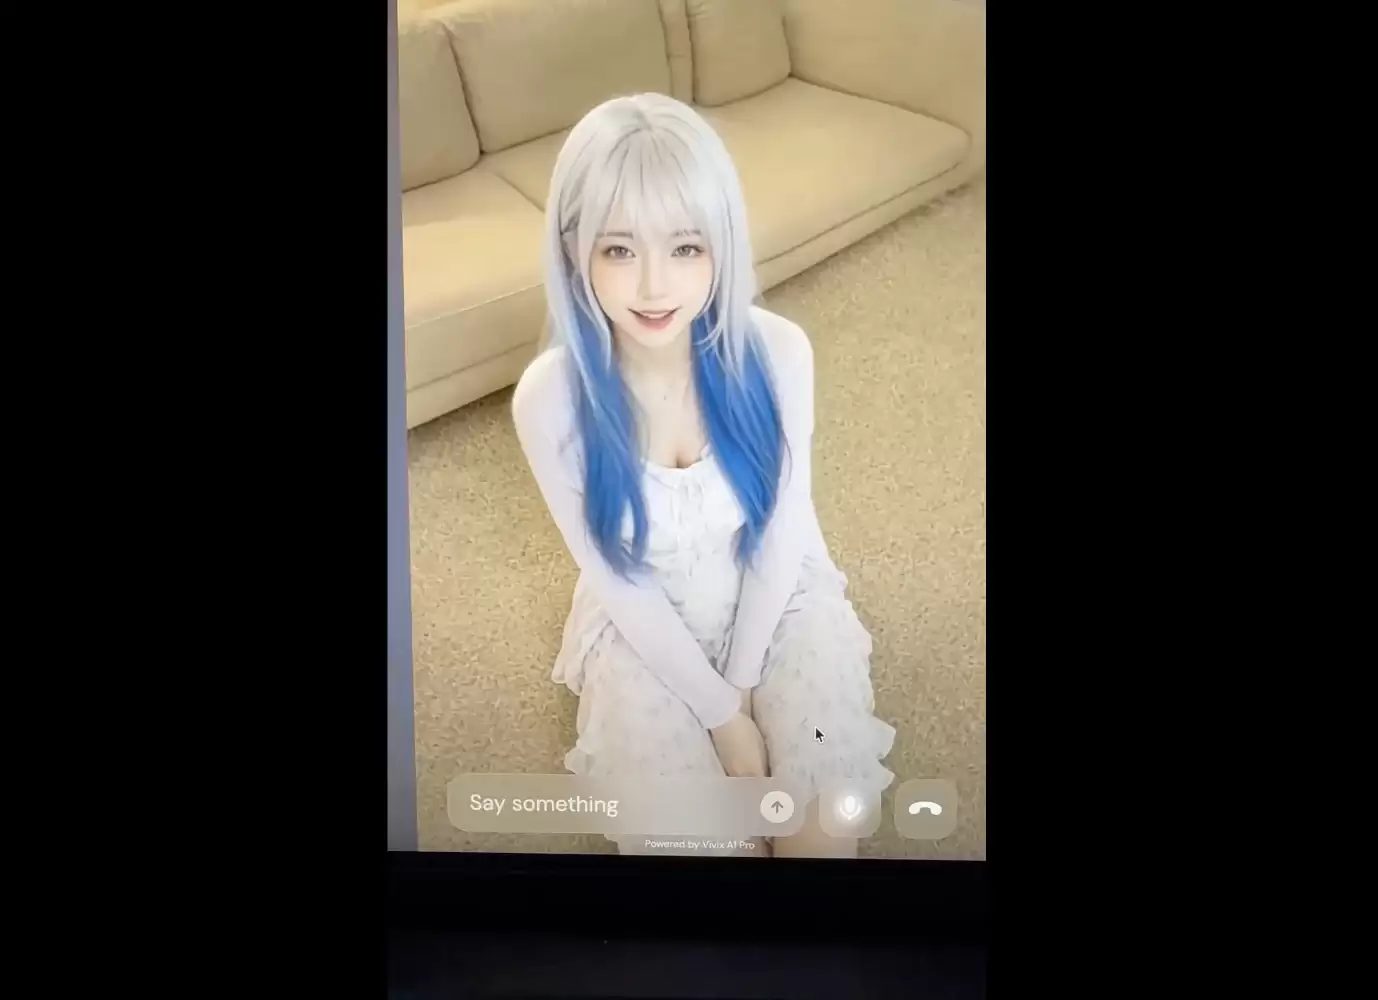
在此场景下,观感最突出的特点是角色的动作、表情与语音同步进行,看不出分别输出再拼接的痕迹。技术上,这源于A1的原生多模态建模方式:模型不经过语音识别文本作为中间表示,而是直接在多模态信号空间中完成感知与生成——语音语义、声学特征、环境声音、手势和视觉信号被统一建模,感知结果直接驱动角色行为,绕开了语音识别、语言模型到动作生成的级联架构。
在直播过程中通过语音调整方向,角色在自然的语句间隙完成切换,无需中断重来。
互动影视:一句话开启实时演进的故事
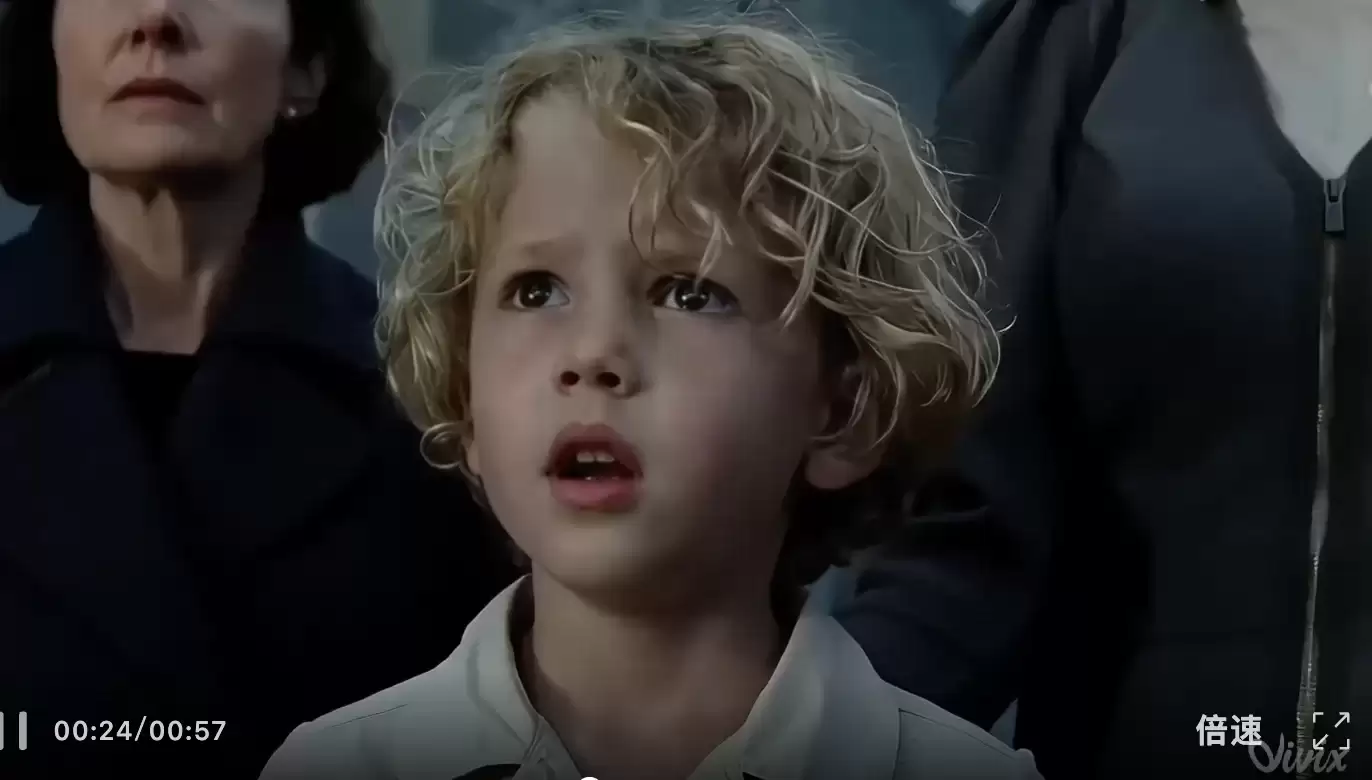
该场景主要展示W1的能力。只需输入一句“外星人入侵地球”,W1便会随即生成一段持续展开的音视频故事。内容开始生成后,用户仍可通过语音、文字、上传图片、点击或触控参与其中,实时改变故事走向。镜头切换、角色反应、对白、环境音和多镜头叙事在同一个生成过程中被原生协调,画面与声音同步产出,而非依赖预设分支或后期拼接。交互响应延迟低于1秒。
为何采用两个模型
A1是面向交互式AI角色的实时全双工模型。它开创性地支持完整全身角色生成与全身动作生成——过去的数字人主要负责将话说出来,而A1让数字人能够将事情做出来。角色不仅可以说话,还能行走、听见环境、产生情绪、改变姿态、跳舞、接近或拿起物体。用户中途用语音打断,角色的动作和回应随之改变,无需重新生成。之所以能做到这一点,是因为A1并非ASR + LLM + TTS的串联,而是原生多模态生成循环——语音、文字和图片不是一次性给定的条件,而是在互动中持续进入模型,中途改变角色正在做的事。
W1则面向互动叙事。其核心不是生成一个静态空间,而是生成一段持续变化的音视频故事。故事开始后,用户的语音、文字、点击、触控等操作持续进入模型,镜头切换、角色反应、环境音和剧情走向随之改变——这些并非后期拼接,而是模型原生同步生成的。交互响应延迟低于1秒。
A1做人,W1做故事——这一拆分不仅是优先级选择,也是能力依赖关系。人类在消费短视频、短剧和游戏时,70%到80%的注意力与人有关,角色是一切叙事的锚点。A1先解决单个数字角色的行动力问题——全身运动、物体交互、实时响应。W1在此基础上解决多角色、多镜头的叙事调度:当单个角色已能自主行动,才有可能让一个“导演”去协调多个角色之间的事件、对白和镜头关系,推动故事持续演进。换句话说,A1是W1的基础能力单元。
在数据管线层面,两款模型共享同一套基础设施。Vivix围绕“观测-交互-生成”构建交互数据三元组,通过数十个专项训练的专家模型完成自动化数据筛选与标注,目前已积累与头部视频模型相当规模的精标数据。
四大技术瓶颈解析
从效果倒推,Vivix这套系统要跑通,必须依次解决四个技术瓶颈。
如何在生成过程中接受新输入
目前主流的视频模型采用clip-based架构,依赖固定时间窗口和双向Attention,先看完全部输入再整体规划输出——画质好,但生成过程中无法塞入新指令。A1和W1采用因果生成:当前帧看不到未来,模型逐帧向前推。好处是随时能接住新输入,难点在于没有全局信息兜底,角色身份、物体关系、动作连贯性全靠模型自己在线维护。Vivix将多模态参考注入、因果时序建模和流式状态维护融入同一套架构中,使图片、语音、文字等信号在生成链路中持续发挥作用,而非仅在第一帧。
因果生成可交互,但速度不够快
视频扩散去噪通常需要4到8步。直觉上减少步数即可提速,但Vivix在W1-Turbo评测中发现事情并非如此简单——直接减步会同时带来动态性下降、细节丢失和长期漂移。不同去噪阶段分别承载语义、运动、细节和时序信息,每一步承载的能力维度不同,砍掉任何一步都不是在去冗余,而是在丢能力。为此,他们设计了MJD(Multidimensional Joint Distillation)蒸馏框架,按去噪阶段的能力分布做联合压缩,将扩散过程从约8步压缩到2步,评测中维持了8步基线下的运动表现和长期稳定性。
速度足够,但30B激活参数的算力成本仍高
4-bit量化是常见的降本手段,但用于视频扩散模型比语言模型困难得多。语言模型逐token生成,量化偏差基本各管各的;视频扩散去噪是连续过程,一步的微小偏差会沿时间轴一路传递,生成长度越远,漂移越严重。训练完再做量化(PTQ)无法堵住这一缺口。Vivix的做法是反向思路,以Blackwell NVFP4 GEMM为目标推理路径,在训练阶段就让模型适配4-bit数值分布,同时加入专门的去噪误差校正,抑制偏差的跨帧传导。据披露,FP4推理相对BF16基线生成质量近乎无损。
模型足够快,但系统调度跟不上
近期市场上陆续出现一些近似实时推理的视频生成模型,包括一系列实时视频“世界模型”。它们的实现方式通常基于小参数量(如1~5B)或较大的VAE压缩比(如16x16x8),牺牲了模型的capacity,导致模型效果要么不能有大运动,要么频繁出现较大artifacts。
从技术博客中可见,Vivix本次发布的两个模型有效激活参数接近30B,并采用8x8x4的高质量压缩率,计算下来每秒token吞吐需要做到前述工作的数十倍,这对模型推理成本和实时性带来了极大挑战。
为稳稳接住这条实时链路,Vivix还推出了VMI,即Vivix Model Infra。VMI将多模态编码和逐帧解码拆成两个独立服务——编码端吃大batch求吞吐,解码端跑实时链路求低延迟,两条线互不干扰。这一解耦直接影响打断体验:用户中途说了一句新指令,系统直接在解码链路中追加新输入,当前生成无需中断重来。执行引擎通过CUDA Graphs统一提交、计算通信融合至Mega Kernel,在消费级GPU上跑出单卡超10,000 video tokens/s,PCIe带宽利用率88%以上。
在Vivix-Bench的1000样本人工评测中,A1在运动动态和音画同步维度上相对现有方案有明显优势,在一致性维度上基本持平——这组数据提供了一个独立于官方指标之外的参考。
在消费级显卡配置下,上述系统的实测表现:首帧延迟(TTFF)< 0.6秒,端到端延迟(TTFR)< 1.7秒,原生打断300-900毫秒,实时推理成本低于每小时1美元(官方测试口径)。近30B激活参数模型在消费级显卡实时运行。
发布后的思考
A1和W1当然并非没有短板——A1在复杂快速运动和精细物体交互中仍有改进空间,W1的实时版本在视觉质感上与头部离线视频模型仍有差距。Vivix对此并不回避。
但近30B激活参数、2-Step Diffusion、消费级显卡实时生成——A1作为本次正式交付的核心已上线API,W1以Demo形式展示能力,平台将在后续阶段逐步开放。Vivix交付的不是一个交互概念,而是一套已经运行起来的原生流式多模态模型。这个方向是否成立,开发者现在可以自己去API上验证了。