

英伟达GB300再破世界纪录:256块GPU跑DeepSeek-v3算力提升50%
英伟达GB300用256块GPU驱动深度求索3671B模型,单GPU吞吐量达一千六百四十八万亿次浮点运算,较去年提升百分之五十,为上一代GB200的三倍。通过模拟超二十五万种配置、实施三十八项优化及一百四十万小时测试,系统级工程实现算力跃升,显著降低AI训练成本。
英伟达GB300再破世界纪录:256块GPU跑DeepSeek-v3,算力提升50%
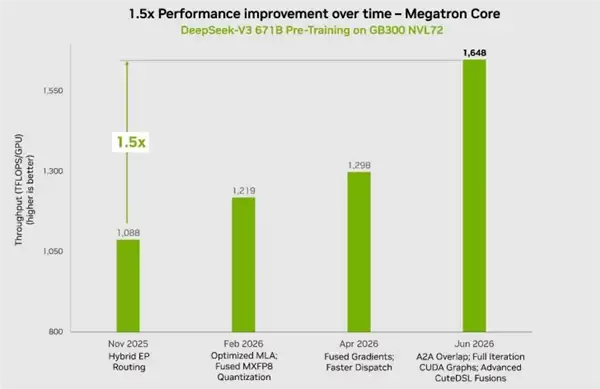
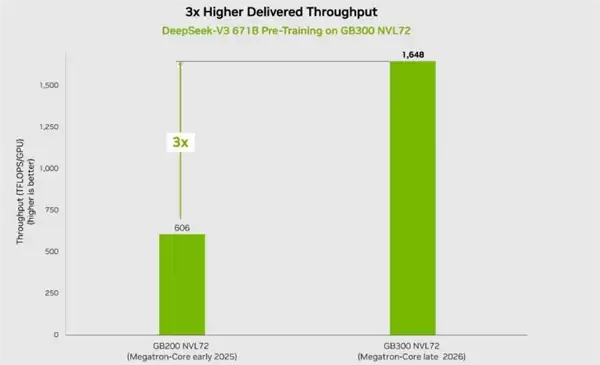
7月22日,英伟达放出了一个重磅消息:Blackwell GB300在MoE预训练上刷新了世界纪录。只用256块GPU就跑起了DeepSeek-v3 671B模型,单GPU吞吐量直接飙到1648 TFLOPs——这个数字意味着什么?对比去年11月的1088 TFLOPs,提升了整整50%;再往前看,上一代GB200只有606 TFLOPs,GB300差不多是它的3倍。
38项优化方案,140万小时测试
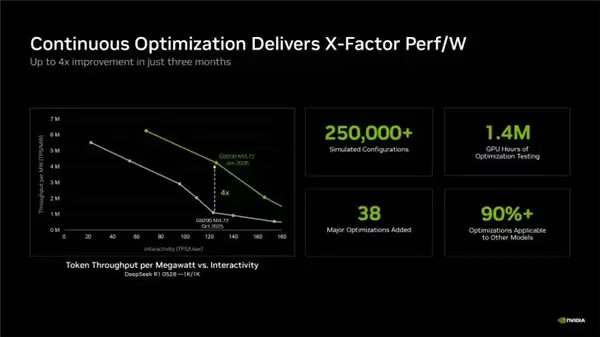
成绩背后是实打实的苦功。英伟达在过去6个多月里,模拟了超过25万种配置,从中摸索出38项重大优化方案,累计投入的GPU测试时长高达140万小时。这可不是简单的参数调优,而是系统级别的硬核工程。
MoE架构:低计算成本撑起大模型容量
简单科普一下:MoE(混合专家模型)就是把大模型拆成多个专家子网络,每次推理或训练只激活其中一部分。这样做的好处很明显——用更低的计算成本撑起更大的模型容量,如今已经是主流大语言模型的标准架构。
GB300降本增效,AI训练成本进一步下降
GB300 NVL72的厉害之处在于,用更少的GPU就能达到相同的训练性能。这意味着什么?AI训练成本会进一步下降,对大模型厂商来说,绝对是实实在在的利好。英伟达也表示,通过系统级优化的持续挖掘,Blackwell架构仍有性能提升空间,而这一轮优化成果将直接惠及所有使用GB300的AI训练集群。
对DeepSeek这类大模型厂商而言,GB300带来的算力跃升直接意味着更短的训练周期和更低的成本。单GPU 1648 TFLOPs的算力,足以支撑更大规模模型的快速迭代——这或许才是行业最值得期待的变化。