

Redis存取速度为什么这么快
Redis速度快源于五个设计决策:数据全存内存避免磁盘IO;采用SDS、哈希表、跳表等高效数据结构;单线程执行命令消除锁竞争与上下文切换;利用epoll多路复用单线程管理数万连接;RESP协议极简降低解析开销。这些因素协同使操作达到微秒级响应。
只要与数据库打过交道,就一定会听到“Redis很快”的说法。那么它到底有多快?一条SQL查询用户信息可能需要200毫秒,而换成Redis的GET user:1001,只需0.1毫秒就能完成。同样是“从存储中取一个值”,两者相差了2000倍。
Redis之所以这么快,并非单靠一个因素就能解释。它是由五个设计决策叠加在一起才实现的。下面就从这五个因素入手,详细解析Redis的速度之谜。
因素一:数据全部存储在内存中
最直观、也最核心的因素,就是Redis将所有数据都放在内存里。
CPU访问内存大约需要100纳秒,而访问磁盘则需要约10毫秒,两者相差十万倍。
MySQL的数据存储在磁盘上,虽然Buffer Pool可以缓存热数据,但Pool的大小有限,无法将整张表都放入内存。一旦查询的数据不在缓存中,就必须触发磁盘IO。
Redis则完全不同,所有数据都在内存中。当客户端发送一个GET命令时,Redis直接从内存中读取值并返回,没有任何磁盘IO参与。这就是0.1毫秒级响应时间的基础。
但“在内存中”只是入场券。同样是内存数据库,如果设计不当,速度依然会很慢。接下来的四个因素,决定了Redis在内存之上能做到多快。
因素二:高效的数据结构
Redis并非一个简单的key-value缓存。它支持String、Hash、List、Set、ZSet等多种数据类型,每种类型底层都采用了专门优化过的数据结构。
这些数据结构决定了操作的时间复杂度,而时间复杂度又决定了性能上限。
以String类型为例,Redis没有直接使用C语言原生的字符串(char*),而是自己设计了SDS(Simple Dynamic String)。SDS多存储了一个len字段来记录字符串长度,使得获取长度的操作从O(n)变为O(1)。同时,SDS会预分配多余空间,在追加字符串时无需每次都重新分配内存。
再看Hash类型。当字段数量较少时,Redis使用ziplist(压缩列表)存储,所有数据紧凑排列在一块连续内存中,节省空间。当字段数量超过阈值时,会自动转为哈希表,查找复杂度为O(1)。
最值得一提的是ZSet(有序集合)。ZSet需要同时支持“按score排序”和“按member查找”两个需求,Redis采用了两种数据结构组合实现:
- 哈希表:建立member → score的映射,实现O(1)的分数查询
- 跳表:按score排序的多层链表,支持O(log n)的范围查询
因素三:单线程处理命令
Redis处理命令时采用单线程模式,同一时刻只有一个命令在执行。
这听起来似乎反直觉——单线程不应该更慢吗?为什么不用多线程让多个命令同时执行?
因为Redis的瓶颈不在CPU,而在网络IO和内存访问。Redis的每个命令执行时间仅为纳秒到微秒级别,CPU根本不是瓶颈。真正耗时的是等待客户端请求通过网络到达。多线程不仅帮不上忙,反而会引入额外开销:
1. 锁竞争
多线程同时修改一个哈希表,必须加锁。加锁意味着线程需要等待、争抢,这些等待时间可能比命令本身的执行时间还要长。
2. 上下文切换
CPU在不同线程之间切换时,需要保存和恢复寄存器、缓存等上下文信息。这个过程本身就有开销,而且会导致CPU缓存失效,增加内存访问延迟。
3. 数据结构复杂度上升
为了让数据结构线程安全,要么加锁,要么使用无锁算法(CAS)。前者影响性能,后者增加代码复杂度。而在单线程下,这些都不需要考虑。
单线程的好处显而易见:没有锁竞争、没有上下文切换、代码实现简单、调试方便。Redis的作者antirez曾说过,单线程是他做出的最正确的设计决策之一。
Redis 6.0引入了多线程IO,但命令执行仍然是单线程。多线程只负责网络数据的读写——将数据从socket读出、将响应写回socket。命令执行这一步,依然是单线程串行。这说明Redis团队也认为,命令执行用单线程是正确的,瓶颈已经转移到了网络IO层面。
因素四:IO多路复用
Redis采用多路复用的IO模型,使其能够单线程处理上万个客户端连接。
在传统的阻塞IO模型下,一个线程处理一个连接。线程调用read()等待数据到达,如果没有数据,线程就会阻塞,无法处理其他任务。要同时处理1000个连接,就需要1000个线程。
IO多路复用改变了这一模型。它的核心思想是:一个线程同时监听多个连接,哪个连接有数据到达就处理哪个,其他的继续等待。
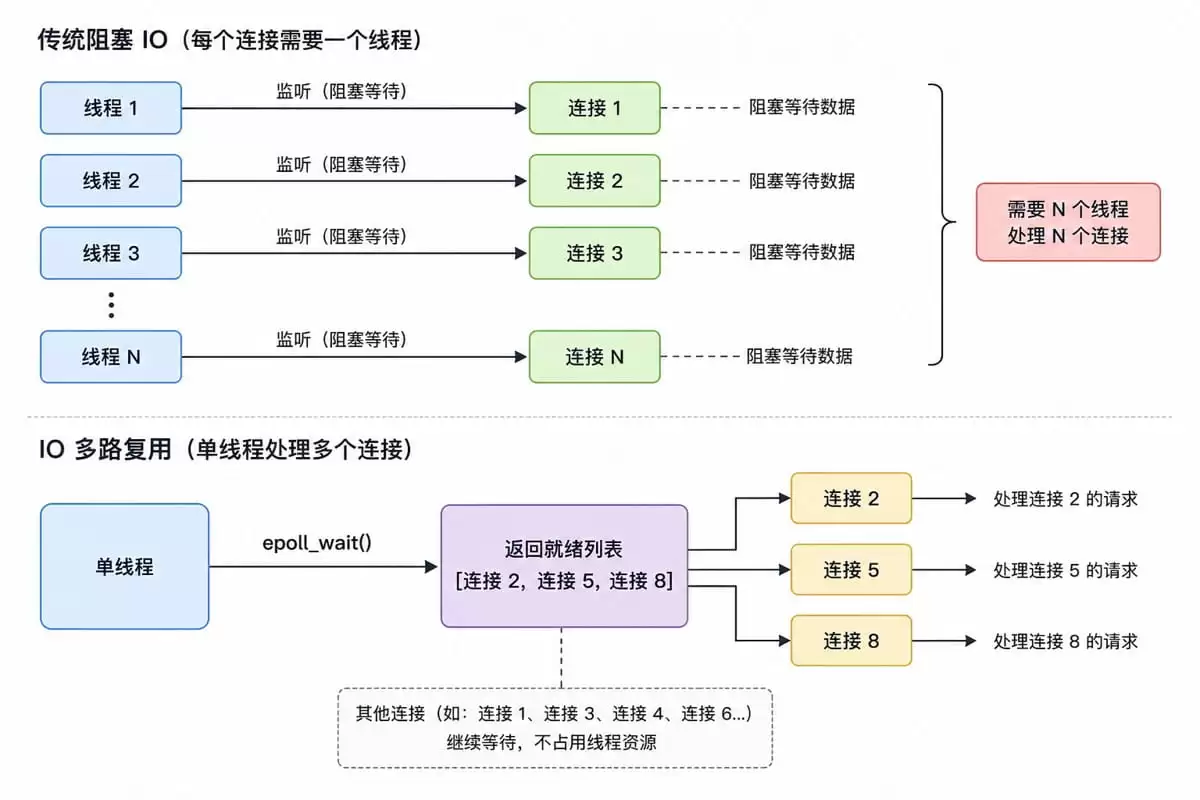
在Linux上,Redis使用epoll实现IO多路复用。epoll_wait()会返回所有就绪的连接列表,Redis遍历这个列表,依次执行每个连接发来的命令。由于命令执行本身很快(微秒级),这个遍历过程也非常快,一个线程就能支撑数万并发连接。
这也是为什么Redis的性能瓶颈通常不在CPU,而在网络。单线程处理命令绰绰有余,但网络带宽和延迟是有上限的。因此,在生产环境中,Redis通常部署在内网,并使用连接池复用连接,以减少网络开销。
因素五:RESP协议设计简单
Redis与客户端之间通信使用的是RESP(Redis Serialization Protocol)协议。这个协议设计得极其简单:
+OK\r\n                          → 简单字符串
-ERR unknown command\r\n         → 错误
:1000\r\n                        → 整数
$5\r\nhello\r\n                  → 批量字符串(5字节)
*2\r\n$3\r\nfoo\r\n$3\r\nbar\r\n → 数组
客户端发给Redis的命令,本质上就是一个字符串数组。例如GET user:1001,序列化后就是:
*2\r\n$3\r\nGET\r\n$10\r\nuser:1001\r\n
解析过程非常简单:按行读取,读到$就读取长度,再按长度读取数据。不需要复杂的状态机,也不需要处理嵌套结构,解析成本极低。
对比一下HTTP协议。一个HTTP请求需要解析请求行、请求头、空行、请求体,请求头是键值对但格式灵活,还有各种编码方式(chunked、gzip)。解析一个HTTP请求的开销远大于解析一个RESP请求。
协议越简单,解析越快,CPU开销越小。RESP就是专门为Redis的使用场景设计的——命令都是简单的字符串数组,不需要HTTP那样强大的表达能力。
小结
Redis快的本质是:在内存之上,用最合适的工具做最合适的事。高效的数据结构保证了操作的时间复杂度接近理论最优,单线程模型避免了锁竞争和上下文切换的开销,IO多路复用让一个线程就能管理成千上万的连接,RESP协议则将通信解析的成本压到最低。这五个因素不是孤立的,它们互相配合,构成了一个没有明显短板的系统。