

可回收垃圾目标检测数据集:5类13000张图像
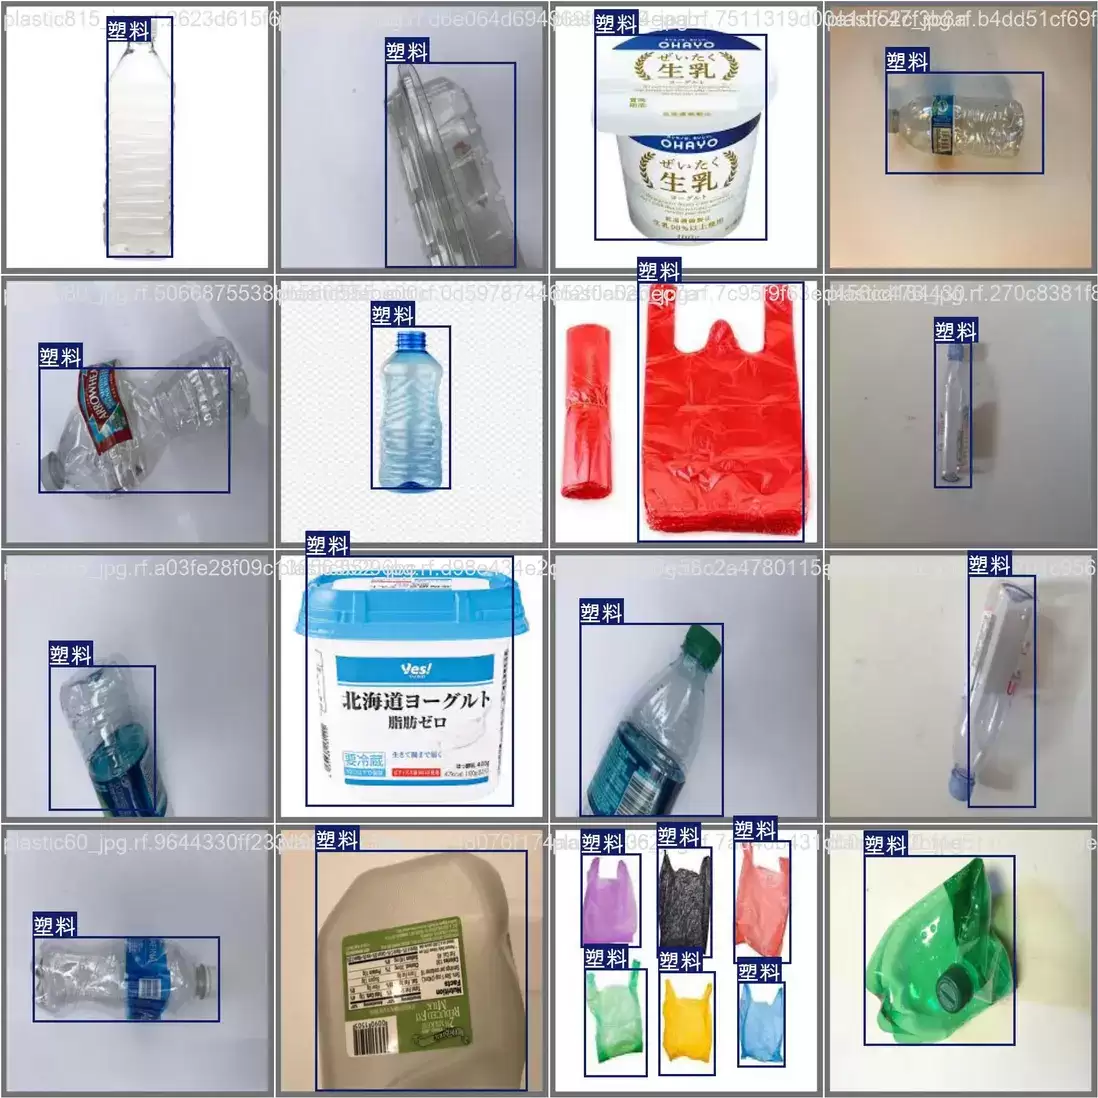
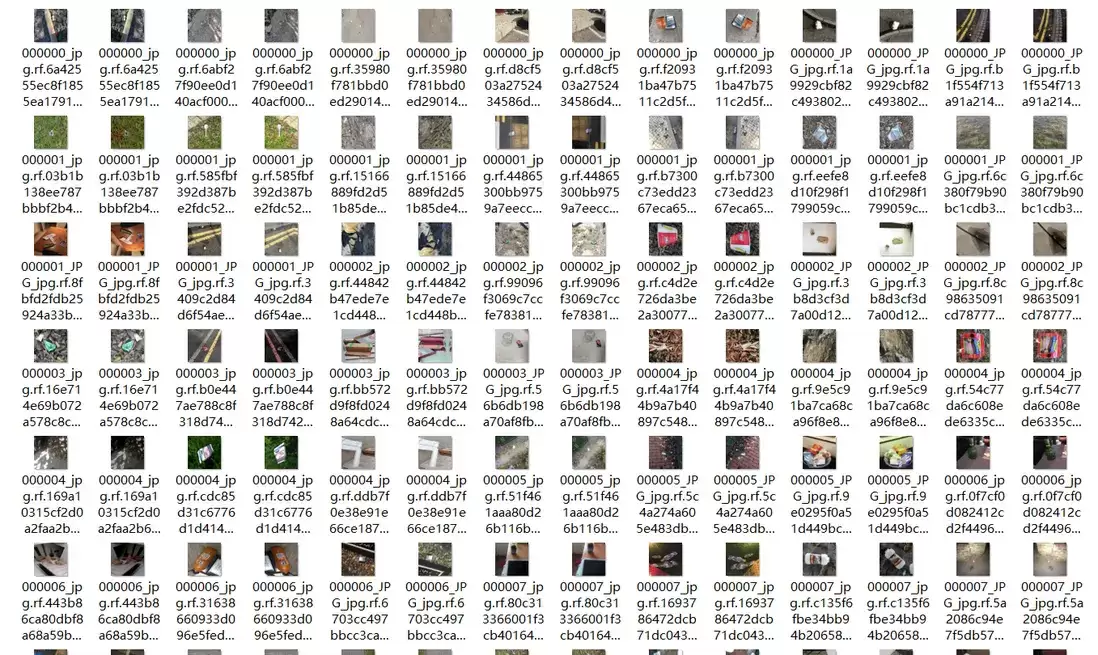
可回收垃圾目标检测数据集包含5类别(纸板、玻璃、金属、纸张、塑料)共13000张真实场景图像,采用YOLO格式边界框标注。该数据集覆盖社区、室内等典型环境,可有效支持深度学习模型训练与智能垃圾分类系统部署,具有突出的工程实用价值。
可回收垃圾目标检测数据集:5类别、13,000张图像 | 目标检测
一、垃圾分类与循环经济的宏观背景
1.1 全球循环经济发展趋势
说到循环经济,它本质上是对传统“取—制—丢”线性模式的一次彻底碘伏。核心思路就三个字:减量化、再利用、再循环——也就是常说的3R原则。目标是让经济增长和资源消耗真正脱钩,而不是一边发展一边透支环境。
在这个体系里,可回收垃圾能不能精准分类、高效回收,就成了整个链条最关键的环节。数据很有说服力:世界经济论坛统计,全球每年产生约20亿吨固体废弃物,但可回收材料的回收率只有可怜的13.5%。症结在哪?分类精度不足。大量本该进入再生链的材料,被混入其他垃圾,最终白白浪费。
1.2 中国垃圾分类政策推进
国内这边,自2019年上海率先强制垃圾分类以来,全国进入了全面推行阶段。按照住建部发布的《生活垃圾分类标志》标准,生活垃圾被分成四大类:可回收物、有害垃圾、厨余垃圾和其他垃圾。其中,可回收物是最有经济价值的一类,具体包括:
- 纸制品:纸板、报纸、书本等,回收后可以制成再生纸浆
- 塑料制品:塑料瓶、塑料包装等,回收后变成再生塑料颗粒
- 金属制品:易拉罐、金属罐等,回收后再生金属
- 玻璃制品:玻璃瓶、玻璃容器等,回收后再生玻璃
根据中国再生资源回收协会的统计,全国每年可回收物的回收价值超过1万亿元,但实际回收率还不足40%。瓶颈很明显:前端分类精度不够,导致大量高价值材料没法有效回流。
1.3 AI视觉技术赋能垃圾分类
传统垃圾分类面临的核心矛盾,说白了就是“分类精度”和“分类效率”之间的冲突。人工分类精度高,但效率低、成本高;简单传感器方案效率高,但精度差、能分的类别少。有没有两全其美的办法?
基于深度学习的视觉检测技术给出了全新的解法:
- 高精度识别:深度学习模型能从复杂背景中精准定位垃圾类别
- 多类别覆盖:同时识别多种垃圾类型,传感器方案根本做不到
- 实时处理:YOLO系列模型可以实现毫秒级检测,满足流水线速度要求
- 持续优化:通过数据积累和模型迭代,识别精度可以不断往上提
而这一切的前提,是得先有一份大规模、高质量、贴近真实场景的垃圾检测数据集。没有数据,再好的算法也是空中楼阁。
二、数据集全面解析
2.1 核心规格参数
| 参数项 | 具体数值/描述 |
|---|---|
| 图像总量 | 13000张 |
| 类别数量 | 5类(纸板、玻璃、金属、纸张、塑料) |
| 标注方式 | YOLO格式边界框标注 |
| 数据来源 | 真实生活垃圾分类场景 |
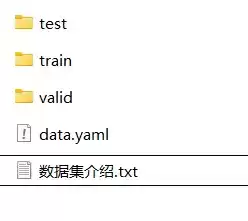
| 数据划分 | train / valid / test |
| 存储路径 | database/5类可回收垃圾数据集 |
| 适配模型 | YOLOv5/v8/v11、RT-DETR等 |
2.2 数据集规模的优势
13000张图像,在垃圾分类数据集里算得上较大规模了。这个体量能带来几个实实在在的好处:
充分的特征覆盖:每种垃圾类别都有足够多的样本,覆盖不同形态、不同角度、不同程度的遮挡,模型能学到更鲁棒的特征表示,而不是死记硬背。
降低过拟合风险:深度学习模型的参数量动辄数百万甚至数千万,数据量不够就容易过拟合。13000张的规模,能有效避免这种情况,提升模型的泛化能力。
支持多模型对比:数据量足够,就可以在同一份数据上公平地对比不同模型架构的表现,为项目选型提供可靠依据。
子集划分灵活性:如果需要针对特定场景(比如只做塑料和玻璃的检测),可以从数据集中灵活提取子集,不用重新标注。
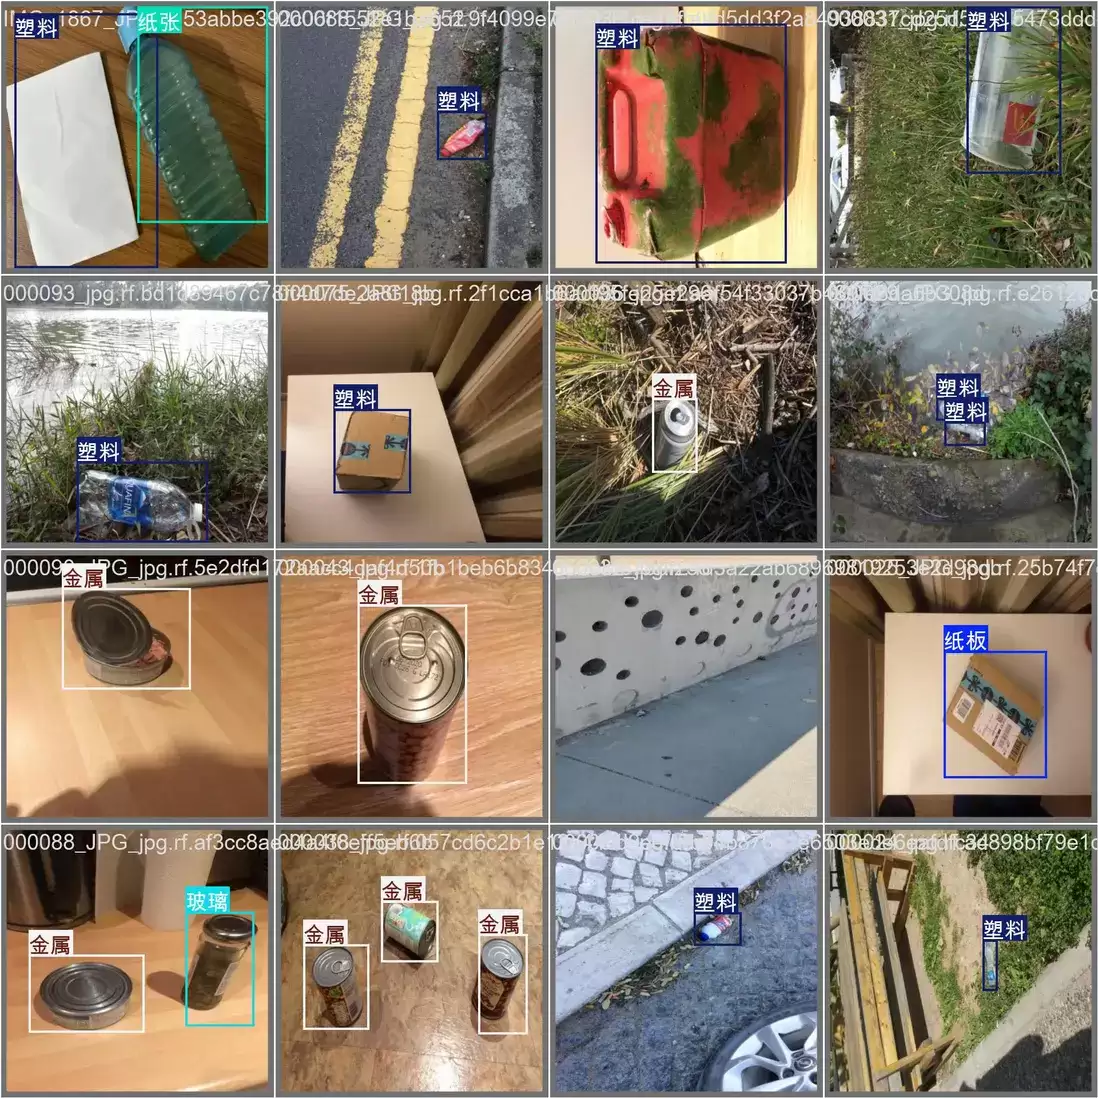
2.3 五类可回收垃圾详解
| 类别ID | 类别名称 | 典型物体 | 材质特征 | 识别难点 |
|---|---|---|---|---|
| 0 | 纸板 | 纸箱、纸板包装、快递盒 | 棕色/白色,有折痕纹理 | 变形后形状不规则,潮湿后颜色变化 |
| 1 | 玻璃 | 玻璃瓶、玻璃容器 | 透明/绿色/棕色,光滑反光 | 透明物体边界模糊,反光干扰 |
| 2 | 金属 | 易拉罐、金属盒、锡箔 | 金属光泽,硬质 | 压扁后形态变化大,与塑料易混淆 |
| 3 | 纸张 | 报纸、书本、废纸 | 白色/灰色,薄质 | 揉皱后形态复杂,与纸板区分 |
| 4 | 塑料 | 塑料瓶、塑料包装、塑料袋 | 透明/半透明/彩色 | 形态变化极大,塑料袋折叠后难以识别 |
2.4 类别设计理念
细心的朋友可能会注意到,数据集里把“纸板”和“纸张”分成了两个类别——它们虽然都是纸,但在回收处理工艺上差异很大。纸板是厚纸制品,回收后主要用于生产瓦楞纸板和包装材料,处理工艺相对粗放;纸张是薄纸制品,回收后用于生产再生纸浆和卫生纸,工艺要求更精细。把两者分开标注,训练出的模型就能直接服务于分拣环节的实际需求,而不仅仅是判断“这是不是纸”。这种贴合回收工艺的类别设计,正是这个数据集工程实用性的体现。
2.5 数据场景覆盖
数据集的图像全部来自真实生活场景,覆盖了垃圾分类的典型环境:
社区垃圾回收站:
- 户外环境,自然光照
- 垃圾桶内的俯拍视角
- 垃圾堆叠、部分遮挡
- 混合放置的多类别垃圾
室内垃圾分类箱:
- 室内环境,人工照明
- 投放口的近距离拍摄
- 单件或少量垃圾
- 背景相对简洁
公共垃圾投放点:
- 街道、公园等公共区域
- 光照条件多变
- 垃圾状态多样(完整/损坏/散落)
- 行人和车辆背景干扰
商业街垃圾区域:
- 商业场所产生的大量包装废弃物
- 纸板和塑料类占比高
- 垃圾密度大,遮挡严重
校园垃圾分类区域:
- 以纸张和塑料为主的校园垃圾
- 投放行为相对规范
- 垃圾完好度较高
三、模型训练实战
3.1 数据集配置
# recyclable_waste.yaml
path: database/5类可回收垃圾数据集
train: train/images
valid: valid/images
test: test/images

nc: 5
names:
  0: 纸板
  1: 玻璃
  2: 金属
  3: 纸张
  4: 塑料
3.2 基线模型训练
from ultralytics import YOLO

model = YOLO('yolov8s.pt')

results = model.train(
    data='recyclable_waste.yaml',
    epochs=200,
    imgsz=640,
    batch=32,
    patience=40,
    lr0=0.01,
    mosaic=1.0,
    mixup=0.15,
    hsv_h=0.015,
    hsv_s=0.7,
    hsv_v=0.4,
    degrees=15,
    translate=0.1,
    scale=0.5,
    fliplr=0.5,
    project='recyclable_waste',
    name='yolov8s_baseline'
)
3.3 针对垃圾检测场景的优化
遮挡与堆叠处理:
垃圾场景里,目标被遮挡是家常便饭。一个易拉罐可能被纸板盖住一半,一个塑料瓶可能嵌在垃圾堆里。这种情况下需要特殊的优化手段:
- 用Soft-NMS替代标准NMS,避免遮挡目标被直接抑制掉
- 增加Copy-Paste增强,把单独的目标粘贴到复杂背景里,模拟遮挡
- 适当调整置信度阈值,稍微降低一点以提升召回率
形态变化适应:
垃圾的形态变化之大,远超一般物体。压扁的易拉罐和完整的易拉罐,折叠的纸板和展开的纸板,揉皱的纸张和平整的纸张,压缩的塑料瓶和膨胀的塑料瓶——这些差异对检测模型的挑战不小。应对策略上:
- 在数据增强中加大仿射变换的幅度(旋转、缩放、剪切)
- 特意增加变形目标的训练样本
- 使用可变形卷积增强模型对形变的适应能力
透明物体检测:
玻璃和透明塑料的边界模糊,是公认的检测难点。解决方法可以多管齐下:
- 用边缘检测预处理增强边界信息
- 在数据增强中增加透明度变化
- 如果有RGB-D传感器,引入深度信息辅助判断
3.4 高级训练技巧
课程学习策略:
先易后难,符合人类学习规律,对模型训练也同样有效。第一阶段用简单样本(单目标、清晰背景)训练,让模型打好基础;第二阶段再逐步加入困难样本(多目标、遮挡、复杂背景)进行微调。具体实现如下:
# 第一阶段:简单样本训练
model.train(data='recyclable_waste_easy.yaml', epochs=50)

# 第二阶段:全量数据微调
model = YOLO('recyclable_waste/yolov8s_easy/weights/best.pt')
model.train(data='recyclable_waste.yaml', epochs=100, lr0=0.001)自训练半监督:
如果有大量未标注数据,可以利用自训练的方式进一步提升模型性能:
- 先用已标注数据训练初始模型
- 用初始模型对未标注数据生成伪标签
- 筛选出高置信度的伪标签样本
- 合并有标签和伪标签数据,重新训练
四、工程部署全链路
4.1 智能垃圾桶方案
智能垃圾桶是AI垃圾分类最直接的落地场景。整体架构可以分为三层:
硬件层:
- 高清摄像头:安装在投放口上方,捕捉投放物品的图像
- 计算模块:瑞芯微RK3588或类似NPU设备,负责运行模型
- 执行机构:电动分拣门,根据分类结果引导垃圾进入对应仓室
- 显示模块:LCD屏显示分类结果和使用指引
软件层:
- 图像采集:实时拍摄投放口图像
- 目标检测:运行YOLO模型,识别垃圾类别
- 结果过滤:基于置信度和时序逻辑,过滤掉误检
- 控制输出:控制分拣门开启对应通道
交互设计:
- 投放时实时识别,并语音播报分类结果
- 分类错误时提示用户正确投放
- 记录每次投放的类别和重量数据,用于后续分析
4.2 分拣流水线方案
在垃圾分拣中心,AI视觉系统部署在传送带上方,属于典型的工业视觉应用:
系统布局:
- 传送带速度:1-2米/秒
- 摄像头间距:1-2米
- 每个摄像头覆盖宽度:0.5-1米
- 推理延迟要求:小于100毫秒
技术方案:
- 多摄像头协同,覆盖整条传送带
- 高帧率检测(30FPS以上),确保不遗漏
- 机器人或气阀执行分拣动作
- 实时统计分拣数量与类别分布
4.3 环卫机器人方案
移动式环卫机器人在户外环境中自动巡检和清理,是更具前瞻性的应用场景:
核心技术:
- 移动平台导航(SLAM)
- 垃圾目标检测与定位
- 机械臂抓取控制
- 垃圾分类与暂存
模型适配:
- 使用轻量化模型(如YOLOv8n)适配边缘计算设备
- 多尺度推理,适应不同距离的垃圾检测
- 时序追踪,避免重复检测同一个目标
4.4 性能监控与模型迭代
部署不是终点,持续监控和迭代才是系统长期有效运行的关键:
监控指标:
- 各类别的检测精度变化趋势
- 误检和漏检案例的统计
- 推理延迟波动
- 业务指标(分拣准确率、吞吐量)
迭代流程:
- 收集线上误检/漏检案例
- 人工审核并标注
- 加入训练集重新训练
- A/B测试验证改进效果
- 灰度发布新模型,逐步替换旧版本
五、垃圾分类AI系统的业务价值
5.1 经济效益分析
| 应用场景 | 传统方案成本 | AI方案成本 | 效率提升 | 投资回收期 |
|---|---|---|---|---|
| 智能垃圾桶 | 人工值守5万/年/点 | 设备2万+运维0.5万/年 | 24小时无间断 | 约1年 |
| 分拣流水线 | 人工分拣20人/线 | AI系统+5人/线 | 3倍吞吐量 | 约2年 |
| 环卫机器人 | 人工清扫10万/年/区 | 设备8万+运维1万/年 | 覆盖面积2倍 | 约2年 |
5.2 环保效益
- 提升可回收物回收率,减少资源浪费
- 降低填埋和焚烧的比例,减少环境污染
- 推动分类习惯养成,提升全民环保意识
- 为循环经济提供高质量的原料来源
5.3 社会效益
- 创造AI+环保领域的新型就业岗位
- 提升城市精细化管理水平
- 推动环保科技产业发展
- 增强公众对AI技术的正面认知
六、技术前沿与发展趋势
6.1 多模态融合检测
结合RGB图像与深度信息,可以更准确地识别透明物体(玻璃、塑料)和判断物体厚度(纸板vs纸张)。RGB-D传感器(比如Intel RealSense、Azure Kinect)的成本正在持续下降,让多模态方案在工程部署中越来越可行。
6.2 少样本学习
实际部署时,很可能遇到训练集中没有覆盖的垃圾类型。少样本学习技术允许在只有少量新类别样本的情况下,快速扩展模型的识别能力,而不需要从头重新训练。
6.3 端云协同推理
对于遮挡严重、形态罕见的复杂样本,边缘设备上的轻量级模型可能无法给出可靠判断。端云协同方案的做法是:把低置信度的样本上传到云端,由更大规模的模型进行二次判断,这样就能兼顾实时性和精度。
6.4 生成式数据增强
利用扩散模型等生成式AI技术,可以合成各种形态、各种环境下的垃圾图像,有效扩充训练数据集。尤其是在罕见类别和极端场景的数据补充上,这种方法潜力巨大。
七、数据集使用建议
7.1 推荐训练流程
- 使用数据集训练基线模型,评估整体mAP
- 分析混淆矩阵,找出易混淆的类别对
- 针对易混淆类别,增加数据增强或调整损失权重
- 在验证集上评估改进效果
- 在测试集上做最终评估
- 收集线上的bad case,持续迭代优化
7.2 与其他数据集联合使用
本数据集可以和其他垃圾分类数据集联合使用,进一步扩大训练规模和数据覆盖。不过联合使用时需要注意几点:
- 统一标注格式和类别映射
- 检查类别定义是否一致(比如“纸板”和“硬纸板”是不是同一个东西)
- 平衡不同来源数据的比例,避免数据偏差
- 在验证集上评估联合训练的实际效果
7.3 迁移学习策略
把本数据集训练的模型作为预训练模型,迁移到特定场景的垃圾分类任务中,是效率很高的做法:
- 特定场景微调:比如校园、商场、医院等场景,用少量本地数据微调即可
- 类别扩展:增加新的垃圾类别(比如电子产品、纺织品),只需要新类别的标注数据
- 精度提升:换用更大的模型或增加更多数据,可以进一步提升精度
八、总结
这份5类可回收垃圾检测数据集,以13000张高质量标注图像,覆盖了纸板、玻璃、金属、纸张、塑料这五类核心可回收垃圾,为智能垃圾分类视觉检测系统提供了坚实的数据基础。规模优势、真实场景覆盖和标准化结构,让它在同类数据集中具备突出的工程适配性和实用价值。
从更宏观的视角看,垃圾分类AI技术正处于从技术验证走向规模化应用的关键阶段。随着数据资源的丰富、算法的进步以及硬件成本的下降,基于视觉的智能垃圾分类系统将在社区、商业区、垃圾处理中心等各类场景中加速落地,真正推动循环经济的发展和绿色城市的建设。