

D Gaussian Splatting原理:从规范高斯到形变场
4D-GS采用因子分解形变场替代逐帧跟踪,仅维护一组规范高斯体,通过HexPlane将4D空间分解为六个2D平面,利用神经网络预测形变偏移,并锁定颜色和不透明度以强制学习物理运动,实现高效动态场景渲染。
实时渲染动态3D场景从来都是一个棘手的难题——现实世界压根儿就不是静止的:人在走动、液体在流动、物体在变形。把3D高斯泼溅(3D-GS)扩展到动态场景(也就是4D),听起来不过是多加一个时间维度、逐帧跟踪每个点就行了,但实际操作起来,显存瓶颈首先就把人卡得死死的。
4D Gaussian Splatting(4D-GS)的架构设计其实相当巧妙。它用一个因子分解的形变场替代了暴力跟踪,绕开了动态渲染中显存爆炸的坑。这篇文章就来拆解一下,它到底是怎么做到的。
显存瓶颈:原始跟踪方式为何行不通
要理解4D-GS的精妙之处,得先弄清楚它要解决什么问题。
传统的动态NeRF会把一个8维输入空间(坐标x、方向d、时间t、潜在编码λ)映射到颜色和密度,其中λ用来处理表面分裂或合并这类拓扑变化。这套方案效果不错,但NeRF的隐式表示天然限制了渲染速度。
3D-GS则把场景显式表示为数百万个类似“点”的高斯体,依靠光栅化实现快速渲染,一举解决了速度问题。但问题也随之而来:如果为每一帧都存一份每个高斯体的位置、旋转和缩放参数(假设有1亿个高斯体×100帧),显存需求会呈线性爆炸式增长。
4D-GS选择了一条截然不同的路:彻底放弃逐帧存储高斯体,只维护一组规范(canonical)的3D高斯体,再用一个轻量级的神经网络作为形变场,来计算这组基础高斯体在任意时间戳下该如何位移、拉伸、旋转。
渲染方程因此被简化为:
G' = G + ΔG
换句话说,形变后的场景G',等于静态基线G加上神经网络预测的变化量ΔG。
拆解形变场
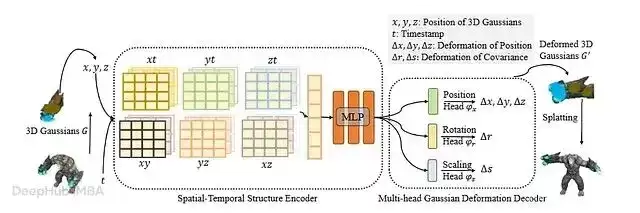
那么,如何在不引发显存爆炸的前提下算出这个ΔG?4D-GS把这个任务拆成了两个阶段:一个当“观察者”(编码器),一个当“导演”(解码器)。
1、时空结构编码器(观察者)
要让一个点发生形变,你得先知道它的上下文:位置在哪、此刻是什么时间、邻居在做什么。
最朴素的做法是把整个场景塞进一个庞大的4D神经体素网格(坐标x、y、z加时间t),但O(N)的显存开销根本不现实。4D-GS借鉴了HexPlane和K-Planes中的一个关键技巧:分解。
它把庞大的4D空间“拍平”成6个轻量级、多分辨率的2D平面:
- 空间平面:XY、XZ、YZ
- 时间平面:XT、YT、ZT
当网络需要查询一个连续的高斯体坐标(比如μ = (1.234, 5.678, 2.0))在时间t上的值时,这个坐标通常不会恰好落在网格顶点上。编码器会用双线性插值,在每个平面上找到最近的四个网格角点,算出距离加权平均值,从而提取出6个特征向量。
这6个向量通过逐元素(Hadamard)乘积捆绑在一起:
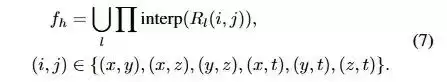
得到的稠密向量f_h,再被送入一个很小的MLP,最终输出压缩后的上下文向量f_d。
HexPlane怎么初始化
网络能不能训练好,很大程度上取决于起点。4D-GS里六个特征平面的初始化方式,就很值得细品。在第一次前向传播之前,显式特征网格需要先填好数值:空间平面(XY、XZ、YZ)用[0.1, 0.5]区间内的均匀随机值初始化,给网络留出学习空间特征的余地;而时空平面(XT、YT、ZT)则统一初始化为1。
为什么时间特征要设成1?
道理很简单:不同平面的特征是通过逐元素相乘组合的。如果时间特征是1,乘上空间特征不会有任何变化——x × 1 = x。
这样一来,模型一开始的行为,就等同于把整个世界当成静止的。这是刻意为之:网络不预设到处都有运动,而是从静态场景出发,只有当损失函数说明“必须靠运动才能解释观测数据”时,它才会去修改时空特征。
换句话说,运动不是模型自带的,得靠优化过程“挣”出来。这种设计让网络只会在真正存在运动的地方学习形变,最终得到的动态场景表示也更稳定、更符合物理规律。
2、多头解码器(导演)
拿到上下文向量后,多头解码器需要把f_d翻译成具体的物理指令。几个独立的线性头分别预测:
- 位置偏移:ΔX
- 旋转偏移:Δr
- 缩放偏移:Δs
这些偏移值加到规范高斯体上后,整个场景就交给了可微分光栅化器,进行实时的、基于图块的splatting。
不过,这里有一个很有意思的架构限制:4D-GS的主流程并不预测颜色ΔC或不透明度Δα的变化。
为什么要卡死这两项?因为神经网络一旦有机会偷懒,就一定会偷懒。要是能自由修改颜色和不透明度,网络完全可以“作弊”:不老老实实把高斯体从A点挪到B点,而是把A点的不透明度调成零、B点调成一,颜色再闪一闪,就伪造出物体在移动的假象。
这样一来,场景的物理几何结构就被破坏了,下游的3D跟踪也没法做。锁死颜色和不透明度,等于逼着网络去学习真正的物理形变。(作者也提到,对于流体或极端非刚性运动这类边缘情况,可以重新打开ΔC和Δα的预测。)
损失函数与训练过程
从零开始训练一个动态场很容易乱套:优化器要同时搞清楚基础几何和运动。4D-GS采用了两阶段训练来稳住这个过程。
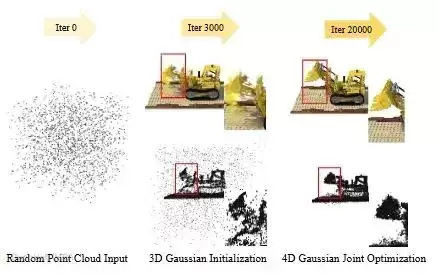
- 静态预热: 前3000次迭代里,形变场完全关闭,模型的行为等同于一个普通的3D-GS,强制规范高斯体先找到最优的静态几何结构。
- 4D优化: 打开形变场,网络开始预测运动,通过可微分的splatting渲染图像并计算损失。
目标函数在准确性和平滑性之间做了权衡:
L1损失用来约束渲染结果匹配真实图像;全变分损失L_tv则直接作用在HexPlane网格上,惩罚相邻网格单元间的剧烈跳变,从数学上强制运动保持平滑和连续。
反向传播:两条路径
splatting函数S是可微分的,因此总损失L可以通过链式法则一路反传回整个流程。
反向传播时,优化器会计算损失相对于所有可学习参数的梯度,这些梯度会分成两条路径。
路径A:更新规范高斯体(G)
梯度会一路传回基础的规范点云,更新起始位置和属性。dL/dG更新基础几何,保证规范形状的准确性。
路径B:更新形变场(F)
梯度经过加法操作G' = G + ΔG后,流入神经网络,调整网络对运动的预测方式。
这就需要一套非常精细的学习率调度,来保证训练的稳定性:
解码器权重(θD):dL/dθD更新多头MLP的权重。论文里这部分训练得比较保守,学习率从1.6 × 10衰减到1.6 × 10。
HexPlane特征(Rl):dL/dRl更新六个多分辨率HexPlane里存储的实际特征值。这些是显式网格参数,不是深度网络权重,因此学习速度更快一些,学习率从1.6 × 10衰减到1.6 × 10。
跑完最多20000次迭代后,规范高斯体会逐渐稳定到最优的基础形状,HexPlane和MLP也不断调整参数,直到预测出的形变能够准确还原视频里的动态。
多视角与单目:两种不同的现实
动态渲染器的真正考验,在于数据输入的方式。在多视角场景下(比如Neu3D),15到20台相机同时拍摄,网络每个时间戳只计算一次4D形变,但会从20个角度分别进行splatting、分别计算损失。密集的反馈信息能有效防止模型为了骗过单一视角而把几何结构“压扁”。而在单目场景下(比如D-NeRF),只有一个相机角度,网络不得不依靠HexPlane的时间连续性去推断3D运动。
在HyperNeRF这类相机本身也在向前移动的数据集里,形变场很容易陷入局部极小值,难以把相机的运动和被拍摄主体的运动区分开。极端快速的运动,叠加缺乏多视角重叠的场景,对目前的编码器设计来说,依然是一个不小的挑战。
总结
从静态点云渲染跳到动态渲染,绝不仅仅是多加一个时间变量那么简单。信息的存储和查询方式,需要整个重新设计。
- 用形变取代跟踪: 只维护一组规范高斯体、预测形变,显存开销取决于运动网络的复杂度,而不是视频的长度。
- 分解是核心: 把4D空间因子分解成六个2D平面,靠双线性插值快速查询特征,绕开了4D体素的O(N)显存问题。
- 用约束换真实: 不让网络碰颜色和不透明度,逼着它去学真正的物理运动。代价是多花点训练技巧,但换来的好处是,渲染之外还能做3D跟踪。
所以,4D-GS靠着合适的因子分解和几个关键约束,让显式表示也能轻松搞定时间维度,而不用牺牲让它一开始就站稳脚跟的实时性能。