

VueRouter进阶:动态路由与嵌套路由详解
Vue Router 进阶:动态路由、参数传递与嵌套路由完全指南 前端路由是单页应用的核心机制。掌握参数传递与嵌套路由,意味着能够独立设计诸如“电商商品列表 → 商品详情”、“资讯首页 → 分类 → 文章详情”这类多层跳转结构。面试中,关于“query 与 params 区别”和“路由钩子执行顺序”
Vue Router 进阶:动态路由、参数传递与嵌套路由完全指南
前端路由是单页应用的核心机制。掌握参数传递与嵌套路由,意味着能够独立设计诸如“电商商品列表 → 商品详情”、“资讯首页 → 分类 → 文章详情”这类多层跳转结构。面试中,关于“query 与 params 区别”和“路由钩子执行顺序”的问题几乎是必考题。这篇文章会把 Vue Router 进阶的核心知识点逐个拆解,顺便聊聊实际开发中那些容易踩的坑。
一、路由导航:声明式与编程式的选择
声明式导航,就是在模板中用 标签。点击链接,路由就跳转了。
编程式导航,则是在 Ja vaScript 方法里调用 this.$router.push() 或 this.$router.replace() 来实现。这种做法很灵活,特别适合在跳转前需要执行一些逻辑的场景,比如表单校验或者权限检查。
关于 router-link 的底层原理,可以把它想象成这样一段简化逻辑:
{{ slot }}
这里的 .prevent 是关键,它拦截了浏览器对 a 标签默认的整页刷新行为,从而让 SPA 在不重新加载页面的情况下完成路由切换。真正的源码还会处理鼠标中键点击、计算激活类名这些事,但核心就是“拦截点击 + 调用 push”。理解了这个等价关系,就能明白为什么有时候给 router-link 绑定 @click 不生效——得用 @click.native 才能监听到原生的点击事件。
$router.push() 和 $router.replace() 的主要区别在于对历史栈的操作:push 是往历史栈里加一条记录,用户可以点“后退”返回;replace 则是替换当前栈顶的记录,用户就无法后退到这一页了。
示例一:声明式导航的三种写法
      首页 |
      新闻列表 |
      商品列表 |
      个人中心


      首页 |
      新闻列表 |
      商品列表 |
      个人中心


      首页 |
      新闻列表 |
      商品列表 |
      个人中心
第三种写法通过 name 跳转的好处是:当路径需要修改时,只需要改动路由配置,所有导航链接都不用动。对于大型项目来说,这种做法是值得推荐的。
示例二:编程式导航
登录
$router.go(n) 可以接受正整数(前进)或负整数(后退),go(-1) 等同于 back()。
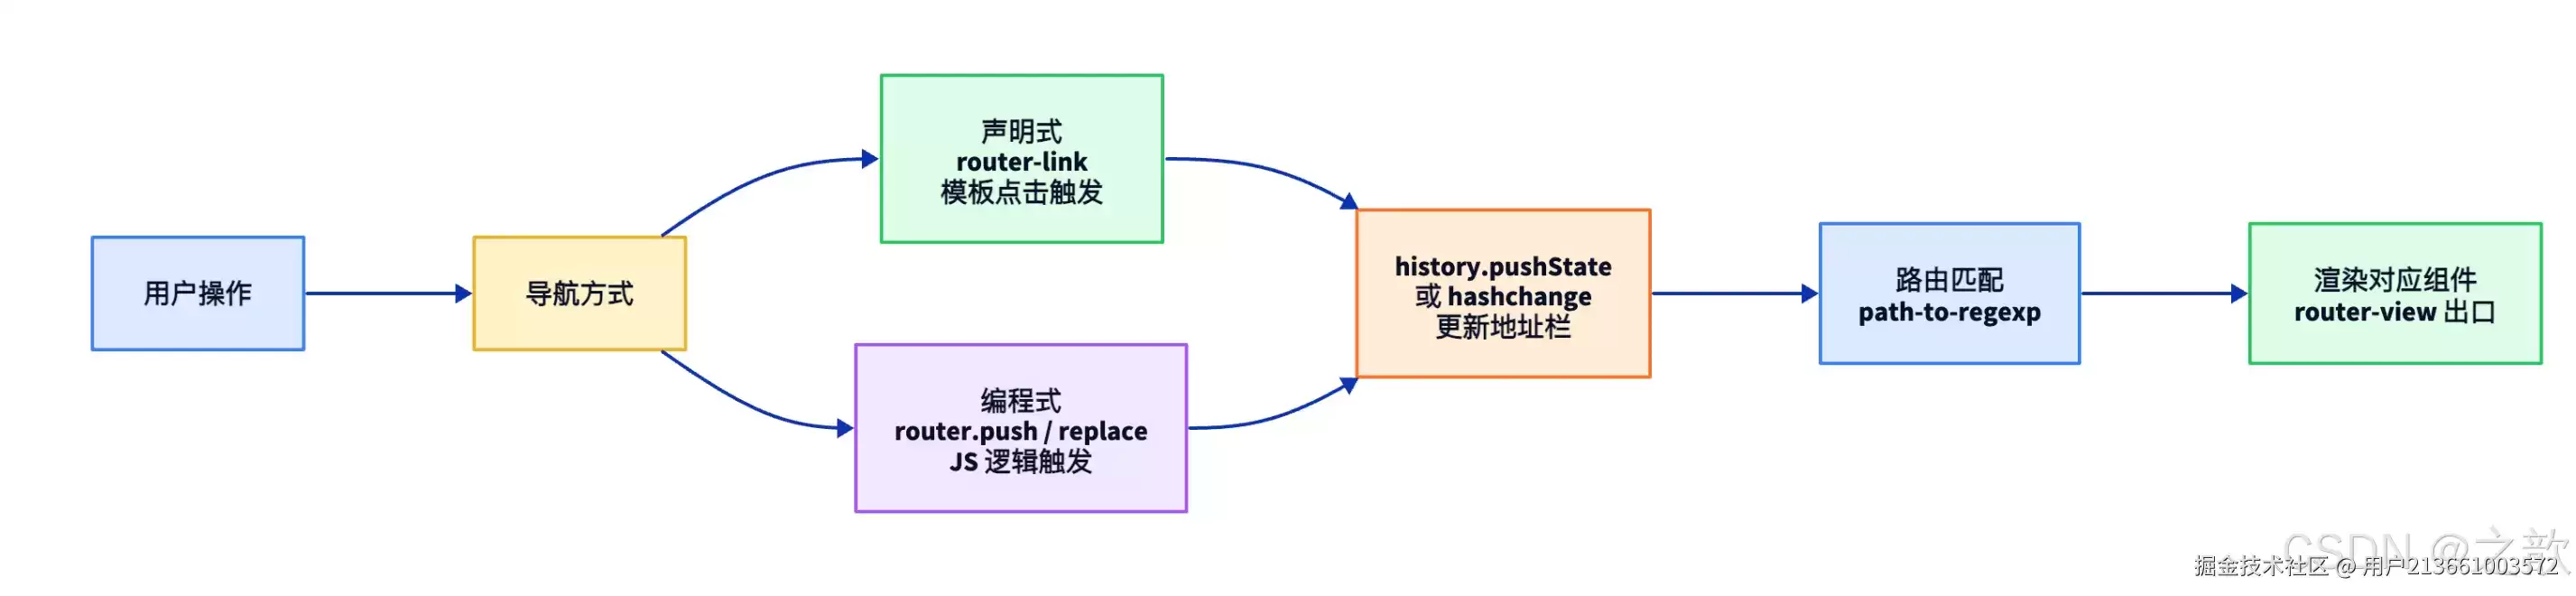
这张图揭示了一个常被忽视的事实:声明式和编程式导航只是触发入口不同,它们最终都会汇流到 History API 这条线上。可以这样理解,router-link 内部本质就是在监听点击事件,然后调用 router.push;两者共用同一条处理流程——更新地址栏、做路由匹配、在 router-view 里渲染目标组件。所以,它们在历史栈操作、守卫触发和激活样式上的表现是完全一致的。比如表单提交成功后用 router.push 跳转,而面包屑用 router-link 渲染,两者混用也不会出问题,正是因为共享了这条底层链路。
实战要点:如果需要传递复杂对象,或者在业务逻辑执行完成之后才跳转,就必须用编程式导航。声明式导航更适合用在纯展示性的顶部或侧边导航栏上。
面试考点:push 和 replace 的区别?push 是往历史栈里追加记录,replace 是替换当前记录,差异体现在用户能不能通过浏览器的后退键回到上一页。
二、路由组件的专属钩子函数
当用户从路由 A 切换到路由 B 时,Vue Router 会触发一系列生命周期钩子,它们与组件的挂载和销毁过程高度交织。路由切换的整个过程遵循严格的时序,Vue Router 会先挂载目标组件 B,在 B 组件的 mounted 钩子执行之前,再销毁原来的组件 A。这样设计的目的是保证两个组件交接时不会出现“空白期”。
完整的执行顺序如下:
A 路由 → B 路由的切换时序:
1. B->beforeCreate    (B 组件开始创建)
2. B->created
3. B->beforeMount     (B 组件即将挂载)
4. A->beforeDestroy   (A 组件开始销毁)
5. A->destroyed       (A 组件销毁完成)
6. B->mounted         (B 组件挂载完成)
这意味着在 B 组件完全进入视图之前,A 组件已经销毁完毕。这个时序表是面试中的“标准答案”。要特别注意第 3 步和第 4 步的相对位置:B 都已经走到 beforeMount 了,A 才开始 beforeDestroy。原因是 Vue Router 采用了一种类似“先进后出”的策略——先把新组件准备到即将落地的状态,确认无误后再拆除旧组件,最后让新组件 mounted。在实际应用中,如果你发现“离开页面时旧组件里的定时器还触发了一次”,多半就是把清理逻辑放在了比 beforeDestroy 更晚的位置,对照这张时序表就能定位问题。
示例:观察路由切换的钩子顺序
首页界面
在这个例子中,Home 组件在六个关键钩子里都打了日志,并按实际执行顺序编排了序号(1-4 是初次挂载,8-9 是被切走时的销毁)。mounted 里强调了“此时才能安全访问 DOM 并发起请求”,beforeDestroy 里则强调了“路由离开时是进行清理的时机”。把序号埋进日志是观察时序最直接的办法——切换路由后看控制台数字是否连续递增,就能验证理论上的时序是否正确。当你排查“切走页面后仍然报错”的问题时,临时在各钩子里打日志,往往是定位问题最快的方式。
从 Home 切换到 NewsList 后,控制台的输出顺序会是 5→6→7→8→9→10。关键点在于:NewsList 的 beforeMount(第 7 步)先于 Home 的 beforeDestroy(第 8 步),但 NewsList 的 mounted(第 10 步)却在 Home 的 destroyed(第 9 步)之后。
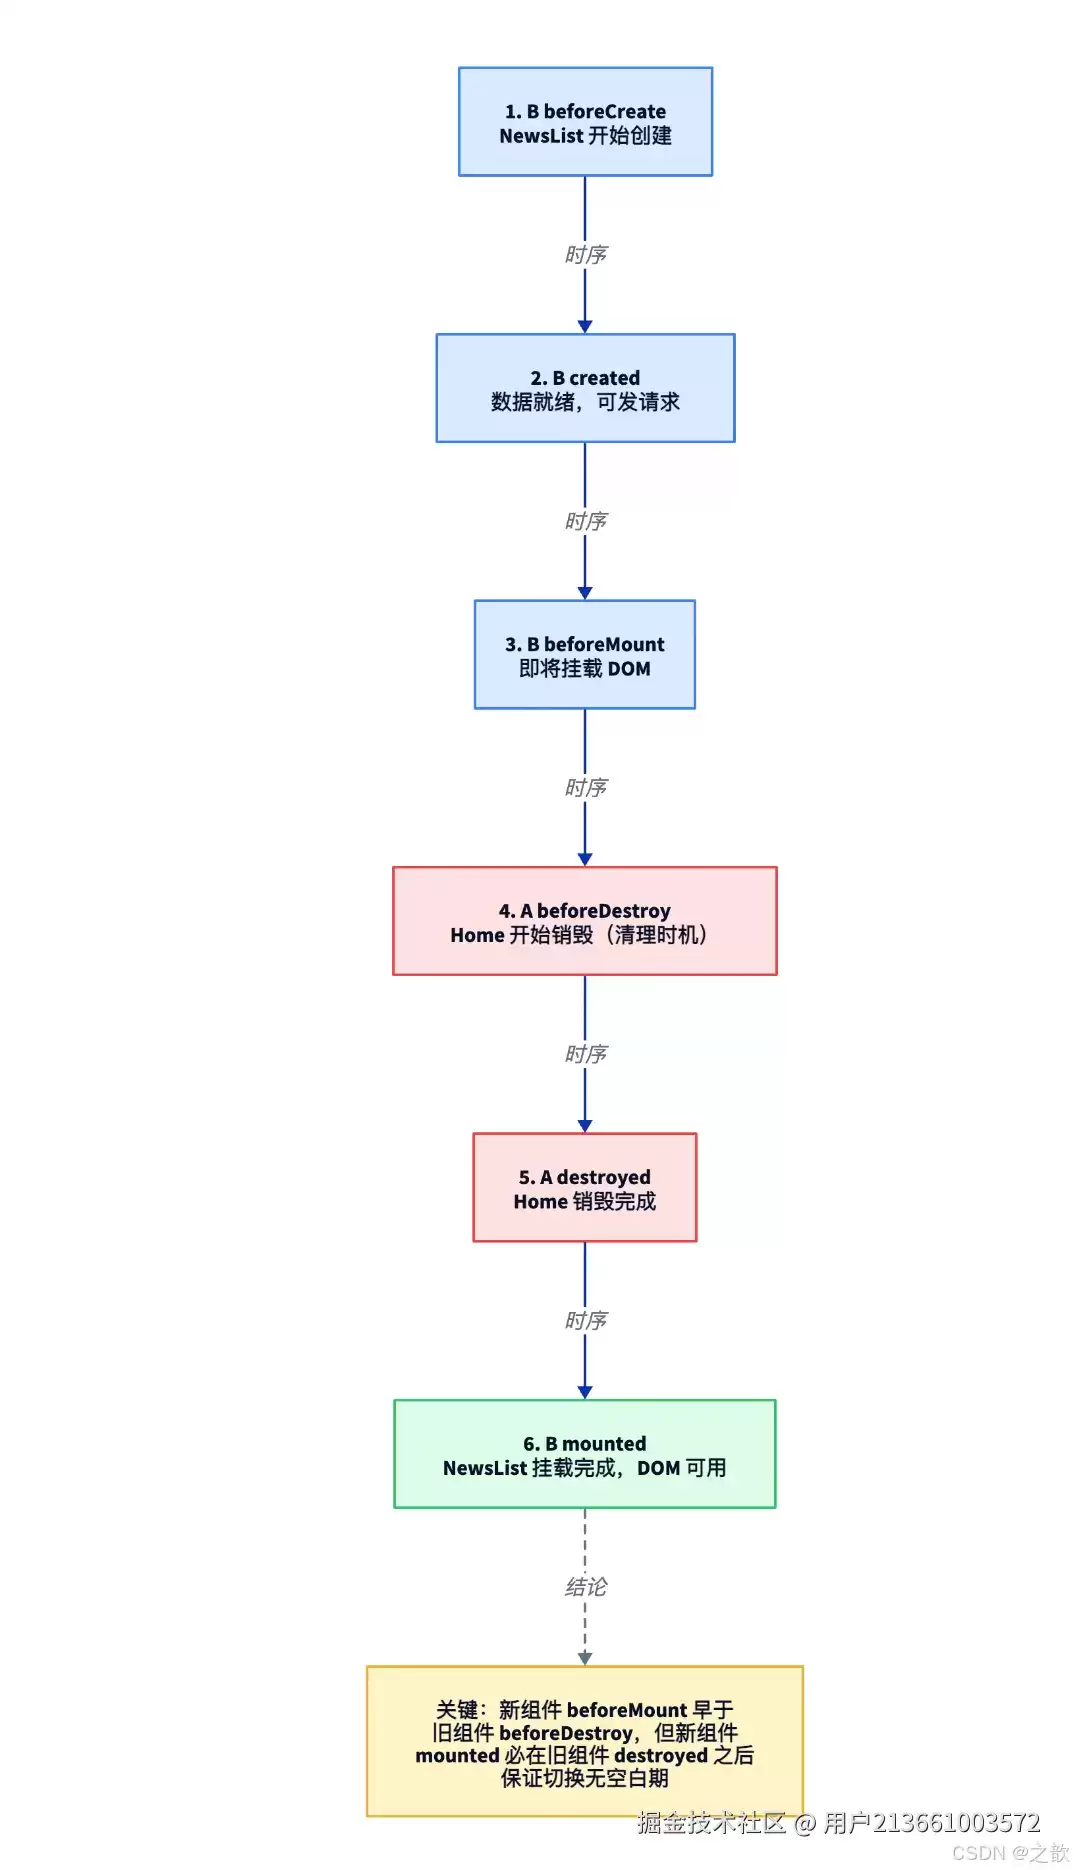
这张图把从 A 到 B 的路由切换过程拆成了 6 个严格有序的步骤:蓝色部分是新组件 B 的创建链,红色部分是旧组件 A 的销毁,绿色部分才是 B 的 mounted。核心结论用黄色框标注了——新组件的 beforeMount 早于旧组件的 beforeDestroy,但新组件的 mounted 一定晚于旧组件的 destroyed。这种“交织”是 Vue Router 刻意为之的设计:先把新组件创建到 beforeMount 状态(此时虚拟 DOM 已生成但还未落地),再销毁旧组件腾出位置,最后让新组件真正 mounted,从而保证视图切换时没有“两个组件同时占位”或“中间空白”的情况。理解这个时序的实际意义在于,资源清理必须放在红色的 beforeDestroy 里——此时旧组件仍然持有 DOM 与数据引用;如果拖到 destroyed 才清理,就为时已晚了。举个例子,在列表页跳转到详情页时,可以在 beforeDestroy 里用 clearInterval 停止轮询,或者用 cancelToken 取消未完成的 axios 请求,避免回调写入已经销毁的实例而引发报错。
实战要点:在 beforeDestroy 中进行资源清理是最佳实践。具体包括:用 clearInterval 或 clearTimeout 清除定时器、取消未完成的 axios 请求、移除全局事件监听等。
面试考点:路由从 A 切换到 B,两个组件的生命周期钩子执行顺序是什么?答案是:B 的 beforeCreate → B 的 created → B 的 beforeMount → A 的 beforeDestroy → A 的 destroyed → B 的 mounted。
三、路由激活状态与样式控制
当浏览器当前的 URL 与某个 router-link 的 to 属性匹配时,Vue Router 会自动为该链接添加特定的 CSS 类名,用来标识当前所在的页面位置。
这里需要弄清楚两种匹配方式:
- 精确匹配:URL 与路由配置的地址完全一致,比如 URL 是
/newsList,路由配置也是/newsList。 - 非精确匹配:只要当前 URL 是路由配置地址的前缀就行。比如 URL 是
/newsList/sport,即使路由配置只是/newsList,也算匹配。
Vue Router 会为激活的 router-link 自动添加两个内置类名:
| 类名 | 触发条件 |
|---|---|
router-link-active |
非精确匹配(包含精确匹配的情况) |
router-link-exact-active |
精确匹配 |
举个例子,如果当前 URL 是 /newsList/sport:
- 指向
/newsList的链接,会添加router-link-active(因为是非精确匹配),但不会添加router-link-exact-active。 - 指向
/newsList/sport的链接,则会同时添加router-link-active和router-link-exact-active。
特别需要注意的是根路径 /。因为所有路径都以 / 开头,如果不加限制,指向 / 的链接在任何页面都会处于“激活”状态。
控制激活样式有三种方案:
方案一:使用内置类名配合 CSS
首页 |
新闻列表 |
商品列表 |
个人中心
这里根路径 / 的 router-link 必须加上 exact 属性,否则在所有路由下它都会被判定为“激活”,导致首页链接始终高亮。
方案二:自定义激活类名(推荐)
首页 |
新闻列表 |
商品列表 |
个人中心
方案二把激活类名统一成了自定义的 .active,摆脱了又长又容易拼错的内置类名。两个属性的分工需要记住:active-class 控制“非精确匹配”时的高亮类,exact-active-class 控制“精确匹配”时的高亮类;根路径 / 必须配合 exact 使用,否则会在所有页面高亮。这种“逐个链接覆盖”的方式适合那些个别链接需要特殊高亮规则的场景。比如,侧边栏大部分菜单使用全局配置,唯独“首页”这个链接因为根路径的特性需要单独加上 exact。
方案三:在路由配置中全局设置(最简洁)
// src/router/index.js
export default new VueRouter({
  routes,
  mode: "history",
  // 全局设置:所有 router-link 的非精确激活类名都改为 active
  linkActiveClass: "active",
  // 全局设置:所有 router-link 的精确激活类名都改为 active
  // linkExactActiveClass: "active"
});
方案三是工程化项目的最佳实践。在 VueRouter 实例中统一配置后,所有 router-link 都不需要再单独设置 active-class,样式库中只需要定义 .active 就可以了。
实战要点:这三种方案的优先级是:方案二(单个 router-link 属性)> 方案三(全局路由配置)> 方案一(默认内置类名)。实际项目中,通常会选择方案三进行全局设置,再对个别特殊链接用方案二进行覆盖。
面试考点:router-link-active 和 router-link-exact-active 有什么区别?前者在路径前缀匹配时就生效,而后者要求 URL 与 to 属性完全一致时才生效。
四、路由参数传递:query vs params
在 Vue Router 中,参数的传递主要有三种方式:query 参数、params 参数(纯内存模式)和 params 参数(动态路由段模式)。
query 参数 是通过 URL 的查询字符串来传递数据的,格式是 key=value&key2=value2。因为数据直接编码在 URL 里,所以页面刷新后参数依然保留。
params 参数(纯内存模式) 是通过 $router.push({ name, params }) 来传递的,数据存储在内存中。它的特点是一旦页面刷新,数据就会丢失,而且 URL 中不会显示这些参数。
params 参数(动态路由段模式) 则是在路由配置中使用 :paramName 来定义路径段。参数会编码在 URL 路径中,刷新后数据仍然保留。
先来看看 $route 对象的完整结构,它是 Vue Router 注入到每个组件的只读对象:
this.$route = {
  path: "/one",          // 当前路由路径
  fullPath: "/oneid=1", // 完整路径,含查询字符串
  name: "one",           // 路由名称
  query: { id: "1" },   // query 参数(始终是字符串)
  params: { a: "100" }, // params 参数(动态路由段)
  hash: "",             // URL 中的 hash 部分
  meta: {},             // 路由元信息
  matched: [...]        // 匹配到的路由记录数组
}
这个对象是 $route 的“全字段地图”。有两个要点值得记住:一是 query 的值永远是字符串(比如 { id: "1" } 而不是 { id: 1 }),做数字运算前必须先转换;二是 matched 是一个数组,在嵌套路由时会自顶向下记录每一级的路由记录,导航守卫做逐级权限校验靠的就是它。另外,$route 是只读的,要修改路由必须通过 $router 的方法。
示例一:query 传参(推荐用于列表筛选等场景)
    one-1 |


      one-2
     |


      one-3
这里展示了 query 传参的三种写法。写法一最直观,但路径硬编码容易出错;写法二用对象方式,Vue Router 会自动处理 URL 编码;写法三使用命名路由,即使路径改了,导航代码也不需要动,是大型项目的首选。三者最终都会在地址栏生成可见、可分享、刷新不丢失的查询字符串。在实际业务中,比如商品列表的筛选条件(分类、价格区间、排序),几乎都会用 query 传参,因为用户需要把筛选后的链接复制给同事或者收藏。
query 接收参数
id: {{ $route.query.id }}
type: {{ $route.query.type }}
category: {{ $route.query.category }}
当 query 参数从 id=1 变成 id=2 时,因为 URL 的路径部分(/one)没有变化,Vue Router 不会销毁并重建组件,只会触发 updated 钩子。所以,要监听参数变化,必须使用 watch 或者 updated,不能依赖 mounted。
示例二:params 传参(纯内存模式,刷新丢失)
跳转到 Two(可传对象)
注意,这里必须用 name 而不是 path 来跳转——这是 params 内存模式的硬性约束:Vue Router 只有通过路由名才能定位到目标路由并注入内存中的 params,如果写成 path,params 会被静默丢弃。这种方式的优势在于可以携带 userInfo: { name, age } 这样的嵌套对象。但代价是这些数据只存在于内存中,刷新就会归零。在实际应用中,比如多步骤表单(下单时将上一步勾选的商品对象数组带到下一步),就经常使用内存模式的 params,因为这些临时数据不需要、也不应该出现在 URL 上。
params 接收参数(刷新会丢失)
a: {{ $route.params.a }}
b: {{ $route.params.b }}
userName: {{ $route.params.userInfo.name }}
params 纯内存模式的核心优势是可以传递任意 Ja vaScript 对象(包括嵌套对象和数组),而 query 传对象时会被序列化为字符串。但代价是刷新后数据丢失,它只适合“点击后立即使用、不需要分享 URL”的场景。
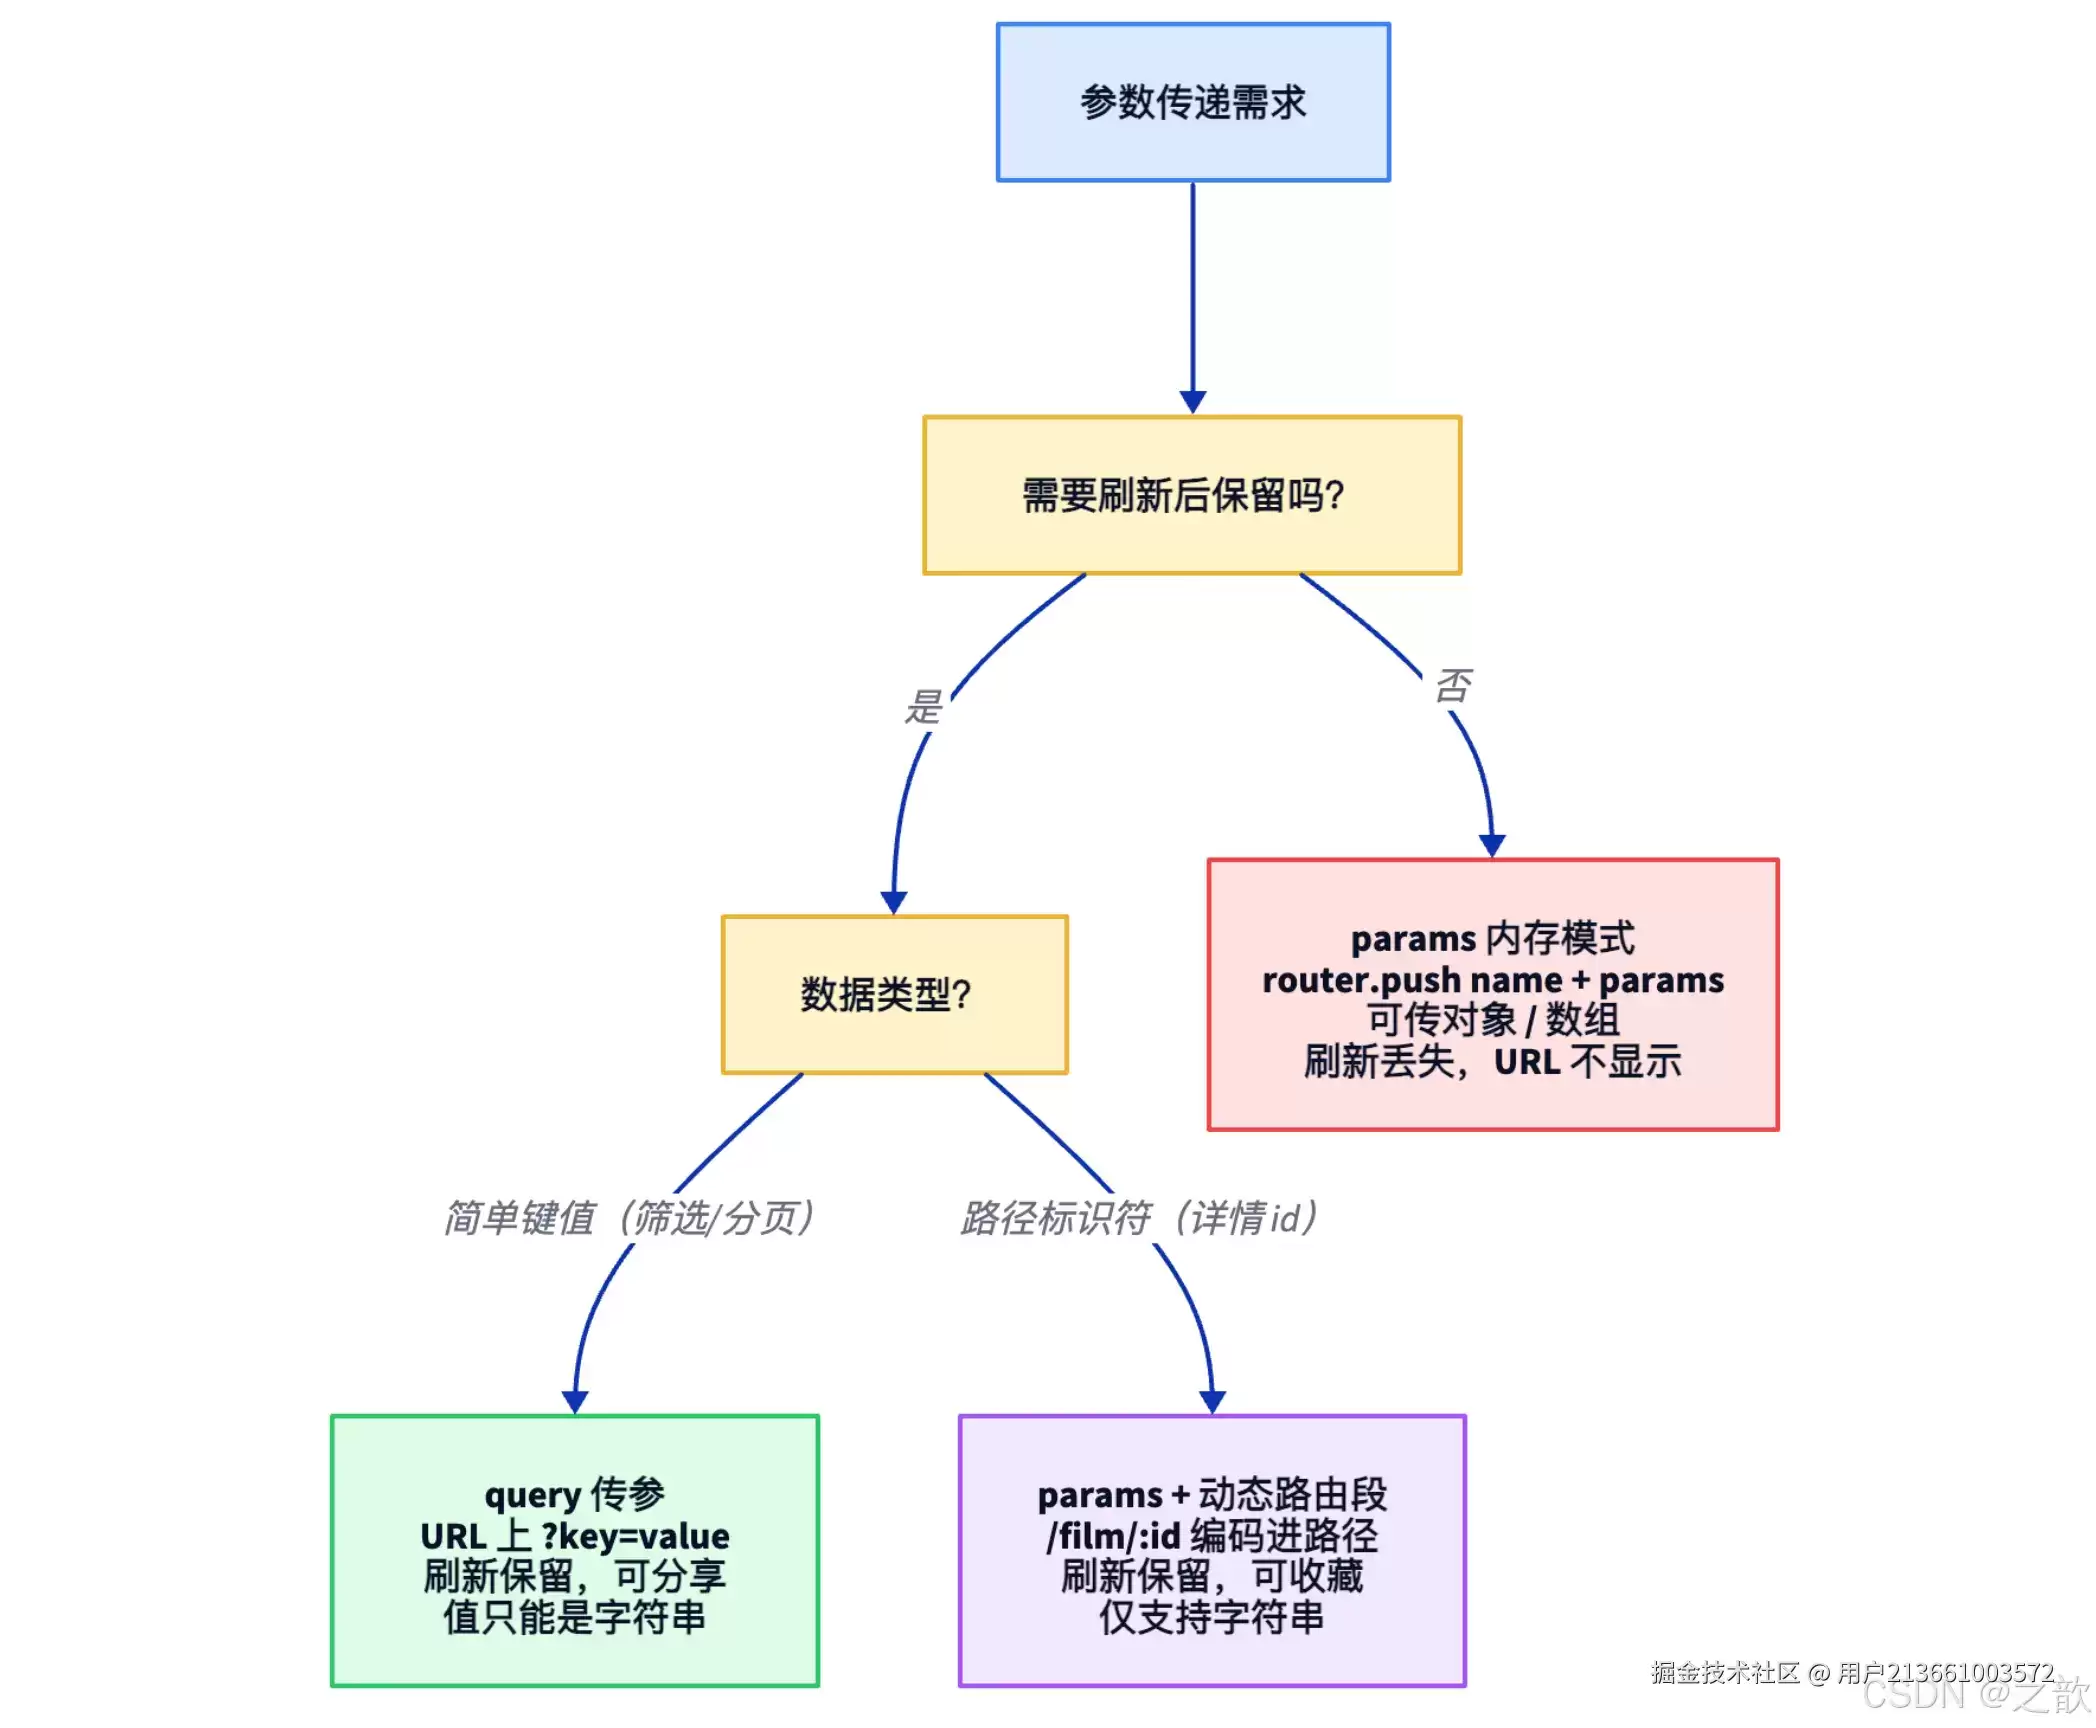
这张决策树图很好地说明了“用 query 还是 params”的取舍。先问是否需要刷新保留:如果不需要,就走红色路径的 params 内存模式;如果需要保留,再问数据类型——简单的键值对走绿色 query,路径标识符走紫色 params + 动态路由段。三种方式的本质差异在于参数的存储位置:query 存在 URL 的查询字符串里,动态段存在 URL 路径里,内存模式存在 JS 运行时内存里。刷新会重新解析 URL,但会清空内存,这正是“内存模式刷新丢失”的根本原因。
实战要点:
- query 的类型陷阱:
$route.query.id永远是字符串,即使传入了{ id: 1 },接收到的也是"1"。需要用Number($route.query.id)进行类型转换。 - params 刷新丢失问题:如果业务要求参数在刷新后保留,必须使用动态路由段(见下一章),或者将参数存储在 localStorage 或 Vuex 中。
面试考点:query 和 params 的核心区别是什么?query 体现在 URL 中,刷新后保留;params 内存模式不体现在 URL 中,刷新后丢失;query 值只能是字符串,params 可以传对象。
五、动态路由与路径参数
动态路由段是指在路由配置路径中,以 : 开头的片段,比如 path: "/film/:filmId"。当你访问 /film/123 时,$route.params.filmId 的值就是 "123"。
它的核心原理是:Vue Router 底层使用 path-to-regexp 库,将 /film/:filmId 编译成正则表达式。当 URL 与该正则匹配时,捕获组的值就会被提取出来,填入 $route.params。
动态路由段支持多种语法形式:
// 单个参数
{ path: "/user/:id" }                // 匹配 /user/123,$route.params = { id: "123" }

// 多个参数
{ path: "/user/:id/post/:postId" }   // 匹配 /user/1/post/2,$route.params = { id: "1", postId: "2" }

// 带后缀(SEO 友好)
{ path: "/film/:filmId.html" }       // 匹配 /film/123.html,$route.params = { filmId: "123" }

// 带前缀
{ path: "/three/:a/:b.html" }        // 匹配 /three/100/200.html
这里展示的四种语法形态,底层都是由 path-to-regexp 把 :param 编译成带捕获组的正则。比如 /user/:id 编译为 ^/user/([^/]+)$,URL 命中后,捕获组的值就被填进 $route.params。有意思的是“带后缀 .html”这种写法,:filmId.html 仍然能正确提取 123 作为 filmId,因为 .html 是字面量,:filmId 是捕获组,正则会精确区分它们。早期 SPA 为了 SEO 和让 URL“看起来像静态页”,经常给详情页的 URL 加上 .html 后缀(比如 /film/123.html),这正是动态路由段带后缀语法的现实来源。
示例一:动态路由参数传递(基础版)
// src/router/index.js
const routes = [
  {
    // 路径参数 :a 和 :b 会出现在 URL 中,刷新后不丢失
    // 访问 /three/100/200.html 时,params = { a: "100", b: "200" }
    path: "/three/:a/:b.html",
    name: "three",
    component: Three
  }
];
这份路由配置定义了一个包含两个动态段 :a、:b 并带有 .html 后缀的路径。通过 name: "three" 给它命名,这样后续在跳转时,代码就不需要关心路径中的 .html 后缀和拼接细节了。把路径模板的复杂性全部封装在路由表里,对外只暴露 name,是大型项目维护路由的标准做法。
    three-1 |

    three-2 |


      three-3
三种写法的核心区别在于“谁负责拼接路径”。写法一和写法二需要把 .html 后缀和分隔符手动写进字符串,一旦路由模板改版,所有导航链接都得逐个修改;写法三使用 name + params,由 Vue Router 根据路由表里的 path 模板自动填充,组件只关心参数名和值。关键的一点是,配合动态路由段时,写法三的 params 会被编码进 URL 路径,因此刷新后不丢失——这与上一章讲的纯内存 params 形成了鲜明对比。
params + 动态路由接收参数(刷新不丢失)
a: {{ $route.params.a }}
b: {{ $route.params.b }}
写法三(命名路由 + params)是最安全的方式。路径模板的细节(比如后缀 .html)都封装在路由配置中,组件代码只需要关心参数名和值,不会因为路径格式的调整而需要批量修改。
示例二:动态路由实战 —— GitHub 用户详情页
// src/router/index.js(详情路由配置)
{
  path: "/details/:login.html",
  name: "details",
  component: Details
}
这里把 GitHub 用户名 login(比如 torvalds)作为动态段 :login,详情页 URL 形如 /details/torvalds.html。用“业务唯一标识”(用户名、商品 id、订单号)作为动态段,是详情页路由的通用范式——它天然唯一、刷新后可解析、也便于后端 SEO 收录。
{{ item.login }}
列表页用 v-for 渲染用户,每项的跳转都使用 { name: 'details', params: { login: item.login } } 而不是字符串拼接(被注释掉的写法一作为对比)。这样做的好处是,无需在模板里关心 .html 后缀,路由表改了模板也不用动。

{{ info.login }}
Followers: {{ info.followers }}
详情页中通过 this.$route.params.login 读取 URL 中的用户名参数,再请求对应用户的详细信息。由于参数在路径中,用户刷新页面或收藏链接后,都可以正常访问。
深入:动态路由复用组件的“陷阱”与 watch / beforeRouteUpdate
这是动态路由最容易踩的坑,也是面试时最爱问的问题。Vue Router 官方文档明确指出:“当使用路由参数时……原来的组件实例会被复用……组件的生命周期钩子不会再被调用。” 换句话说,从 /details/torvalds 跳到 /details/yyx990803——两个 URL 命中的是同一个 Details 组件,Vue Router 出于性能考虑会复用同一个实例,不会销毁重建。后果是:你写在 mounted 里的请求只会执行一次,第二次切换 id 时 mounted 不触发,页面数据“卡”在上一个用户那里。
底层原因在于 Vue 的虚拟 DOM diff:两次渲染的 router-view 里都是同类型的组件(Details),diff 判定为“可复用节点”,于是只更新 props 和 $route,而不会走卸载-挂载流程。虽然 $route 本身是响应式的,变化会触发重渲染,但不会重跑生命周期钩子。
官方提供了两种应对方案:
这里列出了解决“复用陷阱”的两套标准解法:一是 watch: { "$route.params.login" } 监听具体参数,变化即重新请求,写法直观,适合大多数场景;二是 beforeRouteUpdate(to, from, next),这是一个路由组件的专属守卫,仅在“复用当前组件、只有参数变化”时触发,它的优势在于能拿到 from 和 to 做对比,还能在 next() 前取消上一次未完成的请求,避免竞态导致的数据错乱。两者本质上都是绕开“生命周期钩子不重跑”的限制,主动监听参数变化来重新拉数据。实战中,通常把请求逻辑抽成方法(这里的 fetchUser),让 mounted 和 watch 或守卫共用,避免重复代码。
实战要点:使用命名路由(name)+ params 的组合跳转时,Vue Router 内部会根据路由配置的 path 模板自动填充参数,生成最终的 URL。这比手动拼接字符串更安全,也更易于维护。
面试考点:params 传参与动态路由 :id 的关系是什么?仅仅通过 { name, params } 传递的 params 存储在内存中,刷新会丢失;只有配合路由配置中的 :id 动态段,params 才会被编码进 URL,刷新后仍可通过重新解析 URL 获取。
面试考点:动态路由从 /user/1 跳到 /user/2,为什么页面数据不更新?怎么解决?这是因为命中的是同一个组件,Vue Router 会复用组件实例,不重走生命周期钩子,mounted 里的请求只执行一次。解决办法是用 watch: { "$route.params.id" } 监听参数变化重新请求,或者用路由组件专属守卫 beforeRouteUpdate(to, from, next)(后者还能拿到 from/to 做对比,甚至可以取消旧请求)。
六、嵌套路由(二级/三级路由)
嵌套路由是指在路由配置中通过 children 数组定义子路由,形成父子层级关系。父路由组件内部需要放置 router-view 作为子路由的渲染出口。
嵌套路由的匹配过程是递归的。以 URL 为 /newsList/sport 为例:
- 路由器先匹配一级路由,找到
path: "/newsList"对应的NewsList组件。 - 路由器继续用剩余路径
/sport匹配NewsList路由的children,找到path: "sport"对应的Sport组件。 NewsList组件内部的router-view会渲染Sport组件。
关于子路由 path 的写法,有一个规则:子路由的 path 可以省略父路由的路径前缀。比如 path: "sport" 就等同于 path: "/newsList/sport",Vue Router 会自动拼接。
示例一:新闻列表嵌套路由(含默认子路由)
// src/router/index.js
const routes = [
  {
    path: "/",
    component: Home
  },
  {
    path: "/newsList",
    alias: "/news",
    component: NewsList,
    // children 数组定义二级路由
    children: [
      // 方案:进入 /newsList 时,重定向到 /newsList/tiyu
      {
        path: "/",           // 匹配 /newsList
        redirect: "tiyu"    // 重定向到 tiyu 子路由
      },
      {
        path: "tiyu",       // 完整路径:/newsList/tiyu
        name: "tiyu",
        component: TiYu
      },
      {
        path: "yule",       // 完整路径:/newsList/yule
        name: "yule",
        component: YuLe
      },
      {
        path: "caijing",    // 完整路径:/newsList/caijing
        name: "caijing",
        component: CaiJing
      }
    ]
  },
  {
    path: "/goodsList",
    component: GoodsList
  },
  {
    path: "/my",
    component: My
  },
  {
    path: "*",
    component: NotFound
  }
];

export default new VueRouter({
  routes,
  mode: "history",
  linkActiveClass: "active"
});
这份路由表演示了嵌套路由的几个关键点:① /newsList 通过 children 数组挂载了四个子路由,子路由的 path(tiyu/yule/caijing)不以 / 开头,会自动拼成 /newsList/tiyu;② children 里的第一项 { path: "/", redirect: "tiyu" } 实现了“进入 /newsList 时默认显示体育新闻”的效果;③ alias: "/news" 给 /newsList 起了别名,访问 /news 效果一样但地址栏不会变(这和 redirect 不同);④ path: "*" 是通配符,用来兜底所有未匹配的路径,展示 404 页面,必须放在所有路由的最后。
体育新闻 |
娱乐新闻 |
财经新闻
父路由组件 NewsList 扮演着“布局壳”的角色:上半部分是子路由的导航(使用命名路由 { name: 'tiyu' } 跳转,避免硬编码路径),下半部分是必不可少的 router-view——这就是二级路由的渲染出口,子路由的内容全靠它来承载。父组件的 script 几乎为空,这正体现了“壳组件只管布局,业务逻辑下沉到子路由”的分层原则。
体育新闻
- {{ news.title }}
嵌套路由的核心在于两个 router-view:一个在 App.vue 中渲染一级路由(比如 NewsList),另一个在 NewsList.vue 中渲染二级路由(比如 TiYu/YuLe/CaiJing)。这两层 router-view 正好对应着两层路由匹配。
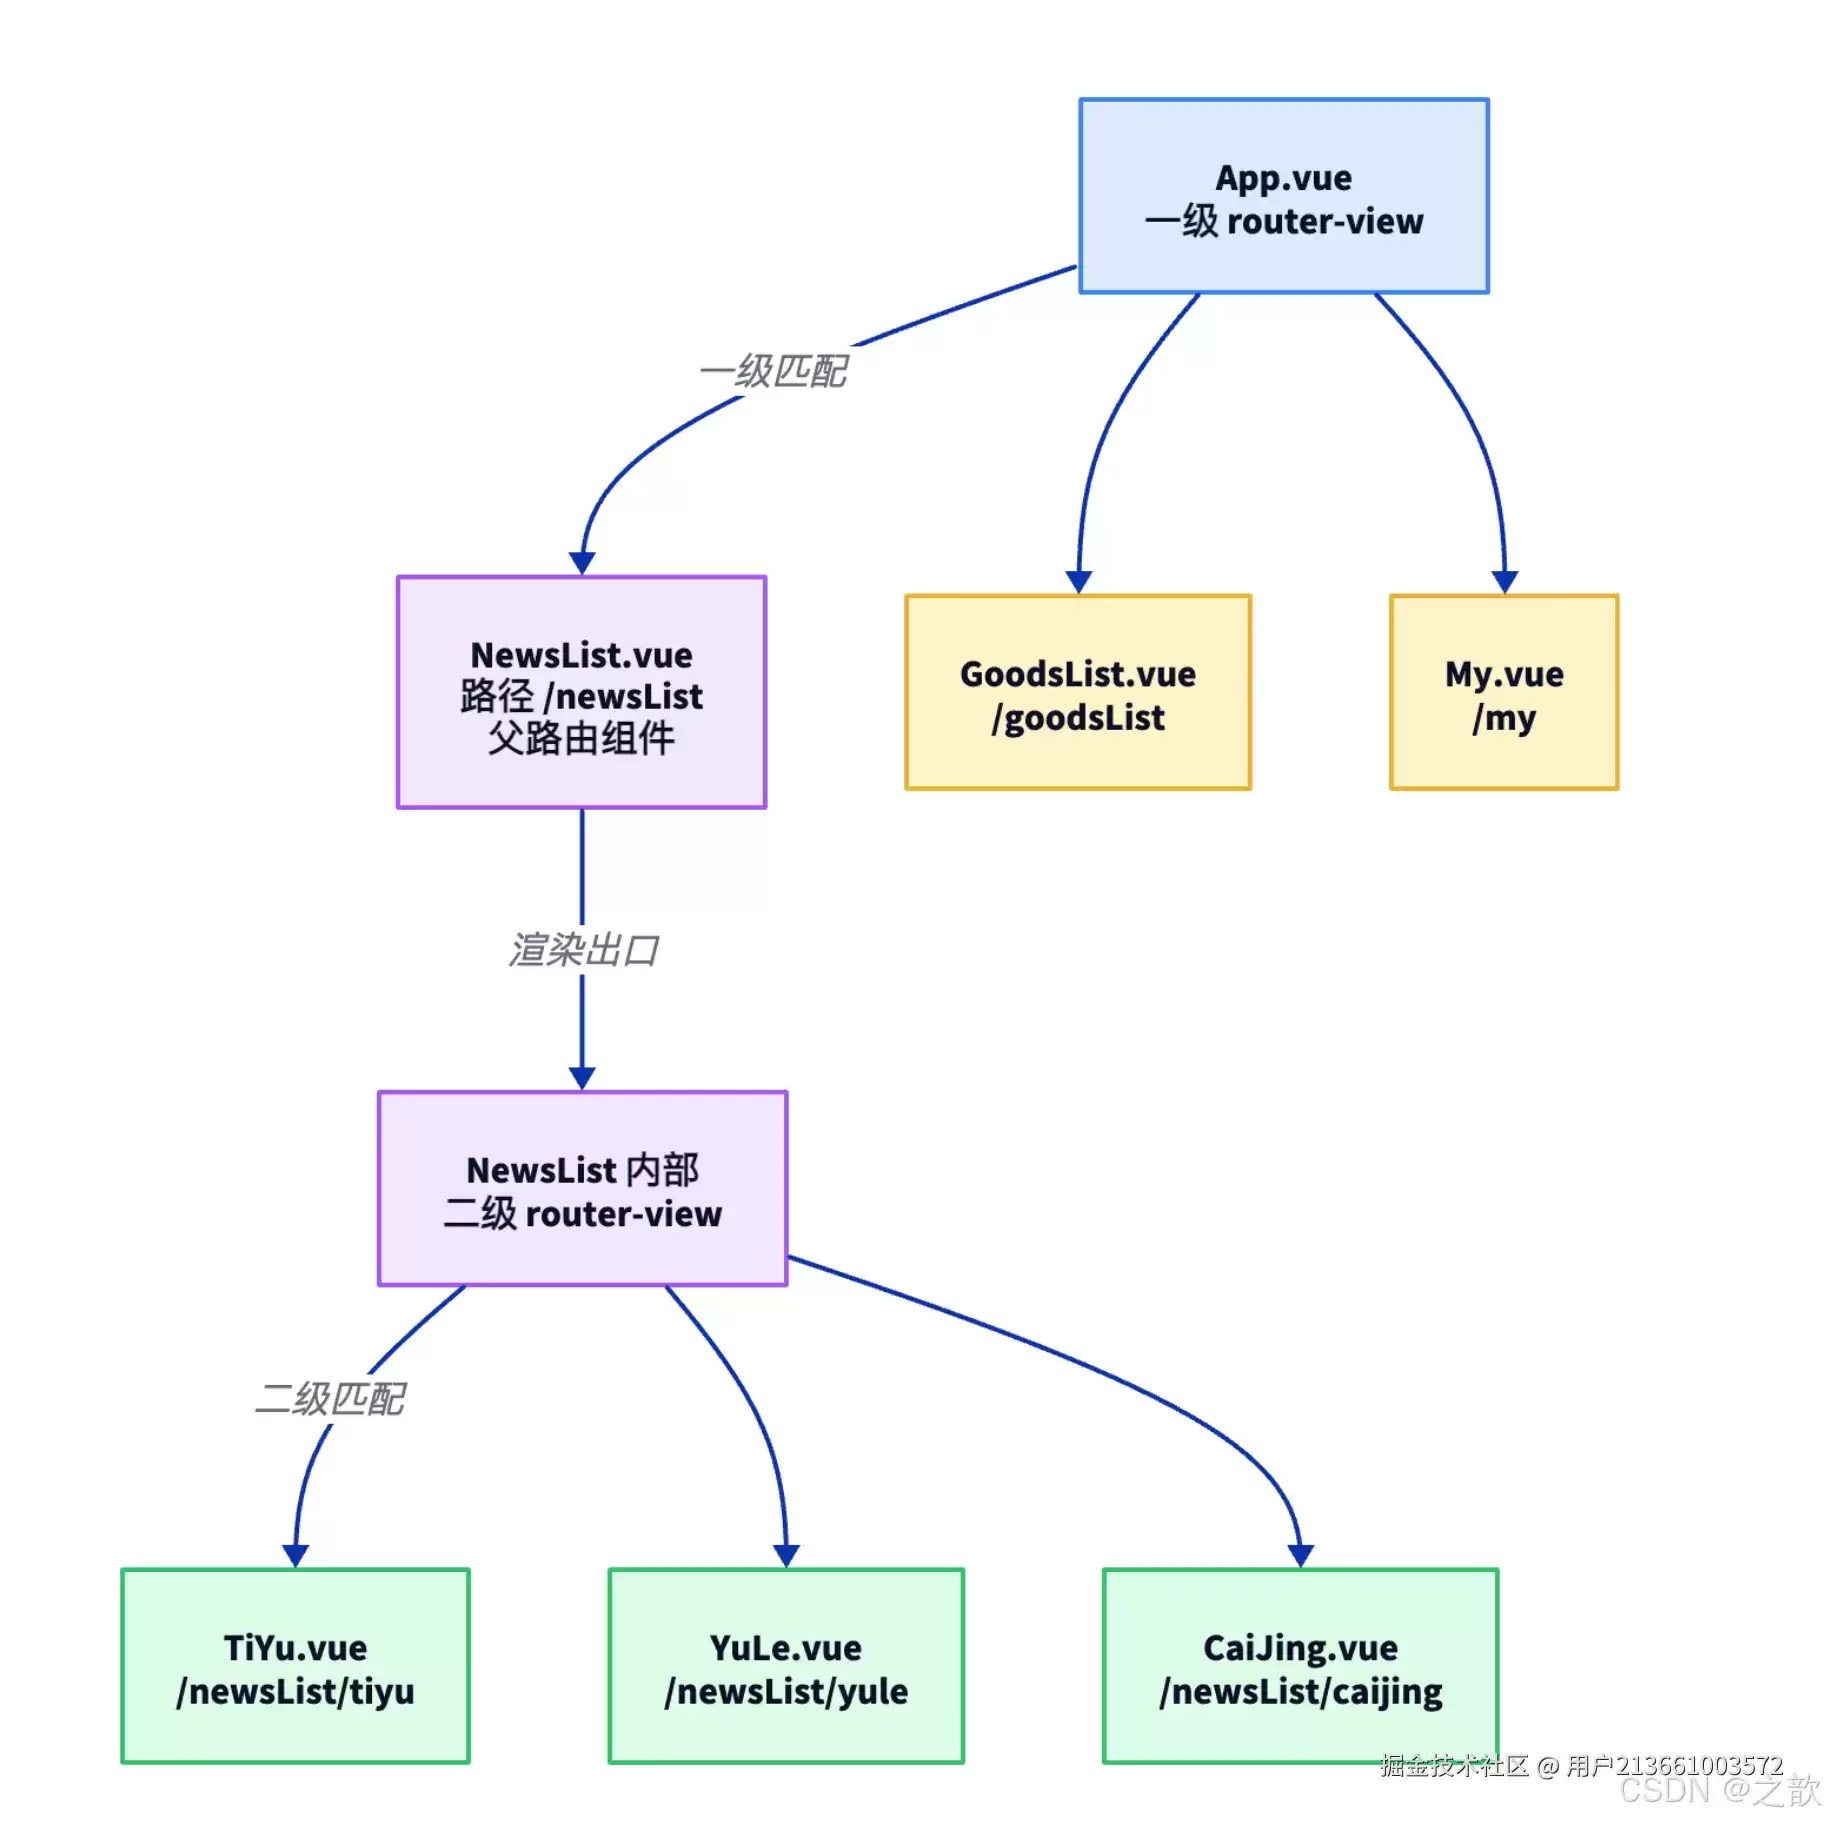
这张图把“两层 router-view 对应两层路由匹配”的结构画得很清楚。访问 /newsList/tiyu 时,路由器会递归匹配:先用 /newsList 命中 NewsList,再用剩余的 /tiyu 在它的 children 里命中 TiYu。此时 $route.matched 数组里会有两条记录(父和子),每条记录对应一个 router-view 出口。所以,有几层嵌套就需要几个 router-view——这是嵌套路由最容易踩的坑:子路由不显示,十有八九是父组件里忘了放 router-view。
默认子路由的两种方案对比
方案一:将子路由路径设置为与父路由相同
children: [
  {
    path: "/newsList",  // 与父路由 path 完全相同
    name: "tiyu",
    component: TiYu
  },
  // ...
]
方案一让第一个子路由的 path 等于父路由的 path(都是 /newsList)。这样访问 /newsList 时,父子路由会同时命中,默认渲染 TiYu。缺点是地址栏仍然停留在 /newsList(不会变成 /newsList/tiyu),而且因为路径前缀关系,导航高亮会“误连带”,所以模板里必须加上 exact 属性。
模板中导航需要 exact:
体育新闻
配合方案一,exact 属性要求 URL 与 to 完全相等时才激活,避免了“指向 /newsList 的链接在所有 /newsList/xxx 子页面都高亮”的问题。
方案二:使用 redirect 重定向(推荐)
children: [
  {
    path: "/",           // 匹配 /newsList(与父路由相同)
    redirect: "tiyu"    // 重定向到子路由 tiyu
  },
  {
    path: "tiyu",
    name: "tiyu",
    component: TiYu
  }
]
方案二是推荐写法,语义更清晰,而且不需要在 router-link 上添加 exact 属性。进入 /newsList 时会自动重定向到 /newsList/tiyu,浏览器地址栏也会相应更新。
实战要点:
- 子路由的
path不要以/开头(除非使用绝对路径),否则会被当作根路径处理,无法正确匹配。 - 每一级路由组件都需要包含
router-view作为子路由的渲染出口,缺少它子路由内容将无法显示。 - 使用
redirect处理默认子路由比修改路径更直观,也更容易理解路由配置的意图。
面试考点:嵌套路由如何实现默认显示第一个子路由?有两种方案:一是将第一个子路由的 path 设置为与父路由完全相同(但需要在导航中使用 exact);二是在 children 中添加 path: "/" 的重定向配置。
七、综合实战:仿影院选片路由架构
本章通过一个“仿影院选片”的完整案例,对比展示两种路由架构的设计思路:有二级路由和无二级路由方案的取舍。
方案对比:有无二级路由
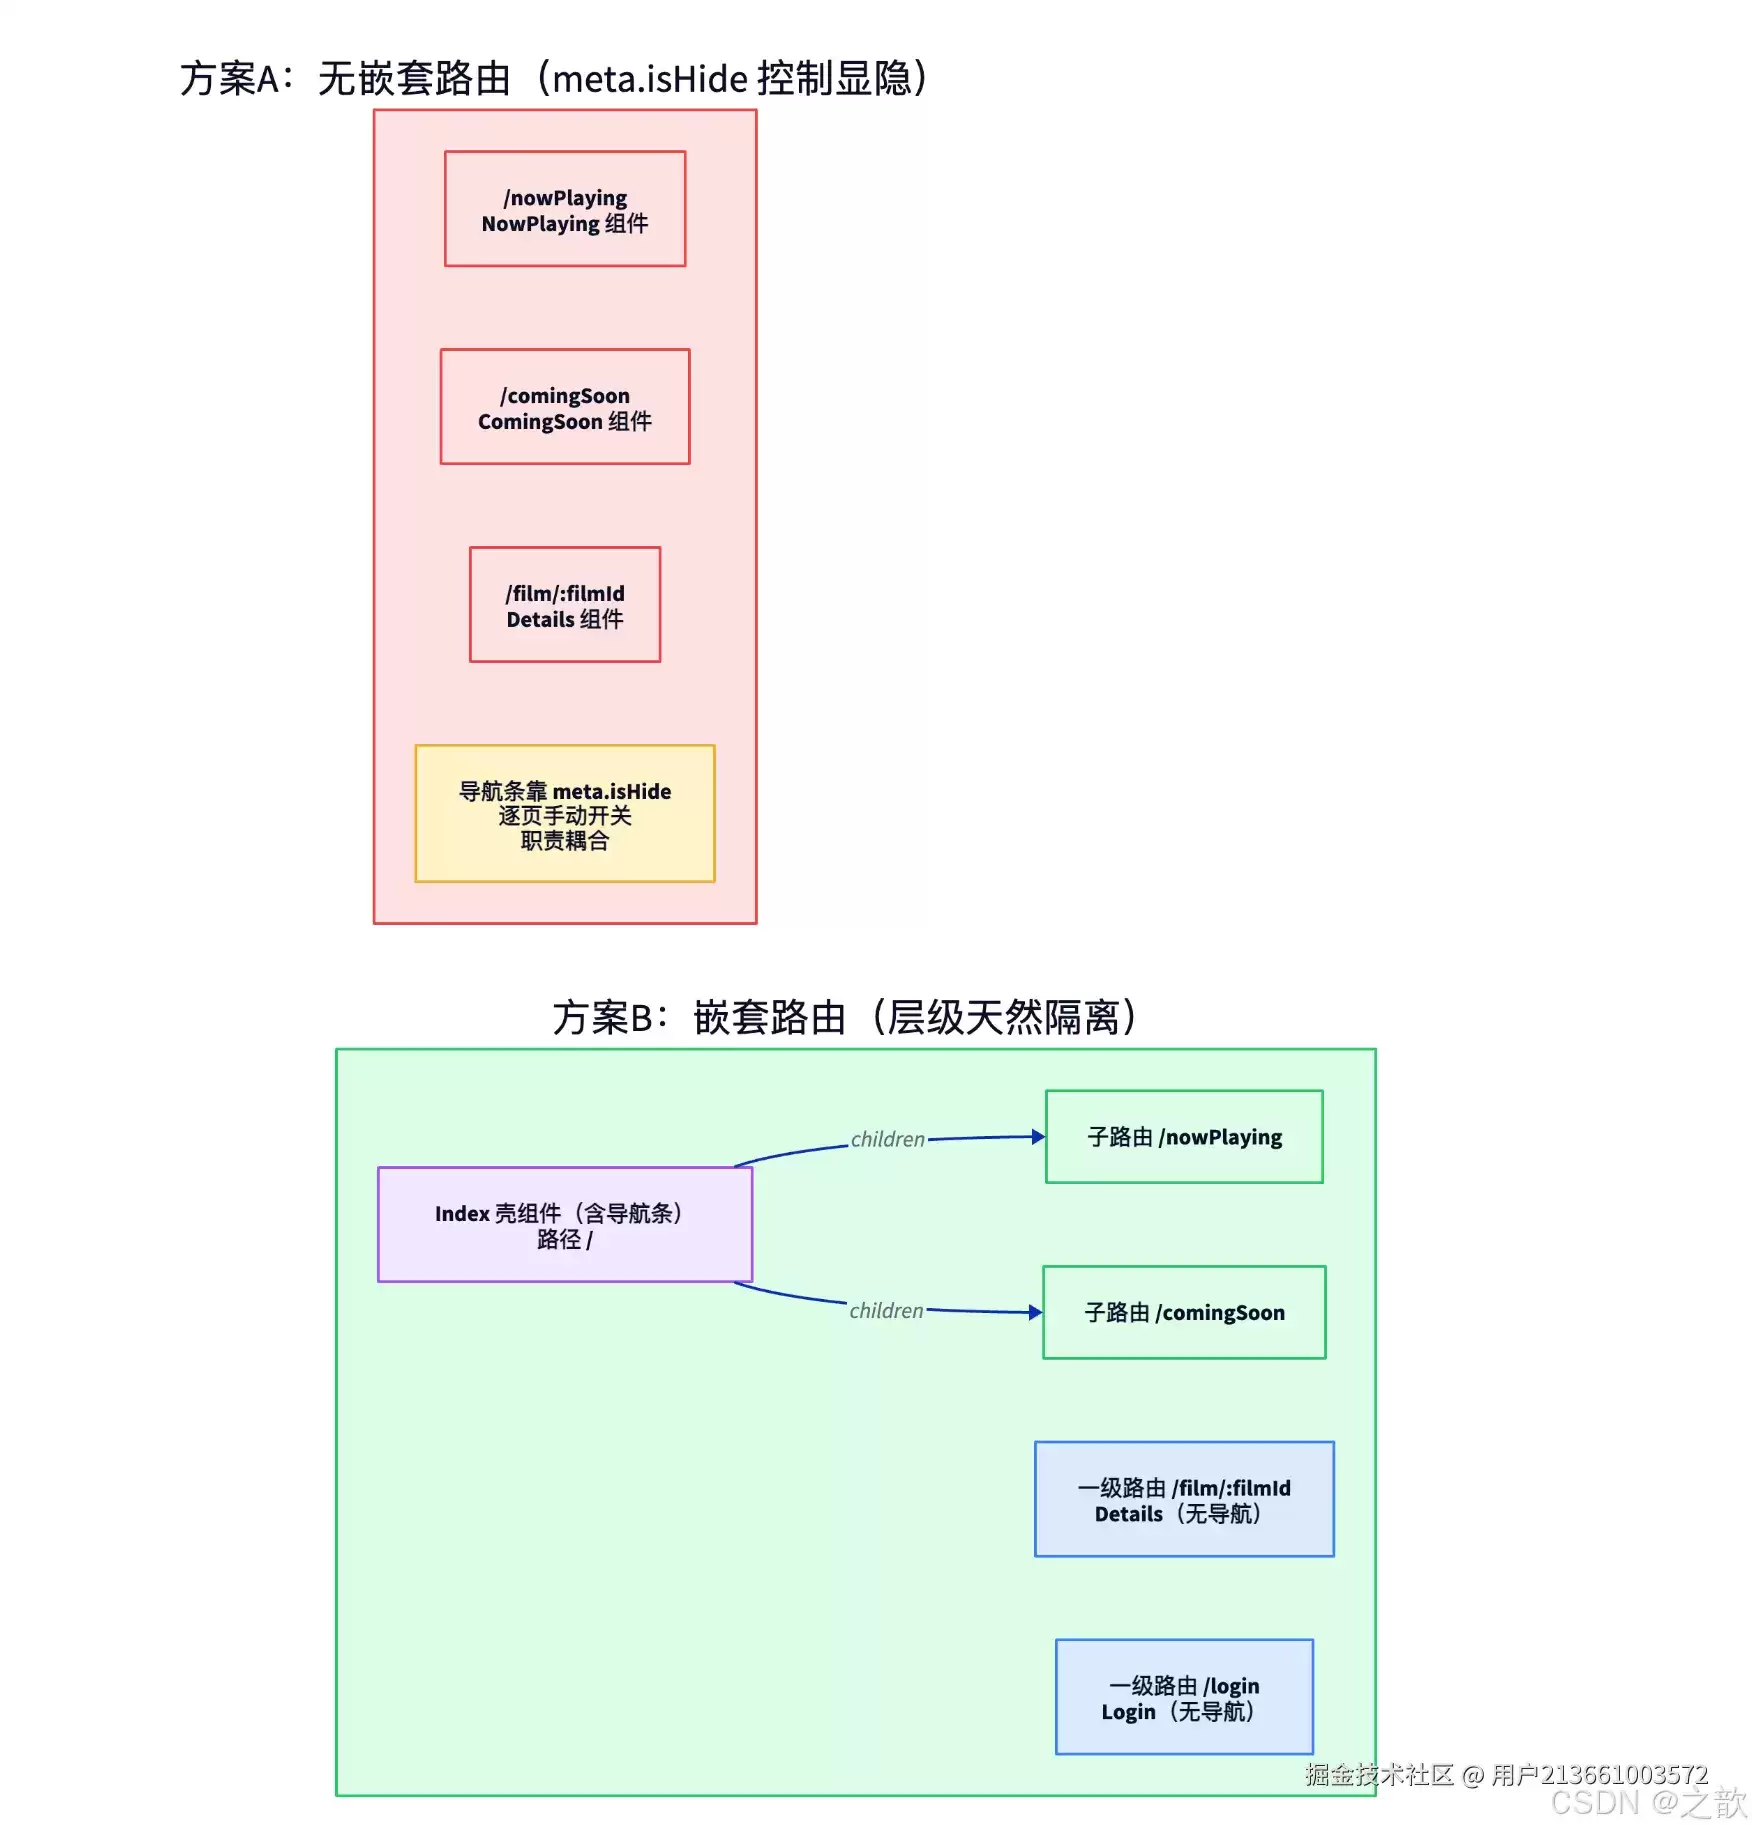
这张图用左右两种颜色对比了两种路由架构。红色方案 A 把所有页面都平铺成一级路由,导航条是否显示依靠每个路由的 meta.isHide 字段在全局守卫里逐页判断——问题在于“布局的关注点”散落到了业务路由配置里,新增页面时很容易漏配。绿色方案 B 采用了嵌套路由:把“有导航条”的页面(正在热映、即将上映)作为紫色 Index 壳组件的 children,把“无导航条”的页面(详情、登录)保留为蓝色独立的一级路由。导航条只写在 Index 模板里,子路由天然继承,一级路由天然没有——用路由层级来表达布局层级,不再需要 meta.isHide 这个开关了。
方案 B(嵌套路由)的设计思路:
- 有导航栏的页面(正在热映、即将上映)作为
Index的子路由。 - 无导航栏的页面(详情、登录)作为独立的一级路由。
- 导航栏的显隐不再依靠
meta.isHide控制,而是通过路由层级天然地隔离开了。
方案 B 完整代码
// src/router/index.js(嵌套路由版本)
import Vue from "vue";
import VueRouter from "vue-router";
import Details from "@/views/Details";
import Index from "@/views/Index";
import NowPlaying from "@/views/NowPlaying";
import ComingSoon from "@/views/ComingSoon";
import Login from "@/views/Login";

Vue.use(VueRouter);

const routes = [
  // 一级路由:无导航的独立页面
  {
    path: "/login",
    component: Login
  },
  {
    path: "/film/:filmId",
    component: Details
  },
  // 一级路由:有导航的 Index 壳组件,将正在热映/即将上映作为子路由
  {
    path: "/",
    component: Index,
    children: [
      {
        path: "/",
        redirect: "/nowPlaying"   // 进入根路径时自动跳转到正在热映
      },
      {
        path: "/nowPlaying",
        component: NowPlaying
      },
      {
        path: "/comingSoon",
        component: ComingSoon
      }
    ]
  }
];

export default new VueRouter({
  routes,
  mode: "history"
});
这是方案 B 的路由表,结构一眼就能看出布局意图:/login 和 /film/:filmId 是无导航的一级路由,/(Index 壳)通过 children 挂载了有导航的二级路由(正在热映、即将上映),并用 redirect: "/nowPlaying" 设定了默认子路由。导航条写在 Index 模板里,子路由继承,一级路由不沾边——布局靠层级而不是 meta 开关。在实际生产环境中,还可以使用路由懒加载,比如把 component: NowPlaying 改写成 component: () => import(/* webpackChunkName: "film" */ "@/views/NowPlaying"),让该组件单独打成一个 chunk,进入对应路由时才按需加载,这能有效控制首屏体积、提升加载速度。
方案 B 的 App.vue 极其简洁——只有一个顶级的 router-view,它渲染的是一级路由(可能是 Index 壳、Details 或 Login)。注意这里没有任何导航条,因为导航条已经下沉到 Index 壳组件里了。这正是嵌套路由“布局分层”的体现。
      正在热映 |
      即将上映
Index 壳组件把“导航条 + 二级 router-view”封装在一起:导航条只写在这里,因此只有它的子路由(正在热映、即将上映)才有导航条,而独立的一级路由(详情、登录)天然没有。这就是方案 B 相比“满屏 meta.isHide”的架构优势——显隐由路由层级决定,而非散落的标志位。

{{ item.name }}
主演:{{ item.actors | actorNames }}
列表组件做了三件事:用 v-for 渲染影片,点击海报用 router-link :to="'/film/' + item.filmId" 跳转到一级详情路由,在 mounted 里请求影片网关接口。:src 用模板字符串 `${item.poster}w=200` 给 CDN 图片加宽度参数,可以按需缩放、节省流量;item.actors | actorNames 用过滤器把演员数组拼成 张三 / 李四 的格式。请求头里的 X-Client-Info 和 X-Host 是该网关的鉴权约定,k: Date.now() 是防缓存的时间戳。

{{ film.name }}
{{ film.synopsis }}
嵌套路由方案的核心优势在这里体现得很明显:详情页(Details)与列表页(NowPlaying/ComingSoon)完全隔离。列表页作为 Index 的子路由,天然继承了导航条;详情页作为独立的一级路由,天然没有导航条。这种设计不需要 meta.isHide 这样的“开关”来手动控制显隐,架构更清晰。
实战要点:
- 设计路由层级时,先问“这个页面有没有公共导航或布局”,有的话就放入对应壳组件的
children,没有就作为独立的一级路由。 - 壳组件(比如
Index.vue)只负责布局框架,不处理业务逻辑,这符合单一职责原则。 - 从详情页返回列表页,使用
$router.back()而不是跳转到固定路径,可以保留列表页的滚动位置。
面试考点:如何用路由设计解决“部分页面不显示导航栏”的问题?使用嵌套路由:将需要导航栏的页面作为壳组件的子路由,不需要导航栏的页面(如详情页、登录页)独立为一级路由,从而天然地隔离布局。
总结
知识点回顾(思维导图)
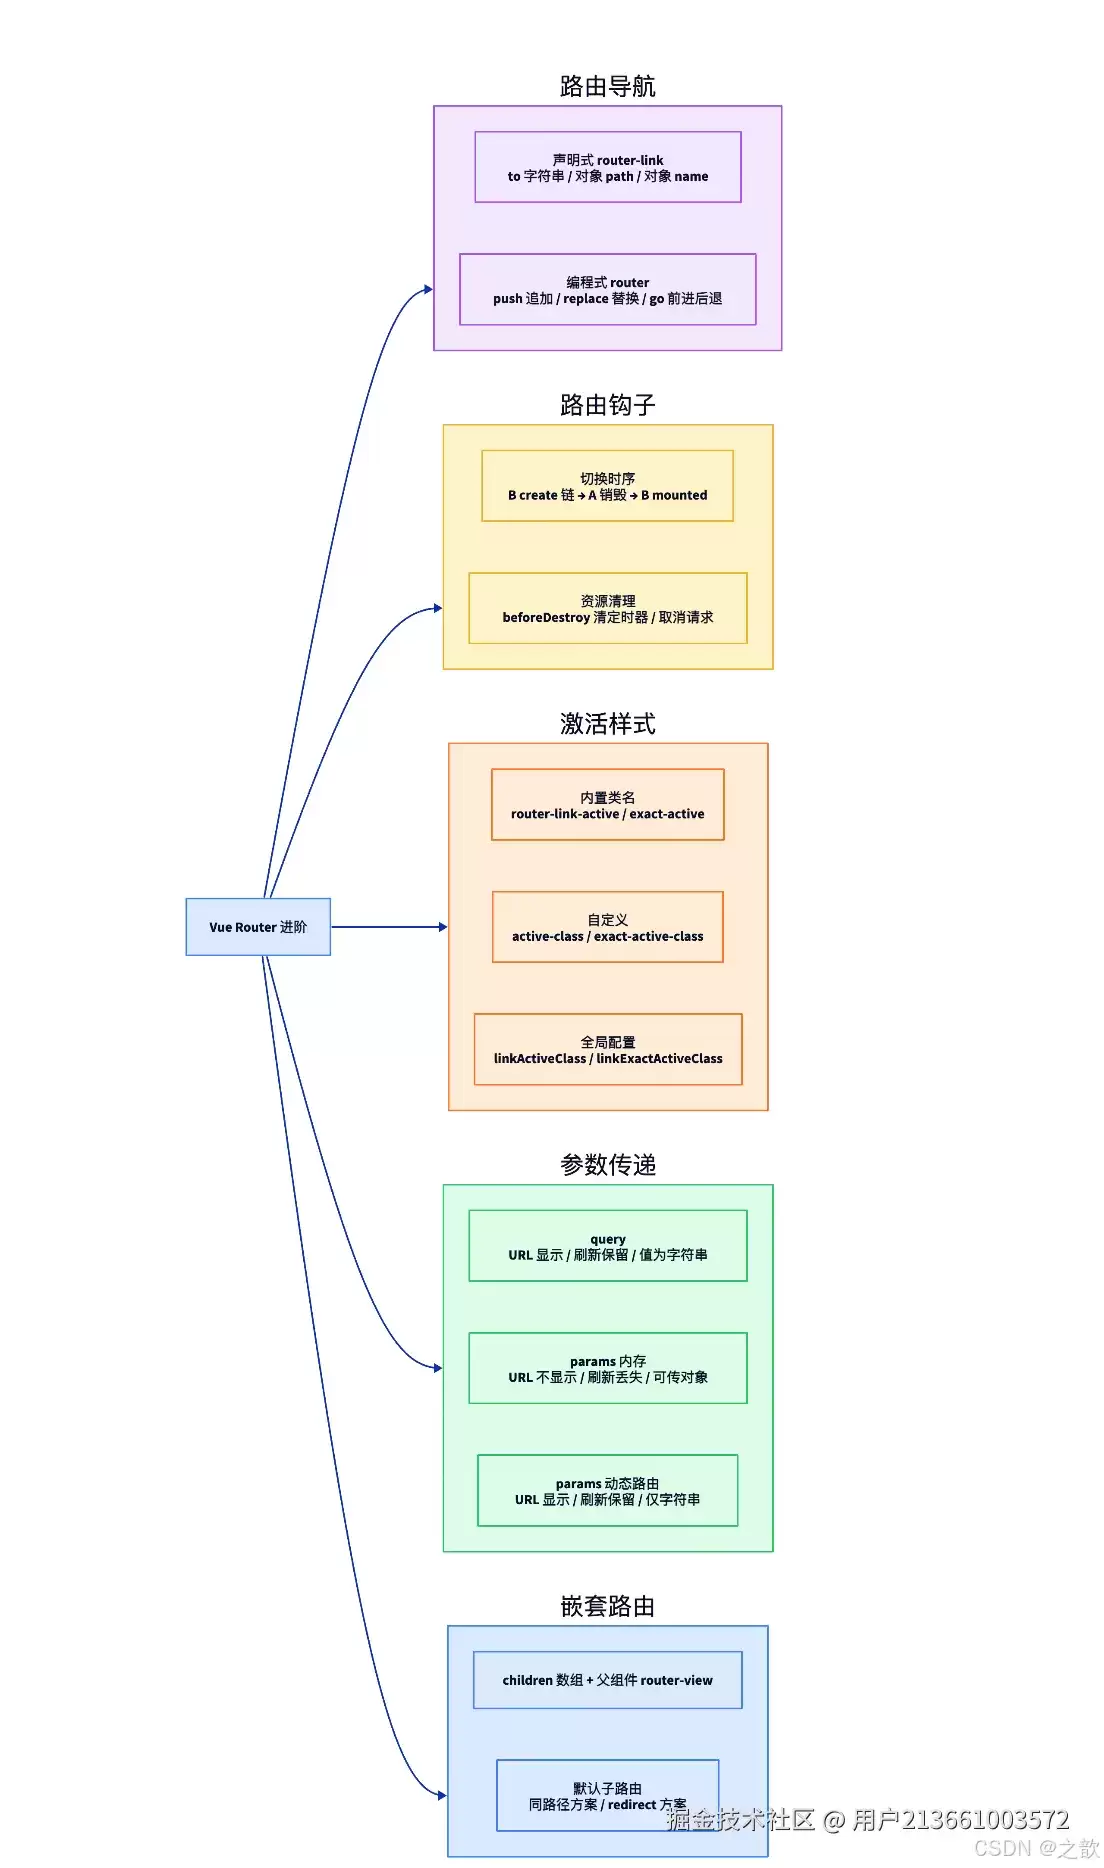
这张思维导图把本篇的五大模块串成了一张知识网。复习的时候,可以试试“由中心向外回放”的方法——从 Vue Router 进阶这个中枢出发,逐个分支自问“这块解决什么问题、有哪几种方案、各自的取舍是什么”,这样能在几分钟内快速自检对整篇内容的掌握程度。尤其要重点关注绿色“参数传递”分支的三态,这是面试中间出现频率最高、也最容易混淆的知识点。
高频面试题速查
| 问题 | 要点 |
|---|---|
push vs replace 区别 |
push 追加历史记录,replace 替换当前记录,影响后退行为 |
| 路由切换钩子顺序 | B的beforeMount → A的beforeDestroy → A的destroyed → B的mounted |
router-link-active vs router-link-exact-active |
前者前缀匹配即生效,后者要求完全匹配 |
| query vs params 区别 | query 在URL中保留,params 内存模式刷新丢失,配合动态路由段则保留 |
| params 刷新丢失怎么解决 | 使用动态路由段(:id)将参数编码进路径 |
| 动态路由切换 id 数据不更新 | 组件被复用、钩子不重跑,用 watch $route 或 beforeRouteUpdate 重新请求 |
| 路由懒加载怎么做 | component: () => import('xx.vue'),Webpack 按代码分割点打成独立 chunk,按需加载;webpackChunkName 可合并 chunk |
| 嵌套路由如何设置默认子路由 | 在 children 中添加 { path: "/", redirect: "子路由名" } |
| 如何实现部分页面无导航栏 | 无导航页面作为独立一级路由,有导航页面作为壳组件的子路由 |
$route vs $router |
$route 只读当前路由信息,$router 是路由器实例可调用方法 |
学习建议
-
动手验证钩子顺序:新建一个 Vue CLI 项目,在两个路由组件中分别添加所有生命周期钩子并打印日志,切换路由观察控制台输出,这是理解路由切换时序最有效的方式。
-
刻意对比 query 与 params:在同一个项目中分别实现 query 传参和 params 传参,然后在接收页手动刷新浏览器,观察哪种方式的数据会丢失,直观感受两者的差异。
-
从架构角度理解嵌套路由:在设计路由时,先画出页面结构图,标注哪些页面有公共布局,再决定嵌套层级。不要为了使用嵌套路由而使用,而是因为页面布局的天然层级关系才使用它。
-
在项目中统一使用命名路由:养成给每个路由配置
name属性的习惯,传参和跳转都使用{ name: "xxx", params/query: {} }的对象形式,避免路径硬编码带来的维护问题。