

Mistral新旗舰1230亿参数挑战Llama 3.1 性能直逼GPT-4o
近日,法国AI公司MistralAI发布MistralLarge2旗舰模型,参数达1230亿,拥有128k上下文窗口,支持十多种语言和80多种编程语言。其MMLU准确率达84%,超越Llama3.170B,性能已逼近GPT-4o和Claude3.5Sonnet。训练重点减少幻觉,经过微调后模型在无法回答时主动承认,显著提升可靠性。
继Meta开源Llama 3.1后,法国AI初创公司Mistral AI迅速跟进,正式发布新一代旗舰模型Mistral Large 2,进一步推动大模型领域的竞争。
Mistral Large 2拥有1230亿参数,支持128k上下文窗口,可在单个节点上以高吞吐量运行。该模型支持十几种语言(包括中文)和80多种编程语言。在多项基准测试中,其表现接近GPT-4o和Claude 3.5 Sonnet,预训练版本的多任务语言理解准确率达到84%,超越Llama 3.1 70B。
值得关注的是,Mistral AI在训练中投入大量成本增强模型的推理能力,重点减少模型“幻觉”的概率。通过微调,模型在响应时更加谨慎和敏锐,提升了输出信息的精准度和可信度。
多任务语言理解超越Llama 3.1 70B
Mistral Large 2的128k上下文窗口,在代码生成、数学和推理方面比前代Mistral Large更强大,同时支持更多语言和高级函数调用——包括中文在内的10余种语言,以及Python、Java等80多种编程语言。
参数仅有1230亿,与Llama 3.1 405B的4050亿相比明显更少,但性能却意外接近后者,甚至在多项基准测试中逼近GPT-4o和Claude 3.5 Sonnet。这促使业界重新思考:参数规模是否还是唯一指标?
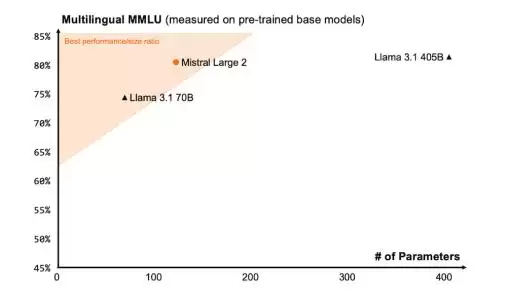
▲Mistral Large 2与Llama 3.1 70B和Llama 3.1 405B在MMLU测试中的准确率对比
在MMLU(大规模多任务语言理解)测试中,Mistral Large 2的准确率击败了Llama 3.1 70B。该测试涵盖57项任务,从初等数学、美国历史到计算机科学、法律,堪称综合能力“大考”。Mistral Large 2以84%的准确率证明了自身在多种任务和语言环境下的广泛适应性。
训练过程中着重减少“幻觉”
Mistral AI团队明确表示,他们投入了大量成本来增强Mistral Large 2的代码生成和推理能力。经过海量代码训练,模型的代码生成能力远超前代Mistral Large,甚至接近GPT-4o、Claude 3 Opus和Llama 3 405B的水平。
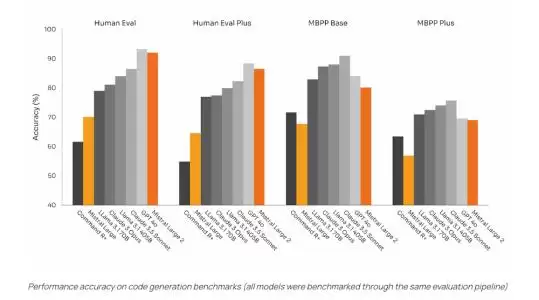
▲代码生成基准测试中Mistral Large 2与其他模型的性能和准确率对比
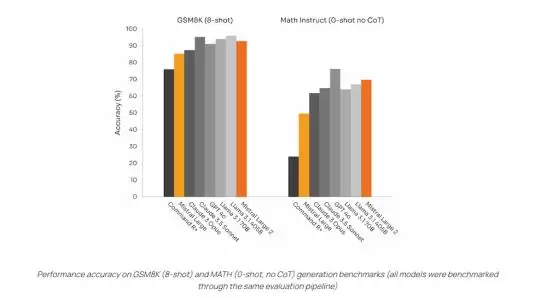
▲Mistral Large 2与其他模型在GSM8K(8-shot)和MATH(0-shot,no CoT)生成基准测试中的性能和准确率对比
在推理能力训练方面,Mistral Large 2的重点之一是降低“幻觉”概率。“幻觉”是生成模型常见的缺陷——编造虚假或不准确的信息。经过微调,模型在响应时更为谨慎和敏锐,确保提供的信息可靠、准确。
值得注意的是,Mistral AI表示,经过训练后,当模型找不到解决方案或没有足够自信给出准确答案时,它会直接承认无法回答,而不是硬着头皮编造。这一点对于真实应用场景而言至关重要。
此外,Mistral Large 2的指令遵循和对话能力也大幅提升,尤其在处理精确指令和长时间多轮对话方面表现突出。
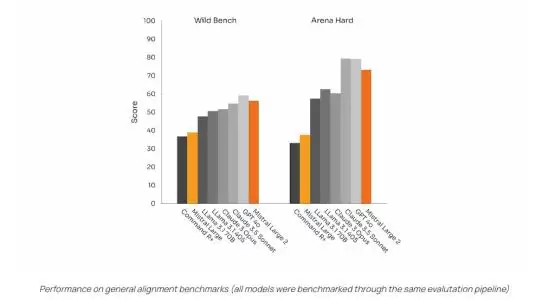
▲Mistral Large 2与其他模型在通用对齐基准测试中的性能对比
同时,模型在生成答案时尽量保持简洁明了,以加快交互速度、提升成本效益。
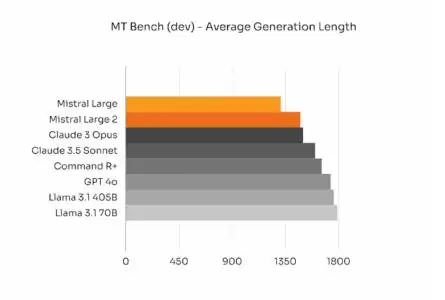
▲Mistral Large 2与其他模型生成回答的平均长度对比
目前,Mistral Large 2可通过Mistral平台(la Plateforme)访问,在Mistral研究许可下可供非商业使用。商业应用则需要获取Mistral的商业许可。用户也可以直接在le Chat上测试该模型,亲自体验其能力。
结语:在高性能和成本效益间找到平衡
AI模型的研发正在以前所未有的速度推进,科技巨头和新兴创业公司之间的竞争异常激烈。但一个明显的趋势是:大家不再一味追求神经网络的规模。Mistral Large 2的发布预示着一个潜在方向——在高性能和成本效益之间找到平衡点。
Mistral AI表示,Mistral Large 2正是他们在成本效益、生成速度和性能上的新尝试。参数1230亿,性能却接近4050亿的Llama 3.1 405B,同时还能快速给出简洁准确的回答。几天前,三款小模型(Mistral Nemo、GPT-4o mini、SmolLM)的陆续发布也印证了同一个道理:不是参数量越大就越好。未来,我们期待更多更具成本效益的模型出现,推动AI生成模型生态的多元化发展。