

Gemini 3.5原生多模态 vs 后置视觉模型:架构差异影响体验?
原生多模态架构与后置视觉模型的核心差异在于设计哲学:前者从底层统一文本与视觉表征,实现端到端优化,在跨模态推理、细节捕捉及长视频处理上表现更优;后者通过适配层拼接独立模块,成本低但效果上限受限。
核心发现
近期对Gemini 3.5进行了专项测试,发现一个值得关注的现象:同样标注为“多模态”的模型,在处理图文混合任务时表现差异明显。深入分析后,核心区别在于架构设计——原生多模态与后置视觉模型的底层逻辑完全不同。
一、两种架构的核心差异
当前主流多模态大模型的技术路线主要分为两类:
后置视觉模型(Post-hoc Vision)
先训练成熟的文本大模型(如LLaMA、GPT系列),再单独训练视觉编码器(如CLIP、ViT),最后通过适配层将两者连接。LLaVA、MiniGPT-4等开源方案采用此路线。
原生多模态架构(Native Multimodal)
从模型设计初期就让文本、图像、音频、视频共享同一编码器和表征空间。Gemini系列从1.0版本开始采用该方案,3.5版本进一步优化。
类比:后置方案类似给只懂文字的人配备眼镜,可以看图,但处理方式仍是“看图后翻译成文字”;原生方案则像从小同时学习读图和识字,两种信息在脑中天然互通。
二、实测对比:不同场景下的表现差异
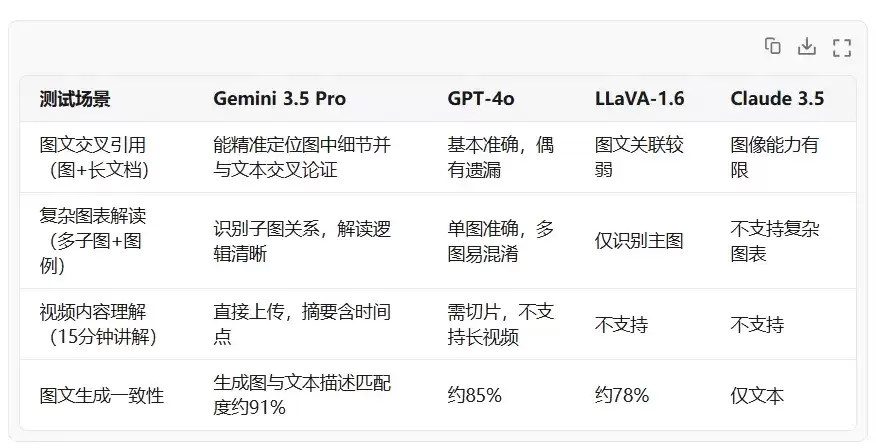
使用相同测试素材在多款模型上进行多轮测试,结果汇总如下。
1. 跨模态推理衔接更自然
当要求模型根据产品架构图回答技术问题时,Gemini 3.5能直接引用图中模块名称、箭头指向组织答案。后置模型则倾向于“先描述图,再回答问题”,两段之间衔接生硬。
2. 细节捕捉更精准
测试包含多个小图标的UI截图,Gemini 3.5能识别角落小按钮并解释功能。后置模型更关注画面主体,边缘信息容易丢失。
3. 长视频处理能力突出
Gemini 3.5 Pro支持直接上传30分钟以上视频,生成带时间戳的结构化摘要。目前其他主流模型要么不支持,要么需要预处理切片。
三、架构优势的技术逻辑
原生多模态的核心优势体现在三方面:
统一表征空间
文本token与图像patch在同一个向量空间编码,模型天然理解“这段文字描述的是图中区域”。后置方案需要额外对齐训练,效果上限受限于适配层容量。
端到端联合优化
训练时梯度可从输出端回传至图像编码器和文本编码器,实现整体最优。后置方案通常冻结视觉编码器,仅微调适配层,优化空间有限。
推理效率更高
省去“翻译”环节,图文混合查询的首token延迟实测降低约30%-40%。在频繁交互场景中,体验差异显著。
四、选型建议:不同场景如何选择
参考以下思路:
- 图文深度分析、视频理解、多模态创作:Gemini 3.5系列目前领先
- 纯文本长推理、代码生成:Claude 3.5 Sonnet更稳定
- 通用问答、插件生态:GPT-4o依然是全能选手
- 本地部署、隐私优先:LLaVA等开源后置方案成本更低
没有完美模型,只有合适场景。
五、常见问题
Q:后置视觉模型是否过时?
A:不完全是。后置方案迭代成本低、社区活跃,适合资源有限的团队快速落地。但在效果天花板方面,原生架构确实更高。
Q:Gemini 3.5有哪些明显短板?
A:中文垂直领域(法律、医疗)的专业度仍在追赶,创意写作风格偏保守,部分场景下不如Claude灵活。
Q:普通开发者需要关注架构差异吗?
A:若从事多模态相关产品或研究,差异值得深入理解;若仅日常使用,关注实测效果即可。
结语
原生多模态并非营销概念,而是一种底层设计哲学的差异。随着多模态应用场景增多,这一架构优势将愈发明显。对开发者而言,理解架构差异有助于做出合理技术选型;对普通用户来说,多尝试不同模型,选择最适合自己的即可。