

Node.js 核心原理与常用模块应用指南
本文深入解析Node.js的核心运行机制,包括单线程、非阻塞I/O与事件驱动模型如何提升服务器并发性能。同时详细讲解Node模块系统的加载机制、exports与require的使用规范,以及http、url、fs等常用内置模块的实际应用方法。
本文详细解析Node.js模块的运行原理与具体用法,旨在帮助开发者深入理解其工作机制,供参考学习。
简介
V8引擎最初是为Chrome浏览器设计的JavaScript解释器,Ryan Dahl将其移植到服务器端,从而诞生了Node.js。Node是一个专注于高性能Web服务器优化的项目,它的诞生得益于V8引擎的应用。
- Node.js没有历史包袱,也不使用同步I/O操作。这避免了因同步I/O导致事件循环性能急剧下降的问题。
- V8引擎的性能非常优异,其执行速度远超Python、Ruby等其他脚本语言的引擎。
- JavaScript语言具备闭包特性,这使得回调函数的使用比C语言更加便捷高效。
Node.js使得JavaScript能够运行在服务器端,将JavaScript的应用范围延伸至后端开发,使其能与PHP、JSP、Python、Ruby等语言进行后端开发对比或结合。
然而,Node.js的设计理念似乎有所不同:
- Node.js并非一种独立的编程语言,它与PHP、JSP、Python、Perl、Ruby等“既是语言也是平台”的技术不同,Node.js使用JavaScript进行编程,并运行在JavaScript引擎(V8)之上。
- 与PHP、JSP等需要运行在Apache、Nginx、Tomcat、IIS等服务器程序上的技术不同,Node.js跳过了这些HTTP服务器层,并不建立在任何传统服务器之上。其设计理念与经典的LAMP架构(Linux + Apache + MySQL + PHP)有显著差异,能够提供强大的伸缩能力。
- Node.js没有Web容器。
- Node.js旨在以最小的硬件成本追求更高的并发处理能力和处理性能。
Node特点
所谓特点,即Node.js如何解决服务器高性能瓶颈问题。当提到JavaScript的特点时,人们通常会想到 单线程、事件驱动 和 面向对象。但JavaScript的精髓在于 this、闭包、作用域链 以及 函数,正是这些特性赋予了这门语言无穷的魅力。
单线程
在Java、PHP或.NET等服务器端语言中,系统会为每个用户连接创建一个新的线程,每个线程大约消耗2MB内存。理论上,8GB内存的服务器最多只能同时连接约4000个用户。若要支持更多用户,必须增加服务器数量,从而推高硬件成本。Node.js不为每个用户连接创建新线程,而是仅使用一个线程。当有用户连接时,触发内部事件,通过非阻塞I/O和事件驱动机制,使Node.js在宏观上实现并行处理。在Node.js中,8GB内存的服务器可同时处理超过4万用户的连接。单线程的好处是操作系统无需承担线程创建和销毁的时间开销。但坏处是,若某个用户导致线程崩溃,整个服务将崩溃,其他用户的服务也会中断。
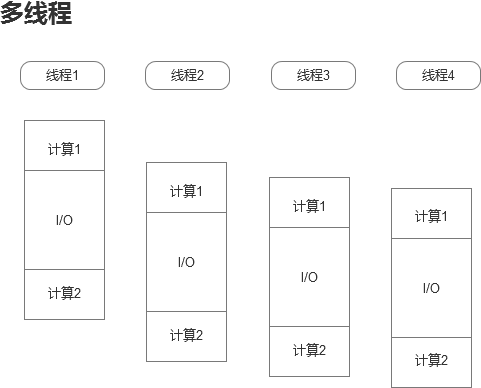
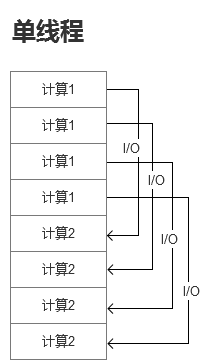
单线程机制也能实现宏观上的“并发”效果。
非阻塞I/O
非阻塞I/O(non-blocking I/O)
例如,访问数据库获取数据需要一定时间。在传统单线程处理机制中,执行访问数据库代码后,整个线程会暂停,等待数据库返回结果才能执行后续代码。这意味着I/O阻塞了代码执行,极大降低了程序效率。
Node.js采用非阻塞型I/O机制,因此在执行访问数据库代码后,会立即转而执行后续代码,将数据库返回结果的处理代码放入回调函数中,从而提高程序执行效率。当某个I/O操作完成时,会以事件形式通知执行I/O操作的线程,线程执行该事件的回调函数。为了处理异步I/O,线程必须有事件循环,不断检查是否有未处理的事件并依次处理。在阻塞模式下,一个线程只能处理一项任务,提高吞吐量需通过多线程实现;而在非阻塞模式下,一个线程始终在执行计算操作,CPU核心利用率可达100%。这类似于:与其多人工作但许多人闲着,不如一个人全力工作。
事件驱动(event-driven)
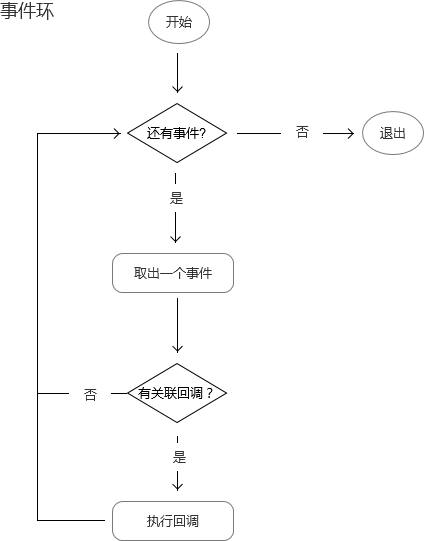
在Node.js中,客户端请求建立连接、提交数据等行为会触发相应事件。在任一时刻,Node.js只能执行一个事件回调函数,但在执行中途可转而处理其他事件(如新用户连接),随后返回继续执行原事件的回调函数。这种处理机制称为“事件环”机制。
Node.js底层由C++(V8也是C++)编写。底层代码中近半数用于构建事件队列和回调函数队列,通过事件驱动完成服务器任务调度。仅用一个线程便担负起处理大量任务的工作。
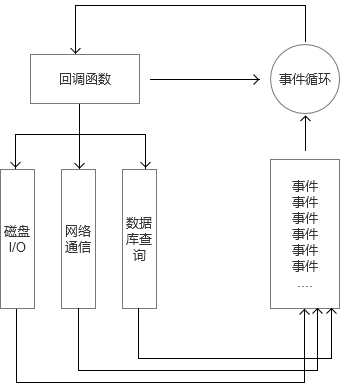
单线程减少了内存开销及操作系统的内存换页操作。若某任务执行时被I/O阻塞,该线程便会阻塞。非阻塞I/O不会傻等I/O语句结束,而是执行后续语句。利用事件驱动,无论是新用户请求还是老用户I/O完成,都以事件方式加入事件环中等待调度。
Node.js所有的I/O操作都是异步的,表现为回调函数嵌套回调函数。
Node.js是单进程单线程应用程序,但通过事件和回调支持并发,因此性能非常高。Node.js的每个API都是异步的,并作为一个独立线程运行,使用异步函数调用处理并发。Node.js几乎所有的事件机制都采用设计模式中的观察者模式实现。Node.js的单线程类似于进入一个while(true)的事件循环,直到没有事件观察者退出,每个异步事件都生成一个事件观察者,若有事件发生则调用该回调函数。
模块
模块(module)
在Node.js中,以模块为单位划分所有功能,并提供完整的模块加载机制,可将应用程序划分为各个不同部分。
在Node.js中,一个JavaScript文件中定义的变量和函数仅在该文件内部有效。
狭义上,每个JavaScript文件都是一个模块;多个JavaScript文件之间可以相互require,共同实现一个功能,对外整体呈现,这被称为广义上的模块。
好处:
- 减少重复代码量,增加代码可读性。
- 方便进行代码规划。
- 方便使用第三方模块。
当需要从JS文件外部引用这些变量或函数时,必须使用exports对象或module.exports进行暴露。使用者需要使用require()函数引入该JS文件。
function People( name,sex,age ){
  this.name = name;
  this.sex = sex;
  this.age = age;
}

People.prototype = {
  sayHello: function(){
    console.log(this.name+this.sex+this.age);
  }
};

// 暴露
module.exports = People;
// 使用
var People = require('./People.js');

var p1 = new People('zf','nv','23');

p1.sayHello();
一个JavaScript文件可以向外exports无数个变量、函数或对象,但require()时仅需载入一次JS文件。因此,无形中会增加一个顶层命名空间。
// 变量
// 需要变量引用 使用
exports.a = 10;
// 直接需要变量值使用.
module.exports = name;

// 对象
module.exports = {
 name1: 123,
 name2: 456
}
// 暴露结果: { name1: 123, name2: 456 }

exports.msg = {
 name1: 1,
 name2: 2
}
// 暴露结果 : { msg: { name1: 1, name2: 2 } }


// 函数
exports.showMsg = function () {
}

// 暴露结果 : { showMsg: [Function] }
// 在 引用结果 需要 通过 变量 引用对象 执行
// var msg = require();
// msg.showMsg();


module.exports = function () {
}
// 暴露结果 [Function]
// 引入文件的 变量 直接执行
模板引擎
数据绑定,成为一个完整的HTML字符串。Node.js中常用的模板引擎有ejs和jade。
后台模板引擎:
<ul>
  <% for(var i = 0 ; i < news.length ; i++){ %>
   <li><%= news[i] %></li>
  <% } %>
</ul>
// 模板中需要的数据
var dictionary = {
 a:6,
 news : ["xixi","haha"]
};
HTTP模块
主要类
Class: http.Server
var server = http.createServer();server就是http.Server类的实例。
常用的方法有:
server.listen(port, [hostname], [backlog], [callback])
Class: http.ServerResponse
var server = http.createServer(function(req,res){ });res就是 http.ServerResponse类的实例。
Class: http.IncomingMessage```var server = http.createServer(function(req,res){ });```req就是http.IncomingMessage类的实例。
server对象
可以使用on语法监听某个事件。
var http = require('http');
var server = http.createServer();

server.on('request',function ( req,res ) {
 res.setHeader('Content-type','text/html;charset=utf8');
 if ( req.url == '/' ){
  res.end('index');
 } else {
  res.end('404');
 }
});

server.listen(8080,'localhost');
req对象
每次上行请求头对象
req.headers //HTTP上行请求头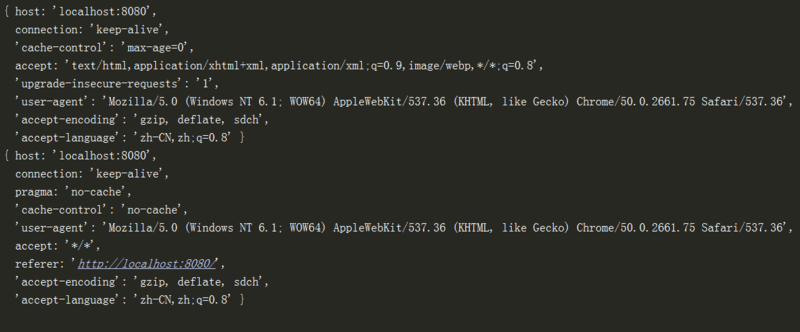
req.httpVersion // http请求的版本。现在基本上都是1.1
req.method  //  “GET”、”POST”就是请求的类型
req.url // 用户请求的网址
res对象
每次下行响应对象
res.end() // 每次都要有这个语句,表示这次的发送已经结束
  // 参数必须是string、buffer(图片、文件)。

res.write()  // 就是写HTTP下行请求的body

res.setHeader()     // 设置返回的报文头部

res.statusCode = 404;  // 设置状态码

res.writeHead()     // 和res.setHeader差不多
res.writeHead(288 , {"Content-Type":"text/plain"});
url模块
作用内置模块,解析url,解析地址。 分析和解析 URL 的工具
url.parse()
url.parse()就是用来解析网址,接收一个字符串,返回一个JSON:
var obj = url.parse("http://localhost:8080/a/b/c/1.html?name=ting&age=21"); 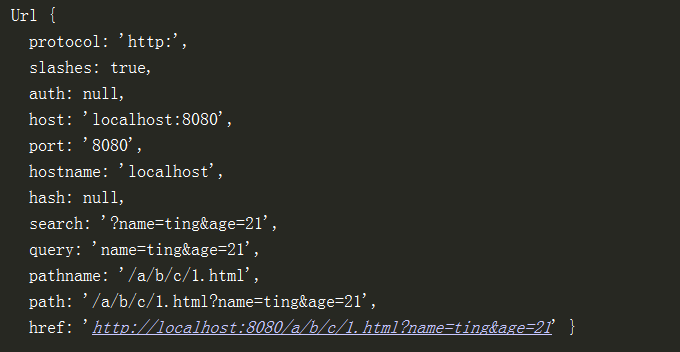
url.parse方法第二个参数如果是true,那么返回的对象中的query就是json
query: { xingming: 'xiaoming', age: '12' }querystring模块
querystring模块是专门用来解析GET请求的查询字符串的。
console.log( qs.parse('name=ting&age=21&hobby=run&hobby=sing') );
// 返回:{ name: 'ting', age: '21', hobby: [ 'run', 'sing' ] }
path模块
处理和转换文件路径的工具集,专门处理路径
path.basename()  返回路径中的文件名
path.dirname()  返回路径中的文件夹名
path.extname()  返回路径的拓展名

console.log( path.basename('/xixi/haha/a.html') ); //a.html
console.log( path.extname('/xixi/haha/a.html') ); //.html
console.log( path.dirname('/xixi/haha/a.html') ); ///xixi/haha
fs模块
文件处理模块,可以读文件,也可以写文件
fs.readFile();      //读取文件内容
fs.readDir();      //读取文件夹名
fs.appendFile();    //追加文件
fs.writeFile();     //写入文件(覆盖原有的)
fs.rename();      //修改文件名
自定义模块
每一个js文件中可以看成是一个小小的模块require()谁,就会执行谁。就相当于调用一个函数。A require B, 先执行B全部语句,然后执行A的剩余语句。
require('./test/a.js'); 每个js文件就是一个闭包,声明的函数、变量只在这个js文件内部有定义。A require了 B , 那么B里面的所有路径都要按照A的路径写。
如果需要使用到其它文件中的变量,使用exports暴露出去。
exports.*** = ***;
testA .js
var a = 100;
exports.a = a;
主文件
var testA = requrie('./testA.js');
console.log( testA.a );
暴露唯一的接口,module.exports ,一般使用到构造函数。
如果只有写文件载入,会去默认文件夹下:node_modules 寻找是否有当前需要载入的文件
require('test.js'); 也可以直接省略路径、省略文件名,只写文件夹名
require('aa'); 实际上引用的是node_moduels文件夹里面的aa文件夹里面的index.js文件。 一般第三方模块,都放入node_modules文件夹中。
package.json
配置信息:
{
 "name": "my_package",  //项目名字
 "version": "1.0.0",  //版本号
 "main": "index.js",  //入口文件
 "keywords": [],    //关键词,就是搜索什么npm上能够显示你
 "author": "ag_dubs",  //作者
 "license": "ISC",   //版权协议
 "repository": {       //代码托管仓库,这个会自动生成一个连接
  "type": "git",
  "url": "https://github.com/ashleygwilliams/my_package.git"
 },
 "bugs": {        //如果发现bug应该交给谁
  "url": "https://github.com/ashleygwilliams/my_package/issues"
 },
  "dependencies": {
  "underscore": "*",
 "date-format" : "0.0.2"
 },
  "homepage": "https://github.com/ashleygwilliams/my_package"  //个人网站
}
最重要的信息是:依赖
{
 "dependencies": {
  "underscore": "*",
 "date-format" : "^0.0.2"
 }
}
formidable
处理POST请求
// formidable 语法
var form = new formidable.IncomingForm();

// 设置上传路径
form.uploadDir = "./uploads";
form.parse(req, function(err, fields, files) {
 // fields是普通域,就是普通的文本框、单选按钮、复选按钮、textarea都存在这个对象里面
 // files是上传的文件信息
 var newname = df('yyyyMMddhhmmssSSS', new Date());

 fs.rename(files.touxiang.path , "./uploads/" + newname + ".jpg",function(err){
   if(err){
     res.end("error");
     return ;
   }
 });
 res.end("ok");
});
爬虫初级
需要的npm包:
- express
- request (后端发送请求的模块)
- cheerio (像前端一样操作拉取回来的数据)
爬虫以及Robots协议介绍:
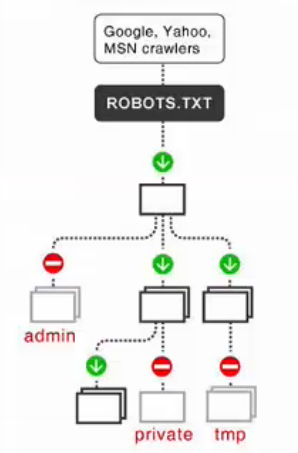
- 爬虫,是中自动获取网页内容的程序。是搜索引擎的重要组成部分,因此搜索引擎优化很大程度上就是针对爬虫而做出的优化。
- robots.txt是一个文本文件,robots.txt是一个协议,不是一个命令。robots.txt是爬虫要查看的第一个文件。robots.txt文件告诉爬虫在服务器上什么文件是可以被查看的,搜索机器人就会按照该文件中的内容来确定访问的范围。
var express = require('express');
var app = express();
var cheerio = require('cheerio');

app.get('/', function(req, res){

  var request = require('request');

  request('https://linxingzhang.com', function(err, response, body) {
    if (!err && response.statusCode == 200) {
      $ = cheerio.load(body); // 和jquery的$('body') 一样

      res.json({
        panel: $('#link-panel li').length
      });
    }
  });

});

app.listen(3000);使用supervisor启动
> supervisor start app.js常用npm包
| 模块名 | 链接地址 | 简介 |
|---|---|---|
| async | async | 异步操作管理 |
| bl | bl | 二进制数据解析 |
| bluebird | bluebird | 异步操作管理 |
| browserify | browserify | 发布浏览器可用的包 |
| bunyan | bunyan | 日志(logging)管理 |
| chai | chai | 断言 |
| chalk | chalk | 命令行彩色输出 |
| co | co | 异步流程管理 |
| colors | colors | 命令行彩色输出 |
| commander | commander | 命令行工具 |
| debug | debug | Debug输出器 |
| dockerode | dockerode | Docker管理 |
| duplexify | duplexify | Stream流操作工具 |
| event-stream | event-stream | Stream流操作工具 |
| express | express | Server服务器框架 |
| hapi | hapi | Server服务器框架 |
| koa | koa | Server服务器框架 |
| glob | glob | 文件名匹配 |
| grunt | grunt | 构建工具 |
| gulp | gulp | 构建工具 |
| hyperquest | hyperquest | 轻量级HTTP客户端 |
| istanbul | istanbul | 测试用例覆盖率分析 |
| JSONStream | JSONStream | Stream流管理工具 |
| levelup | levelup | LevelDB |
| lodash | lodash | 函数式编程工具 |
| log4js | log4js | 日志(logging)管理工具 |
| minimatch | minimatch | 文件名匹配 |
| minimist | minimist | 命令行操作 |
| mocha | mocha | 单元测试 |
| moment | moment | 日期时间输出 |
| mongodb | mongodb | MongoDB |
| mysql | mysql | MySQL |
| nconf | nconf | 配置工具 |
| needle | needle | 轻量级HTTP客户端 |
| node-fetch | node-fetch | Fetch API |
| nodemailer | nodemailer | Email客户端 |
| passport | passport | 登录和认证 |
| pg | pg | Postgres |
| pump | pump | Stream流管理工具 |
| redis | redis | Redis |
| request | request | HTTP客户端 |
| restify | restify | REST API搭建 |
| socket.io | socket.io | WebSocket实时通信 |
| split2 | split2 | Stream流管理工具 |
| tape | tape | 单元测试 |
| through2 | through2 | Stream流管理工具 |
| underscore | underscore | 函数式编程工具 |
| ws | ws | Websockets |
| xml2js | xml2js | XML转换为JavaScript |
| http-server | http-server | 命令行的HTTP服务器 |
| nrm | nrm | 更改NPM下载源 |
| node-inspector | node-inspector | Node调试 |
| supervisor | supervisor | 检测Node进程的服务 |
| nodemon | nodemon | 在文件有变化之后会自动重启服务 |
希望本文所述对大家node.js程序设计有所帮助。
怎么在本地运行JavaScript脚本:Node.js下载安装与环境配置教程
2026-11-05 09:02:33
JavaScript开发环境怎么搭建:Node.js安装与VS Code配置指南
2026-11-03 23:36:59
JavaScript零基础入门:环境搭建与第一个Hello World
2026-11-03 23:34:09
NW.js 是什么:基于 Chromium 和 Node.js 的桌面应用框架
2026-11-03 15:14:00
nvm、n 和官方安装包:哪种 Node.js 升级方式更适合你
2026-11-03 14:54:28