

AI大模型入门教程:从零基础到精通(详细版)
从零基础入门到精通AI大模型,系统讲解基础概念、环境搭建、机器学习与深度学习原理,通过小模型实战练手,进而使用预训练模型和微调技术。涵盖实战项目与进阶学习,提供完整学习路线,助力掌握大模型开发与应用。
近年来,人工智能大模型发展极为迅速,用“一日千里”来形容并不过分。GPT-3、BERT等模型不仅在学术界备受关注,在大众领域也积累了大量认知。它们在自然语言处理、图像识别等方面的能力已经得到广泛应用。如果你是一名刚入门的开发者,希望从零开始系统掌握这些大型模型,这篇教程可以帮助你打好基础。
第一部分:理解AI大模型的基础
1.1 什么是AI大模型?
AI大模型,是指参数量巨大的深度学习模型,通常在亿级甚至百亿级以上。这类模型通过海量数据训练,能够自动生成文本、回答问题、完成翻译任务。其核心依然是深度学习——利用多层神经网络从数据中提取特征。
1.2 关键概念
在深入学习大模型之前,需要了解几个基础概念:
- 参数:模型中可学习的变量,直接影响输出结果。参数越多,模型的表达能力越强。
- 训练数据:提供给模型的数据集,包含输入和对应的输出标签。
- 损失函数:用于评估模型预测结果与真实值之间的差距,模型据此调整优化方向。
- 优化器:如SGD、Adam等算法,负责调整参数,使损失函数值不断下降。
第二部分:准备学习环境
2.1 硬件准备
大模型的训练和推理对硬件有一定要求。最便捷的方式是准备一台带GPU的电脑——NVIDIA GTX 1660或更高型号基本可以满足需求。
2.2 软件准备
- 安装Python:推荐Python 3.6及以上版本,这是AI领域的主流语言。
- 安装Anaconda:用于管理环境和依赖包,可减少配置麻烦。
- 安装深度学习框架:主流选择包括TensorFlow和PyTorch,按需安装即可。
TensorFlow安装命令:
pip install tensorflowPyTorch安装命令:
pip install torch torchvision torchaudio- 安装其他常用库:
pip install numpy pandas matplotlib transformers第三部分:学习基础知识
3.1 深入理解机器学习和深度学习
上手大模型之前,需要掌握机器学习和深度学习的基本原理。机器学习使计算机能从数据中自动学习并做出预测,常见算法包括决策树、支持向量机等。深度学习是机器学习的子集,依靠多层神经网络处理图像、声音、文本等复杂数据。
3.2 开始使用小模型
掌握基础后,建议从小模型开始实践。经典的MNIST手写数字识别、CIFAR-10图像分类都是不错的入门项目。以下是使用PyTorch实现手写数字识别的示例:
import torch
import torchvision
import torchvision.transforms as transforms
from torch import nn, optim

transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

trainset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=64, shuffle=True)

class SimpleNN(nn.Module):
    def __init__(self):
        super(SimpleNN, self).__init__()
        self.fc1 = nn.Linear(28 * 28, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):
        x = x.view(-1, 28 * 28)
        x = torch.relu(self.fc1(x))
        x = self.fc2(x)
        return x

model = SimpleNN()
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

for epoch in range(5):
    for images, labels in trainloader:
        optimizer.zero_grad()
        outputs = model(images)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()
第四部分:探索大模型
4.1 使用预训练模型
许多大模型已有预训练版本可直接使用——Hugging Face的Transformers库提供了丰富的资源。以下是快速使用GPT-2生成文本的示例:
from transformers import GPT2Tokenizer, GPT2LMHeadModel

tokenizer = GPT2Tokenizer.from_pretrained("gpt2")
model = GPT2LMHeadModel.from_pretrained("gpt2")

input_text = "Once upon a time"
input_ids = tokenizer.encode(input_text, return_tensors='pt')

output = model.generate(input_ids, max_length=50)
generated_text = tokenizer.decode(output[0], skip_special_tokens=True)
print(generated_text)
4.2 微调模型
实际项目中,直接使用通用预训练模型往往不够,需要针对具体任务进行微调(Fine-tuning)。这样既能发挥大模型的潜力,又能使其快速适配特定场景。
4.3 了解大模型的架构
建议深入研究BERT、GPT、T5等代表性模型的架构设计。理解它们成功的原因,对后续创新和应用有重要启发。
第五部分:实战项目与进阶学习
5.1 实战项目
理论学习需要结合实践。可以利用公开数据集开展情感分类、机器翻译、图像生成等实际项目,积累真实经验。
5.2 进阶学习
多阅读前沿文献,关注最新模型和技术进展;参与Kaggle等数据科学竞赛,通过实战检验能力。
5.3 参与社区
GitHub、Stack Overflow等平台上有大量活跃开发者,参与交流能帮助拓宽视野,解决实际问题。
结语
从零基础到精通AI大模型并非易事,但按照上述路径逐步学习,那些看似遥不可及的技术会变得清晰可循。遇到问题时不要轻易放弃,持续学习和动手实践是最好的解决方式。
在大模型时代,如何有效学习大模型?
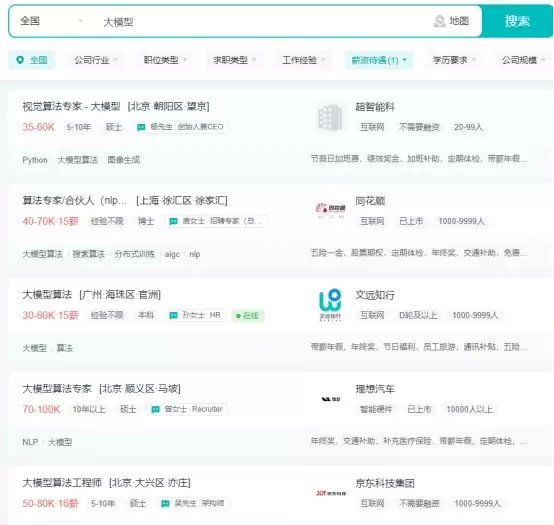
目前大模型岗位需求快速增长,相关人才紧缺,薪资持续走高:AI运营岗位平均薪资约18457元,AI工程师平均薪资约37336元,大模型算法岗位平均薪资约39607元。
掌握大模型技术还能带来更多发展机会:
- 成为全栈大模型工程师,覆盖Prompt、LangChain、LoRA等技术开发、运营、产品等方向;
- 具备模型二次训练和微调能力,能够主导智能对话、文生图等热门应用开发;
- 薪资上浮10%-20%,覆盖更多高薪岗位,是大模型领域的高需求、高待遇方向;
- 优质项目可以为未来创新创业奠定基础。
许多人希望学习AI大模型技术,并借助这项技能实现升职加薪、就业或副业目标,但面对海量资料不知从何入手——缺乏系统学习往往事倍功半。
一、AGI大模型系统学习路线
很多人在学习大模型时缺乏方向,零散学习容易陷入混乱。以下是一套完整的学习路线,可供参考。
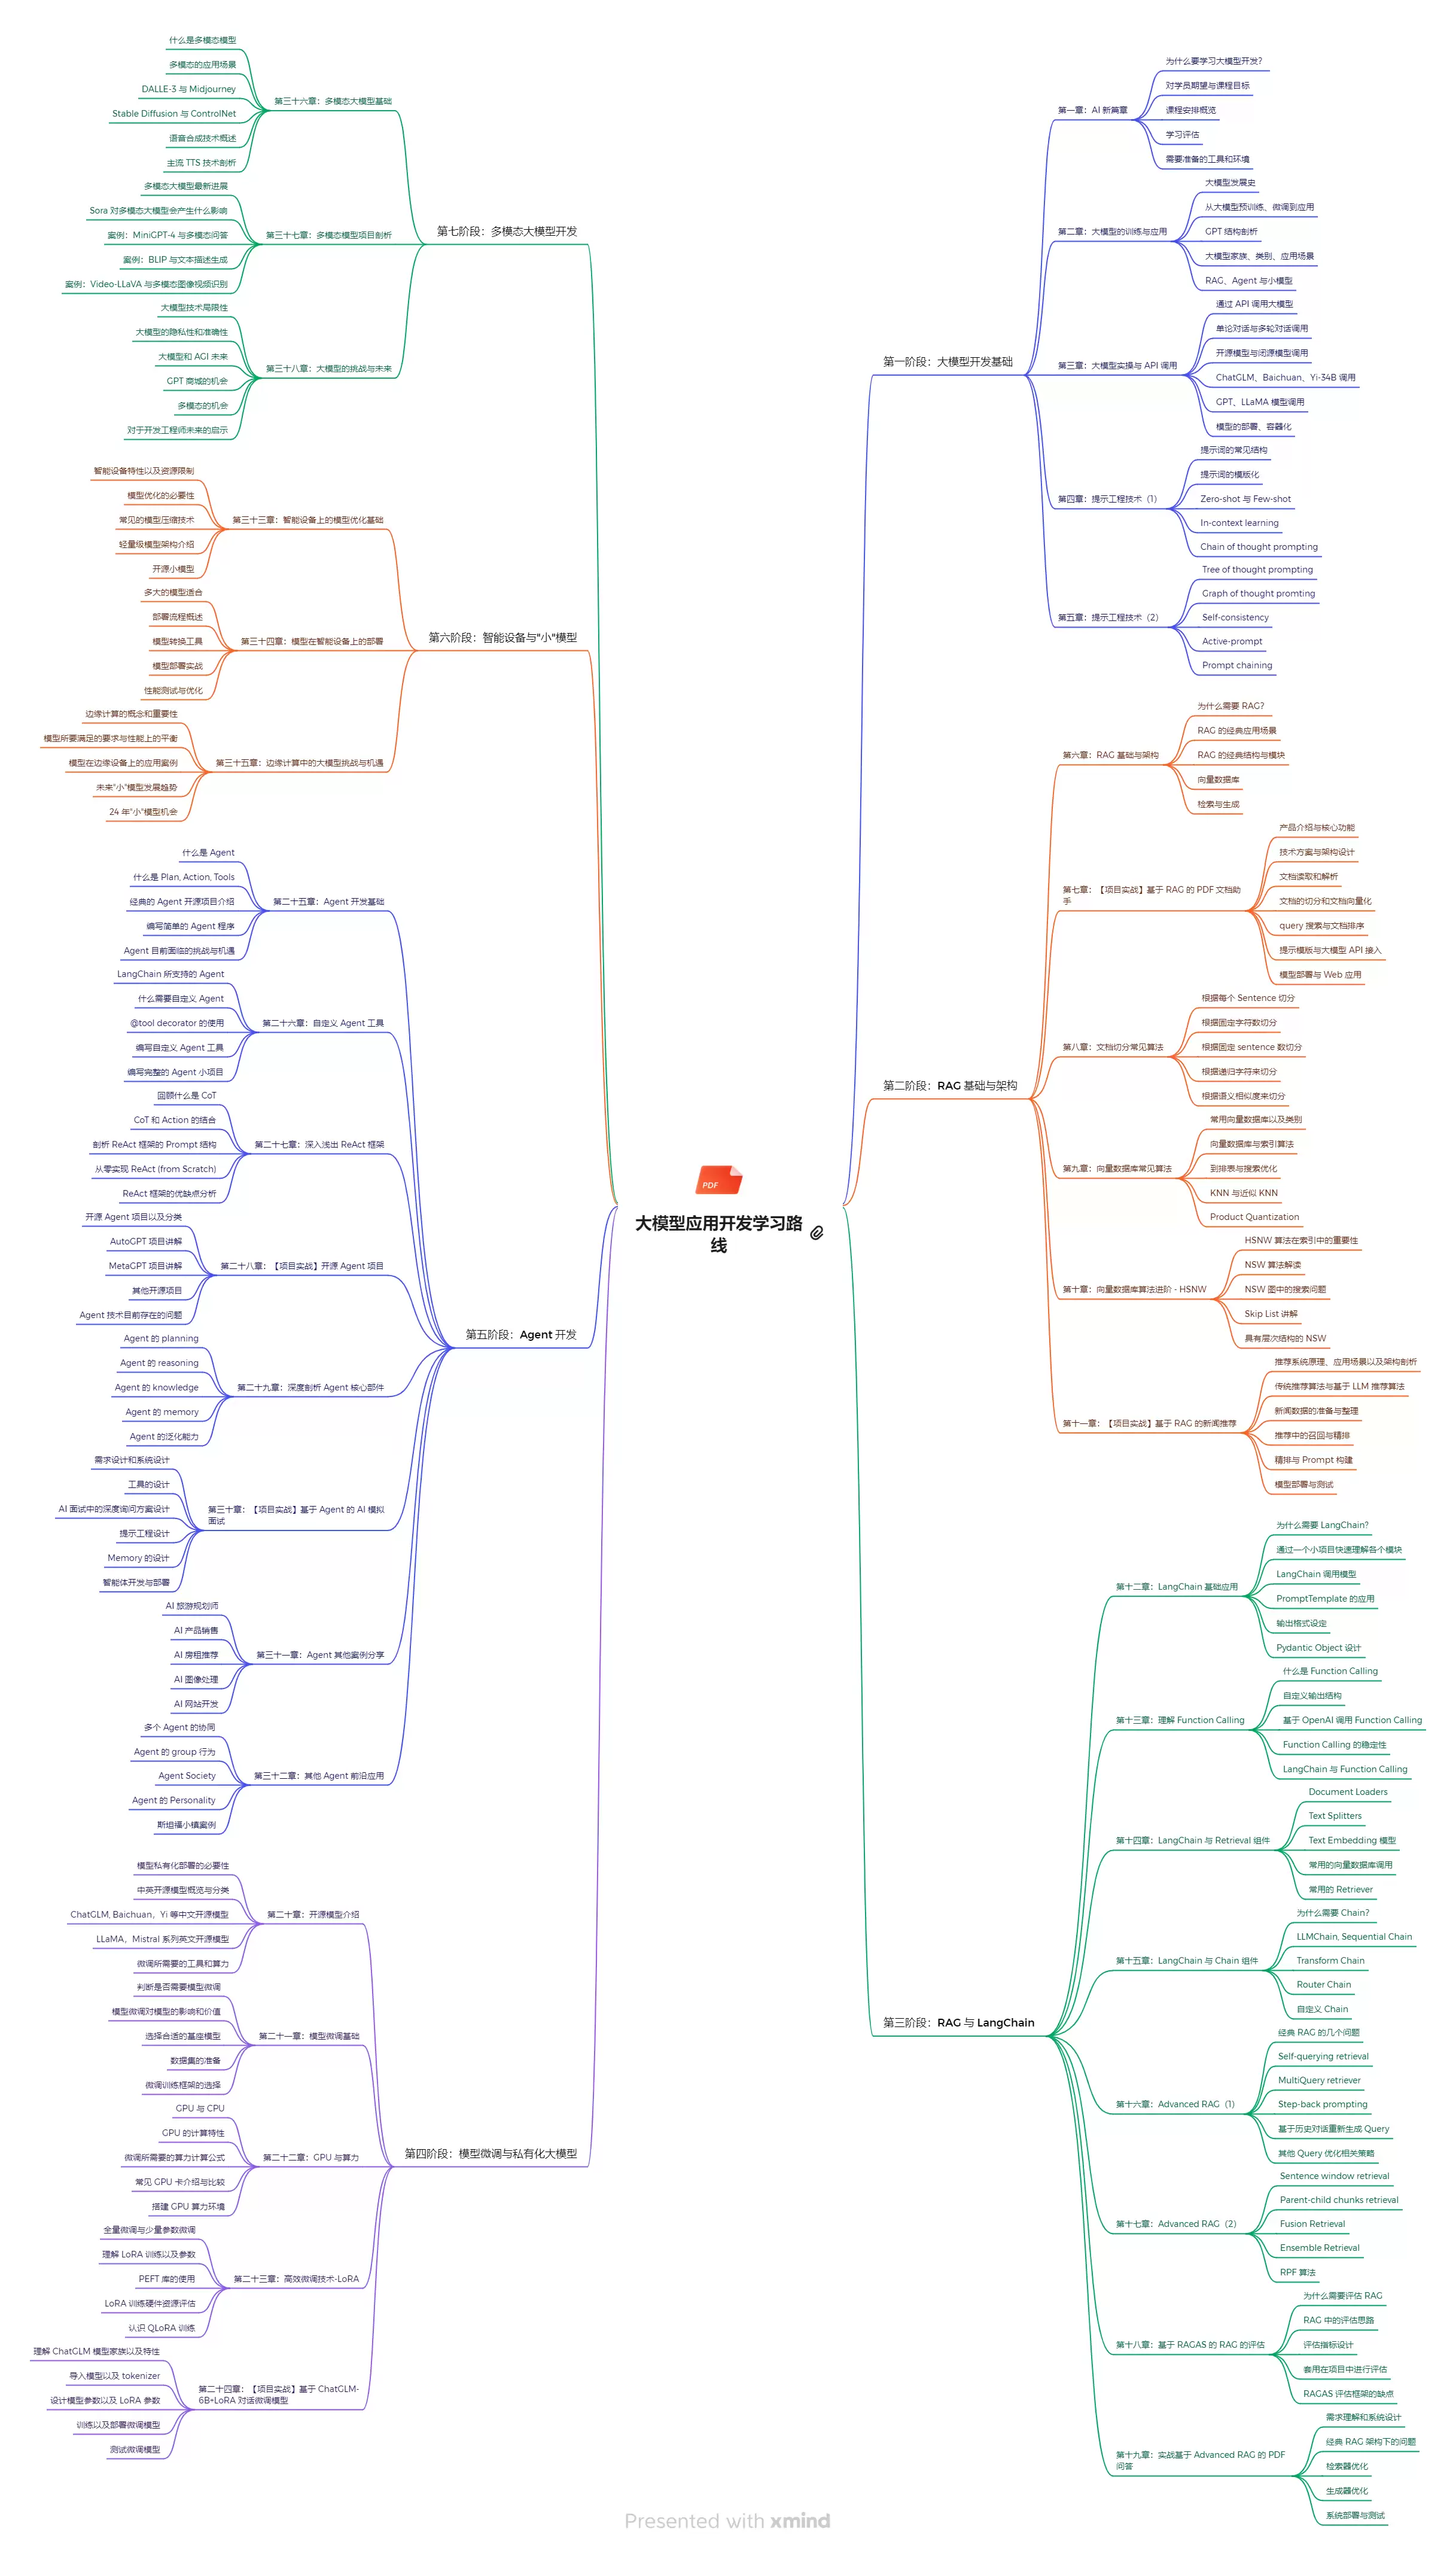
第一阶段:从大模型系统设计入手,讲解大模型的主要方法;
第二阶段:通过大模型提示词工程,从Prompts角度更好发挥模型作用;
第三阶段:大模型平台应用开发,借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段:大模型知识库应用开发,以LangChain框架为例构建物流行业咨询智能问答系统;
第五阶段:大模型微调开发,借助大健康、新零售、新媒体领域构建适合当前领域的大模型;
第六阶段:以SD多模态大模型为主,搭建文生图小程序案例;
第七阶段:以大模型平台应用与开发为主,通过星火大模型、文心大模型等成熟产品构建行业应用。
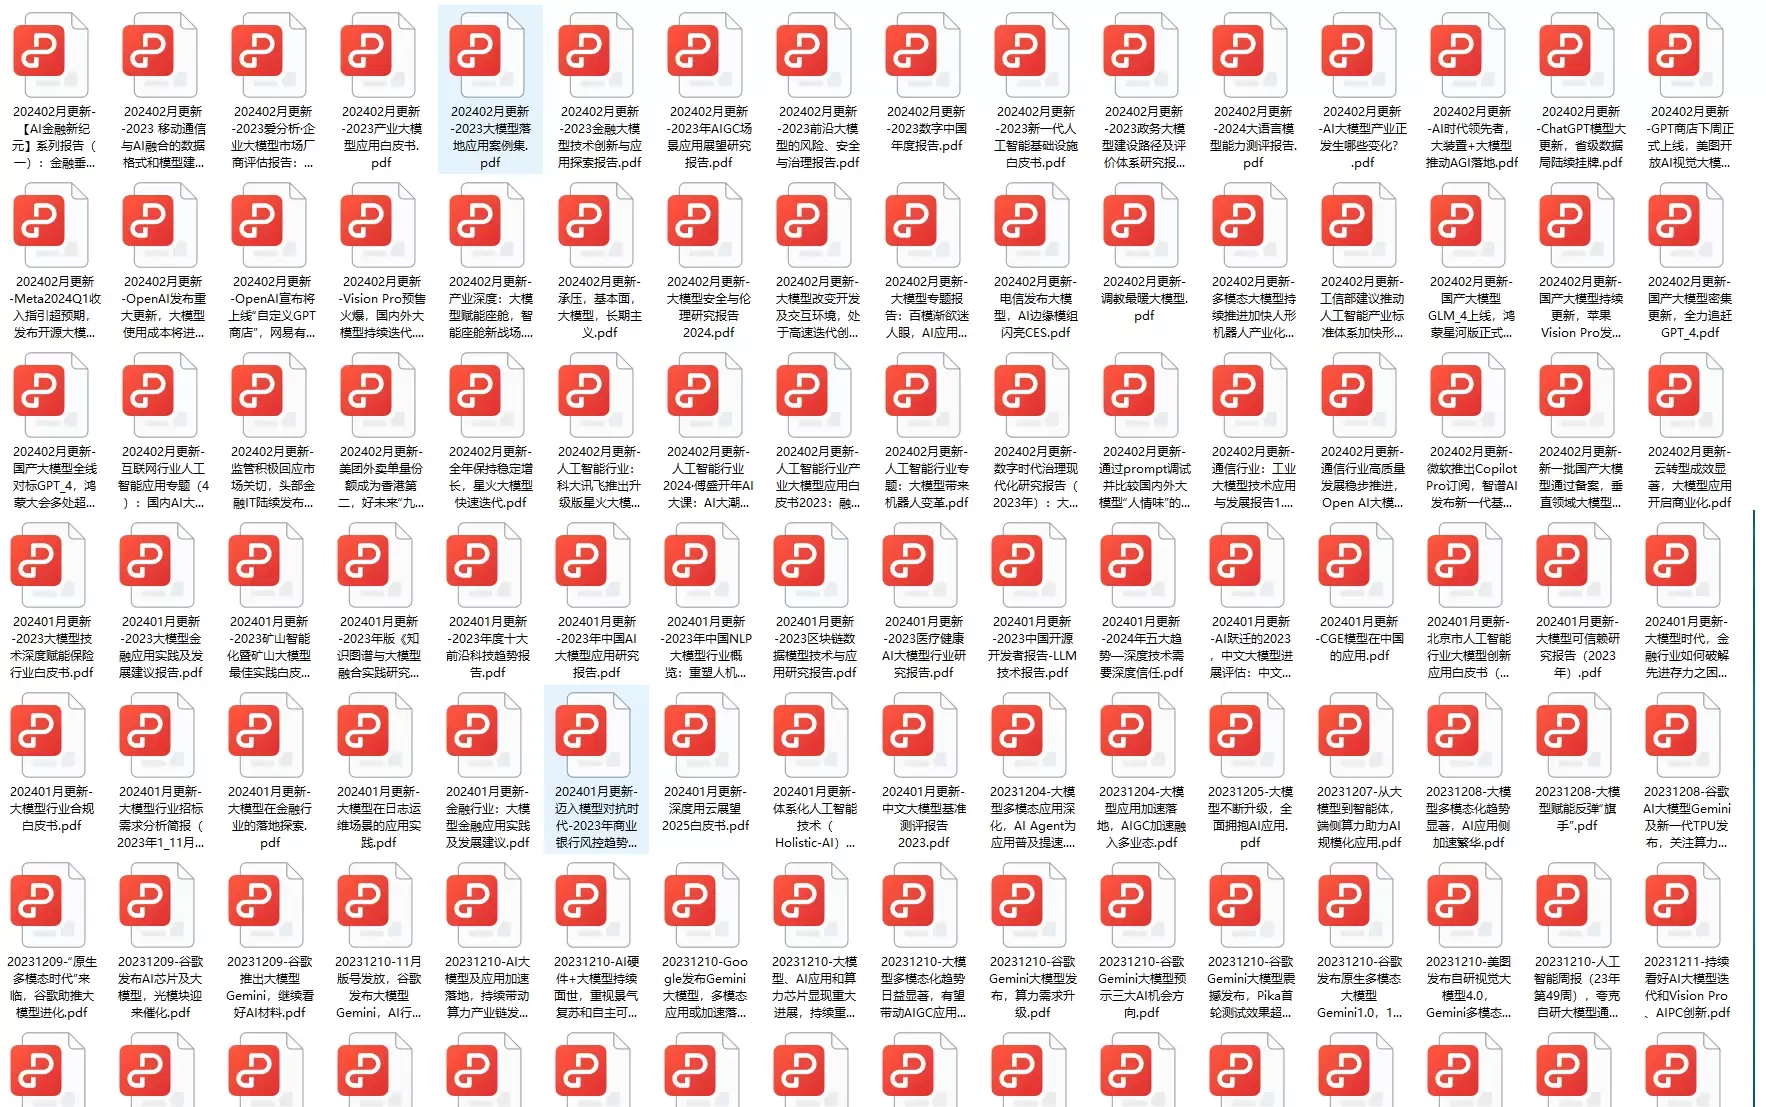
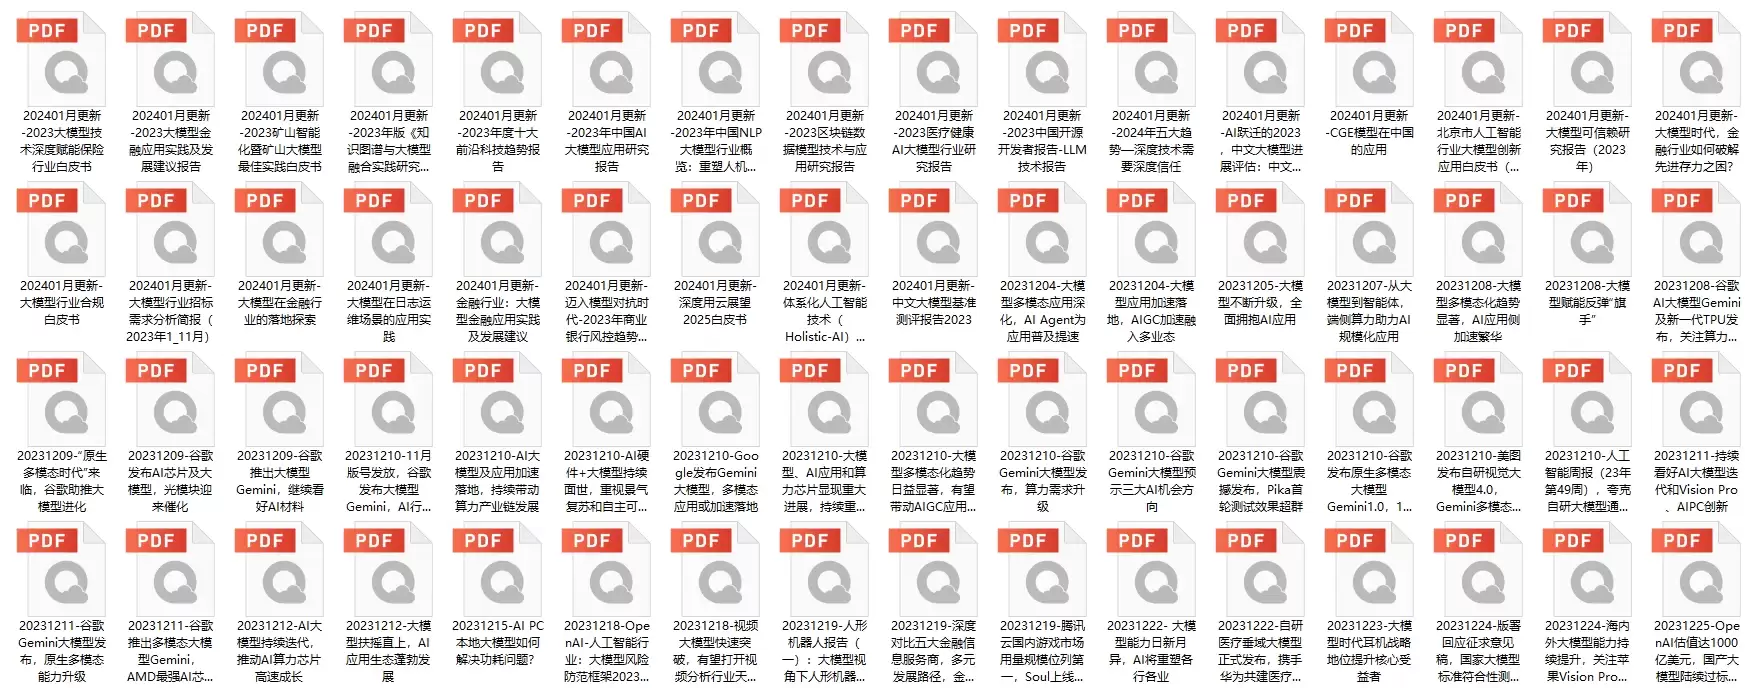
二、640套AI大模型报告合集
这套包含640份报告的合集,覆盖AI大模型的理论研究、技术实现、行业应用等多个方面。无论你是科研人员、工程师,还是AI大模型爱好者,都能从中获取有价值的信息。
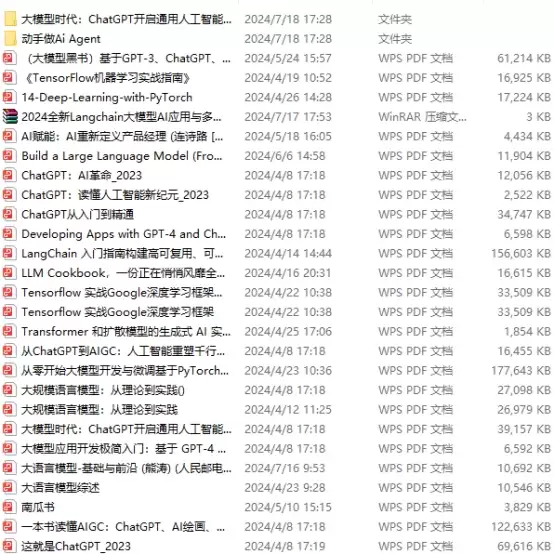
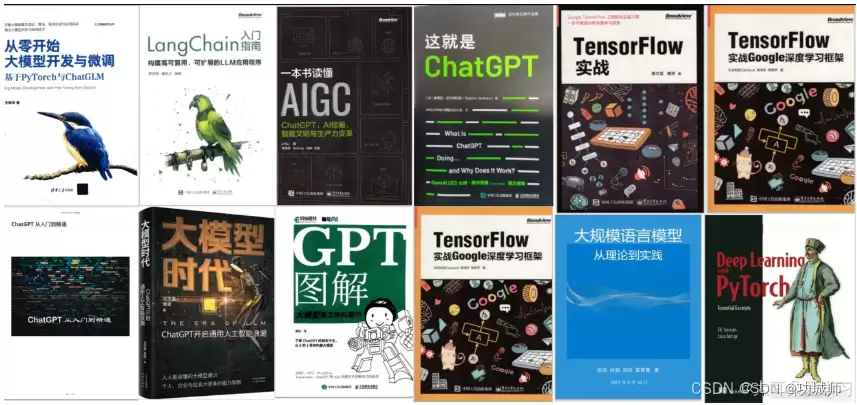
三、AI大模型经典PDF书籍
随着人工智能技术快速发展,大型预训练模型如GPT-3、BERT、XLNet等正在改变人们对AI的认知。以下PDF书籍是非常不错的学习资源。
四、AI大模型各大场景实战案例
结语
以上资源可以帮助你系统性地学习大模型,但一切的核心仍在于持续的实践与思考。