

MySQL存储过程for循环处理查询结果方式
MySQL存储过程可利用游标实现查询结果的循环处理,关键步骤包括声明游标、打开游标、循环取数、判断结束标识及关闭游标。通过FETCH逐行获取数据,结合LOOP循环执行业务逻辑,适用于批处理场景。
在日常的 MySQL 使用中,存储过程是非常实用的功能——它相当于一组预先编译好的 SQL 指令,可以反复调用。然而,当存储过程查询出多条结果后,往往需要逐条处理这些数据。此时,循环就显得至关重要。接下来介绍如何在 MySQL 存储过程中实现查询结果的循环处理。
1. 创建表
先搭建一个简单的场景。我们准备两张表:t_job 用于存储任务,t_task 用于记录每次执行的具体情况。建表语句如下:
CREATE TABLE `t_job` (
  `job_id` int(11) unsigned NOT NULL AUTO_INCREMENT,
  `job_name` varchar(50) DEFAULT NULL,
  `next_time` timestamp NULL DEFAULT NULL COMMENT '下次执行时间',
  `last_task` int(11) DEFAULT NULL,
  PRIMARY KEY (`job_id`)
) ENGINE=InnoDB AUTO_INCREMENT=2 DEFAULT CHARSET=utf8mb4;

CREATE TABLE `t_task` (
  `task_id` int(11) unsigned NOT NULL AUTO_INCREMENT,
  `start_time` datetime DEFAULT NULL,
  `end_time` datetime DEFAULT NULL,
  `status` tinyint(1) DEFAULT NULL,
  `job_id` int(11) NOT NULL,
  PRIMARY KEY (`task_id`)
) ENGINE=InnoDB AUTO_INCREMENT=25 DEFAULT CHARSET=utf8mb4;
2. 存储过程查询结果
2.1 创建存储过程
先给出一个基础版本,只处理单条记录。逻辑很简单:查询需要执行的 job,然后向 t_task 插入一条记录,同时更新 t_job 表的下次执行时间和最近一次任务 ID。
CREATE DEFINER=`root`@`%` PROCEDURE `p_sayn_job`()
BEGIN
  #Routine body goes here...
  DECLARE v_cnt INT;
  DECLARE v_job_id INT;

  SELECT count( 1 ) INTO v_cnt
  FROM t_job j
  WHERE j.next_time < SYSDATE();

  IF v_cnt > 0 THEN
    -- 插入数据
    INSERT INTO t_task ( start_time, end_time, STATUS, job_id )
    VALUES ( SYSDATE(), SYSDATE()+ 1, 1, v_job_id );

    -- 更新数据
    UPDATE t_job j
    SET j.last_task = ( SELECT MAX( t.task_id ) FROM t_task t WHERE t.job_id = j.job_id ),
        j.next_time = DATE_ADD( j.next_time, INTERVAL 1 DAY )
    WHERE j.job_id = v_job_id;
  END IF;
END
这个版本只能处理一条记录,但如果符合条件的 job 有多条,就需要使用循环。
2.2 添加 for 循环语句
这里的关键是游标(Cursor)。简单来说,游标就是用来逐行遍历结果集的一个指针。下面拆开来看具体步骤。
先用 DECLARE 声明一个游标,把需要循环的查询结果放入:
-- DECLARE语句声明游标
DECLARE jobs CURSOR FOR
  (SELECT j.job_id FROM t_job j WHERE j.next_time > SYSDATE());
接着声明一个变量来标记循环何时结束:
-- 声明变量
DECLARE v_finished  int DEFAULT FALSE;
-- 结束标识
DECLARE CONTINUE HANDLER FOR NOT FOUND SET v_finished = TRUE;
然后打开游标,开始处理:
-- OPEN语句打开游标
OPEN  jobs ;
真正循环迭代的部分,用一个 LOOP 结构包起来:
-- 循环迭代 jobs
read_loop : LOOP
END LOOP read_loop;
在循环内,用 FETCH 语句取出一行数据,同时将游标移动到下一行:
-- 使用FETCH语句检索光标指向的下一行,并将光标移动到结果集中的下一行。
FETCH jobs into v_job_id;
如何判断循环结束?使用之前声明的 v_finished 变量。当 FETCH 发现没有更多数据时,提前设置的 CONTINUE HANDLER 会将 v_finished 设为 TRUE:
-- 使用v_finished变量来检查列表是否有id来终止循环。
IF v_finished THEN
  LEA VE read_loop;
END IF;
在这段判断之后,就可以放心地加入自己的业务逻辑。最后需要用 CLOSE 关闭游标,释放内存:
-- CLOSE语句以停用游标并释放与其关联的内存
CLOSE jobs;
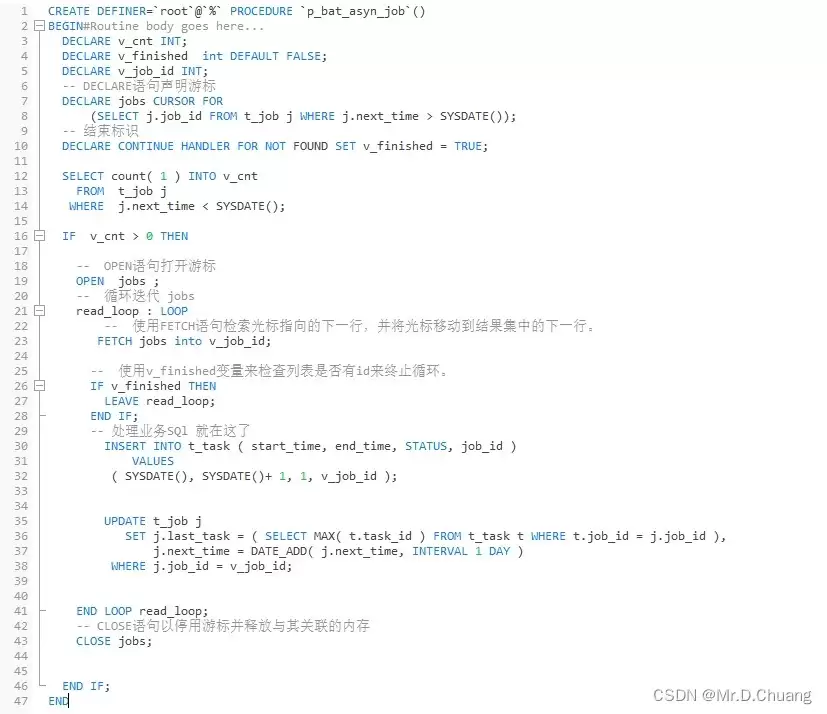
将以上零件组合起来,就是一个完整的带循环的存储过程:
CREATE DEFINER=`root`@`%` PROCEDURE `p_sayn_job`()
BEGIN
  #Routine body goes here...
  DECLARE v_cnt INT;
  DECLARE v_finished  int DEFAULT FALSE;
  DECLARE v_job_id INT;

  -- DECLARE语句声明游标
  DECLARE jobs CURSOR FOR
    (SELECT j.job_id FROM t_job j WHERE j.next_time > SYSDATE());

  -- 结束标识
  DECLARE CONTINUE HANDLER FOR NOT FOUND SET v_finished = TRUE;

  SELECT count( 1 ) INTO v_cnt
  FROM t_job j
  WHERE j.next_time < SYSDATE();

  IF v_cnt > 0 THEN
    -- OPEN语句打开游标
    OPEN  jobs ;

    -- 循环迭代 jobs
    read_loop : LOOP
      -- 使用FETCH语句检索光标指向的下一行,并将光标移动到结果集中的下一行。
      FETCH jobs into v_job_id;

      -- 使用v_finished变量来检查列表是否有id来终止循环。
      IF v_finished THEN
        LEA VE read_loop;
      END IF;

      -- 处理业务SQL就在这了
      INSERT INTO t_task ( start_time, end_time, STATUS, job_id )
      VALUES ( SYSDATE(), SYSDATE()+ 1, 1, v_job_id );

      UPDATE t_job j
      SET j.last_task = ( SELECT MAX( t.task_id ) FROM t_task t WHERE t.job_id = j.job_id ),
          j.next_time = DATE_ADD( j.next_time, INTERVAL 1 DAY )
      WHERE j.job_id = v_job_id;

    END LOOP read_loop;

    -- CLOSE语句以停用游标并释放与其关联的内存
    CLOSE jobs;
  END IF;
END
2.3 保存执行存储过程
编写完成后,调用一下验证效果:
CALL p_sayn_job();
总结
游标的用法并不复杂,关键步骤包括:声明、打开、循环取数、判断结束、关闭。许多复杂的数据处理逻辑,都可以通过上述方式逐一拆解。希望这篇文章能帮助你少走弯路。