

JavaScript 正则表达式入门指南与实战示例
本文系统讲解 JavaScript 中正则表达式的创建方式、元字符与量词用法、优先级规则及 test、exec、match、replace 等核心方法。通过对比字面量与构造函数创建的区别,深入解析贪婪性与懒惰性,并介绍零宽断言的高级应用,帮助开发者高效处理复杂字符串匹配与替换任务。
正则表达式是什么?
正则表达式(regular expression)是一种用于描述字符串匹配模式的工具,可用于检查字符串中是否包含特定子串、替换匹配到的子串,或从字符串中提取符合特定条件的子串。
基础知识科普
在 JavaScript 中使用正则表达式时,除了掌握基本的匹配规则外,还需了解以下基础知识:
Python、JavaScript、Groovy 等脚本语言均有在线调试工具,可在线测试语法错误,使用便捷。
var reg = new RegExp('\\d{8-20}')
reg.test("11111111a")
这里的 \\,第一个 \ 是转义字符,用于转义。
上述示例还可以写成:
var reg = new RegExp(/\d{8-20}/)
reg.test("11111111a")
test 方法用于测试字符串是否匹配正则表达式的规则,exec 和 match 用于捕获匹配的子串。
简单来说,正则表达式就是用来处理字符串的,它可以用来处理一些复杂的字符串操作。
为什么要学习正则表达式?
我们直接用一个例子来说明。
//找出这个字符串中的所有数字
var str = 'abc123de45fgh6789qqq111';
//方法1
 function findNum(str) {
 var tmp = '',
  arr = [];
 for (var i = 0; i < str.length; i++) {
  var cur = str[i];
  if (!isNaN(cur)) {
  tmp += cur;
  } else {
  if (tmp) {
   arr.push(tmp);
   tmp = '';
  }
  }
 }
 if (tmp) {
  arr.push(tmp)
 }
 return arr;
 }
 console.log(findNum(str))
 //["123", "45", "6789", "111"]

//方法2 使用正则表达式
 var reg = /\d+/g;
 console.log(str.match(reg))
 // ["123", "45", "6789", "111"]
通过比较两种方法,我们可以明显看出,在处理字符串时,使用正则表达式会简单许多。因此,虽然正则表达式看起来像是一堆乱码,但我们仍有必要去学习它。
正则表达式的创建方式
1、字面量创建方式 2、实例创建方式
var reg = /pattern/flags
 // 字面量创建方式
 var reg = new RegExp(pattern,flags);
 //实例创建方式

 pattern:正则表达式
 flags:标识(修饰符)
 标识主要包括:
 1. i 忽略大小写匹配
 2. m 多行匹配,即在到达一行文本末尾时还会继续寻常下一行中是否与正则匹配的项
 3. g 全局匹配 模式应用于所有字符串,而非在找到第一个匹配项时停止
字面量创建方式与构造函数创建方式的区别
字面量创建方式不能进行字符串拼接,实例创建方式可以。
var regParam = 'cm';
var reg1 = new RegExp(regParam+'1');
var reg2 = /regParam/;
console.log(reg1); // /cm1/
console.log(reg2); // /regParam/
字面量创建方式中特殊含义的字符不需要转义,实例创建方式需要转义。
var reg1 = new RegExp('\d'); // /d/
var reg2 = new RegExp('\\d') // /\d/
var reg3 = /\d/;  // /\d/
元字符 代表特殊含义的元字符
\d : 0-9 之间的任意一个数字 \d 只占一个位置 \w : 数字,字母 ,下划线 0-9 a-z A-Z _ \s : 空格或者空白等 \D : 除了\d \W : 除了\w \S : 除了\s . : 除了\n 之外的任意一个字符 \ : 转义字符 | : 或者 () : 分组 \n : 匹配换行符 \b : 匹配边界 字符串的开头和结尾 空格的两边都是边界 => 不占用字符串位数 ^ : 限定开始位置 => 本身不占位置 $ : 限定结束位置 => 本身不占位置 [a-z] : 任意字母 [] 中的表示任意一个都可以 [^a-z] : 非字母 [] 中^代表除了 [abc] : abc 三个字母中的任何一个 [^abc] 除了这三个字母中的任何一个字符
代表次数的量词元字符
* : 0 到多个 + : 1 到多个 ? : 0 次或 1 次 可有可无 {n} : 正好 n 次; {n,} : n 到多次 {n,m} : n 次到 m 次
量词出现在元字符后面,如 \d+,限定出现在前面的元字符的次数。
var str = '1223334444';
var reg = /\d{2}/g;
var res = str.match(reg);
console.log(res) //["12", "23", "33", "44", "44"]

var str =' 我是空格君 ';
var reg = /^\s+|\s+$/g; //匹配开头结尾空格
var res = str.replace(reg,'');
console.log('('+res+')') //(我是空格君)
正则中的 () 和 [] 和重复子项 // 拿出来单独说一下
一般 [] 中的字符没有特殊含义,如 + 就表示 +。
但是像 \w 这样的还是有特殊含义的。
var str1 = 'abc';
var str2 = 'dbc';
var str3 = '.bc';
var reg = /[ab.]bc/; //此时的.就表示.
reg.test(str1) //true
reg.test(str2) //false
reg.test(str3) //true
[] 中,不会出现两位数。
[12]表示1或者2 不过[0-9]这样的表示0到9 [a-z]表示a到z
例如:匹配从18到65年龄段所有的人
var reg = /[18-65]/; // 这样写对么
reg.test('50')
reg = /(18|19)|([2-5]\d)|(6[0-5])/;
Uncaught SyntaxError: Invalid regular expression: /[18-65]/: Range out of order in character class 聪明的你想可能是 8-6 这里不对,于是改成 [16-85] 似乎可以匹配 16 到 65 的年龄段的,但实际上发现这也是不靠谱的实际上我们匹配这个 18-65 年龄段的正则我们要拆开来匹配我们拆成 3 部分来匹配 18-19 20-59 60-65
() 的提高优先级功能: 凡是有 | 出现的时候,我们一定要注意是否有必要加上 () 来提高优先级;
() 的分组 重复子项 (两个放到一起说)
分组: 只要正则中出现了小括号那么就会形成一份分组 只要有分组,exec(match) 和 replace 中的结果就会发生改变 (后边的正则方法中再说)
分组的引用 (重复子项) : 只要在正则中出现了括号就会形成一个分组,我们可以通过 \n (n 是数字代表的是第几个分组) 来引用这个分组,第一个小分组我们可以用 \1 来表示
例如:求出这个字符串 'abAAbcBCCccdaACBDDabcccddddaab' 中出现最多的字母,并求出出现多少次 (忽略大小写)。
var str = 'abbbbAAbcBCCccdaACBDDabcccddddaab';
 str = str.toLowerCase().split('').sort(function(a,b){return a.localeCompare(b)}).join('');

 var reg = /(\w)\1+/ig;
 var maxStr = '';
 var maxLen = 0;
 str.replace(reg,function($0,$1){
 var regLen = $0.length;
 if(regLen>maxLen){
  maxLen = regLen;
  maxStr = $1;
 }else if(maxLen == regLen){
  maxStr += $1;
 }
 })
 console.log(`出现最多的字母是${maxStr},共出现了${maxLen}次`)
当我们加 () 只是为了提高优先级而不想捕获小分组时,可以在 () 中加 ?: 来取消分组的捕获
var str = 'aaabbb';
var reg = /(a+)(?:b+)/;
var res =reg.exec(str);
console.log(res)
//["aaabbb", "aaa", index: 0, input: "aaabbb"]
//只捕获第一个小分组的内容
正则运算符的优先级
- 正则表达式从左到右进行计算,并遵循优先级顺序,这与算术表达式非常类似。
- 相同优先级的会从左到右进行运算,不同优先级的运算先高后低。
下面是常见的运算符的优先级排列
依次从最高到最低说明各种正则表达式运算符的优先级顺序:
\ : 转义符 (), (?:), (?=), [] => 圆括号和方括号 *, +, ?, {n}, {n,}, {n,m} => 量词限定符 ^, $, \ 任何元字符、任何字符 | => 替换,"或" 操作
字符具有高于替换运算符的优先级,一般用 | 的时候,为了提高 | 的优先级,我们常用 () 来提高优先级 如: 匹配 food 或者 foot 的时候 reg = /foo(t|d)/ 这样来匹配
正则的特性
1、贪婪性 所谓的贪婪性就是正则在捕获时,每一次会尽可能多的去捕获符合条件的内容。 如果我们想尽可能的少的去捕获符合条件的字符串的话,可以在量词元字符后加 ?
2、懒惰性 懒惰性则是正则在成功捕获一次后不管后边的字符串有没有符合条件的都不再捕获。 如果想捕获目标中所有符合条件的字符串的话,我们可以用标识符 g 来标明是全局捕获
var str = '123aaa456';
var reg = /\d+/; //只捕获一次,一次尽可能多的捕获
var res = str.match(reg)
console.log(res)
// ["123", index: 0, input: "123aaa456"]
reg = /\d+?/g; //解决贪婪性、懒惰性
res = str.match(reg)
console.log(res)
// ["1", "2", "3", "4", "5", "6"]
和正则相关的一些方法
这里我们只介绍 test、exec、match 和 replace 这四个方法
reg.test(str) 用来验证字符串是否符合正则 符合返回 true 否则返回 false
var str = 'abc';
var reg = /\w+/;
console.log(reg.test(str)); //true
reg.exec() 用来捕获符合规则的字符串
var str = 'abc123cba456aaa789';
var reg = /\d+/;
console.log(reg.exec(str))
// ["123", index: 3, input: "abc123cba456aaa789"];
console.log(reg.lastIndex)
// lastIndex : 0

reg.exec捕获的数组中
// [0:"123",index:3,input:"abc123cba456aaa789"]
0:"123" 表示我们捕获到的字符串
index:3 表示捕获开始位置的索引
input 表示原有的字符串
当我们用 exec 进行捕获时,如果正则没有加 'g' 标识符,则 exec 捕获的每次都是同一个,当正则中有 'g' 标识符时 捕获的结果就不一样了,我们还是来看刚刚的例子
var str = 'abc123cba456aaa789';
var reg = /\d+/g; //此时加了标识符g
console.log(reg.lastIndex)
// lastIndex : 0

console.log(reg.exec(str))
// ["123", index: 3, input: "abc123cba456aaa789"]
console.log(reg.lastIndex)
// lastIndex : 6

console.log(reg.exec(str))
// ["456", index: 9, input: "abc123cba456aaa789"]
console.log(reg.lastIndex)
// lastIndex : 12

console.log(reg.exec(str))
// ["789", index: 15, input: "abc123cba456aaa789"]
console.log(reg.lastIndex)
// lastIndex : 18

console.log(reg.exec(str))
// null
console.log(reg.lastIndex)
// lastIndex : 0
每次调用 exec 方法时,捕获到的字符串都不相同 lastIndex :这个属性记录的就是下一次捕获从哪个索引开始。 当未开始捕获时,这个值为 0。 如果当前次捕获结果为 null。那么 lastIndex 的值会被修改为 0.下次从头开始捕获。 而且这个 lastIndex 属性还支持人为赋值。
exec 的捕获还受分组 () 的影响
var str = '2017-01-05';
var reg = /-(\d+)/g
// ["-01", "01", index: 4, input: "2017-01-05"]
"-01" : 正则捕获到的内容
"01" : 捕获到的字符串中的小分组中的内容
str.match(reg) 如果匹配成功,就返回匹配成功的数组,如果匹配不成功,就返回 null
//match和exec的用法差不多
var str = 'abc123cba456aaa789';
var reg = /\d+/;
console.log(reg.exec(str));
//["123", index: 3, input: "abc123cba456aaa789"]
console.log(str.match(reg));
//["123", index: 3, input: "abc123cba456aaa789"]
上边两个方法 console 的结果有什么不同呢?二个字符串是一样滴。 当我们进行全局匹配时,二者的不同就会显现出来了.
var str = 'abc123cba456aaa789';
var reg = /\d+/g;
console.log(reg.exec(str));
// ["123", index: 3, input: "abc123cba456aaa789"]
console.log(str.match(reg));
// ["123", "456", "789"]
当全局匹配时,match 方法会一次性把符合匹配条件的字符串全部捕获到数组中, 如果想用 exec 来达到同样的效果需要执行多次 exec 方法。
我们可以尝试着用 exec 来简单模拟下 match 方法的实现。
String.prototype.myMatch = function (reg) {
 var arr = [];
 var res = reg.exec(this);
 if (reg.global) {
 while (res) {
  arr.push(res[0]);
  res = reg.exec(this)
 }
 }else{
 arr.push(res[0]);
 }
 return arr;
}

var str = 'abc123cba456aaa789';
var reg = /\d+/;
console.log(str.myMatch(reg))
// ["123"]

var str = 'abc123cba456aaa789';
var reg = /\d+/g;
console.log(str.myMatch(reg))
// ["123", "456", "789"]
此外,match 和 exec 都可以受到分组 () 的影响,不过 match 只在没有标识符 g 的情况下才显示小分组的内容,如果有全局 g,则 match 会一次性全部捕获放到数组中
var str = 'abc';
var reg = /(a)(b)(c)/;

console.log( str.match(reg) );
// ["abc", "a", "b", "c", index: 0, input: "abc"]
console.log( reg.exec(str) );
// ["abc", "a", "b", "c", index: 0, input: "abc"]


当有全局g的情况下
var str = 'abc';
var reg = /(a)(b)(c)/g;
console.log( str.match(reg) );
// ["abc"]
console.log( reg.exec(str) );
// ["abc", "a", "b", "c", index: 0, input: "abc"]
str.replace() 这个方法大家肯定不陌生,现在我们要说的就是和这个方法和正则相关的东西了。
正则去匹配字符串,匹配成功的字符去替换成新的字符串
写法:str.replace(reg,newStr);
var str = 'a111bc222de';
var res = str.replace(/\d/g,'Q')
console.log(res)
// "aQQQbcQQQde"

//replace的第二个参数也可以是一个函数
str.replace(reg,fn);

var str = '2017-01-06';
str = str.replace(/-\d+/g,function(){
 console.log(arguments)
})

//控制台打印结果:
["-01", 4, "2017-01-06"]
["-06", 7, "2017-01-06"]
"2017undefinedundefined"
//从打印结果我们发现每一次输出的值似乎跟exec捕获时很相似,既然与exec似乎很相似,那么似乎也可以打印出小分组中的内容喽

var str = '2017-01-06';
str = str.replace(/-(\d+)/g,function(){
 console.log(arguments)
})
["-01", "01", 4, "2017-01-06"]
["-06", "06", 7, "2017-01-06"]
"2017undefinedundefined"
//从结果看来我们的猜测没问题。
此外,我们需要注意的是,如果我们需要替换 replace 中正则找到的字符串,函数中需要一个返回值去替换正则捕获的内容。 通过 replace 方法获取 url 中的参数的方法
(function(pro){
 function queryString(){
 var obj = {},
  reg = /([^?&#+]+)=([^?&#+]+)/g;
 this.replace(reg,function($0,$1,$2){
  obj[$1] = $2;
 })
 return obj;
 }
 pro.queryString = queryString;
}(String.prototype));

// 例如 url为 https://www.baidu.com?a=1&b=2
// window.location.href.queryString();
// {a:1,b:2}
零宽断言
用于查找在某些内容 (但并不包括这些内容) 之前或之后的东西,如 \b,^,$ 那样用于指定一个位置,这个位置应该满足一定的条件 (即断言),因此它们也被称为零宽断言。
在使用正则表达式时,捕获的内容前后必须是特定的内容,而我们又不想捕获这些特定内容的时候,零宽断言就可以派上用场了。
- 零宽度正预测先行断言 (?=exp)
- 零宽度负预测先行断言 (?!exp)
- 零宽度正回顾后发断言 (?<=exp)
- 零宽度负回顾后发断言 (?<!exp)
这四胞胎看着名字好长,给人一种好复杂好难的感觉,我们还是挨个来看看它们究竟是干什么的吧。
(?=exp) 这个简单理解就是说字符出现的位置的右边必须匹配到 exp 这个表达式。
var str = "i'm singing and dancing";
var reg = /\b(\w+(?=ing\b))/g
var res = str.match(reg);
console.log(res)
// ["sing", "danc"]
注意一点,这里说到的是位置,不是字符。
var str = 'abc';
var reg = /a(?=b)c/;
console.log(res.test(str)); // false

// 这个看起来似乎是正确的,实际上结果是false
reg 中 a(?=b) 匹配字符串 'abc' 字符串 a 的右边是 b 这个匹配没问题,接下来 reg 中 a(?=b) 后边的 c 匹配字符串时是从字符串 'abc' 中 a 的后边 b 的前边的这个位置开始匹配的, 这个相当于 /ac/ 匹配 'abc',显然结果是 false 了
(?!exp) 这个就是说字符出现的位置的右边不能是 exp 这个表达式。
var str = 'nodejs';
var reg = /node(?!js)/;
console.log(reg.test(str)) // false
(?<=exp) 这个就是说字符出现的位置的前边是 exp 这个表达式。
var str = '¥998$888';
var reg = /(?<=\$)\d+/;
console.log(reg.exec(str)) //888
(?<!exp) 这个就是说字符出现的位置的前边不能是 exp 这个表达式。
var str = '¥998$888';
var reg = /(?<!\$)\d+/;
console.log(reg.exec(str)) //998
最后,来一张思维导图
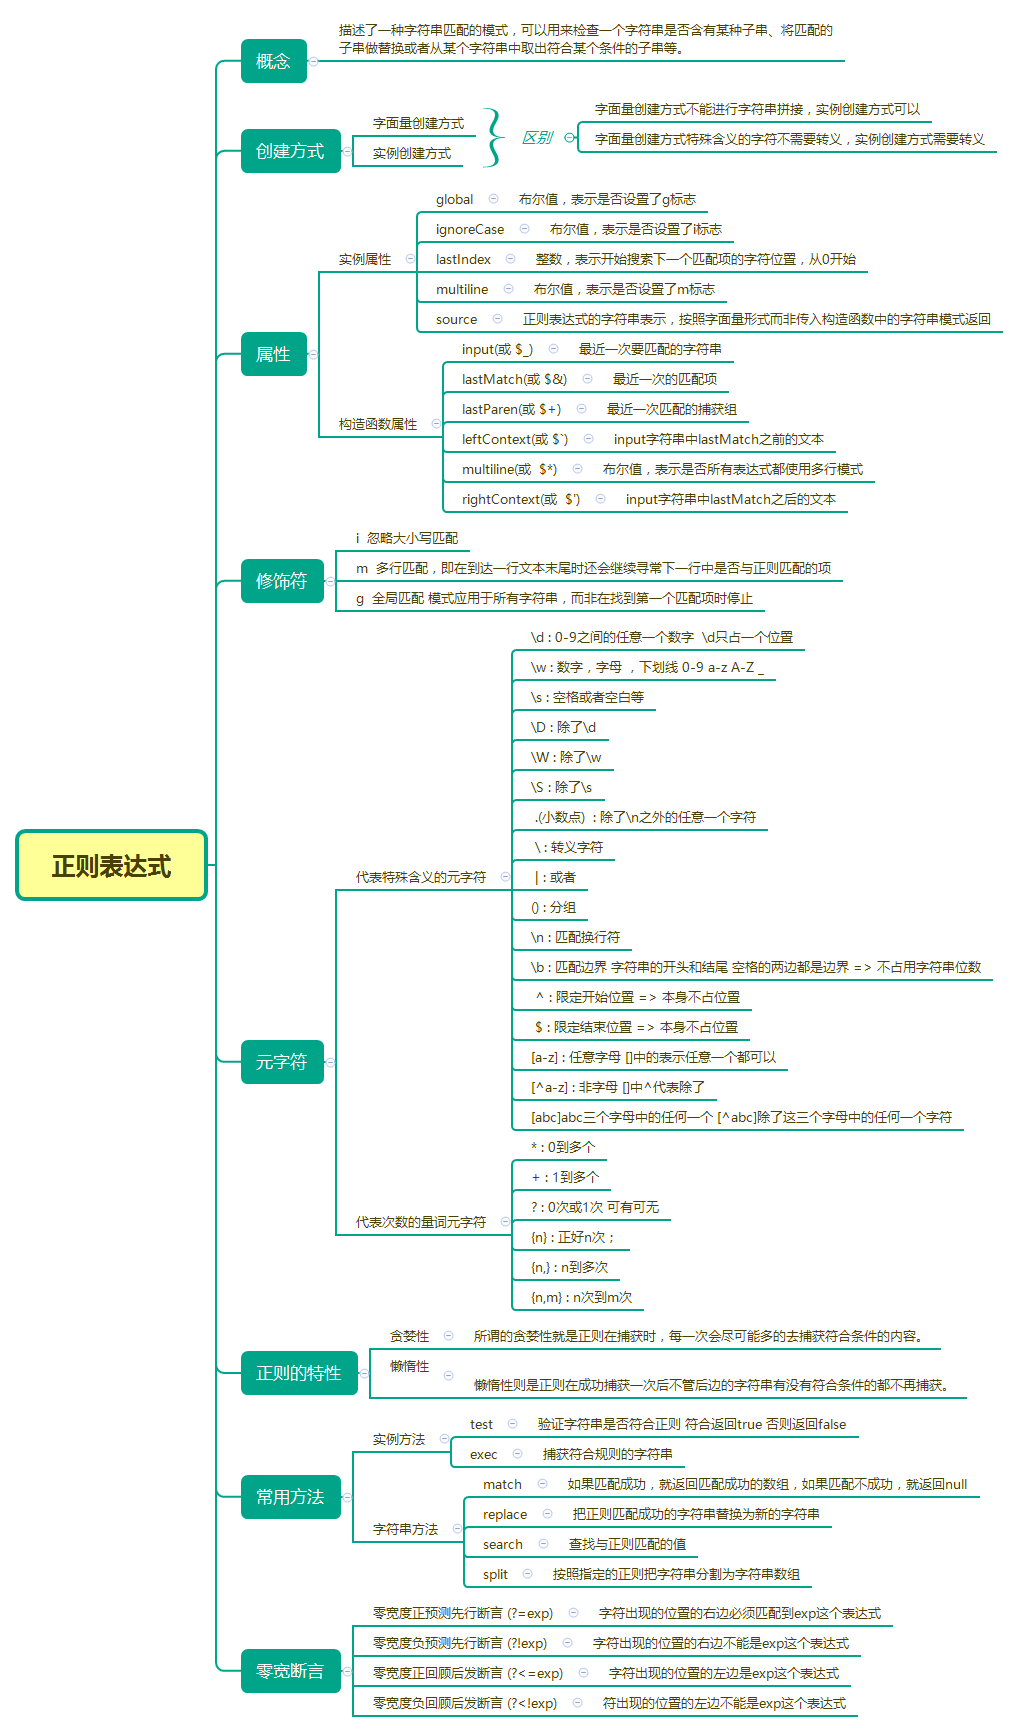
图片如果放大也看不清的话 下载地址 如有错误欢迎指正!
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13