

人工智能如何训练自编码器
训练自编码器需依次完成数据清洗与归一化、构建编码器与解码器结构、选择均方误差等损失函数、配置Adam或SGD优化器、迭代训练并调整超参数、通过测试集评估重构效果,最终应用于降维或异常检测等场景。
在人工智能领域,自编码器是一种非常实用的工具,擅长对数据进行高效的编码与重构。通过训练自编码器,可以挖掘数据中隐藏的潜在特征,进而实现降维、异常检测等众多应用。那么,具体该如何训练一个自编码器?下面从实操层面逐步拆解。
第一步:数据准备
训练自编码器的第一步是收集并整理好数据集。数据质量对训练效果影响很大,必要的清洗和预处理不可省略,例如归一化操作,将数据调整到合适的范围,这样后续训练会更顺畅。
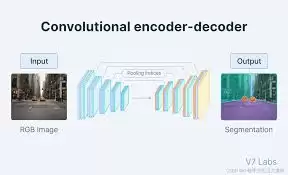
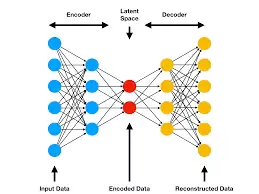
第二步:构建自编码器模型
接下来需要设计神经网络的结构。自编码器通常包含两个部分:编码器负责将输入数据映射到低维空间,解码器则将低维表示还原回原始数据空间。具体使用哪些层?全连接层、卷积层都可以,根据数据特点灵活选择。
第三步:定义损失函数
损失函数的选择很关键,最常用的是均方误差(MSE)。它衡量原始输入与经过编码-解码重构后数据之间的差异。目标很明确:让损失值尽可能小,从而迫使自编码器学会高效编码和解码。
第四步:选择优化器
优化器负责调整模型参数,逐步降低损失函数的值。Adam、SGD等是常见选项,各有特点与适用场景。具体选哪个?根据任务和数据量来定,没有绝对标准答案。
第五步:训练模型
将准备好的数据输入模型,用选定的优化器不断更新参数,使损失函数逐步下降。训练过程中需要留意几个超参数:训练轮数、批次大小等,它们会影响最终效果,值得反复调试。
第六步:评估模型
训练完成后,用测试集检验自编码器的真实性能。可以通过计算重构误差、直接查看重构图像等方式,直观判断模型对数据的编码与解码能力。如果重构误差偏大,则需要考虑调整模型结构或重新训练。
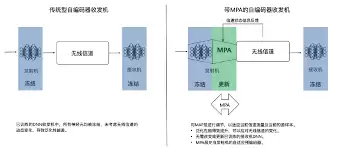
第七步:应用与拓展
一个训练好的自编码器可以应用于数据降维、特征提取、异常检测等实际场景。此外,还可以在此基础上继续拓展,例如与其他模型结合,进一步提升性能和应用范围。掌握以上步骤,就能搭建出一个有效的自编码器,为人工智能的各项任务提供有力支撑。