

Redis集群节点增删操作指南
RedisCluster集群扩展时,新增节点需启动实例后使用clustermeet加入集群,通过clusterreshard分配槽位并设置主从关系。删除节点时先移除从节点,迁移主节点槽位后再删除主节点,最后平衡各节点槽位分布。
1. 添加节点
目前Redis集群由三台服务器(11、12、13)构成,每台运行两个Redis实例(6379和6380),共计六个节点。现计划新增一台服务器10,同样部署两个实例,一主一备。假设新服务器上的Redis已配置完毕(配置过程可参考Redis Cluster搭建相关文档),下面直接进入集群扩展流程。
1.1. 启动新节点
登录新服务器10,分别启动6379和6380两个Redis服务:
[test@node-10 6379]$ /usr/local/redis/bin/redis-server redis.conf
[test@node-10 6380]$ /usr/local/redis/bin/redis-server redis.conf
确认进程是否正常启动:
[test@node-10 6379]$ ps -ef|grep redis
test     137409      1  0 15:18         00:00:00 /usr/local/redis/bin/redis-server 0.0.0.0:6380 [cluster]
test     137510      1  0 15:19         00:00:00 /usr/local/redis/bin/redis-server 0.0.0.0:6379 [cluster]
test     137524 130159  0 15:19 pts/0    00:00:00 grep --color=auto redis
登录6379查看集群节点信息,会发现目前该节点只有一个master(自己),另一个6380同理,尚未加入集群。
[test@node-10 bin]$ redis-cli -p 6379 -c -a test
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
127.0.0.1:6379> cluster nodes
36efcd23eecc5c4238711c4e680026fea1a71e6d :6379@16379 myself,master - 0 0 0 connected
接下来需要将这两个节点加入现有集群。
1.2. 添加主节点
任意连接集群中的一个已有节点,例如连接服务器11的6379,使用cluster meet命令将10上的两个节点加入集群:
[test@node-11 bin]$ redis-cli -p 6379 -c -a test
127.0.0.1:6379> cluster meet 192.168.50.10 6379
OK
127.0.0.1:6379> cluster meet 192.168.50.10 6380
OK
127.0.0.1:6379> cluster nodes
# 信息省略,可以看到两个新节点已加入集群
通过cluster nodes查看,10上的6379和6380都已成为master节点,但槽位数为0——它们目前只是空壳,没有负责的数据分片。
分配槽位
接下来使用cluster reshard为10上的6379分配槽位:
[test@node-10 bin]$ redis-cli --cluster reshard 192.168.50.10:6379 -a test
交互过程中需填写以下内容:
- 每个master的目标槽位数:4096(原本三个master,增加一个后变成四个,16384 ÷ 4 = 4096)。
- 接收槽位的节点ID:36efcd23eecc5c4238711c4e680026fea1a71e6d(即新节点)。
- 槽位来源:输入
all,表示从其他所有master节点均匀迁移槽位。
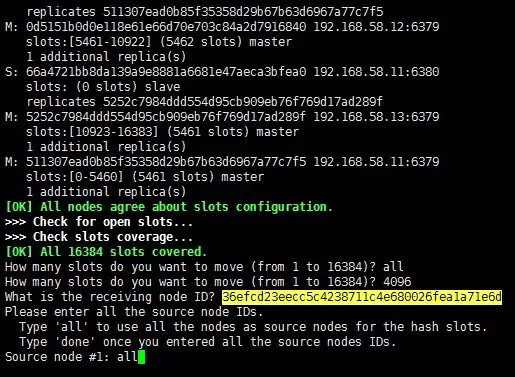
至此,新master节点(10上的6379)已成功加入集群并分配了槽位。而10上的6380目前仍是一个没有槽位的master节点,下一步将其设置为从节点。
1.3. 设置从节点
登录6380实例,执行cluster replicate命令,指定其主节点为刚才添加的6379(通过节点ID指定):
[test@node-10 bin]$ redis-cli -p 6380 -c -a test
127.0.0.1:6380> cluster replicate 36efcd23eecc5c4238711c4e680026fea1a71e6d
OK
127.0.0.1:6380> cluster nodes
# 输出中可以看到6380已标记为slave,并指向36efcd23...
完成后,新服务器10上的两个Redis实例(6379主、6380从)已成功加入现有集群。现在集群共有四台服务器、八个实例,四主四从。
2. 删除节点
当前集群由四台服务器(10、11、12、13)共八个实例构成。现在需要移除服务器13,即从集群中删除一主一从两个Redis服务。
2.1. 删除从节点
查看集群状态会发现,13上两个实例都是master,而11上两个实例都是slave。为避免数据丢失,需先将11上的某个slave提升为master,同时将13上的对应master降级为slave。巧的是,11上的一个slave的master正是13上的一个Redis服务。处理办法:直接杀掉13上的那个master进程,11上的对应slave会自动被选举为新的master,然后重新启动13上的该实例,它会自动以slave身份加入集群。
[test@node-13 bin]$ ps -ef|grep redis
test     148079      1  4 Jun04         2-03:22:25 ../bin/redis-server 0.0.0.0:6379 [cluster]
test     148555      1  3 Jun04         1-10:35:36 ../bin/redis-server 0.0.0.0:6380 [cluster]
[test@node-13 bin]$ kill -9 148555
[test@node-13 bin]$ ps -ef|grep redis
test     148079      1  4 Jun04         2-03:22:26 ../bin/redis-server 0.0.0.0:6379 [cluster]
[test@node-13 6380]$ ../bin/redis-server redis.conf
[test@node-13 6380]$ ps -ef|grep redis
test     148079      1  4 Jun04         2-03:22:29 ../bin/redis-server 0.0.0.0:6379 [cluster]
test     226582      1 95 16:47         00:00:35 ../bin/redis-server 0.0.0.0:6380 [cluster]
此时查看集群节点信息,确认13上的6380已变成slave:
127.0.0.1:6380> cluster nodes
ec6307189da48a8af1c0b168f7500a59f747289e 192.168.50.10:6380@16380 myself,slave 36efcd23eecc5c4238711c4e680026fea1a71e6d 0 1626770883000 8 connected
0d5151b0d0e118e61e66d70e703c84a2d7916840 192.168.50.12:6379@16379 master - 0 1626770882000 9 connected 6827-10922
# ... 其他节点信息略
0d8423b0f03adcd631ca40f9d0cda8ec55c7b1bd 192.168.50.13:6380@16380 slave 0d5151b0d0e118e61e66d70e703c84a2d7916840 0 1626770881000 9 connected
# ...
现在可以正式删除这个从节点。使用redis-cli --cluster del-node命令,指定要删除的节点ID:
[test@node-10 bin]$ redis-cli --cluster del-node 192.168.50.10:6379 0d8423b0f03adcd631ca40f9d0cda8ec55c7b1bd -a test
>>> Removing node 0d8423b0f03adcd631ca40f9d0cda8ec55c7b1bd from cluster 192.168.50.10:6379
>>> Sending CLUSTER FORGET messages to the cluster...
>>> Sending CLUSTER RESET SOFT to the deleted node.
2.2. 删除主节点
13上还剩下一个master(6379),它的从节点是11上的一个slave。现在需要把这个slave重新挂到11上另一个master下面(因为11上的master目前还没有从节点)。
登录11上的6380(slave),执行cluster replicate重新指定其主节点为11上的master:
[test@node-11 bin]$ redis-cli -p 6380 -c -a test
127.0.0.1:6380> cluster replicate 0d5151b0d0e118e61e66d70e703c84a2d7916840
OK
127.0.0.1:6380> cluster nodes
# 可以看到6380已变为0d5151b0... 的slave
接下来需要将13上剩余master(节点ID为5252c798...)拥有的槽位(12288-16383)迁移出来。同样使用cluster reshard将这些槽位分配给其他master,这里选择全部迁移到10上的master:
[test@node-10 bin]$ redis-cli --cluster reshard 192.168.50.10:6379 -a test
# 交互输入:迁移槽位数、接收节点ID、来源节点ID
迁移后查看集群节点,13的master上槽位已清空,10的master槽位增加:
127.0.0.1:6380> cluster nodes
# 略,可见13的master槽位为0,10的master槽位包含0-1364 5461-6826 10923-16383
最后直接删除这个已无槽位的主节点:
[test@node-13 bin]$ redis-cli --cluster del-node 127.0.0.1:6379 5252c7984ddd554d95cb909eb76f769d17ad289f -a test
>>> Removing node 5252c7984ddd554d95cb909eb76f769d17ad289f from cluster 127.0.0.1:6379
>>> Sending CLUSTER FORGET messages to the cluster...
>>> Sending CLUSTER RESET SOFT to the deleted node.
3. 最终结果
至此,已将13上的6379和6380从集群中移除,并成功加入10上的6379和6380。查看集群信息:
[test@node-11 bin]$ redis-cli --cluster info 192.168.58.11:6379 -a test
192.168.50.11:6379 (511307ea...) -> 206141 keys | 4096 slots | 1 slaves.
192.168.50.10:6379 (36efcd23...) -> 411127 keys | 8192 slots | 1 slaves.
192.168.50.12:6379 (0d5151b0...) -> 205536 keys | 4096 slots | 1 slaves.
[OK] 822804 keys in 3 masters.
50.22 keys per slot on average.
发现槽位分布不均:10上的master拥有8192个槽位,而另外两个只有4096个。需要重新平衡:
[test@node-10 bin]$ redis-cli --cluster reshard 192.168.50.10:6379 -a test
# 交互输入:迁移1365个槽位,接收节点为11的master ID,来源节点为10的master ID
# 再执行一次类似操作,迁移1365个槽位给12的master
平衡后结果:
[test@node-10 bin]$ redis-cli --cluster info 192.168.50.10:6379 -a test
192.168.50.10:6379 (36efcd23...) -> 261787 keys | 5462 slots | 1 slaves.
192.168.50.12:6379 (0d5151b0...) -> 261514 keys | 5461 slots | 1 slaves.
192.168.50.11:6379 (511307ea...) -> 262509 keys | 5461 slots | 1 slaves.
[OK] 785810 keys in 3 masters.
47.96 keys per slot on average.
分布已经很均匀了。其实回过头来看,这种“删除一个节点、新增一个节点”的需求,完全可以在新节点分配槽位时直接把要删除节点的槽位迁移过来,省去中间那些步骤。这次操作完之后才想明白……下次遇到类似场景,可以走更简洁的路线。
总结
以上操作完整展示了Redis Cluster节点的添加与删除流程,关键点在于:新节点加入集群后无槽位,需手动分配;删除主节点前必须先迁移其槽位,避免数据丢失;从节点可直接删除,主节点则需要先处理数据归属。实际操作中注意节点ID的正确引用,以及交互式命令的输入顺序。