

RAG应用测试策略设计方法
RAG应用测试需分层设计:检索层验证召回率与排序质量,生成层检测忠实性与上下文利用率,端到端评估全链路。两条失效路径(检索错误与生成幻觉)需分别定位。测试用例来自业务场景、用户日志和对抗构造,关键指标包括召回率、忠实性、拒答率等。分层对齐架构,持续维护用例与监控。
RAG(检索增强生成)的架构,说起来其实挺直白:用户提问,检索模块从知识库里翻找相关文档,然后把这些文档连同问题一起喂给大模型,最后大模型生成回答。看起来是不是很简单?
但这个结构里藏着两条完全独立的失效路径,这是很多人容易忽略的关键点。
先看第一条:检索环节出了问题。找到的文档要么不相关、要么残缺不全、要么排序一塌糊涂——这种情况下,LLM拿到手的材料本身就是错的,就算模型能力再强,也是巧妇难为无米之炊。
再看第二条:生成环节出了问题。检索结果明明没毛病,但LLM要么没好好用它,要么忽略了关键信息,要么干脆自己“发挥”了一通,在文档之外凭空添油加醋。
这两条路径彼此独立,失效模式也完全不同,但最终都会直接砸在输出质量上。问题在于,如果你把RAG当成一个黑盒去测,你看到的只是最终答案对不对。一旦答错了,你根本不知道问题出在检索还是生成。而这两者的修复方向,一个得调向量模型和索引策略,一个得改prompt和上下文处理逻辑,完全是两码事。
所以,RAG的测试策略,不能只看结果,必须分层设计。
一、测试分层:三层独立验证
RAG应用的测试,得拆成三层来做。每层有各自的目标、方法和评估指标,一层一层往下验证,而不是盯着最终输出就看完了。
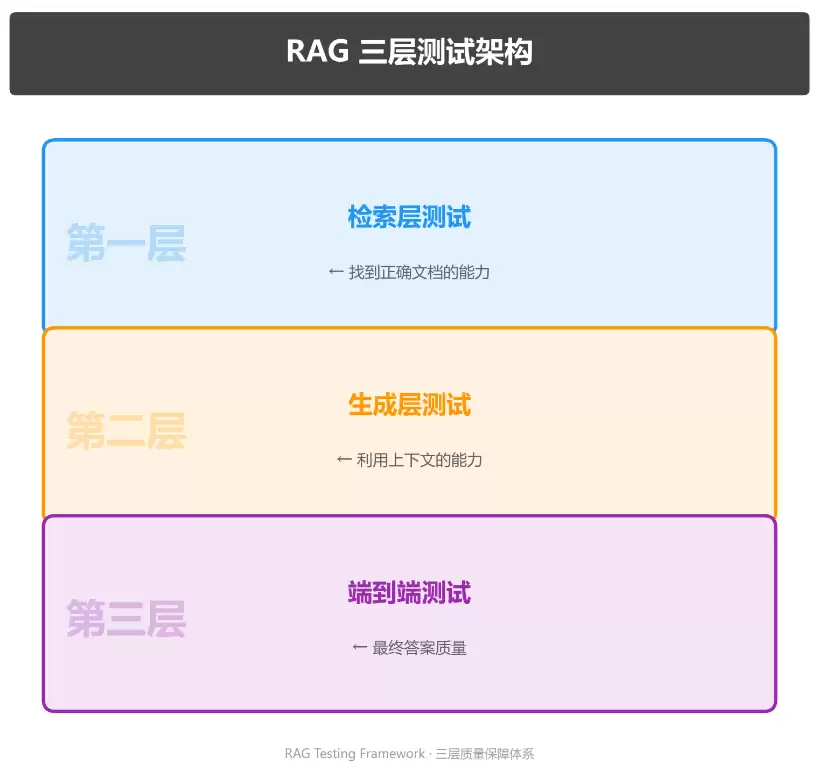
这三层是从下往上逐层验证的,下层是上层的基础。检索层要是塌了,生成层再厉害也没用;反过来,生成层要是自己短板,那检索层再准也是白费功夫。
二、第一层:检索层测试
检索层要解决的核心问题只有一个:当用户提出问题,系统能不能把正确、相关的文档找出来?
这一层的测试,跟LLM没有半点关系。它测的是向量检索、BM25、重排序模型这些检索组件本身的质量。
核心指标
召回率(Recall@K) 在返回的前K条结果里,包含了多少应该被找到的相关文档?这是最重要的指标。召回率低了,意味着LLM根本拿不到回答问题所需的材料,后面的一切都是白搭。
计算方式也很直接:相关文档被检索到的数量 / 应该被检索到的相关文档总数。
精确率(Precision@K) 在返回的前K条结果里,有多少是真正相关的?精确率低了,意味着LLM拿到了一堆噪声,上下文被无关内容稀释,效果自然好不了。
平均排名倒数(MRR) 第一条相关文档排在第几位?排名越靠前,LLM越容易利用它。这个指标衡量的是检索结果的排序质量。
上下文相关性(Context Relevance) 检索出来的文档片段,和用户的提问到底有多相关?不只是“找到了”,还得“找对了”。
测试用例设计
构建“问题-文档”标注集
这是检索层测试的核心工作,也是成本最高的部分。你需要为每个测试问题,标注出知识库里哪些文档(或文档片段)是回答这个问题所必需的。
标注集至少要覆盖四类场景:
- 直接匹配:问题中的关键词直接出现在文档里。这是最简单的情况,检索系统必须能搞定。
- 语义匹配:问题和文档的表达不同,但语义一致。比如问“如何取消订单”,文档里写的是“订单撤销流程”。这正是向量检索要解决的核心问题。
- 多跳检索:回答问题需要综合多个文档的信息。比如“A产品和B产品在价格上的差异”,可能需要同时检索到两个产品的文档。
- 无答案场景:知识库里根本没有相关文档。系统应该检索不到有效内容,而不是检索到一堆不相关的东西然后让LLM硬答。
Chunk策略的边界测试
RAG系统里,文档通常会被切成片段(chunk)再建索引。切分策略直接决定了检索质量。需要专门测试:
- 答案恰好横跨两个chunk的边界时,系统能不能同时检索到两个相关片段?
- Chunk太小时,单个片段缺乏上下文,LLM能否正确理解?
- Chunk太大时,相关内容被稀释在大段无关文本里,检索排序还准确吗?
一个常见陷阱
很多团队在做检索层测试时,只测“能不能找到”,不测“找到的排序对不对”。但对LLM来说,第一条结果和第五条结果的权重完全不同——排在前面的内容,LLM更容易采纳。召回率高但排序混乱,同样会导致最终答案质量忽高忽低。MRR这类排序相关的指标,不能省。
三、第二层:生成层测试
假设检索层已经正常工作了,文档准确找到。接下来要测的是:LLM能不能正确利用这些文档来生成答案?
这一层的测试,需要把检索结果固定下来——用标准的、已知质量的文档作为输入,专门测LLM的上下文理解和生成能力。
核心指标
忠实性(Faithfulness) LLM的回答,有没有超出提供的上下文?回答里的每一个声明,是否都能在检索到的文档里找到依据?
这是RAG生成层最重要的指标。RAG的核心价值就是“有据可查”——如果LLM开始在文档之外自行发挥,RAG就失去了它最根本的意义。
答案相关性(Answer Relevance) 生成的回答,有没有真正回答用户的问题?有时候LLM会生成一段看起来和文档高度相关的文字,但其实并没有直接回应用户的具体问题——内容没毛病,但答非所问。
上下文利用率(Context Utilization) 检索到了5段文档,LLM实际用到了几段?如果关键信息在第3段,但LLM只关注了第1段,后面的信息被忽略,说明模型对长上下文的处理存在短板。
专项测试场景
文档冲突测试
给LLM提供两段内容互相矛盾的文档,观察它的行为。好的处理方式是明确指出文档之间存在矛盾,给出两种说法,说明无法确定哪个正确。需要警惕的问题则是:直接采信其中一方,完全忽视另一方,甚至把两段矛盾信息“融合”成一个错误的新结论。这类测试在知识库内容来自多个来源(不同时间的文档、不同部门的规定)时尤为重要。
无关文档注入测试
在正确的检索结果里混入几段完全不相关的文档,观察LLM的抗干扰能力。好的处理方式是正确识别并忽略无关文档,基于相关文档给出准确回答。需要关注的问题是:被无关文档“带跑”,在回答里引入了不相关的信息,甚至把无关文档的内容误当作答案。
知识边界测试
给LLM提供的文档里完全没有回答问题所需的信息,观察它是否会老老实实说“根据提供的文档,无法回答这个问题”,还是会用自身参数知识来“补全”答案。这是RAG系统里最常见的幻觉来源之一:检索没找到相关文档,但LLM不说不知道,而是凭空生成一个看起来合理的答案。
位置偏见测试
把同一段关键文档放在上下文的不同位置(第一段、中间、最后一段),观察LLM的回答质量是否因位置不同而变化。研究表明,很多LLM对位于上下文开头和结尾的内容注意力更高,中间部分容易被忽略。这个问题在上下文较长时尤为明显。如果你的RAG系统检索出10段文档,而关键信息在第6段,这个测试能告诉你系统是否存在系统性的漏读风险。
四、第三层:端到端测试
前两层分别验证了检索和生成的质量。第三层测的是完整链路在真实场景下的整体表现。
端到端测试不需要标注“哪些文档是正确答案”,它直接评估用户问题的最终回答质量。但它要配合前两层的测试结果一起看——端到端出了问题,要能快速定位是检索问题还是生成问题。
核心测试场景
多轮对话测试 RAG系统在多轮对话中面临一个特殊挑战:用户的追问往往包含指代(“它”、“这个产品”、“上面提到的方案”),系统需要结合对话历史来理解当前问题的真实意图,再去检索。测试重点包括:指代消解是否正确;多轮对话中检索质量是否稳定;前几轮的错误信息是否会污染后续回答。
知识库边界问题 用户问了一个知识库里完全没有覆盖的问题。端到端测试要验证系统能否清晰地告知用户“这个问题超出了我的知识范围”,而不是给出一个听起来合理但实际编造的回答。
时效性测试 如果知识库里同时存在过期的和最新的文档,系统应该优先采信哪个?测试系统对文档时效性的处理策略是否符合预期。
跨文档综合推理 回答问题需要综合多个文档的信息,而不是从单个文档里直接抽取。这类问题考验的是系统在检索和生成两层的协同能力。
端到端的评估方式
端到端测试的评估,无法完全依赖自动化——因为“答案质量”本身带有主观性。建议采用三层评估:
- 自动化初筛:用LLM-as-Judge对答案的准确性、完整性、忠实性做初步打分,快速筛出明显的问题输出。
- 抽样人工审核:对自动化评分在中间区间(既不明显好也不明显差)的输出,进行人工审核,校准自动评分的可靠性。
- 用户反馈闭环:在生产环境里收集用户的显式反馈(点赞/点踩)和隐式信号(是否追问、是否重新提问),把这些信号定期反哺到测试用例库里,让用例库持续贴近真实场景。
五、评估指标汇总
把三层测试的核心指标整理在一起,便于建立监控体系:
| 层级 | 指标 | 含义 | 关注方向 |
|---|---|---|---|
| 检索层 | Recall@K | 相关文档被找到的比例 | 覆盖完整性 |
| 检索层 | Precision@K | 检索结果中相关文档的比例 | 噪声控制 |
| 检索层 | MRR | 第一条相关文档的平均排名 | 排序质量 |
| 检索层 | Context Relevance | 检索内容与问题的相关程度 | 内容匹配 |
| 生成层 | Faithfulness | 回答是否忠实于检索内容 | 幻觉控制 |
| 生成层 | Answer Relevance | 回答是否真正回答了问题 | 答非所问 |
| 生成层 | Context Utilization | 关键文档被实际利用的程度 | 遗漏风险 |
| 端到端 | 端到端准确率 | 最终答案的整体正确性 | 全链路质量 |
| 端到端 | 拒答率 | 无法回答时的正确拒绝比例 | 边界处理 |
每个指标都要追踪版本间的趋势变化,而不只是看单次绝对值。某个指标从上个版本到这个版本下降了,比这个版本的绝对值是多少,更值得立刻关注。
六、测试用例从哪里来
再好的测试框架,也需要高质量的测试用例来驱动。RAG测试的用例来源,主要看三个方向。
来源1:业务场景梳理 把你的RAG应用实际会被用来做什么,系统性地梳理出来。每个核心使用场景,至少要有10-20条覆盖不同难度的测试用例。这是用例库的基础。
来源2:真实用户日志 线上运行一段时间后,从用户的真实提问里抽样,转化成测试用例。用户的真实提问往往比工程师自己设计的用例更贴近实际,能覆盖到很多“没想到的场景”。尤其要重点关注:用户追问了多次的问题(说明第一次没答好),用户给了差评的回答,以及用户重新换了措辞再问的问题(说明原始问题没被理解)。
来源3:对抗性构造 主动设计“难题”:知识库里有多个相似但不同的条目时,故意提容易混淆的问题;把问题措辞设计成和文档表达差异很大的形式;构造需要跨3个以上文档才能回答的综合性问题。这类用例能找到系统的能力边界。
结尾:测试策略的本质,是跟系统架构对齐
RAG应用的测试策略,说到底就一件事:让测试结构和系统架构保持一致。
系统是两层串联的,测试就必须是分层的。检索层的问题和生成层的问题,表现出来的症状可能完全一样——最终答案不对——但根因完全不同,修复方向也完全不同。用黑盒测试看结果,你只能发现问题;用分层测试看过程,你才能定位问题。
这不是一次性的工作。知识库在更新,模型在迭代,业务场景在扩展——测试用例库需要跟着演进,检索层和生成层的指标需要持续监控,每次版本变更后,三层测试都需要重新跑一遍。
RAG测试的成本,大部分不在于搭框架,而在于持续维护这套体系,让它始终能反映系统的真实质量。这是个长期投入,但也是RAG应用能放心上生产的底线。