

LLM输出交互界面方法
通过Markdown+Spec协议,LLM输出扁平JSON组件规格,经流式提取与渲染生成可交互界面。组件库vtu-cmpts支持状态驱动与事件回传,无需前端编码即可实现从文本到界面的高效转换,显著提升信息获取效率并简化开发流程。
从文本到界面:Generative UI如何重塑LLM输出体验
先来想象一个常见的对话场景——用户问LLM“2026年有哪些值得关注的北欧风室内设计”,模型开始输出一大段文字:明厅设计采用落地窗搭配浅色木地板,采光充足;厨房以白色橱柜和原木台面为主,强调功能性……用户逐行阅读,在脑海中拼凑画面。
不过,面对大段文字靠脑补拼凑画面,确实挺费力气的。同样的内容,其实可以有另一种呈现方式:
纯文本输出的信息密度很高,但前提是读者得掌握提炼重点的技巧,才能流畅阅读。更何况,它本身就有固有局限——缺乏层次、没有视觉锚点、也无法交互。
上图展示的是Generative UI(GenUI)在纯文本输出中的融入效果。LLM的输出不再是一段需要自行消化的文字,而是一个可以直接浏览、点击、交互的界面。人从返回内容中获取信息的效率,存在量级差异。
但纯HTML也不行。尽管LLM对HTML非常精通,在聊天模式下,工程上很难对产物进行约束。
一个重要的判断是:之后很长一段时间,人机交互的形式都不会是HTML甚至实时渲染,而是存在于两者之间的一种中间态——既保留Markdown的简洁和LLM的熟悉度,又能承载结构化组件的交互能力。
有人可能会想到MDX。这确实是一种选型,但在我们这个场景里,最终选择了输出和解析都更简单的Markdown + Spec模式:用Markdown组织文本和推理过程,用代码块承载结构化的组件规格(Specification)。
Spec比HTML语义更单一、结构更扁平,LLM输出更稳定,前端解析也更简单。作为协议层,它恰好处于“足够表达组件语义”和“足够简单可控”之间的中间状态。
下面就以vtu-cmpts的ImageGallery(画廊)组件为例,按数据流顺序,走完从LLM输出到可交互界面的完整旅程。
从流到组件:ImageGallery的完整数据流与交互实现
整个数据流分为五层:
LLM Stream → chunk-processor → Spec 提取 → VtuRenderer → 用户交互 → 新一轮对话
组件库架构:状态驱动的自包含单元设计
结构化的输出需要一套预定义的组件库。组件库用什么框架写其实不重要,关键是组件必须是状态驱动的自包含单元——每个组件通过Props接收数据,通过事件对外通信,不依赖外部的context或状态树。
Headless模式组件库比较适合这个场景,但因为使用Vue技术栈,扫了一圈市面上没有合适的库,所以基于assistant-ui抄了一份Vue组件。
在Vue项目中,使用经典的桶模式组织组件:
index.ts   // 组件入口,连接组件与工程
index.vue  // 组件界面骨架,整合依赖与内部逻辑
meta.jsonc // 组件定义,兼顾人类阅读与机器理解
states/*.ts // 组件状态及状态驱动的方法
config/*.ts // 组件所需的数据或配置
桶模式的好处在于结构扁平,LLM能一步到位理解组件全貌,不需要先读入口文件,再追踪import链去翻其他模块。
index.ts或目录下如果有spec.ts,即组件的spec定义。以ImageGallery为例,它的Props定义如下:
export const ImageGalleryItemSchema = z.object({
  id: z.string().min(1),
  src: z.url(),
  // ...
});
export type ImageGalleryItem = z.infer;/* ... */export interface ImageGalleryProps {
  id: string;
  images: ImageGalleryItem[];
  onImageClick?: (imageId: string, image: ImageGalleryItem) => void;
  // ...
}
可以看到,这个组件使用Zod作为唯一的Spec来源。type ImageGalleryItem = z.infer从Zod Schema派生出TypeScript类型——一份定义,同时服务于编译时类型检查和运行时校验,是一个极好的胶水层。
关于这个组件库,它叫vtu-cmpts,有表格、画廊、图表等展示类组件,也有表单、审核卡片等交互组件,加起来共计二十余种,基本覆盖了目前的使用场景。
| 类别 | 组件 |
|---|---|
| 数据展示 | Article、DataTable、Chart、StatsDisplay、WeatherWidget |
| 代码 | CodeBlock、CodeDiff、Terminal |
| 社交/内容 | ContactCard、Citation、XPost |
| 表单/输入 | ApprovalCard、OptionList、ParameterSlider、PreferencesPanel |
| 流程 | QuestionFlow、Plan、ProgressTracker、OrderSummary、GeoMap |
Spec协议:LLM与前端之间的中间协议层
LLM不会直接输出组件代码,而是输出一种中间协议——Spec。在实践中,Spec以Markdown代码块的形式嵌入对话:
2026年的销售数据和转化率如下:
```json
{
  "root": "main",
  "elements": {
    "main": { "type": "Stack", "props": { "direction": "row" }, "children": ["card-1", "card-2"] },
    "card-1": { "type": "StatCard", "props": { "title": "总销售额", "value": "120万" } },
    "card-2": { "type": "StatCard", "props": { "title": "转化率", "value": "3.2%" } }
  }
}
```
Spec采用Vercel json-render的Flat Map协议。组件在elements对象中以扁平列表形式输出,而非嵌套结构。扁平Spec有两个天然优势:结构简单,不会给LLM增加嵌套复杂度;数据易于增量更新,适合做流式渲染。
chunk-processor:流式碎片提取与修复机制
数据流从Markdown开始处理。Markdown解析器方面选择了开源组件markstream-vue,因为它提供了自定义标签与高级组件功能,同时还有高性能的节点缓存,能直接接管从MD到混合输出的渲染。
chunk-processor就是SSE streaming到交给markstream-vue中间的数据处理层,负责把JSON Spec提取出来交给渲染引擎。具体来说:
- 检测——扫描流式文本,找到
```jsonspec代码块 - 提取——用
jsonrepair修复不完整的JSON(缺少闭合括号、字符串没写完) - 验证——检查是否符合vtu-cmpts Spec,即
{ "root": ..., "elements": ... }结构 - 转换成文本模板如
LLM吐到一半的内容可能是这样的:
{"root":"root","elements":{"root":{"type":"Col括号未闭合,字符串未结束,直接JSON.parse会报错。chunk-processor在流式上下文中持续修复这些碎片,让下游渲染器始终能拿到合法的JSON。
除了提取以外,chunk-processor还通过中间件形式提供对spec的增强,比如下一小节提到的spec流式渲染能力。
流式渲染:从骨架到完整界面的渐进式呈现
如果等JSON全部生成完再渲染,用户会面对几秒钟的空白,然后界面突然弹出。流式渲染要解决的是:如何在数据尚未完整时,就给出有意义的界面反馈。
目前一个稳定的方案是在提示词中引导LLM按固定顺序生成Spec属性,比如先输出type、id、title等元信息,再输出数据密集型字段。这样即使images数组尚未到达,渲染器已经能画出组件骨架:
{
  "root": "main",
  "elements": {
    "main": {
      "type": "ImageGallery",
      "title": "2026北欧自然风景精选",
    },
  }
}
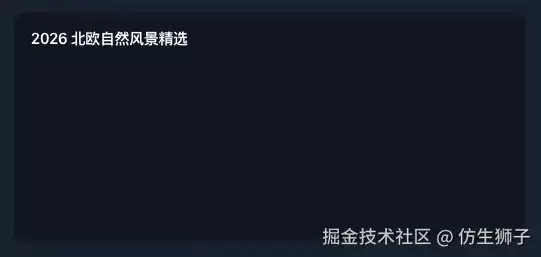
此时ImageGallery以空状态或loading状态呈现,用户知道内容正在生成。随着流继续,当第一个完整的ImageItem到达时,触发节点激活,图片开始逐张渲染:
{
  "root": "main",
  "elements": {
    "main": {
      "type": "ImageGallery",
      "title": "2026北欧自然风景精选",
      "images": [
        {
          "id": "img-1",
          "src": "https://picsum.photos/seed/nordic1/800/600",
          "title": "明厅设计",
          "caption": "落地窗 + 浅色木地板"
        },
      ]
    },
  }
}
所以第一个要介绍的chunk-processor增强插件就是data-trigger,它支持给不同组件设置不同的数据触发节点。
举个例子,Chart允许按Series的数据项触发渲染;文档(Markdown inside markdown)允许按行刷新等等。手动实现触发节点可以达到极为精确的控制效果。
当然,回退到简单策略也可行——比如每固定间隔100ms对当前Spec做一次补全,并触发组件重渲染。
最终,流结束后,ImageGallery的images数组完整,界面从骨架蜕变为可交互的完整画廊。
用户交互:从单向输出到闭环问答
Generative UI如果只能看不能点,那只是花哨的Markdown。
传统界面通过事件绑定执行特定函数,但GenUI的理想情况是事件不交给LLM去配置——LLM不理解整个交互上下文。我们把交互按复杂度分层:纯文本、可播放媒体、按钮等单点交互、表单等有状态容器、弹窗、长时任务。在展示类场景中,交互复杂度控制在表单及以下层级。
单点交互的处理很直接:给LLM提供上下文即可。比如用户点击ImageGallery的某张图片,系统捕获到「用户点击了图片:明厅设计」,将其拼接到下一次对话的上下文中,LLM基于这个信息生成新的回复。
点击DataTable表格行的“详情”按钮或OptionList的多选同理,见以下图片:
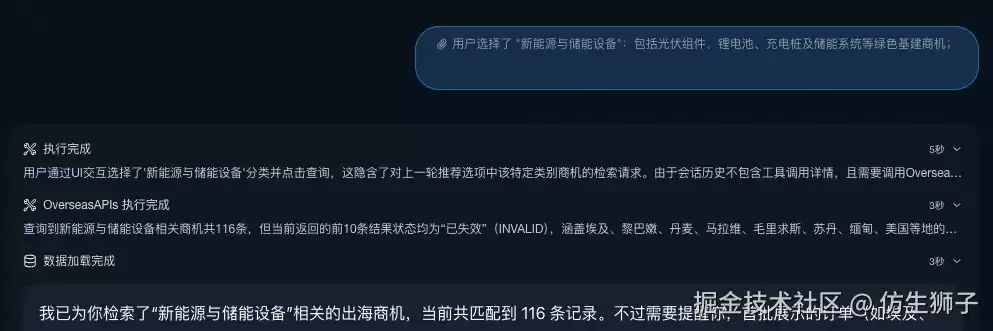
表单类组件带状态,稍微复杂一些,需要渲染器具备注入能力。
注入可以是状态(Vue的响应式值,可与localStorage绑定),也可以是事件。VTU组件暴露特定事件,所以能注入特定处理函数,也可以通过DOM监听统一捕获组件内部的点击、切换等交互。
只要事件能被捕获,操作空间就大了。我们可以决定拼接什么上下文、是否立即发送进入下一轮对话、还是等用户补充更多信息。如果输出包含多个Spec,多个组件的交互上下文可以同时被收集——比如用户勾选了DataTable的几行,再从OptionList中选了"查看价格",最终的上下文会携带表格行选择信息和按钮点击信息。
这些被捕获并拼接成带上下文的数据,被添加到下一次用户提问。LLM根据这个上下文继续生成新的回复,问答场景形成闭环。
容错设计:组件层、渲染层、交互层的异常恢复机制
最后简单提一下容错。LLM输出不稳定是常态,即使Prompt写得再详细,输出也会碰到不合格的状态——缺字段、类型错误、甚至混入自然语言。
组件层、渲染层、交互层都需要相应的容错和恢复机制。组件层通过Zod Schema做运行时校验,不合法的Spec被拦截在渲染之前。渲染层对不完整的JSON做降级或增强溃。交互层则确保事件捕获和上下文拼接的鲁棒性,不会因为某个组件的异常而影响整个对话流程。
未尽之路:GenUI落地的挑战与未来方向
这篇文章涵盖了GenUI落地的六个核心问题:组件库设计、协议设计、流式碎片提取、中间态渲染、交互回传、异常容错。
每一个环节都还有深入的空间,但将它们串联起来,已经能勾勒出一幅从LLM文本流到可交互界面的全景图。
时间成本也非常低,整个Demo从Agent到组件库和前端,只花费约40人日——放在以前纯手作时代,不敢想象要抄多少代码才能把代码串起来。
不过实践中,也遇到了一些没有解决思路的问题。
一是聊天页的虚拟滚动。每条消息都包含工具调用、思考过程和最终回答等不同聊天块。这些块高度差异极大,精确计算高度比较困难。但开不开虚拟滚动,却会直接影响长对话的性能表现。怎么处理长对话是个问题。
二是自定义组件的可能性。结论可行,但需要一个足够强壮的Renderer和规范层。如果做过低码,应该能理解这里的挑战。
站在更宏观的视角看,LLM的输出形态从文本到界面演进是必然进程。当AI的回答不再是一段需要自行提炼的文字,而是一个可以直接操作的界面时,人与AI的协作模式会发生根本变化。以后有机会会继续分享相关内容。