

MiniMax M3 1M上下文 SWE-Bench 59% 三项前沿能力一次集齐
MiniMax发布旗舰语言模型M3,具备1M上下文窗口(每token计算量仅为上代二十分之一)、SWE-BenchPro59.0%超越GPT-5.5和Gemini3.1Pro、原生多模态从预训练开始混合训练等前沿能力。MSA稀疏注意力架构实现Prefilling加速超9倍,Decoding加速超15倍,且能力与全注意力打平。
2026年6月1日,MiniMax发布了新一代旗舰语言模型M3。翻看官方博客与技术报告,一组数据引人注目:SWE-Bench Pro评测达59.0%,超过GPT-5.5与Gemini 3.1 Pro;在1M tokens上下文窗口下,每token计算量仅为上代模型的二十分之一;原生多模态从预训练Day 1开始混合训练。这三个方向单独看均有模型表现优异,但将Coding与Agentic能力、超长上下文、原生多模态整合至一个模型,且各项能力均达前沿水平——此前仅极少数闭源模型实现。M3能否支撑此定位?以下逐项解析。
1. MSA架构:让1M上下文成为可用资源
问题根源
标准Transformer的全注意力机制存在先天缺陷:计算量随上下文长度平方级增长。100K tokens尚可承受,至1M tokens时计算开销急剧膨胀。业界方案多围绕稀疏注意力展开——仅对关键token进行注意力计算。但关键在于如何筛选、筛选的准确性以及计算效率。
MSA的两阶段设计
MiniMax给出的答案是MSA(MiniMax Sparse Attention),一种两阶段稀疏注意力架构:
第一阶段:Index Attention。利用轻量索引query对KV缓存进行Block Max Pooling,从大量KV块中选出Top-k高相关性块。该步计算成本极低,因索引query数量远少于实际query数量。
第二阶段:Sparse Attention。仅对选出的Top-k块执行完整稀疏注意力计算。相比全注意力方案,计算量大幅缩减。与DSA(Dynamic Sparse Attention)和MoBA(Mixture of Block Attention)等方案相比,MSA的关键优势在于KV分块策略更精细——相同初筛思路下,能更精确切分KV块,有效上下文覆盖更高。
算子层优化:KV Outer Gather
架构设计仅为第一步,底层算子才是性能瓶颈。MSA采用KV Outer Gather Q方式:以KV块为外层循环,聚合命中该块的query并批量计算。优势在于:每块KV数据仅读取一次,访存连续;在M3的head配比下,计算访存比明显优于通行方法;比开源的Flash-Sparse-Attention、Flash-MoBA快4倍以上。
实际性能收益
官方公布的对比数据亮眼:
| 指标 | 数据 |
|---|---|
| 1M上下文每token计算量 | 仅为上代模型的1/20 |
| Prefilling阶段加速 | 超过9倍 |
| Decoding阶段加速 | 超过15倍 |
官方强调,多组对照实验中MSA绝大部分能力与全注意力打平,稀疏化未带来明显性能损失——注意力方案优劣最终需验证模型能力是否下降。
Agent场景为何需要长上下文
若仅用于聊天问答,4K或8K上下文窗口已足够。但Agent场景截然不同:Agent任务可能涉及读取数十个源代码文件、执行多条命令并分析输出、维护持续增长的操作日志、在多轮工具调用间保持状态一致性。以M3完成的CUDA优化任务为例,1959次工具调用要求每次调用保留先前执行历史、分析结果与决策依据。缺乏足够长上下文窗口,Agent如同每数分钟失忆一次的程序员。因此M3的1M上下文窗口并非简单参数堆叠,而是与Agent能力深度绑定的基础设施。MSA将1M上下文的计算成本压缩至可控范围,Agent方可长期运行于长线程任务。
2. Coding与Agent能力:评测数据展示
M3在多个国际权威评测基准上的成绩如下:
| 评测基准 | M3成绩 | 备注 |
|---|---|---|
| SWE-Bench Pro | 59.0% | 超过GPT-5.5、Gemini 3.1 Pro,接近Opus 4.7 |
| Terminal Bench 2.1 | 66.0% | 终端命令执行能力 |
| BrowseComp | 83.5 | 超越Opus 4.7(79.3) |
| MCP Atlas | 74.2% | MCP工具调用能力 |
| SVG-Bench | 超过Opus 4.7 | SVG矢量图生成 |
| Claw-Eval | 排名靠前 | 自主Agent端到端评测 |
| OmniDocBench | 超过Gemini 3.1 Pro | 多模态文档理解 |
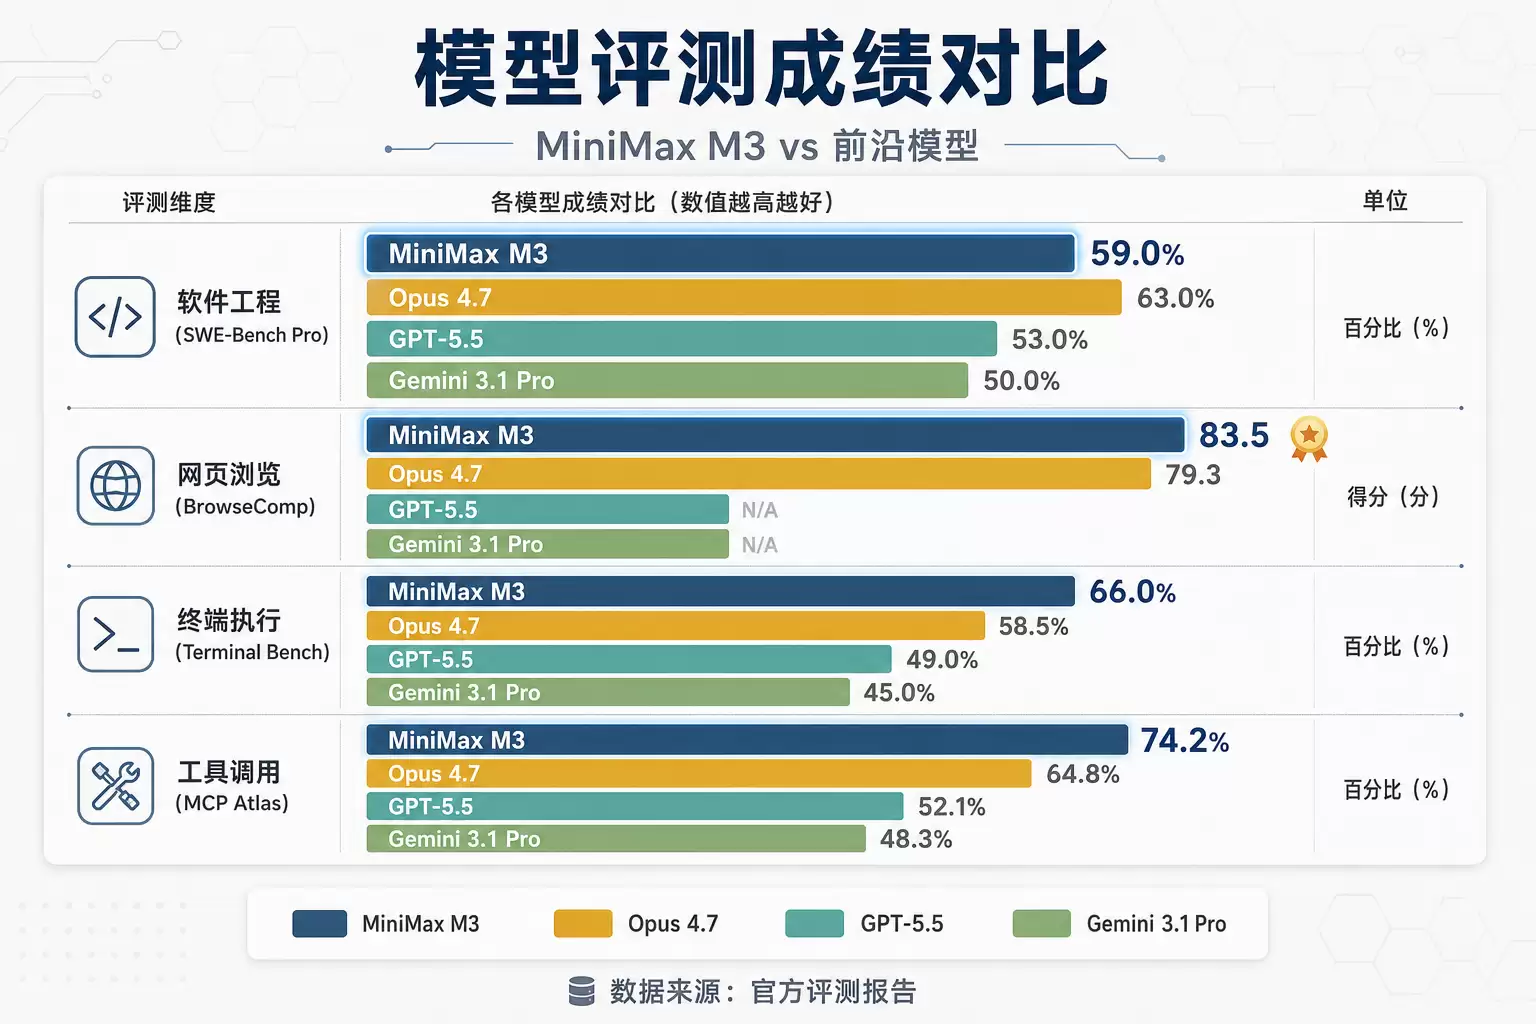 评测成绩对比图表
图2:MiniMax M3与前沿模型评测成绩对比
值得关注的数据:BrowseComp 83.5对比Opus 4.7的79.3,体现模型在真实网页环境中的信息检索与综合能力。Claw-Eval排名靠前,表明M3在多步规划、工具调用、错误恢复等Agent核心能力上表现扎实。SWE-Bench Pro 59.0%通过率,使M3在真实GitHub issue修复场景中具备实际应用能力。你在项目中用过类似Agent方案吗?欢迎在评论区分享体验。
3. 三个实战任务:超越评测分数
基准测试代表理论水平,实际任务表现更具说服力。官方提供了三个具体案例,信息量远超评测分数。
论文独立复现:12小时跑通核心实验
任务:独立复现ICLR 2025 Outstanding Paper Award获奖论文《Learning Dynamics of LLM Finetuning》。过程:M3自主运行近12小时,产出18次commit与23张实验图表。结果:跑通核心实验,验证SFT阶段预测概率变化趋势、DPO的squeezing效应、Extend缓解方法。此任务难点在于三项能力同时在线:多模态理解论文图表与公式,长上下文容纳全文加代码加运行日志,编程与Agent能力驱动12小时长线程执行。缺少任何一项皆无法完成。具体拆解:先解读论文数学推导与实验设计(多模态理解),将方法转化为可运行代码(编程能力),运行实验对比结果(Agent与长上下文),结果不符则分析原因修正(持续推理)。全程M3自主完成,23张实验图表验证复现正确性——其行为更像研究助理而非单纯代码生成器。
CUDA算子优化:从7.6%到71.3%
此案例是三个任务中说服力最强之一。任务:在NVIDIA Hopper架构上优化FP8 GEMM kernel。起点仅有一份任务描述、一个benchmark脚本、一个无法运行的Triton骨架代码,无参考实现或现成答案。过程:约24小时,147次benchmark提交,1959次工具调用,经历6轮标志性优化迭代。结果:硬件峰值利用率从7.6%提升至71.3%,实现9.4倍加速。
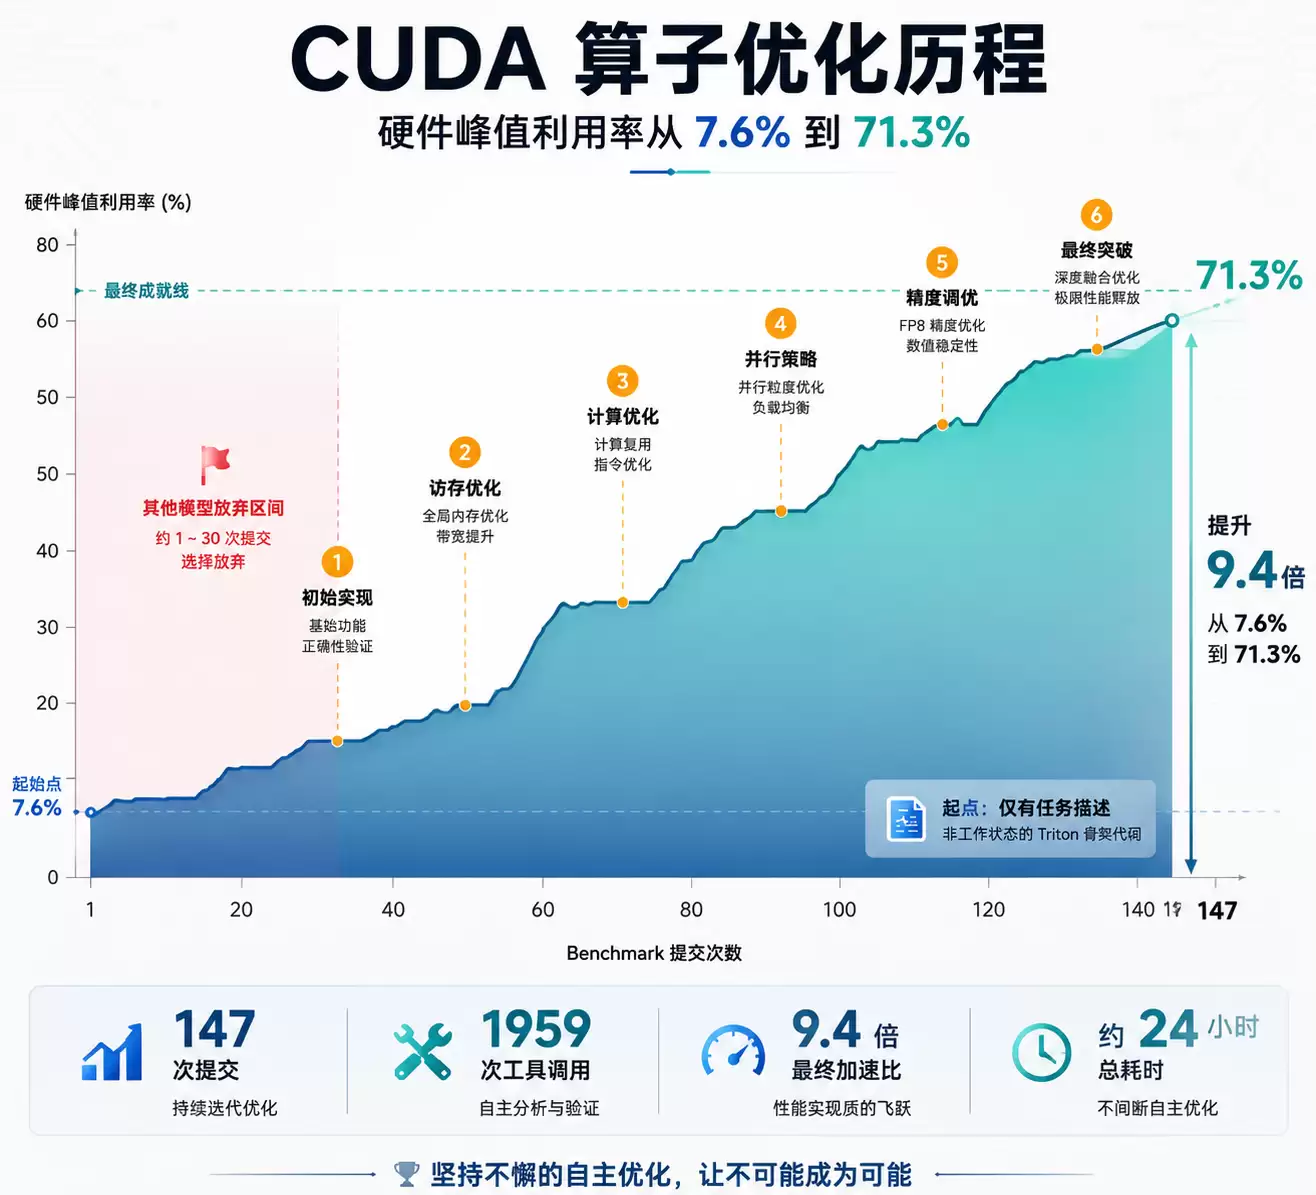 CUDA优化过程可视化
图3:CUDA算子优化历程——硬件峰值利用率从7.6%升至71.3%
细节值得注意:最佳结果出现在第145次提交,而其他参评模型大多在前30次内停滞。M3不仅代码能力强,更关键的是具备持续迭代耐力——在Agent场景中,此特质比单次推理能力更重要。
PostTrainBench:让M3自主训练模型
任务:向M3提供四个Base模型,要求其在12小时内自主完成数据合成→训练→评测→迭代全流程。该任务考验的不是编程能力,而是判断力:自主决定合成数据内容、选择训练策略、依据评测结果调整方案。本质上是让模型扮演AI研究员。得分:0.37,排第三,仅次于Opus 4.7(0.42)与GPT-5.5(0.39)。在AI训AI的闭环任务中,此成绩表现不俗。
4. 原生多模态:从Day 1起步
为何原生训练重要
多数多模态模型的做法是:先训练纯文本模型,再嫁接视觉编码器。该方法效率高、实现简单,但文本与视觉的语义空间天然存在缝隙。M3不走此路——从预训练的Day 1(官方原文为Step 0)便开始多模态混合训练,使文本与视觉语义空间从一开始便对齐。代价是训练流程更复杂,需重构整个数据管线,预训练数据规模扩充至百T量级。但回报也很明确:在图表、公式、曲线图等跨模态推理任务中表现更自然。
Interleaved Data的关键作用
MiniMax通过大量实验发现,Interleaved Data(交错数据)对模型性能的提升远超预期。所谓Interleaved Data,指文本与图像在序列中交替自然排列的数据——例如包含图片说明的文档,而非文本块与图片块分开堆叠。其逻辑在于:模型不仅需看图识字,还需理解图文交替逻辑关系。论文理解、文档分析、网页浏览均依赖此能力。从数据工程角度看,Interleaved Data的准备成本比普通图文对高得多:原始文档(论文、网页、教程)需保持自然格式,文本与图像交替排列,不能粗暴拆分。MiniMax为适配此训练方式重构了整个数据管线,预训练数据规模拉至百T量级。这一投入不小,但从论文复现任务中M3对图表和公式的理解能力来看,回报明显。
多模态应用场景
根据官方披露信息,M3的多模态能力覆盖以下场景:
- 论文中的图表、公式、曲线图理解(论文复现任务已验证)
- 视频输入理解
- Computer Use——直接操作电脑桌面完成跨应用操作
5. 交互式用户模拟器:下一代Agent训练范式
本节虽非M3模型本身功能,但展示了MiniMax对Agent能力演进的思考。
问题定义
当前多数代码Agent的训练建立在单轮任务假设上:用户给需求,Agent完成,结束。但真实开发并非如此——用户会在同一session中持续协作:补充需求、讨论方案、反馈修正、切换任务、迭代项目。
框架设计
MiniMax提出交互式用户模拟器框架,模拟真实开发者的协作行为模式。该框架覆盖几种典型协作行为:需求补充、方案讨论、反馈修正、连续任务切换、复杂项目迭代。这使得Agent不再被动执行指令,而是主动与用户协同完成任务。此方向背后的判断是:下一代Coding能力的比拼,不仅限于代码生成的准确率,更包括长期协作能力、规划能力以及人与Agent的协同效率。坦白讲,此方向比单纯刷SWE-Bench分数困难得多,但从Agent落地角度看,这正是当前关键瓶颈——真实开发不是跑benchmark。
6. 接入方式与定价
API接入
API地址:https://api.minimaxi.com/v1/text/chatcompletion_v2
模型名:MiniMax-M3
兼容OpenAI API格式,支持自动Cache。
两种思考模式
M3提供Thinking与Non-thinking两种模式,共享同一套定价:
- Thinking模式:适合复杂推理、Agentic任务与长程协作,模型会输出中间推理过程。
- Non-thinking模式:响应更快,适合对话、代码补全等延迟敏感场景。
两种模式可在请求时按需切换,无需更换模型。此设计实用——同一端点覆盖了“想清楚再回答”与“快速响应”两种需求。
服务等级
- 默认通道:适合常规请求
- 优先通道(service_tier=priority):高并发场景下获得调度优先级与更稳定响应时延
Token Plan定价
| 档位 | 月费 | Token量 | 对标参考 |
|---|---|---|---|
| Plus | 49/月 | 6亿 | 约Claude Pro的5倍 |
| Max | 119/月 | 18亿 | 约Claude Max的2倍 |
| Ultra | 469/月 | 55亿 | 约Claude Max 20x的3倍 |
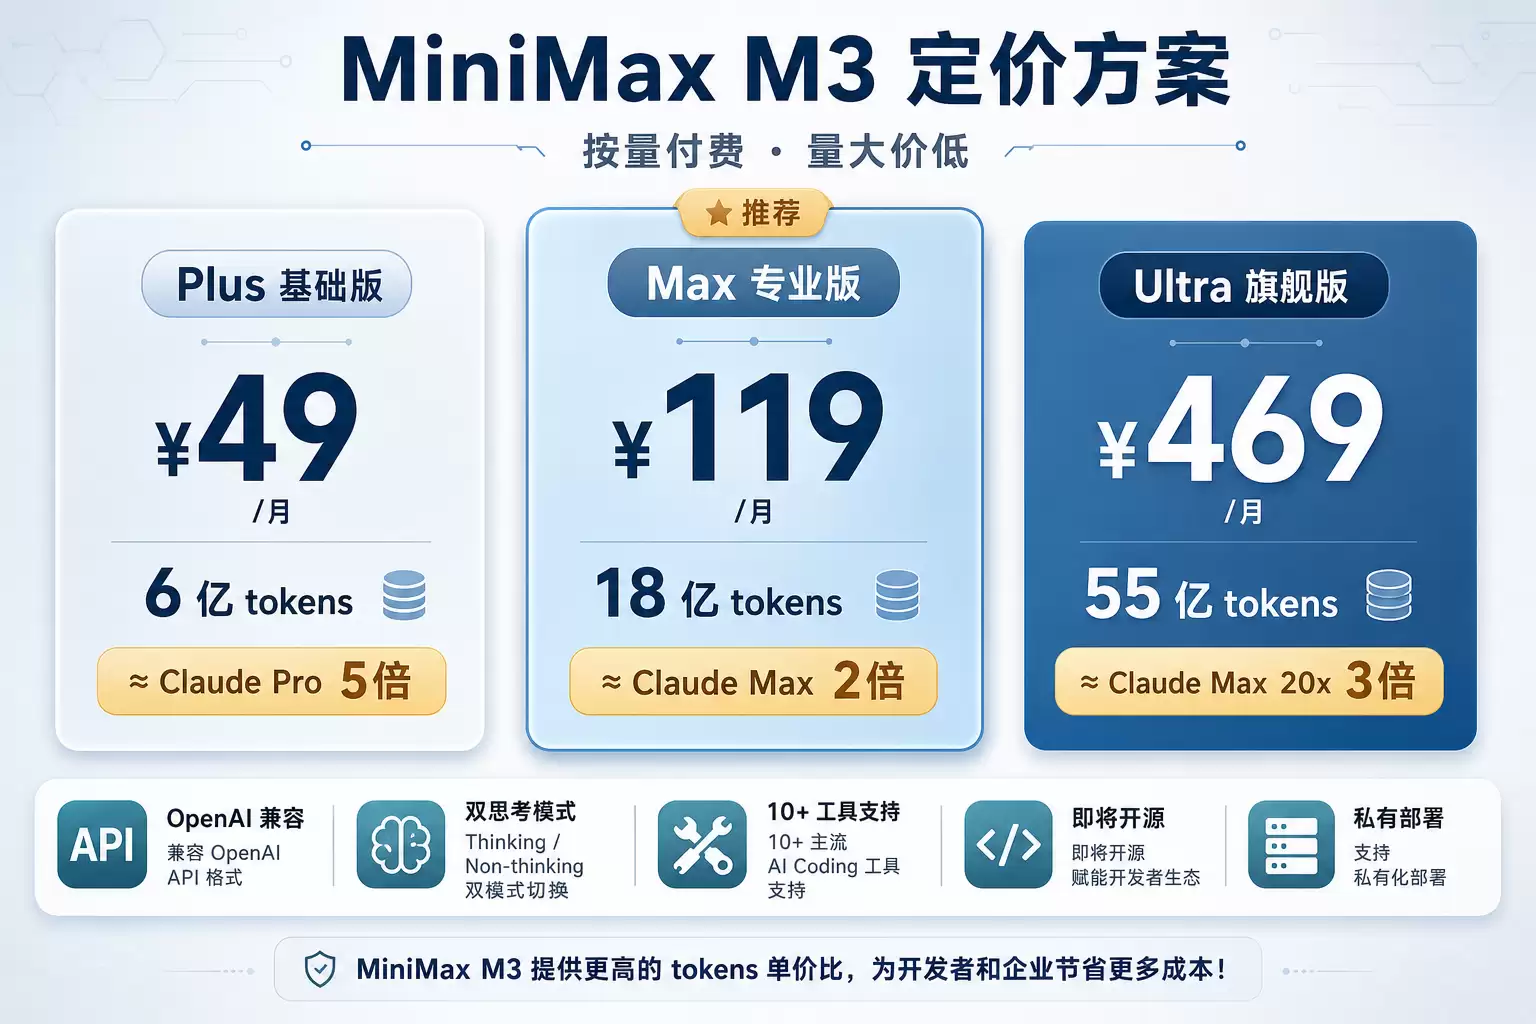 定价对比信息图
图4:MiniMax M3 Token Plan定价方案
从token单价看,M3走量大价低路线。Plus档49/月提供6亿token,日常开发额度充裕。
开发者工具支持
M3支持10余款主流AI Coding工具接入:Claude Code、Roo Code、Kilo Code、Cline、Codex CLI、OpenCode、Droid、TRAE、Grok CLI、Cursor等。主流AI编程工具基本覆盖。接入简单——M3兼容OpenAI API格式,多数工具只需修改API endpoint与model name即可。熟悉这些工具的开发者切换到M3几乎零学习成本。
开源计划
M3即将在HuggingFace与GitHub上完成开源,支持私有集群部署与微调。官方表示技术报告与开源模型权重将在发布后10天内更新。若开源版本保持与闭源版本相近的能力,对国内开发者极具吸引力——可基于自有基础设施运行,无需担心里程碑计费与数据隐私。
7. MiniMax Code:配套Agent产品
MiniMax还发布了专为M3设计的Agent产品MiniMax Code,核心特性包括:
- Agent Team:将大型任务拆解为多阶段、可并发、可动态调整的Workflow
- Producer + Verifier对抗式Harness循环:可持续运行数天,反复验证输出质量
- Computer Use能力:可操作电脑桌面完成跨应用操作
- 基于社区开源项目OpenCode与Pi Agent构建
其中Producer + Verifier的对抗式设计颇具新意——并非一次生成后祈祷正确,而是通过持续的生成→验证→修正循环提升质量,与M3在CUDA优化中跑147次benchmark的行为模式一致。
总结
翻阅官方资料后,对M3的整体印象是:三项能力均衡,无明显短板。MSA架构在稀疏注意力上实现了可观的效率提升,1M上下文并非营销噱头,而是实际可用。Coding与Agent能力在多个权威评测中进入前沿梯队。原生多模态从Day 1开始训练,成本更高但跨模态理解能力更加自然。当然仍存在不确定性:评测成绩与实际体验差距多大?开源版本保留多少能力?长期协作场景下稳定性如何?这些需待模型真正可用后才能判断。但从定价策略与开源计划看,MiniMax明显在降低开发者试用门槛。Plus档49/月提供6亿token,加上即将开源的模型权重,想体验国产前沿模型的开发者试错成本很低。如果你也关注国产大模型进展,M3值得投入时间实际测试。欢迎在评论区分享你最想用它完成什么任务。