

MySQL B+Tree索引优化技巧
MySQL索引以B+树结构为主,支持B树、哈希、R树和全文索引。B+树是多路平衡树,节点含多个关键字与指针,非叶子节点仅存储指针,叶子节点存储数据且在同一层并通过链表连接,支持高效范围查询,减少磁盘IO开销。
索引结构
MySQL目前提供了四种索引类型,分别适用于不同的场景:
- BTREE索引:最常见,绝大多数索引都基于B+树实现。
- HASH索引:只有MEMORY引擎支持,适合简单的等值查询。
- R-tree索引(空间索引):MyISAM引擎的特殊索引,用于地理空间数据,实际中用得不多。
- Full-text(全文索引):也是MyISAM的特色,InnoDB从5.6版本开始才支持。
| InnoDB引擎 | MyISAM引擎 | Memory引擎 |
|---|---|---|
| BTREE索引 | 支持 | 支持 |
| HASH索引 | 不支持 | 不支持 |
| R-tree索引 | 不支持 | 支持 |
| Full-text | 5.6版本之后支持 | 支持 |
通常我们说的索引,如果不特别指明,指的就是B+树(多路搜索树,不一定是二叉树)结构组织的索引。聚集索引、复合索引、前缀索引、唯一索引默认都是B+Tree,统称为索引。
BTREE结构
Btree也叫多路平衡树。一棵m叉Btree的特性如下:
- 树中每个节点最多包含m个孩子
- 除根节点外,每个节点至少有
ceil(m/2)个孩子 - 若根节点不是叶子节点,则至少含有两个孩子
- 所有的叶子节点都在同一层
- 每个非叶子节点由n个key与n+1个指针组成,其中
[ceil(m/2)-1] <= n <= m-1
以5叉BTREE为例
插入步骤
key的数量范围是 2 <= n <= 4。当n>4时,中间节点分裂到父节点,两边节点分裂。
以插入 C N G A H E K Q M F W L T Z D P R X Y S 这组数据为例,来看看整个演变过程。
起初结点空间足够,四个字母可以放在同一个节点中:
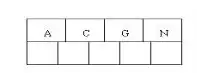
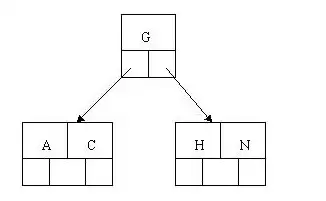
再插入H,此时节点内元素变成ACGHN,数量超过4,中间元素G向上分裂到新节点:
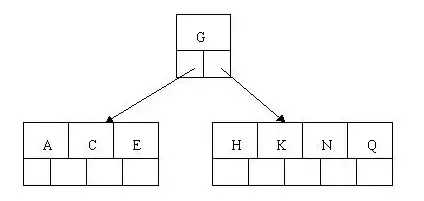
接着插入E、K、Q,节点空间都足够,无需分裂:
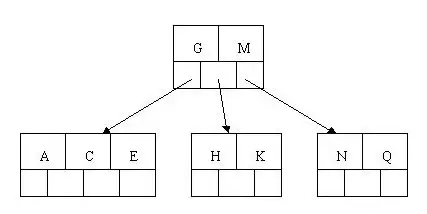
再插入M,在HKNQ块中插入M后变成HKMNQ,中间元素是M,M向上分裂到父节点G,同时HK与NQ分裂:
插入F、W、L、T,均无需分裂:
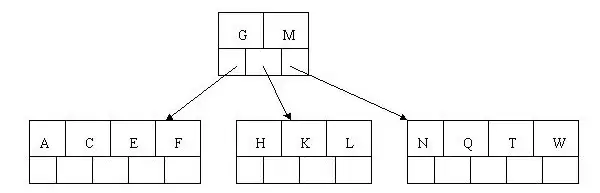
插入Z,Z大于M,走最右边指针,指向NQTW节点。插入Z后变成NQTWZ,中间元素是T,但此时n最大为4,T需要向上分裂,同时NQ和WZ分裂:
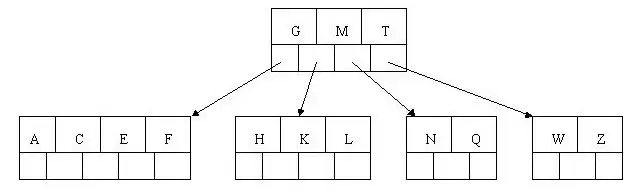
插入D,类似上述步骤,D是中间元素,向上分裂,AC和EF分裂,D插入到父节点后仍然平衡;接着插入P、R、X、Y,都满足Btree特性,不需要分裂:
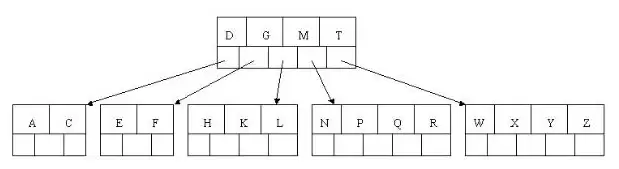
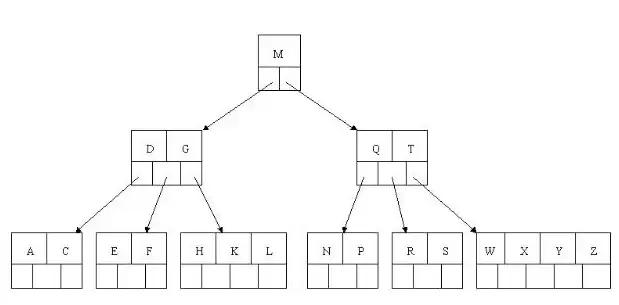
最后插入S,S大于M小于T,走第四个指针,向NPQR中插入。插入后变成NPQRS,key个数超过4,中间元素Q向上分裂,同时NP、RS分裂;Q插入到父节点DGMT变成DGMQT,再次超过4,中间元素M向上分裂,同时DG和QT分裂:
删除步骤
- 首先在B树中查找要删除的元素。如果该元素存在,则在其节点中删除。删除后,先判断该元素是否有左右孩子节点,如果有,则将孩子节点中的相近元素上移到父节点中;如果没有,则直接删除,并处理后续移动。
- 删除元素并移动后,如果某节点中元素数目小于
ceil(m/2)-1,则需要看其相邻兄弟节点是否丰满(节点中元素个数大于ceil(m/2)-1)。如果丰满,则向父节点借一个元素来满足条件;如果兄弟节点也刚脱贫(借了之后自身也会不足),那么该节点与相邻兄弟节点进行合并。
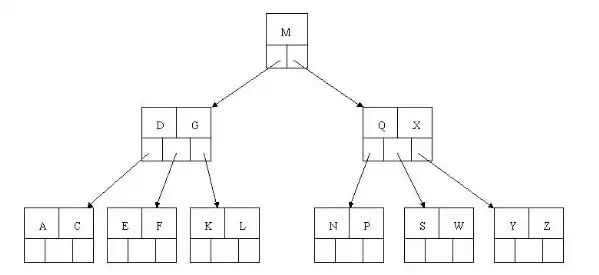
例如,依次删除上述B树中的H、T、R、E:
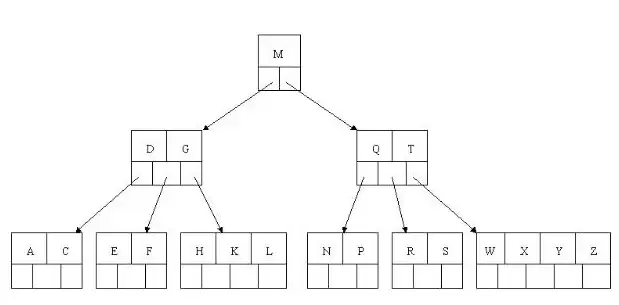
先删除H。H位于叶子节点中,该节点元素数目3大于最小元素数目2,所以直接移动K到原来H的位置,移动L到K的位置:
再删除T。T位于中间节点中,找到它的继承者W(字母升序下的下一个元素),将W上移到T的位置,然后删除原孩子节点中的W。删除W后,该孩子节点元素个数仍然大于2,无需合并:
接着删除R。R在叶子节点中,该节点原有2个元素(PS),删除后只剩1个,小于ceil(5/2)-1=2。右相邻兄弟节点(WX)比较丰满(3个元素>2),所以向父节点借一个元素W下移到该节点,代替S,S前移;然后X从右兄弟节点上移到父节点,再删除右兄弟节点中的X:
最后删除E。E所在节点(ACF)在删除E后只剩C和F,刚好满足最小条件?实际上删除E后该节点只有C和F两个元素,而相邻兄弟节点(无?图中显示的是合并情况)。这里需要与相邻兄弟节点合并。先将父节点中的元素D下移到子节点中,然后将含有D和F的节点与含有A和C的兄弟节点合并成一个节点:
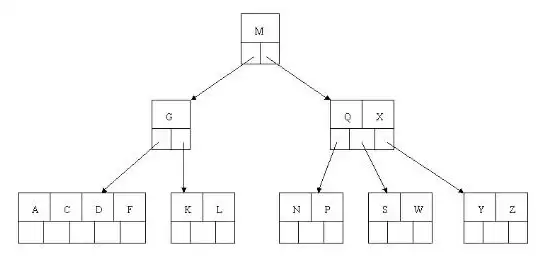
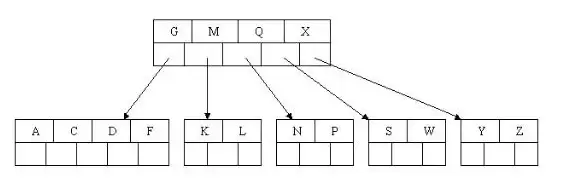
合并后,D元素使ACDF节点满足平衡条件,但父节点G不满足(元素个数小于ceil(5/2)-1)。所有相邻兄弟节点元素也都刚好满足,无法借,只能再次合并。将根节点中的唯一元素M下移到子节点,树的高度减少一层:
B+TREE结构
B+Tree是Btree的变种,主要区别在于:
- m叉B+Tree最多含有m个key,而Btree最多含有m-1个key
- B+Tree的叶子节点保存所有key信息,并按key大小顺序排列
- 所有非叶子节点可以看作key的索引部分
由于B+Tree只有叶子节点保存key信息,查询任何key都要从根走到叶子,因此查询效率更加稳定。
MySQL中的B+TREE
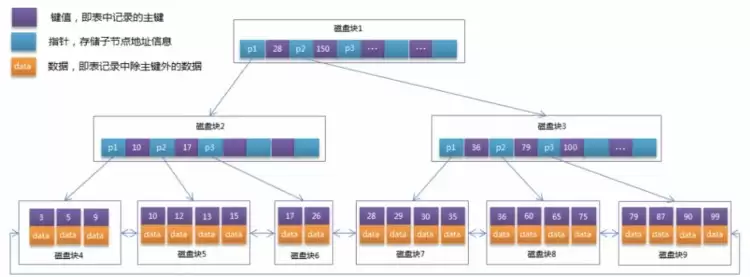
MySQL对经典的B+Tree做了优化:在原有结构基础上,增加一个指向相邻叶子节点的链表指针,形成了带有顺序指针的B+Tree,这能显著提高区间访问的性能。
索引分类
- 单值索引(单列索引):一个索引只包含单个列,一个表可以有多个单列索引。
- 唯一索引:索引列的值必须唯一,但允许有空值。
- 复合索引:一个索引包含多个列。
索引语法
创建索引
-- 不指定索引类型时,默认使用B+TREE
-- 方式一:使用CREATE
CREATE [UNIQUE|FULLTEXT|SPATIAL] INDEX index_name [USING index_type] ON table_name(index_col_name,...);

-- 方式二:使用ALTER
-- 普通索引
ALTER TABLE table_name ADD INDEX index_name(columnName_list);
-- 唯一索引(列的值除了null可重复,其余必须唯一)
ALTER TABLE table_name ADD UNIQUE INDEX index_name(columnName_list);
-- 全文索引
ALTER TABLE table_name ADD FULLTEXT index_name(columnName_list);
查看索引
SHOW INDEX FROM table_name;
删除索引
DROP INDEX index_name ON table_name;
索引失效情形
定义了索引,但在某些条件下查询并不会走索引,下面逐一分析。
情形一:对索引字段使用了函数,会导致索引失效。
情形二:复合索引下,最左前缀法则和范围查询的影响。
假设一张表有字段name、status、address,构成了复合索引,顺序为 create index name_status_address_index on table_name(name,status,address),三个字段都是varchar类型。
- 等值条件
where name='aa' and status='1' and address='苏州市':全部走索引。 - 范围条件
where name='aa' and status>'1' and address='苏州市':status用了范围查询,后面的address不走索引,所以只有name和status走索引。 - 等值条件
where name='aa' and address='苏州市':根据最左前缀法则,只有name走了索引。 - 等值条件
where address='苏州市':最左前缀不满足,没有索引可走。 - 等值条件
where status='1' and address='苏州市' and name='aa':顺序不重要,只要最左列出现,全部走索引。 - 等值条件
where name='aa':走name索引。
情形三:隐式类型转换。
上面同样的索引,如果执行 where name='aa' and status=1(status是varchar类型,但传入数值),status发生隐式转换,不走索引,只有name走索引。
情形四:使用or关联条件时,如果or前面的字段有索引,后面的字段没有索引,那么整个查询不走索引。
-- 不走索引
SELECT name,status,address FROM table_name WHERE name='aa' OR remark='bb';
-- and条件下,name走索引
SELECT name,status,address FROM table_name WHERE name='aa' AND remark='bb';
模糊匹配:like以%开头时,不走索引;以%结尾时走索引。但可以通过覆盖索引来绕过:如果要查询的字段都在索引内,即使like以%开头,也可能走索引。
-- 假设有复合索引(name,status,address)和主键id索引,查询id也在覆盖范围内
SELECT id,name,status,address FROM table_name WHERE name LIKE '%aa%';
-- 上述可能走索引,因为要查询的字段都在索引或主键中
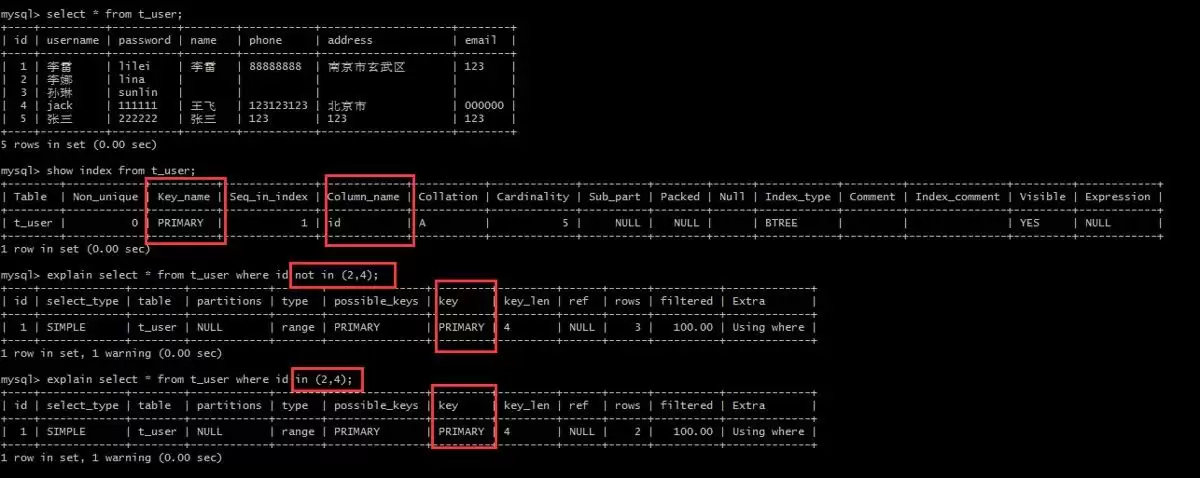
in和not in:MySQL 8.0之前,in走索引,not in不走索引;8.0之后两者都走索引。
例如,表seller中sellerid为主键,name,status,address为联合索引。5.7版本下in和not in的执行计划不同:
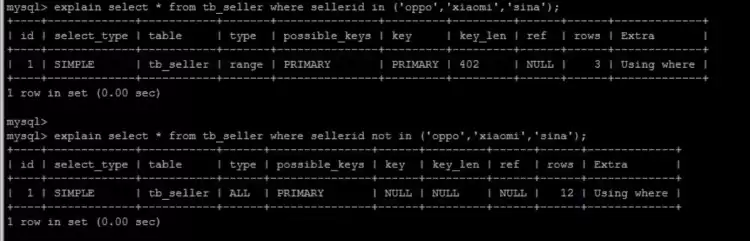
8.0版本下in和not in都走索引:
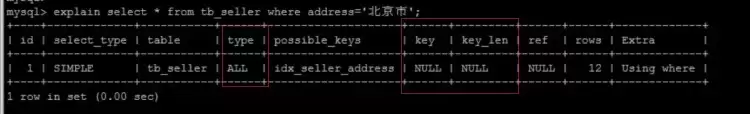
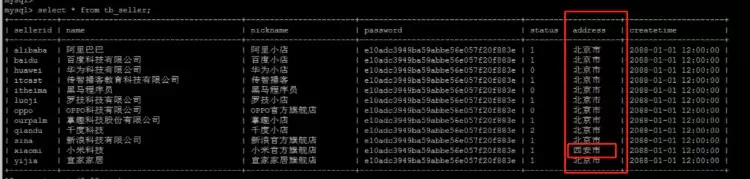
情形五:如果MySQL评估使用索引比全表扫描更慢,则会选择全表扫描。例如,索引字段中某个值占比特别大,几乎占全表,查询该值就可能不走索引。
执行 select * from seller where name='北京市',由于‘北京市’的记录太多,MySQL选择全表扫描。而 select * from seller where name='西安市',则走索引:
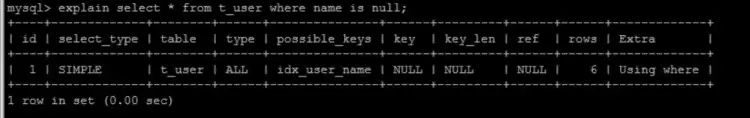
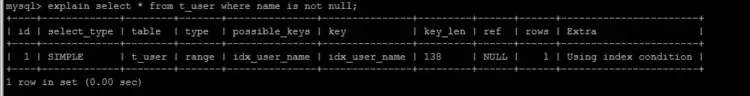
情形六:is null和is not null有时走索引,有时不走。取决于该字段中null值的分布情况。如果null值占比大,is null就不走索引,is not null走索引;反之亦然。
例如,t_user表中name字段有索引。执行explain select * from t_user where name is null;和where name is not null;,结果不同:
SQL优化的细节
- 尽量使用索引,配合
explain分析执行计划。 - 查询时尽量使用覆盖索引,即要查询的字段都在索引中,避免回表(因为索引只记录了索引列的数据,不包含整行记录)。
-- 回表查询
SELECT * FROM table_name WHERE name='aa';  -- Extra: Using index condition
-- 覆盖索引查询
SELECT name,status,address FROM table_name WHERE name='aa';  -- Extra: Using where; Using index
-- 部分覆盖,部分回表
SELECT name,status,remark FROM table_name WHERE name='aa';  -- Extra: Using index condition
大批量导入数据
使用LOAD DATA指令导入大批量数据时:
- 最好按主键顺序排好数据再导入。
- 如果表有唯一性约束,导入前关闭唯一性校验,导入后开启:
SET UNIQUE_CHECKS=0;
-- 导入...
SET UNIQUE_CHECKS=1;
- 手动提交事务,导入前关闭自动提交,导入后提交并恢复。
INSERT优化细节
多数据插入时,尽量拼接在一起,开启手动事务,且数据的主键有序。
ORDER BY排序优化
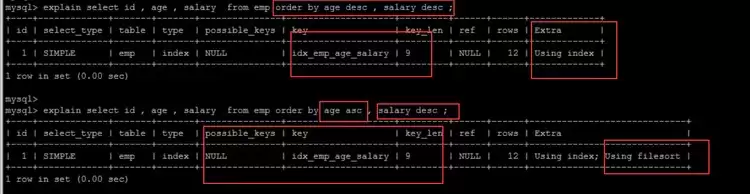
explain中extra字段可能出现两种:Using index(使用索引排序)和Using filesort(未使用索引排序)。
例如,emp表有复合索引(age, salary)。即使order by字段建立了索引,但如果没有满足覆盖索引条件,仍可能出现filesort:
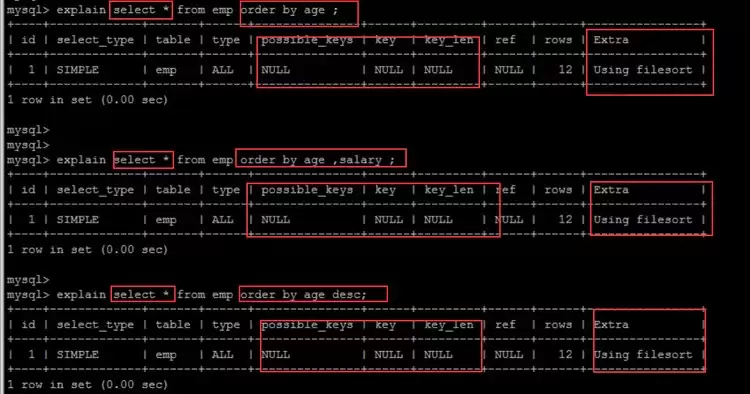
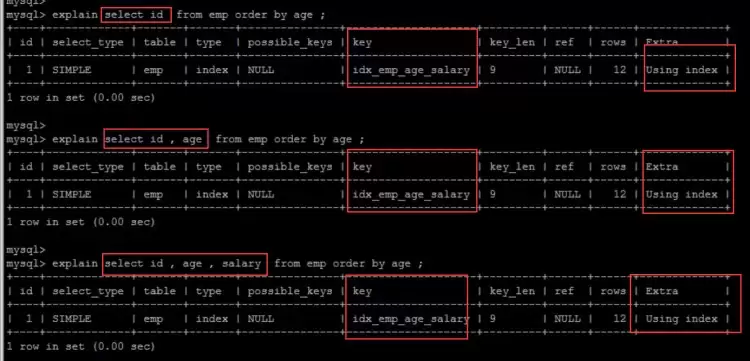
只有在select字段都在索引内(覆盖索引)时,才能用索引排序。如果select包含了非索引字段,就会回表并导致filesort。
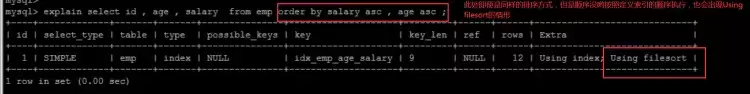
另外,排序时两个字段如果一个升序一个降序,或者排序字段的顺序与索引定义顺序不一致,也会出现filesort。两个字段同时升序或同时降序,且顺序与索引一致,才能走索引排序。
对出现filesort的优化
通过创建合适的索引可以减少filesort,但有些情况下无法避免。此时可以加快filesort本身的速度。MySQL有两种排序算法:
- 两次扫描算法(MySQL 4.1之前):先取出排序字段和行指针,在排序区排序,如果内存不够则用临时表,最后根据行指针回表读取数据,可能导致大量随机I/O。
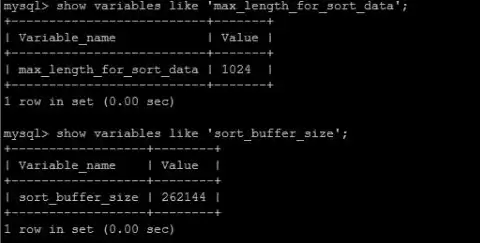
- 一次扫描算法:一次性取出所有需要的字段,在排序区排序后直接输出。内存开销较大,但效率更高。MySQL通过比较
max_length_for_sort_data和查询字段总大小来决定使用哪种算法。如果max_length_for_sort_data更大,则使用一次扫描算法。
可以适当提高sort_buffer_size和max_length_for_sort_data来提升排序效率。
GROUP BY语句优化
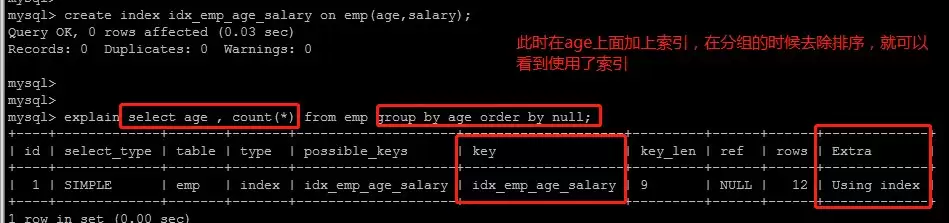
GROUP BY默认会进行排序操作,与ORDER BY类似,也可以利用索引。如果希望避免排序消耗,可以加上ORDER BY NULL来禁止排序:
上面出现的Using temporary表示使用了临时表,因为age没有索引。
子查询优化
MySQL 4.1后支持子查询。子查询写起来很方便,但有些情况下可以用更高效的JOIN替代:
OR优化
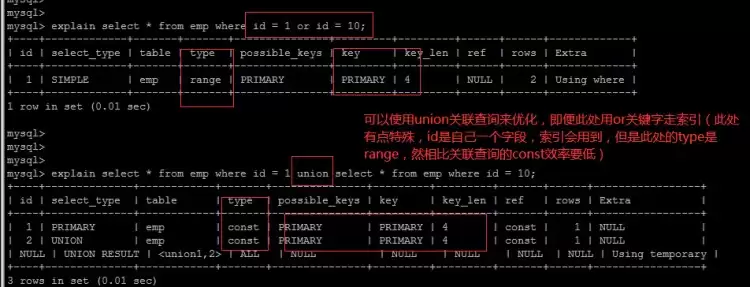
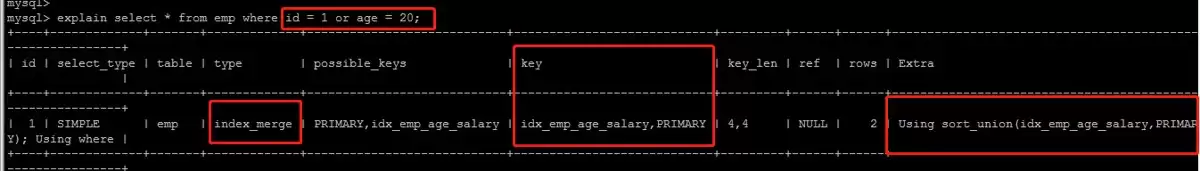
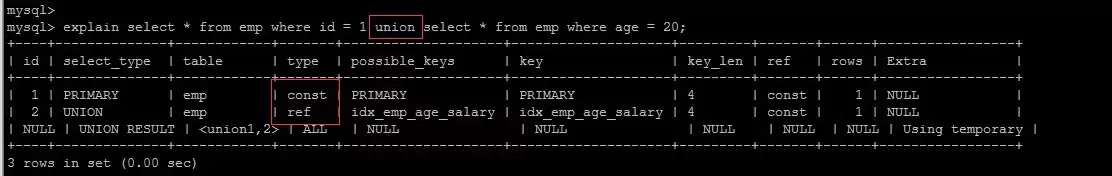
前面提到,如果or两边的字段一个有索引一个没有,整个查询不走索引。对于复合索引,即使两个字段都在复合索引中,但or条件依然不走索引。建议用UNION替换or。
情形一(复合索引中两个字段用or):
情形二(不同字段有各自独立的索引,or时type为index_merge):
改用UNION后,type变成const和ref,效率更高:
LIMIT分页查询优化
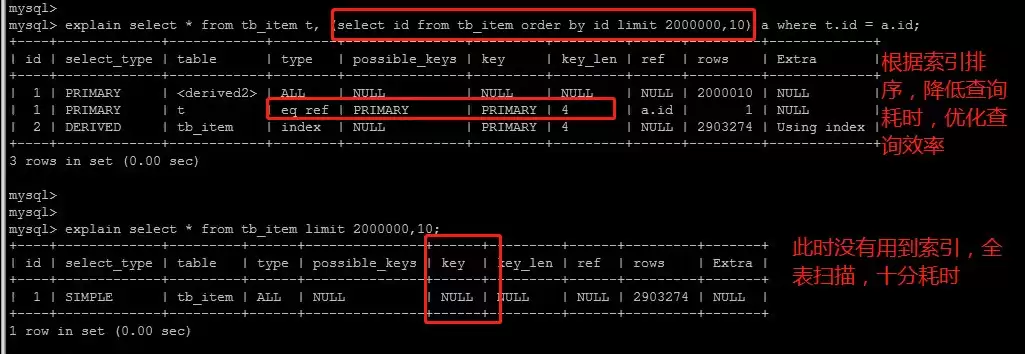
当分页偏移量很大时,比如 LIMIT 2000000,10,MySQL需要排序前2000010条记录,然后丢弃前面的2000000条,代价巨大。
优化思路一:在主键上完成排序分页,再根据主键关联回原表查询其他列:
优化思路二:如果主键自增且没有断层(即没有删除记录导致主键不连续),可以将limit查询转化为某个位置查询:
索引提示
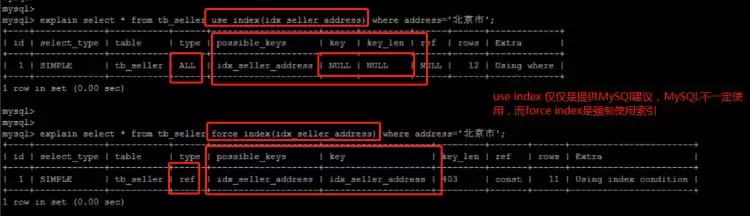
- USE INDEX:建议MySQL使用某个索引(仅供参考,MySQL不一定采纳)。
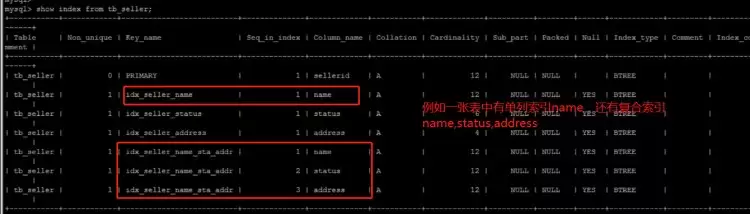
- IGNORE INDEX:忽略某个索引。
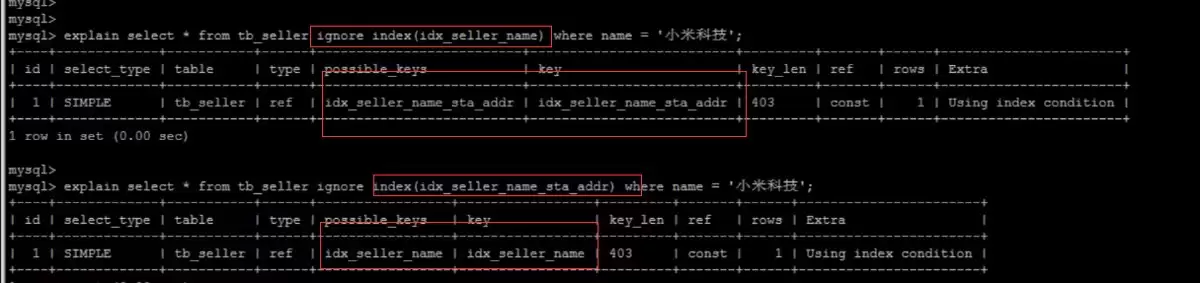
- FORCE INDEX:强制使用某个索引,即使MySQL认为全表扫描更优。
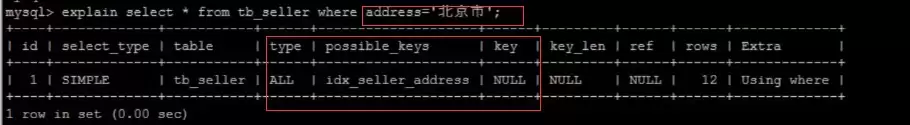
使用FORCE INDEX后的效果:
总结
索引是数据库性能优化的核心手段之一,从B+Tree的结构原理到索引失效的各种情形,再到SQL优化细节,每一步都值得在实际开发中反复验证。用好explain,理解覆盖索引、最左前缀、排序优化等概念,能帮助我们在日常工作中写出更高效的SQL。