

知识图谱:从三元组到GraphRAG,搞懂知识表示构建推理
知识图谱以三元组为基本单元,通过图结构组织知识,涵盖RDF与属性图两种表示模型。其构建依赖知识抽取、融合与推理技术,最终应用包括GraphRAG等,支持多跳推理与关联发现,提升复杂问答准确性。
知识图谱这几年已经不是新鲜概念了,但真正把它用好的团队却不多。从最基础的三元组说起,到如今火出圈的GraphRAG,里头串联着一整套知识表示、构建与推理的技术栈。今天就顺着这条线,把整个体系完整过一遍。
一、知识图谱定义与核心概念
1.1 知识图谱核心定义与三元组结构
简单来说,知识图谱就是用图结构来组织知识的一套系统。它的基本构件三个:
- 节点:就是实体,比如某个人、某个地点、某个组织或某个抽象概念。
- 边:就是关系,标明两个实体之间怎么关联的,比如“出生于”“创立了”“属于”。
- 属性:实体的具体特征,比如年龄38岁、人口1400万这些细节信息。
这里的最小知识单元叫三元组:
(头实体, 关系, 尾实体)
举个例子更直观:
| 头实体 | 关系 | 尾实体 |
|---|---|---|
| DeepSeek | 位于 | 中国 |
| LLM | 基于 | Transformer |
| Transformer | 提出者 | |
| Transformer | 提出时间 | 2017 |
1.2 知识图谱与关系数据库的本质区别
这两者到底有什么本质区别?一句话就能说清:关系数据库存数据,知识图谱存知识。数据是死的,知识是活的——能推理、能发现、还能解释。
| 维度 | 关系数据库 | 知识图谱 |
|---|---|---|
| 数据模型 | 表(行+列) | 图(节点+边) |
| 关系表示 | 外键(隐式) | 边(显式) |
| 查询方式 | SQL JOIN | 图遍历/模式匹配 |
| 多跳查询 | 多次JOIN,复杂 | 路径查询,自然 |
| Schema | 固定表结构 | 灵活本体 |
| 推理能力 | 无 | 支持(规则/嵌入/GNN) |
| 典型场景 | 事务处理 | 知识推理/关联发现 |
二、知识图谱技术全景图与架构
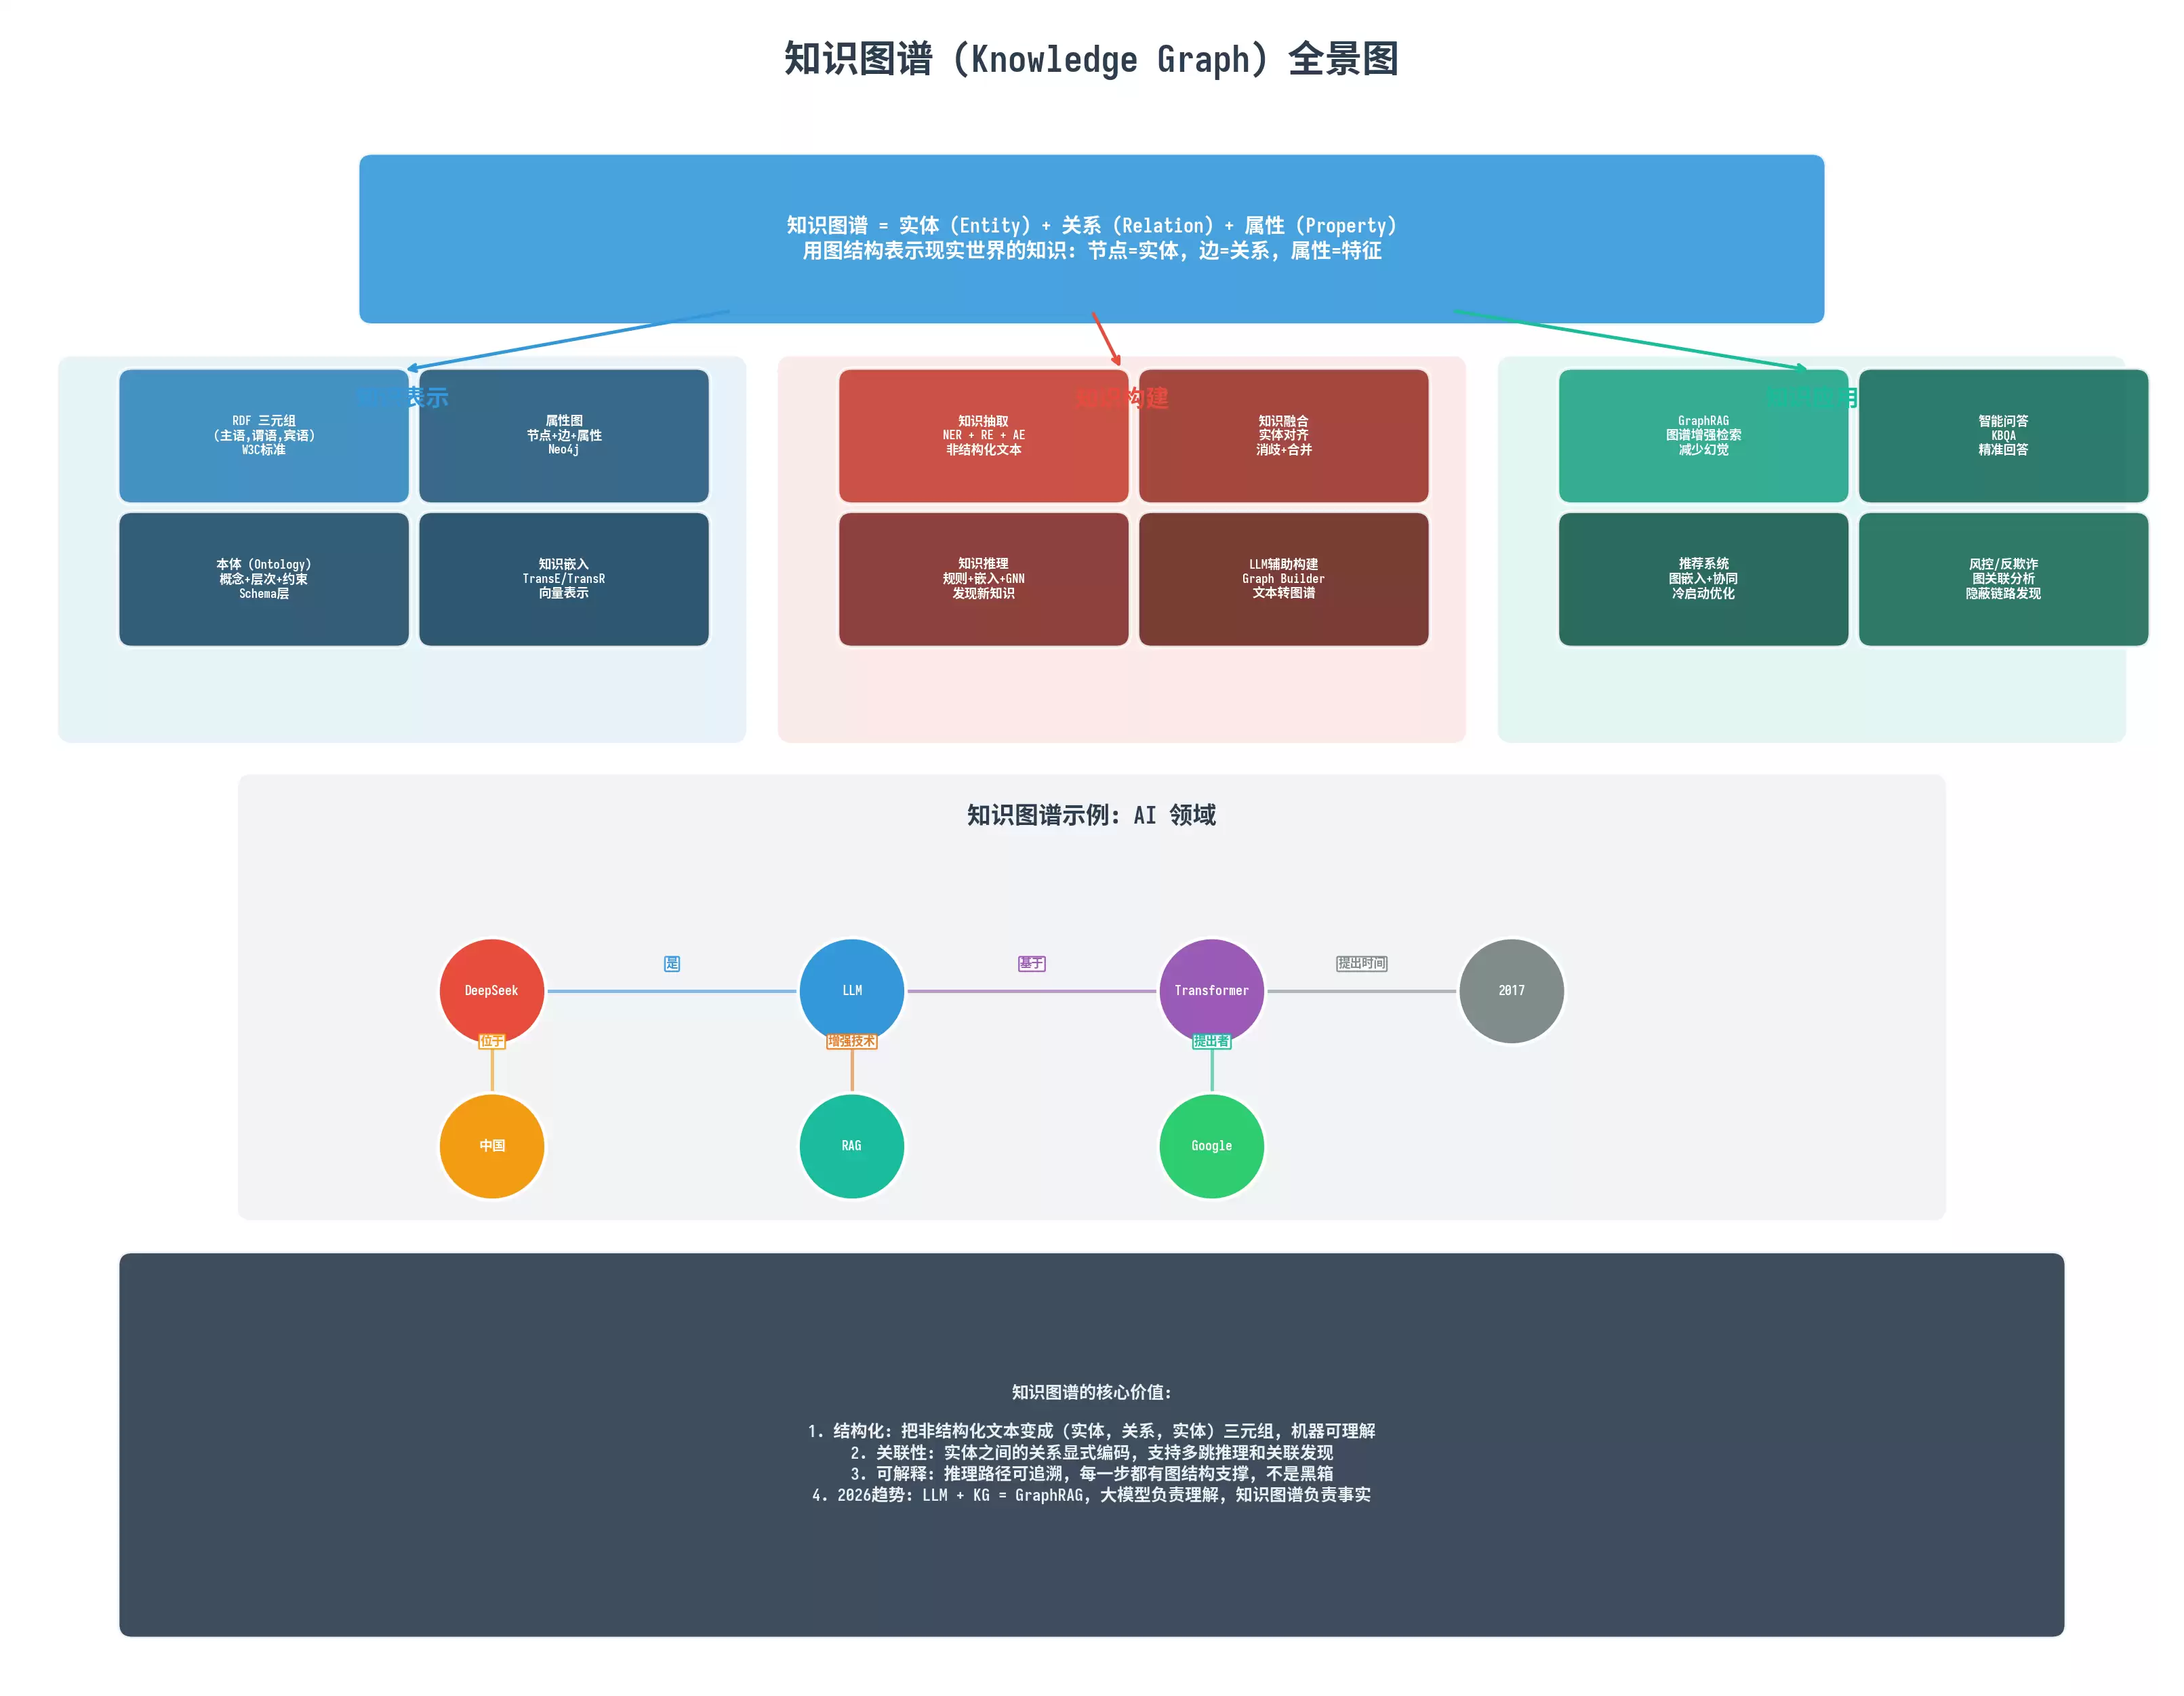
整个知识图谱的技术栈可以拆成三大块:
| 支柱 | 核心问题 | 关键技术 |
|---|---|---|
| 知识表示 | 怎么存? | RDF三元组 / 属性图 / 本体 / 知识嵌入 |
| 知识构建 | 怎么建? | 知识抽取 / 知识融合 / 知识推理 / LLM辅助 |
| 知识应用 | 怎么用? | GraphRAG / KBQA / 推荐系统 / 风控反欺诈 |
三、知识图谱知识表示:RDF与属性图模型
3.1 RDF三元组模型
RDF是W3C定的一套标准表示模型,每条知识就是一个三元组,实体和关系都用URI来标识。查询用的是SPARQL。
举个例子(Turtle格式):
@prefix ex: 优点很突出:标准统一、语义丰富、天然支持推理。但缺点也很明显——属性表示不够直观,写起查询来复杂度高。
3.2 属性图模型
这是Neo4j采用的模型,相比之下直观得多。节点带标签和属性,关系也有类型和属性,查询用的是Cypher。
CREATE (d:Company {name: 'DeepSeek', founded: 2023})
CREATE (c:Country {name: '中国'})
CREATE (l:Technology {name: 'LLM'})
CREATE (t:Architecture {name: 'Transformer', year: 2017})
CREATE (g:Company {name: 'Google'})
CREATE (d)-[:LOCATED_IN]->(c)
CREATE (d)-[:DEVELOPS]->(l)
CREATE (l)-[:BASED_ON]->(t)
CREATE (t)-[:PROPOSED_BY]->(g)
直观、属性丰富、生态成熟,这是它的优势。但缺点是它不是W3C标准,跨平台互操作性差一些。
3.3 RDF与属性图模型对比
| 维度 | RDF | 属性图 |
|---|---|---|
| 标准化 | W3C标准 | 厂商标准 |
| 查询语言 | SPARQL | Cypher |
| 属性表示 | 间接 | 直接 |
| 推理支持 | 内置(RDFS/OWL) | 需外部工具 |
| 代表系统 | Apache Jena, Virtuoso | Neo4j, JanusGraph |
| 适用场景 | 语义网、学术研究 | 工业应用、GraphRAG |
四、知识图谱构建:从文本到图谱
4.1 知识抽取方法与流程
从一堆非结构化文本里抽三元组,这是构建知识图谱的第一步。具体分三个子任务:
| 任务 | 输入 | 输出 | 方法 |
|---|---|---|---|
| NER(命名实体识别) | “DeepSeek位于中国” | DeepSeek(ORG), 中国(LOC) | BiLSTM-CRF / BERT-NER / LLM |
| RE(关系抽取) | “DeepSeek位于中国” | (DeepSeek, 位于, 中国) | PCNN / BERT-RE / LLM |
| AE(属性抽取) | “DeepSeek成立于2023年” | (DeepSeek, 成立年份, 2023) | 正则 / BERT / LLM |
到了2026年,用LLM辅助抽取已经是主流做法,比如:
from langchain.chat_models import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_template("""
从以下文本中抽取知识三元组,格式为 (头实体, 关系, 尾实体):
文本: {text}
输出格式:
- (实体1, 关系, 实体2)
- (实体3, 关系, 实体4)
...
""")

llm = ChatOpenAI(model="gpt-4o-mini")
chain = prompt | llm

text = "DeepSeek是一家位于中国的AI公司,由梁文锋创立,开发了DeepSeek-V3大语言模型"
result = chain.invoke({"text": text})
print(result.content)
# 输出:
# - (DeepSeek, 位于, 中国)
# - (DeepSeek, 创始人, 梁文锋)
# - (DeepSeek, 开发了, DeepSeek-V3)
# - (DeepSeek-V3, 类型, 大语言模型)
4.2 知识融合与实体对齐
不同来源的知识怎么合并?这里有几个典型问题需要处理:
| 任务 | 问题 | 方法 |
|---|---|---|
| 实体对齐 | “DeepSeek”和“deepseek-ai”是同一实体 | 表示学习 + 相似度匹配 |
| 实体消歧 | “苹果”是水果还是公司? | 上下文嵌入 + 分类器 |
| 知识合并 | 两个知识库有重叠和互补 | 图匹配 + 冲突消解 |
4.3 知识推理技术与方法
推理是知识图谱真正的“杀手锏”——能从已知知识推导出未知知识。目前主流的方法有四种:
| 方法 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 规则推理 | IF-THEN规则 | 可解释 | 规则需人工编写 |
| 嵌入推理 | TransE/RotatE | 自动学习 | 黑箱 |
| GNN推理 | 消息传递 | 捕获图结构 | 可扩展性差 |
| LLM推理 | 上下文学习 | 灵活 | 可能幻觉 |
五、知识图谱嵌入:把图谱变成向量
5.1 为什么需要知识嵌入?
知识图谱本质上还是符号系统,机器没法直接用来做计算和推理。知识嵌入(KGE)就是把实体和关系映射到低维向量空间,让机器能算、能比、能推理。
5.2 三大嵌入家族
翻译模型(Translation-based)
核心思路很简洁:头实体向量 + 关系向量 ≈ 尾实体向量。用公式写就是:
f(h, r, t) = ||h + r - t||
| 模型 | 核心创新 | 年份 |
|---|---|---|
| TransE | h + r ≈ t,最简单 | 2013 |
| TransH | 超平面投影,处理1-to-N | 2014 |
| TransR | 实体空间和关系空间分离 | 2015 |
| RotatE | 复数空间旋转,建模对称/反对称 | 2019 |
语义匹配模型(Semantic Matching)
这类模型用双线性或内积来衡量三元组的合理性:
f(h, r, t) = hMt
| 模型 | 核心创新 | 年份 |
|---|---|---|
| DistMult | 对角矩阵,简单高效 | 2015 |
| ComplEx | 复数空间,建模非对称 | 2016 |
| HolE | 循环相关,压缩表示 | 2016 |
图神经网络模型(GNN-based)
核心是通过消息传递来聚合邻居信息:
h = σ(∑ ∑∈N(v) W h)
| 模型 | 核心创新 | 年份 |
|---|---|---|
| RGCN | 关系特定的变换矩阵 | 2018 |
| CompGCN | 组合编码,参数共享 | 2020 |
| KBAT | 知识感知的注意力机制 | 2020 |
5.3 代码实战:TransE训练
import torch
import torch.nn as nn

class TransE(nn.Module):
    def __init__(self, num_entities, num_relations, dim=128, margin=1.0):
        super().__init__()
        self.entity_emb = nn.Embedding(num_entities, dim)
        self.relation_emb = nn.Embedding(num_relations, dim)
        self.margin = margin
        nn.init.xa vier_uniform_(self.entity_emb.weight)
        nn.init.xa vier_uniform_(self.relation_emb.weight)

    def forward(self, h, r, t):
        h_emb = self.entity_emb(h)
        r_emb = self.relation_emb(r)
        t_emb = self.entity_emb(t)
        h_emb = nn.functional.normalize(h_emb, p=2, dim=-1)
        t_emb = nn.functional.normalize(t_emb, p=2, dim=-1)
        score = torch.norm(h_emb + r_emb - t_emb, p=2, dim=-1)
        return score

    def loss(self, pos_score, neg_score):
        return torch.mean(torch.clamp(pos_score - neg_score + self.margin, min=0))

# 训练示例
model = TransE(num_entities=10000, num_relations=100, dim=128)
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)

for epoch in range(100):
    pos_h, pos_r, pos_t = get_positive_batch()
    neg_t = get_negative_samples(pos_t)
    pos_score = model(pos_h, pos_r, pos_t)
    neg_score = model(pos_h, pos_r, neg_t)
    loss = model.loss(pos_score, neg_score)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    if epoch % 10 == 0:
        print(f"Epoch {epoch}, Loss: {loss.item():.4f}")

# 链接预测
def predict_tail(model, , r, all_entities):
    h_tensor = torch.tensor([h]).repeat(len(all_entities))
    r_tensor = torch.tensor([r]).repeat(len(all_entities))
    t_tensor = torch.tensor(all_entities)
    scores = model(h_tensor, r_tensor, t_tensor)
    top_k = torch.argsort(scores)[:10]
    return top_k
六、知识图谱查询:Cypher与SPARQL
6.1 Neo4j Cypher查询
// 1. 创建知识图谱
CREATE (ds:Company {name: 'DeepSeek', founded: 2023})
CREATE (cn:Country {name: '中国'})
CREATE (llm:Technology {name: 'LLM'})
CREATE (tf:Architecture {name: 'Transformer', year: 2017})
CREATE (gg:Company {name: 'Google'})
CREATE (rag:Technique {name: 'RAG'})

CREATE (ds)-[:LOCATED_IN]->(cn)
CREATE (ds)-[:DEVELOPS]->(llm)
CREATE (llm)-[:BASED_ON]->(tf)
CREATE (tf)-[:PROPOSED_BY]->(gg)
CREATE (llm)-[:ENHANCED_BY]->(rag)

// 2. 单跳查询
MATCH (d:Company {name: 'DeepSeek'})-[:LOCATED_IN]->(c)
RETURN c.name

// 3. 多跳查询
MATCH (d:Company {name: 'DeepSeek'})-[:DEVELOPS]->()-[:BASED_ON]->()-[:PROPOSED_BY]->(c)
RETURN c.name

// 4. 路径查询
MATCH path = (d:Company {name: 'DeepSeek'})-[*..5]-(g:Company {name: 'Google'})
RETURN path

// 5. 聚合查询
MATCH (c:Country)<-[:LOCATED_IN]-(d:Company)
RETURN c.name, COUNT(d) AS company_count
ORDER BY company_count DESC
6.2 Python + Neo4j实战
from neo4j import GraphDatabase

class KnowledgeGraph:
    def __init__(self, uri="bolt://localhost:7687", user="neo4j", password="password"):
        self.driver = GraphDatabase.driver(uri, auth=(user, password))

    def close(self):
        self.driver.close()

    def add_triple(self, head, relation, tail, head_label="Entity", tail_label="Entity"):
        with self.driver.session() as session:
            session.run(f"""
                MERGE (h:{head_label} {{name: $head}})
                MERGE (t:{tail_label} {{name: $tail}})
                MERGE (h)-[r:{relation}]->(t)
            """, head=head, tail=tail)

    def query(self, cypher, **params):
        with self.driver.session() as session:
            result = session.run(cypher, **params)
            return [record.data() for record in result]

    def multi_hop_query(self, entity, relation_path):
        path = "-".join([f"[:{r}]->(:Entity)" for r in relation_path])
        cypher = f"""
            MATCH (e:Entity {{name: $entity}})-{path}-(target)
            RETURN target.name AS result
        """
        return self.query(cypher, entity=entity)

    def find_paths(self, entity1, entity2, max_depth=5):
        cypher = f"""
            MATCH path = (e1:Entity {{name: $e1}})-[*..{max_depth}]-(e2:Entity {{name: $e2}})
            RETURN [node in nodes(path) | node.name] AS entities, [rel in relationships(path) | type(rel)] AS relations
            LIMIT 10
        """
        return self.query(cypher, e1=entity1, e2=entity2)

# 使用示例
kg = KnowledgeGraph()
kg.add_triple("DeepSeek", "LOCATED_IN", "中国", "Company", "Country")
kg.add_triple("DeepSeek", "DEVELOPS", "LLM", "Company", "Technology")
kg.add_triple("LLM", "BASED_ON", "Transformer", "Technology", "Architecture")
result = kg.multi_hop_query("DeepSeek", ["DEVELOPS", "BASED_ON"])
paths = kg.find_paths("DeepSeek", "Google")
七、GraphRAG:知识图谱增强生成
7.1 为什么需要GraphRAG?
传统基于向量检索的RAG有三个绕不开的硬伤:
| 问题 | 原因 | GraphRAG怎么解决 |
|---|---|---|
| 多跳推理差 | 向量检索只找相似片段 | 图遍历支持多跳关联 |
| 幻觉严重 | 检索片段缺乏上下文 | 图谱提供结构化事实 |
| 不可解释 | 不知道答案从哪来 | 推理路径可追溯 |
7.2 GraphRAG架构
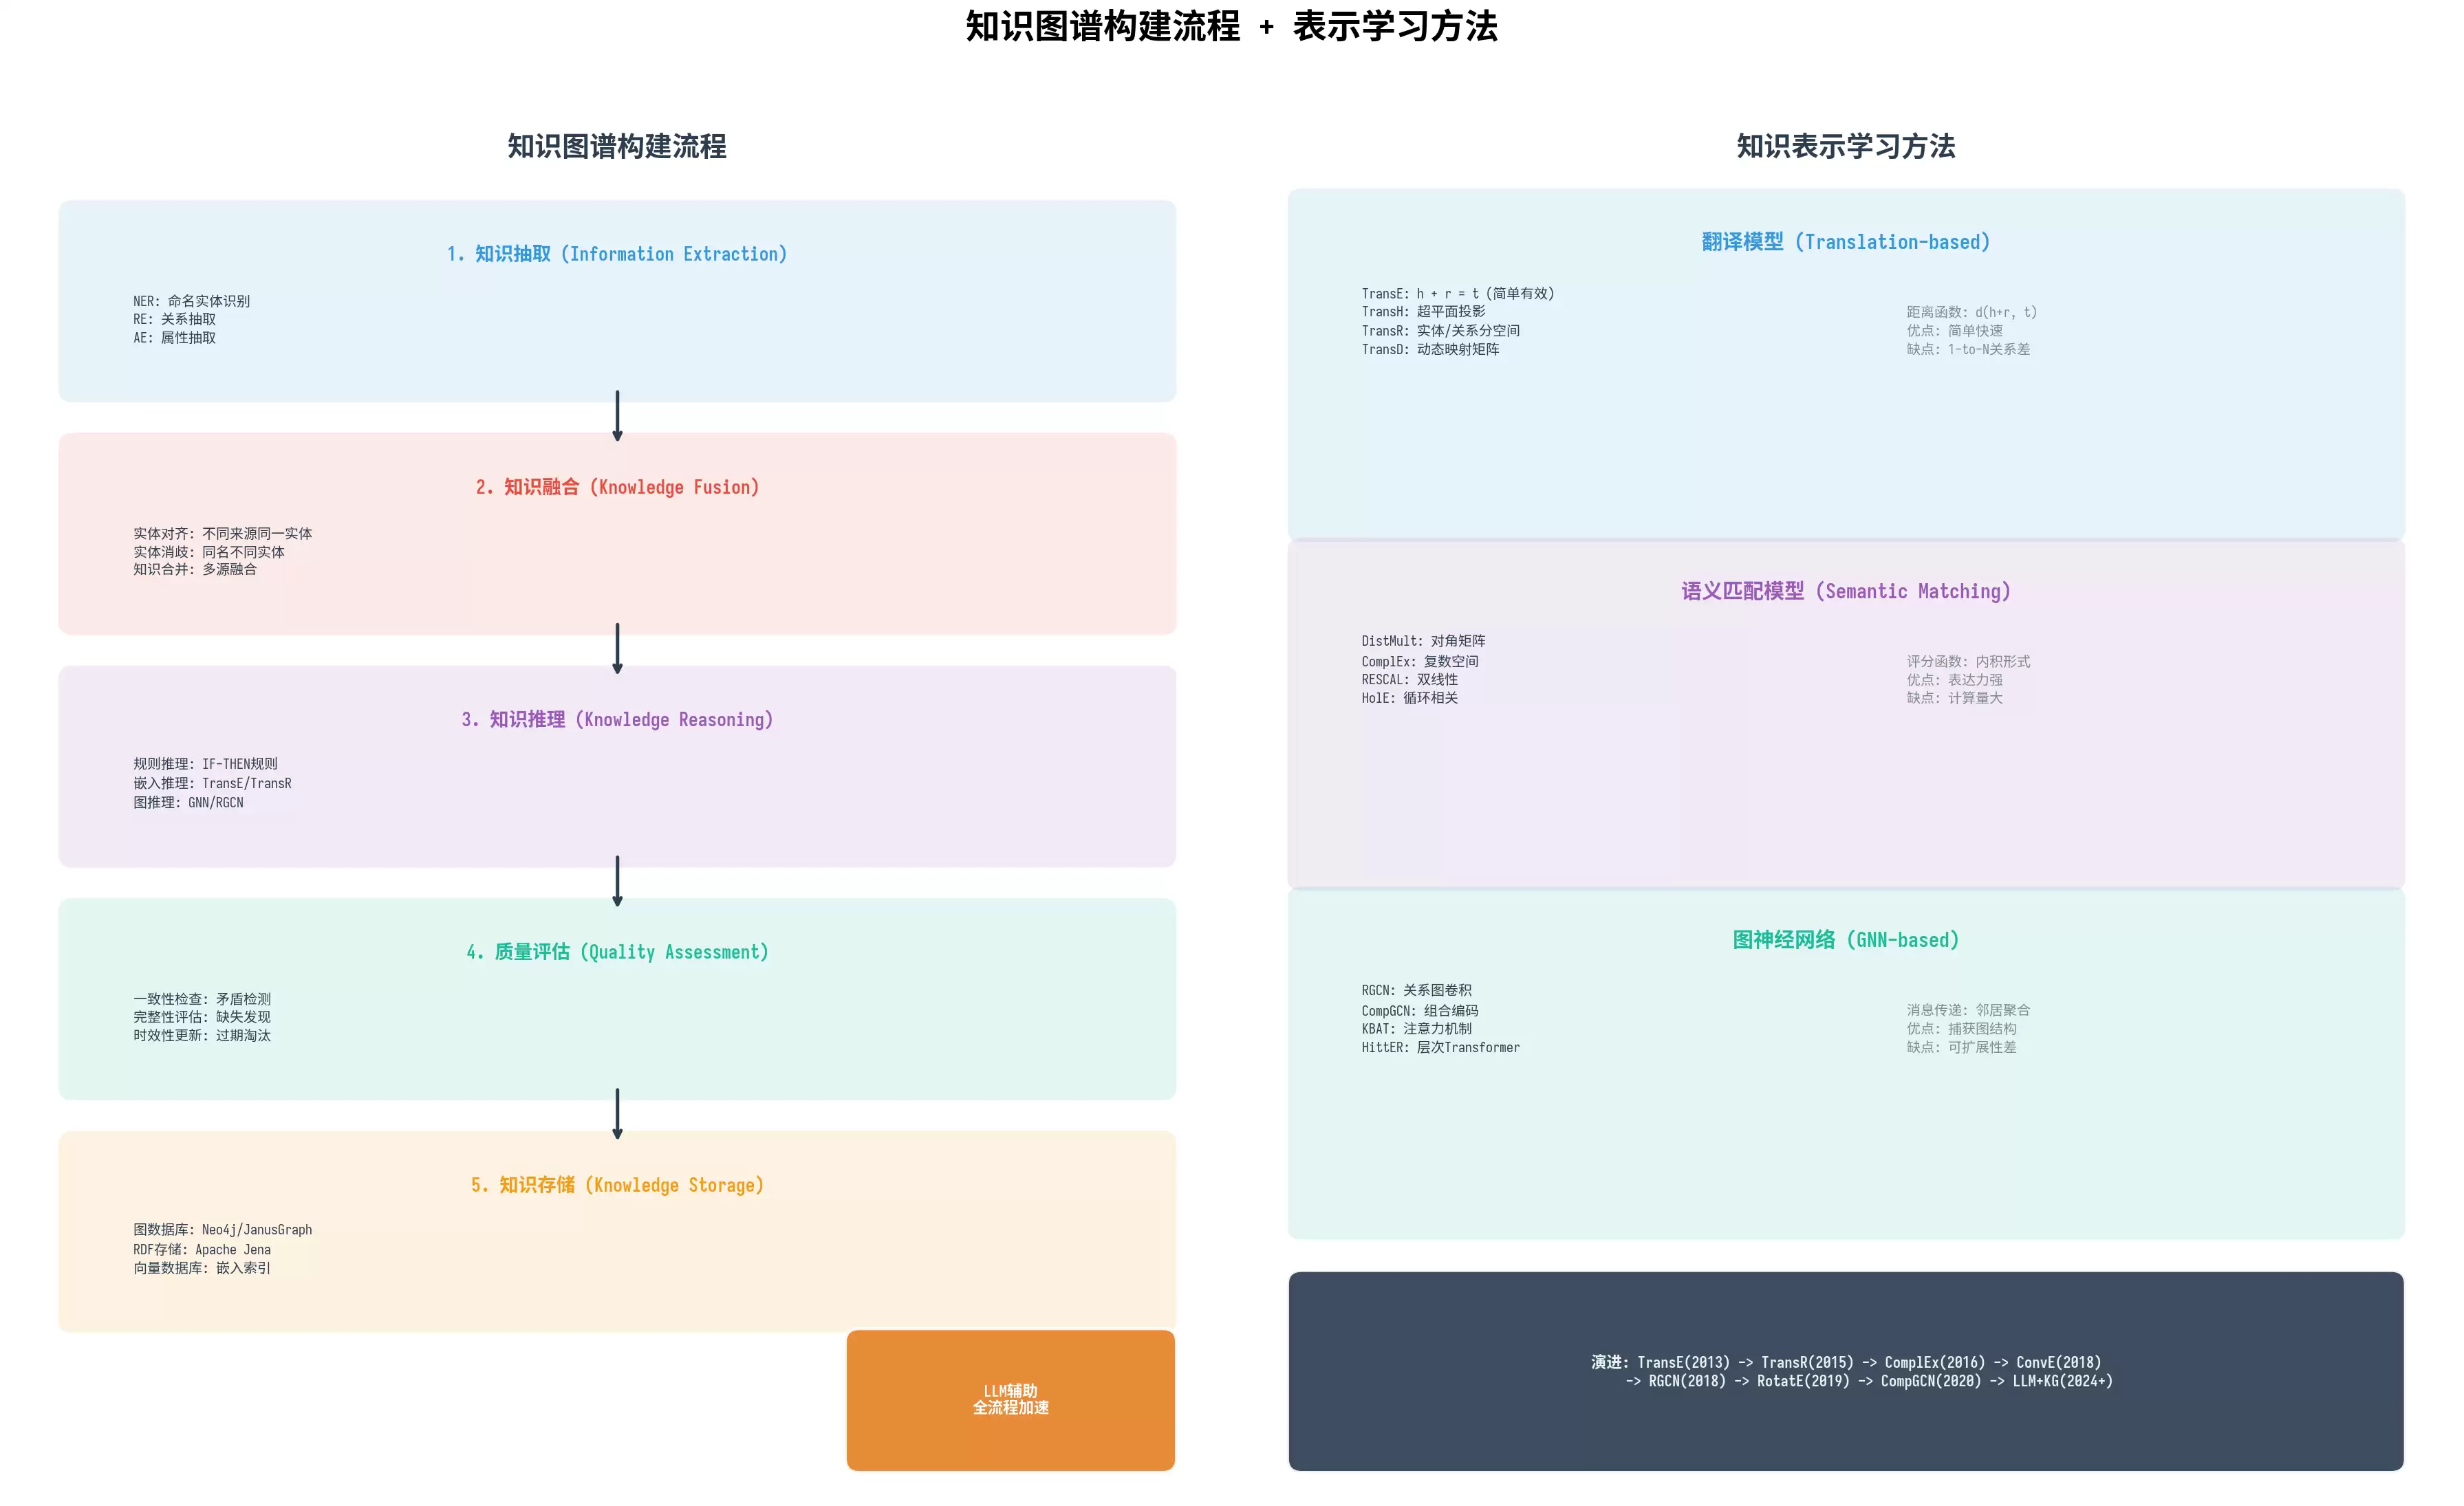
整个流程大致分五步:
- 文档输入:拿到的是一堆非结构化文本。
- LLM知识抽取:从中识别实体、抽取关系,转成三元组存入Neo4j。
- 查询处理:用户问问题,先做实体链接,定位关键实体。
- 图谱检索:结合Cypher查询、向量搜索和PCST算法,返回最相关的子图。
- LLM生成:把子图和原始问题送给大模型,产出精准答案,推理路径全程可追溯。
7.3 GraphRAG代码实战
from langchain.chat_models import ChatOpenAI
from langchain.graphs import Neo4jGraph
from langchain.chains import GraphCypherQAChain

graph = Neo4jGraph(url="bolt://localhost:7687", username="neo4j", password="password")

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
chain = GraphCypherQAChain.from_llm(
    llm=llm,
    graph=graph,
    verbose=True,
    return_intermediate_steps=True
)

result = chain.invoke("DeepSeek的技术基础是谁提出的?")
print(result['result'])
# "Google"
print(result['intermediate_steps'])
# DeepSeek -> DEVELOPS -> LLM -> BASED_ON -> Transformer -> PROPOSED_BY -> Google
7.4 GraphRAG与向量RAG对比
| 维度 | 向量RAG | GraphRAG |
|---|---|---|
| 检索方式 | 语义相似度 | 图遍历 + 语义搜索 |
| 多跳推理 | 差 | 强 |
| 关联发现 | 无 | 路径查询 |
| 可解释性 | 黑箱 | 路径可追溯 |
| 幻觉率 | 高 | 低 |
| 构建成本 | 低 | 高(需构建图谱) |
| 适用场景 | 简单问答 | 复杂推理/关联分析 |
八、知识图谱四大应用场景
8.1 智能问答(KBQA)
从知识图谱里直接找答案,支持各种类型的问题:简单问题单跳就能搞定,复杂问题需要多跳推理,聚合问题则需要聚合查询。
8.2 推荐系统
知识图谱给推荐系统带来了三个明显改善:冷启动阶段可以用图谱属性做推荐,可解释性上推荐路径直观可追溯,而且沿图谱路径探索能有效避免推荐同质化。
8.3 风控与反欺诈
金融风控本质上就是关联分析。知识图谱在这方面优势明显:能发现隐蔽的关联链路,用社区检测算法识别欺诈团伙,还能通过异常模式检测发现异常资金流向。
8.4 GraphRAG(图谱增强生成)
这是2026年最火的应用方向。核心是用知识图谱来给LLM做事实校准,确保生成前先查图谱;多跳推理方面,图谱能搞定向量检索做不了的关联推理;而且每一步推理都有图结构支撑,可解释性极强。
九、知识图谱面试高频问题
Q1:知识图谱和关系数据库的本质区别?
三个维度:一是关系表示,数据库用外键隐式表示,知识图谱用边显式表示;二是查询方式,数据库用JOIN做多表关联,知识图谱用图遍历做多跳查询,更自然;三是推理能力,数据库只能查已有数据,知识图谱能通过规则/嵌入/GNN推导新知识。
Q2:TransE的局限性是什么?怎么解决?
TransE假设h+r=t,处理不了1-to-N关系,比如一个导演拍多部电影,所有电影向量会趋同。解决方案是TransH投影到超平面、TransR映射到关系空间、RotatE用复数旋转,其中RotatE效果最好。
Q3:知识图谱构建中最大的挑战是什么?
三大挑战:知识抽取质量不够高,噪声三元组多;实体对齐难,不同来源的同一实体需要识别和合并;知识更新需求持续。LLM辅助构建是2026年的主流解法,但幻觉问题仍需人工校验。
Q4:GraphRAG和向量RAG怎么选?
简单问答用向量RAG,成本低、构建快;复杂推理用GraphRAG,多跳关联、可解释。实践中可以混合用:向量RAG做初筛,GraphRAG做精排。如果知识之间有大量关联关系——比如法律、医疗、金融领域——GraphRAG优势明显。
Q5:知识图谱和LLM的关系?
互补关系。LLM擅长理解和生成,不擅长事实记忆和多跳推理;知识图谱擅长事实存储和关联推理,但不擅长自然语言理解。2026年的趋势是LLM+KG融合:LLM负责从文本中抽取知识构建图谱,图谱负责为LLM提供事实校准和推理支撑。
十、知识图谱技术总结
知识图谱的精髓可以用一句话概括:用图结构表示知识,从已知推理未知,最终落地到智能应用。
| 概念 | 一句话 | 关键词 |
|---|---|---|
| 知识表示 | 三元组建图,RDF或属性图 | 图结构 |
| 知识构建 | 抽取→融合→推理→评估 | 从文本到图谱 |
| 知识嵌入 | 把图谱变成向量 | TransE/RotatE |
| 知识推理 | 从已知推导未知 | 规则/嵌入/GNN |
| 知识查询 | Cypher/SPARQL | 图遍历 |
| GraphRAG | LLM+知识图谱 | 减少幻觉 |
最后记住一条:知识图谱不是数据库的升级版,而是AI从“语言理解”到“知识推理”的关键基础设施。大模型给了AI理解力,知识图谱给了AI事实力——两者结合,才是真正可信赖的AI。