

DeepSeek本地部署硬件配置指南
DeepSeek-R1模型本地部署的硬件需求差异显著:1.5B版本仅需普通电脑,适合个人学习;7B/8B版本需中端显卡,可处理中等任务;14B及以上版本要求专业级硬件,面向企业应用;32B和70B版本成本达数万至数十万元,服务于专业机构;顶级的671B版本需服务器集群,成本极高,仅适用于前沿科研。选择时需在任务需求、性能与预算间取。
这个春节,AI领域的热门话题无疑是DeepSeek-R1。这款通过强化学习技术显著提升复杂推理能力的高性能模型,展现了巨大的潜力。然而,当技术爱好者们准备尝试本地部署时,现实的门槛便清晰显现——尤其是那个拥有671B参数的完整版本。
不同规模的模型,对应着差异巨大的硬件需求和适用场景。下表可以帮助你快速建立整体了解:
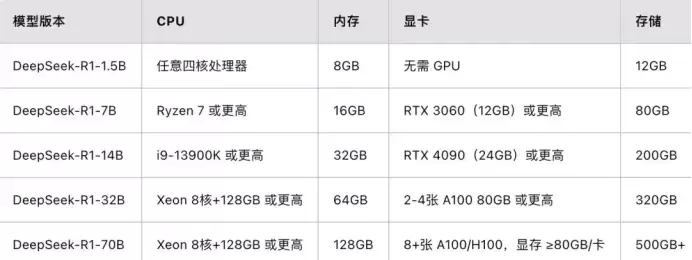
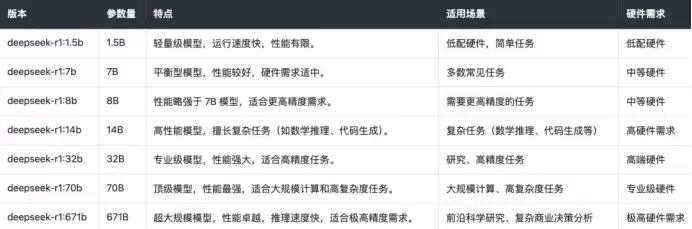
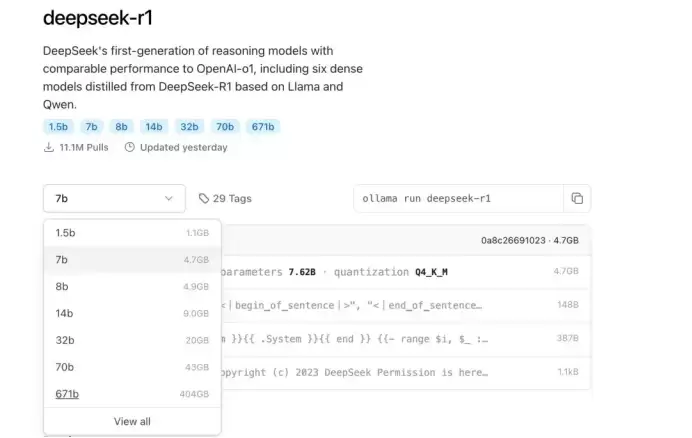
首先来看位于“天花板”级别的671B版本。部署它需要一个服务器集群:至少64核CPU、512GB内存、300GB硬盘是基础,还需搭配多节点分布式训练(例如8张A100或H100显卡),以及支持整套系统的高功率电源和散热方案。这显然属于大型研究机构或企业的范畴。
那么,从个人用户到企业,各个版本的实际部署门槛究竟如何?我们来逐一分析。
小型模型:个人体验的起点
DeepSeek-R1-1.5B可以视为最易上手的入口。最低仅需4核CPU、8GB内存和256GB硬盘,无需独立显卡,纯CPU即可进行推理。配合Ollama等工具,在个人电脑上运行并不困难。其定位明确:用于本地测试和学习。整套配置预计花费在2000至5000元之间,对于大多数技术爱好者来说,是触手可及的选择。
中型模型:性能与成本的平衡
当任务复杂度提升时,就需要考虑DeepSeek-R1-7B或8B版本。它们要求8核以上CPU、16GB内存,并推荐配备8GB以上显存的显卡(如RTX 3070或4060)。
7B版本适合处理文本摘要、翻译、轻量级对话等中等复杂度的自然语言任务;8B版本则在代码生成、逻辑推理等需要更高精度的场景中表现更好。这两个版本的预计费用在5000到10000元区间,对于有明确开发需求的个人或小团队而言,是值得考虑的投入。
大型模型:企业级应用的门槛
从这里开始,便逐步进入专业领域。DeepSeek-R1-14B模型需要12核以上CPU、32GB内存,以及至少16GB显存的显卡(如RTX 4090)。它能胜任企业级的长文本理解与生成任务,但预计2万到3万元的费用,已超出普通个人用户的常规预算。
至于DeepSeek-R1-32B,则要求16核CPU、64GB内存和24GB以上的显存(例如A100 40GB或双RTX 3090)。它面向高精度专业任务,如多模态任务预处理。4万到10万元的预算,决定了其仅为资金充裕的企业或研究机构所用。
超大型模型:科研与行业巨头的领域
最后的两个版本,清晰地划定了技术应用的边界。DeepSeek-R1-70B需要32核CPU、128GB内存,并通过多卡并行(如2张A100 80GB或4张RTX 4090)来驱动,适用于高复杂度生成任务,预计费用40万元以上。这通常是大型企业或科研机构考虑的方向。
而顶点的DeepSeek-R1-671B,如前所述,其硬件配置及动辄上千万元的投入,已成为超大规模AI研究或通用人工智能探索的专属,是投资者和顶尖实验室需要评估的命题。
由此可见,从1.5B到671B,DeepSeek-R1系列覆盖了一条从个人实验到前沿科研的广阔光谱。选择哪个版本,本质上是在任务需求、性能预期和硬件预算之间寻找最切实的平衡点。