

SQL递归查询操作方法详解
处理层级数据时,递归公用表表达式提供了一种高效方案。通过定义包含锚点成员和递归成员的CTE,可逐级遍历数据并标记层级。该方法适用于组织架构、树形分类等场景,以声明式语法简化查询,提升效率。
处理层级数据,比如组织架构或者分类树,是数据库应用里一个挺常见的需求。你可能会想到用多次自连接,但那样写起来又长又笨,而且层级一深就没办法了。好在,现代主流数据库都提供了更优雅的解决方案:递归公用表表达式(Recursive CTE)。今天,我们就用一个经典的公司员工层级表为例,把它的用法和原理彻底讲清楚。
数据表定义:
我们先来定义一下这个场景。假设有一张员工表,核心是记录每个人的上级是谁。
CREATE TABLE employees (
    id INT PRIMARY KEY,
    name VARCHAR(50),
    manager_id INT  -- 指向上级,CEO的manager_id为NULL(或0,通常用NULL表示无上级)
);
初始化数据:
为了演示,我们插入一些有层级关系的数据。结构很简单:马总是顶层,张工和王工向他汇报,李工向张工汇报,赵工和刘工再向李工汇报。
INSERT INTO `employees` (`id`, `name`, `manager_id`) VALUES (101, '马总', NULL);
INSERT INTO `employees` (`id`, `name`, `manager_id`) VALUES (201, '张工', 101);
INSERT INTO `employees` (`id`, `name`, `manager_id`) VALUES (202, '王工', 101);
INSERT INTO `employees` (`id`, `name`, `manager_id`) VALUES (301, '李工', 201);
INSERT INTO `employees` (`id`, `name`, `manager_id`) VALUES (401, '赵工', 301);
INSERT INTO `employees` (`id`, `name`, `manager_id`) VALUES (402, '刘工', 301);
查询需求:
现在,问题来了:如何查询出id=101的人员(马总)及其所有的下级信息(包括间接下级),同时还要清晰地标记出每个下属所处的层级?比如,直接下属层级为1,下属的下属层级为2,以此类推。
查询语句(MySQL 8.0+):
这正是递归CTE大显身手的地方。下面这条SQL语句,就能完美解决这个问题。注意,这里以MySQL 8.0+的语法为例,其他数据库(如PostgreSQL, SQL Server)的写法也大同小异。
WITH RECURSIVE subordinates AS (
    -- 初始查询:找到起点(id = 101)
    SELECT
        id,
        name,
        manager_id,
        0 AS level
    FROM employees
    WHERE id = 101
    UNION ALL
    -- 递归查询:逐级向下查找
    SELECT
        e.id,
        e.name,
        e.manager_id,
        s.level + 1
    FROM employees e
    INNER JOIN subordinates s ON e.manager_id = s.id
)
SELECT *
FROM subordinates
ORDER BY level, id;
执行结果:
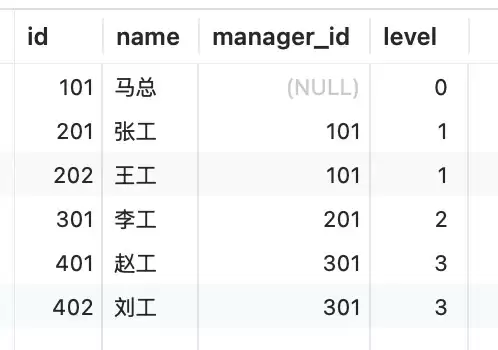
语法解释:
看到上面那段带着WITH RECURSIVE的SQL,是不是觉得既强大又有点神秘?别急,我们来把它拆解开,一步步看明白。
WITH RECURSIVE subordinates AS (...) 这整句,就是在定义一个递归公用表表达式。你可以把它想象成一个临时的、可以自我引用的视图,专门用来处理这种“一层套一层”的数据。
1. WITH与RECURSIVE关键字
WITH:用来声明一个公用表表达式(CTE),目的是让复杂查询变得更清晰、更模块化。RECURSIVE:这是关键,它告诉数据库:“我这个CTE要引用自己,实现循环迭代。”在MySQL里必须明确写出来,其他一些数据库可能语法略有不同。
2. 递归CTE的两部分结构
递归CTE的核心在于,它由两部分通过UNION ALL连接而成:
(1) 锚点成员:递归的起点
SELECT id, name, manager_id, 0 AS level
FROM employees
WHERE id = 101
这部分是非递归的,只执行一次。它的作用就是找到我们查询的“根节点”——id为101的马总,并设定其层级为0。这个结果集构成了递归迭代的初始数据。
(2) 递归成员:迭代的核心
SELECT e.id, e.name, e.manager_id, s.level + 1
FROM employees e
INNER JOIN subordinates s ON e.manager_id = s.id
这部分是递归的,它会反复执行。每次执行时,它都把上一轮迭代得到的subordinates结果集(作为上级s)和原始的employees表(作为下级e)进行连接,条件是e.manager_id = s.id。这样就能找到上一级的所有直接下级。同时,将层级level加1,表示深度增加了一层。新找到的记录会被添加到subordinates中,并用于下一次迭代。
(3) 终止条件
递归不会无限进行下去。当某一次递归成员执行后,没有产生任何新的行(即找不到更多下级了),递归就会自动停止。这里有个重要前提:数据中不能有循环引用(比如A的管理者是B,B的管理者又是A),否则会陷入死循环。好在多数数据库都有默认的递归深度限制来防止这种情况。
3. 示例执行流程
光说理论可能有点抽象,我们结合数据,把上面的查询过程推演一遍:
- 第一步(锚点):找到id=101的记录,得到结果 (101, ‘马总’, NULL, level=0)。
- 第二步(第一次递归):用上级id=101去找下级,找到manager_id=101的记录,即(201, ‘张工’)和(202, ‘王工’),层级level=0+1=1。
- 第三步(第二次递归):用上级id=201和202去找下级。用id=201找到下级301(李工),层级level=1+1=2。id=202没有下级。
- 第四步(第三次递归):用上级id=301去找下级,找到401(赵工)和402(刘工),层级level=2+1=3。
- 第五步(第四次递归):用上级id=401和402去找下级,都没有找到。递归终止。
最终,subordinates这个临时结果集就包含了从101开始的所有层级员工及其对应层级。外层的SELECT只是把它按层级和ID排序后展示出来。
适用场景
掌握了递归CTE,你就能轻松应对多种层级或图状数据查询:
- 组织架构遍历:查询某个领导的所有汇报线,就像本文例子。
- 物料清单(BOM)展开:查询一个产品所需的所有子组件和原材料。
- 树形结构:如多级评论回复、商品分类导航的完整路径查询。
- 图数据查询:查找社交网络中的朋友关系链,或者路径规划。
总而言之,WITH RECURSIVE是SQL标准中处理递归查询的利器。相比传统的游标或复杂脚本,它用声明式的语法清晰地表达了层次关系,不仅代码更简洁,执行效率也往往更高,是现代SQL工程师必备的技能之一。