

阿里达摩院RLVR新作突破推理同质化实现有效探索
阿里达摩院针对强化学习可验证奖励范式中的推理同质化问题,提出IB-LPO框架。该框架通过识别高熵关键节点,向模型潜在表示空间注入可控分支,引导其进行有效探索,避免无效采样与奖励作弊,从而在有限预算内提升大模型推理性能。
在提升大语言模型推理能力的过程中,基于可验证奖励的强化学习已成为关键范式。其核心思路是让模型针对同一问题生成多条推理路径,随后依据奖励信号强化正确思路并抑制错误思路,类似于学生通过撰写多份解题草稿来学习最优解法。
然而,这种方法存在效率瓶颈。一个常见疑问是:增加采样路径数量是否总能获得更优解法?实际情况往往相反,这源于强化学习中的经典“探索-利用”困境。模型需要在“利用”现有高概率得分路径与“探索”新可能性之间取得平衡。当前采样机制常不自觉地偏向“利用”端,使模型迅速收敛至少数看似稳妥的推理模板,导致生成路径虽措辞不同,底层逻辑却高度同质。这种同质化使得额外采样难以提供有效的学习信号。
那么,如何引导模型进行更高效、更有价值的探索?关键在于利用“不确定性”。
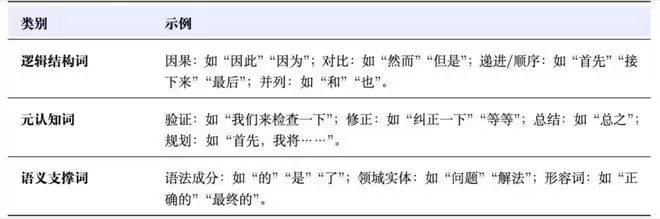
表 1: 高熵 Token 类别示例
熵作为衡量模型生成下一个词时不确定性的指标,可视为探索潜力的风向标。实验表明,策略熵较高的位置通常对应逻辑转折、步骤跳跃或模型自我纠错(如表1所示),这些节点正是决定推理方向的“十字路口”。
识别关键节点仅是第一步,真正的挑战在于如何在此施加有效影响,引导模型走向不同的探索分支,避免原地打转或误入歧途。
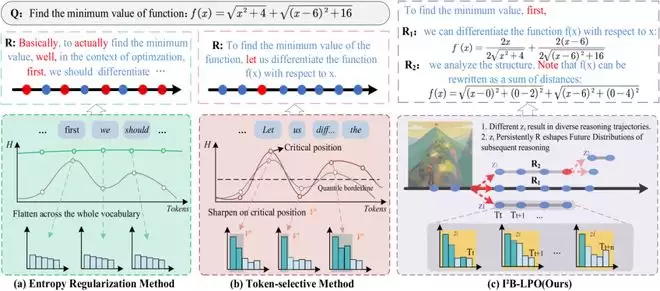
图 1:RLVR 中不同探索范式的对比(a)Sequence-level 的整体正则化方法通过全局平滑 token 分布来提高熵,但容易让模型生成冗长、重复或与解题无关的内容,形成 “高熵但低信息量” 的无效探索。(b)token-level 的概率扰动方法则只在局部高熵 token 上调整概率,往往只能带来连接词、同义词或表层表达的变化,也难以突破预训练模型已有的推理偏好来持续改变后续推理方向。
现有基于熵的探索方法主要面临两大问题(如图1所示):一是“奖励作弊”,即模型为迎合熵奖励而生成冗长、重复或无意义的文本,导致探索流于形式;二是难以打破“归纳偏置”,仅在词汇层面进行概率扰动无法改变模型预训练形成的深层推理偏好,使探索停留在表面。
为突破这些限制,我们提出了 IB-LPO 框架。其核心思想是:在识别出的高熵关键节点,不简单扰动词表概率,而是向模型的潜在表示空间注入可控分支,相当于在推理岔路口提供内在逻辑不同的“路标”。同时,引入反馈机制自动过滤冗长或无意义的探索路径,确保探索质量。该方法旨在有限推理预算内实现更高效探索,从而进一步提升大模型推理性能。
论文标题:IB-LPO: Latent Policy Optimization via Iterative Information Bottleneck论文链接:https://arxiv.org/pdf/2601.05870开源链接:https://github.com/denghuilin-cyber/IIB-LPO