

国产内存新架构问世:30TBs带宽超越HBM,摆脱国外供应链依赖
AI需求重心转移:从训练到推理,内存架构成新挑战 AI的需求重心正在从训练转向推理,一个关键的转变随之而来:算力本身不再是唯一的瓶颈,内存的“墙”却越垒越高。如何构建高带宽、低延迟的内存架构,成了整个行业必须攻克的挑战。而最近,国内公司在架构创新上交出了一份令人瞩目的答卷。 紫光发布“紫弦”三维近存
AI需求重心转移:从训练到推理,内存架构成新挑战
AI的需求重心正在从训练转向推理,一个关键的转变随之而来:算力本身不再是唯一的瓶颈,内存的“墙”却越垒越高。如何构建高带宽、低延迟的内存架构,成了整个行业必须攻克的挑战。而最近,国内公司在架构创新上交出了一份令人瞩目的答卷。
紫光发布“紫弦”三维近存计算架构,带宽达30TB/s
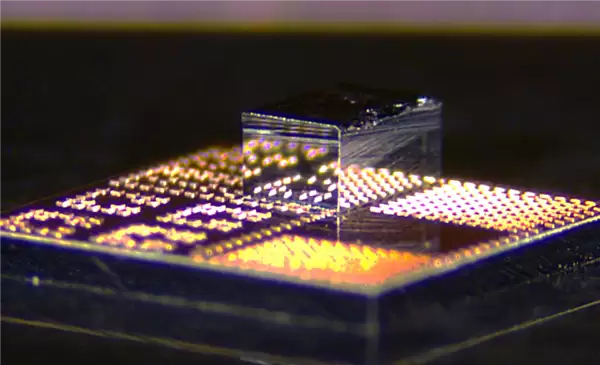
新紫光集团日前正式发布了名为“紫弦”的三维化近存计算架构。这套方案的核心,是围绕3D DRAM进行构建,并首创了所谓的“3.5D异质异构集成”方案。其最炸裂的参数,是存储带宽达到了惊人的30TB/s。
30TB/s带宽是什么概念?对比HBM3e与B200 GPU
这个数字是什么概念?不妨做个对比。目前AMD和NVIDIA高端芯片采用的HBM3e内存,单颗带宽大约在1.2TB/s。即便是英伟达最新的B200 GPU,其总带宽也“仅”为8TB/s。紫弦架构的30TB/s带宽,可以说实现了数量级上的跨越,优势相当明显。
低延迟与高性能表现:访存延迟降低18倍,吞吐率领先
高带宽之外,低延迟是另一个杀手锏。在PNM近存计算模式下,该架构的访存延迟最大可以降低18倍。这意味着数据不用再“长途跋涉”,计算单元能更快地拿到所需信息,效率自然大幅提升。
性能究竟如何?根据官方公布的模拟仿真数据,在同等算力条件下,紫弦架构的Token吞吐率,相比NVIDIA的B200系列,要高出1.5到2倍以上。这不仅仅是纸面参数的领先,更是实际效能的有力证明。
技术可落地性与战略意义:具备量产能力,不依赖国外供应链
当然,任何前沿技术都面临一个灵魂拷问:能落地吗?对此,新紫光给出了明确的肯定。他们强调,这项技术并非实验室里的“盆景”,而是具备了规模化量产的能力。更关键的一点在于,其技术路径并不依赖国外供应链,而是基于国内领先的产业链构建而成。这在当前的地缘技术格局下,无疑增添了一层特殊的战略意义。
未来展望:架构创新引领差异化AI算力发展路径
当然,具体的量产上市时间表尚未公布。但这项技术的亮相本身,已经传递出一个清晰的信号:在先进制程可能受限的背景下,通过极致的架构与集成技术创新,完全有可能走出一条差异化的、高性能的AI算力发展路径。未来的竞争,或许不止在晶体管密度上,更在系统级的设计智慧里。