

深入理解JavaScript引擎:从作用域到事件循环
本文深入解析JavaScript引擎的工作机制,涵盖词法作用域、块作用域、调用堆栈及事件循环原理。通过代码示例详解变量提升、闭包实现及异步执行流程,帮助开发者理解JS底层运行逻辑,优化代码性能并规避常见异步陷阱。
JavaScript核心概念解析
在深入探讨之前,先明确几个核心概念。
JS引擎是负责读取并执行代码的程序,并不存在单一的“JS引擎”,每个浏览器都拥有自己的实现,例如谷歌浏览器使用V8引擎。
作用域是指可以访问变量的“区域”。
词法作用域是指在代码编写阶段就确定的作用域,变量和块的作用域位置在词法分析时已固定,因此作用域在编译阶段保持不变。
块作用域是由花括号{}所创建的范围。
作用域链允许函数向其外部环境(词法上)搜索变量,查找过程一直向上延伸,直到到达全局作用域。
同步意味着一次只执行一件事,同步引擎逐行执行代码,JavaScript默认是同步执行的。
异步涉及同时处理多个任务,JavaScript通过浏览器API来模拟异步行为。
事件循环(Event Loop)是浏览器API完成函数调用后,将回调函数推送到回调队列(callback queue),并在调用堆栈为空时将回调函数推入调用堆栈的过程。
堆栈是一种数据结构,只能将元素推入并弹出顶部元素,类似于叠放字形的塔楼,不能删除中间的块,遵循后进先出原则。
堆用于存储变量,即变量存储在内存中。
调用堆栈是函数调用的队列,实现了堆栈数据类型,意味着一次只能运行一个函数。调用函数会将其推入堆栈,函数返回则将其弹出堆栈。
执行上下文是当函数被放入调用堆栈时由JavaScript创建的环境。
闭包是指当在另一个函数内部创建一个函数时,该内部函数“记住”了它在创建时所处的环境,以便在后续调用时使用。
垃圾收集是指当内存中的变量不再被使用时,JavaScript引擎会自动删除这些变量以释放内存。
变量提升是指当变量声明但未赋值时,其内存会被提升到全局顶部并初始化为undefined。
this是由JavaScript为每个新的执行上下文自动创建的关键字或变量。
调用堆栈与执行上下文
调用堆栈(Call Stack)是管理函数执行顺序的关键机制。
观察以下代码示例:
var myOtherVar = 10
function a() {
console.log('myVar', myVar)
b()
}
function b() {
console.log('myOtherVar', myOtherVar)
c()
}
function c() {
console.log('Hello world!')
}
a()
var myVar = 5
有几个关键点需要注意:
- 变量声明的位置不同,一个在上方,一个在下方。
- 函数a调用了下方定义的函数b,而函数b又调用了函数c。
当执行这段代码时,你期望发生什么?是否会因为b在a之后声明而报错,或者一切正常?console.log打印的变量结果又是怎样的?
以下是实际的打印结果:
"myVar" undefined
"myOtherVar" 10
"Hello world!"
接下来分解上述代码的执行步骤。
1. 变量和函数声明(创建阶段)
第一步是在内存中为所有变量和函数分配空间。需要注意的是,除了undefined之外,变量尚未被赋值。因此,当打印myVar时,其值为undefined,因为JavaScript引擎从代码顶部开始逐行执行。
函数与变量不同,函数可以一次性声明并初始化,这意味着它们可以在代码的任何位置被调用。
因此,上述代码在内存中的表现形式大致如下:
var myOtherVar = undefined
var myVar = undefined
function a() {...}
function b() {...}
function c() {...}
这些内容都存在于JavaScript创建的全局上下文中,因为它们位于全局空间内。
在全局上下文中,JavaScript还添加了以下内容:
- 全局对象(在浏览器中是window对象,在Node.js中是global对象)。
- this指向全局对象。
2. 执行阶段
接下来,JavaScript引擎会逐行执行代码。
在全局上下文中,myOtherVar被赋值为10。
所有函数已创建,下一步是执行函数a()。
每次调用函数时,都会为该函数创建一个新的上下文(重复步骤1),并将其放入调用堆栈。
function a() {
console.log('myVar', myVar)
b()
}
具体步骤如下:
- 创建新的函数上下文。
- 函数a内部没有声明变量和函数。
- 函数内部创建了this,并指向全局对象(window)。
- 接着引用了外部变量myVar,myVar属于全局作用域。
- 接着调用函数b,函数b的过程与a类似,此处不再赘述。
以下是调用堆栈的执行示意图:
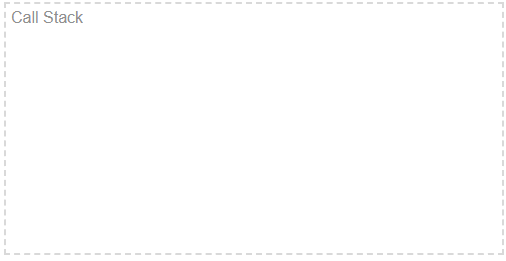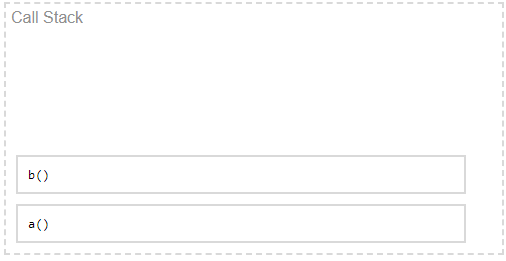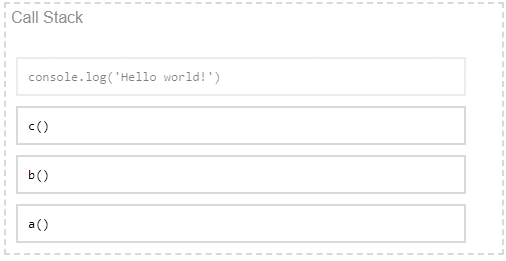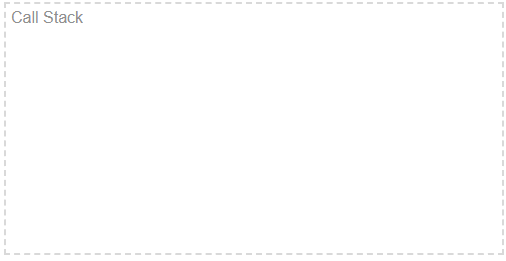
- 创建全局上下文,包含全局变量和函数。
- 每次函数调用都会创建一个上下文,包含外部环境的引用及this。
- 函数执行结束后会从堆栈中弹出,其执行上下文会被垃圾收集回收(闭包除外)。
- 当调用堆栈为空时,系统将从事件队列中获取事件。
作用域与词法作用域链
作用域及作用域链
在前面的示例中,所有内容都属于全局作用域,这意味着我们可以从代码的任何位置访问它们。现在,我们来介绍私有作用域以及如何定义作用域。
函数/词法作用域
考虑以下代码:
function a() {
var myOtherVar = 'inside A'
b()
}
function b() {
var myVar = 'inside B'
console.log('myOtherVar:', myOtherVar)
function c() {
console.log('myVar:', myVar)
}
c()
}
var myOtherVar = 'global otherVar'
var myVar = 'global myVar'
a()
需要注意以下几点:
- 全局作用域和函数内部都声明了变量。
- 函数c现在是在函数b中声明的。
打印结果如下:
myOtherVar: "global otherVar"
myVar: "inside B"
执行步骤:
- 全局创建和声明:创建内存中的所有函数和变量,以及全局对象和this。
- 执行:逐行读取代码,给变量赋值,并执行函数a。
- 函数a创建一个新的上下文并被放入堆栈,在上下文中创建变量myOtherVar,然后调用函数b。
- 函数b也会创建一个新的上下文,同样被放入堆栈中。
- 在函数b的上下文中创建了myVar变量,并声明了函数c。
前面提到每个新上下文会创建外部引用,外部引用取决于函数在代码中声明的位置。
- 函数b试图打印myOtherVar,但该变量不存在于函数b中,因此函数b会利用其外部引用,沿着作用域链向上查找。由于函数b是在全局声明的,而不是在函数a内部声明的,所以它使用全局变量myOtherVar。
- 函数c的执行步骤类似。由于函数c本身没有变量myVar,它通过作用域链向上查找,即函数b,因为myVar是在函数b内部声明的。
以下是执行示意图:
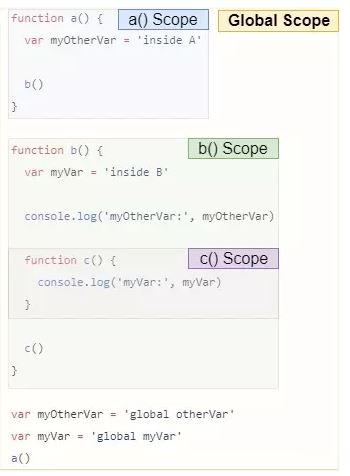
请记住,外部引用是单向的,它不是双向关系。例如,函数b不能直接跳到函数c的上下文中并从那里获取变量。
最好将其视为一个只能在一个方向上运行的链(作用域链)。
- a -> global
- c -> b -> global
在上面的图中,你可能注意到,函数是创建新作用域的一种方式(除了全局作用域)。然而,还有另一种创建新作用域的方法,即块作用域。
块作用域与变量声明
块作用域
在下面的代码中,我们有两个变量和两个循环,如果在循环中重新声明相同的变量,会打印什么(反正我是做错了)?
function loopScope () {
var i = 50
var j = 99
for (var i = 0; i < 10; i++) {}
console.log('i =', i)
for (let j = 0; j < 10; j++) {}
console.log('j =', j)
}
loopScope()
打印结果:
i = 10
j = 99
第一个循环覆盖了var i,对于不了解这一点的开发人员来说,这可能会导致bug。
第二个循环中,每次迭代都创建了自己的作用域和变量。这是因为它使用了let关键字,它与var类似,但let拥有自己的块作用域。另一个关键字是const,它与let类似,但const是常量且无法更改(指内存地址)。
块作用域是由大括号{}创建的作用域。
再看一个例子:
function blockScope () {
let a = 5
{
const blockedVar = 'blocked'
var b = 11
a = 9000
}
console.log('a =', a)
console.log('b =', b)
console.log('blockedVar =', blockedVar)
}
blockScope()
打印结果:
a = 9000
b = 11
ReferenceError: blockedVar is not defined- a是块作用域,但它在函数中,而不是嵌套的,本例中使用var也是一样的。
- 对于块作用域的变量,其行为类似于函数,注意var b可以在外部访问,但是const blockedVar不能。
- 在块内部,从作用域链向上找到a,并将let a更改为9000。
使用块作用域可以使代码更清晰、更安全,应该尽可能地使用它。
事件循环与异步机制
事件循环(Event Loop)
接下来看看事件循环。这是回调、事件和浏览器API工作的地方。
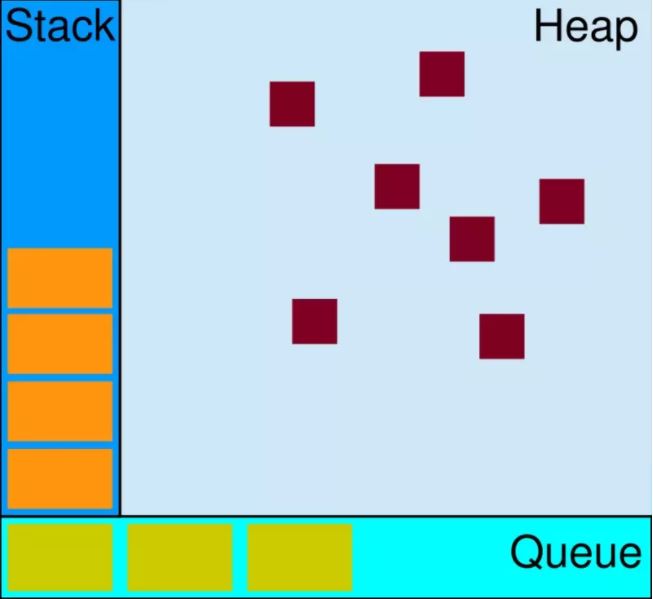
我们没有过多讨论的事情是堆,也叫全局内存。它是变量存储的地方。由于了解JavaScript引擎是如何实现其数据存储的实际用途并不多,所以我们不在这里深入讨论。
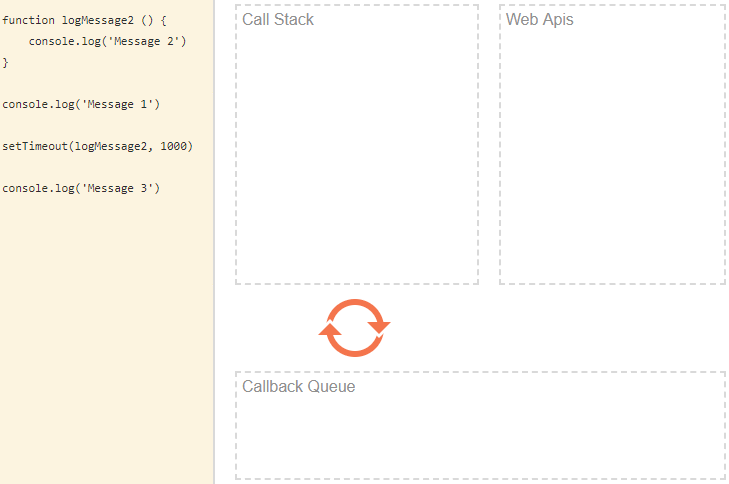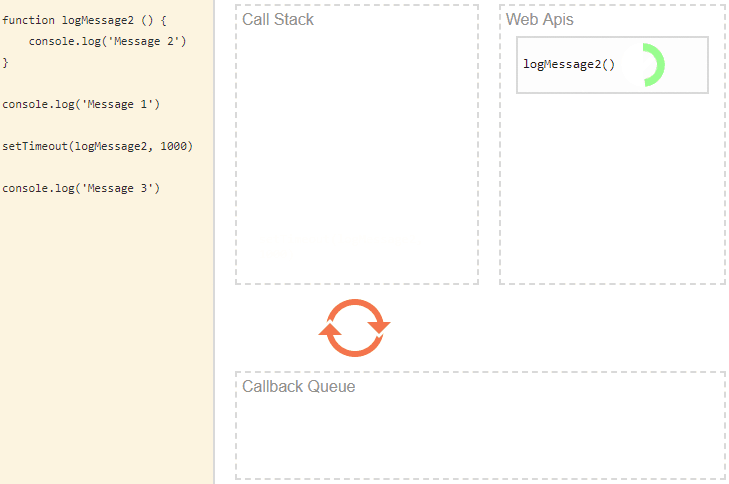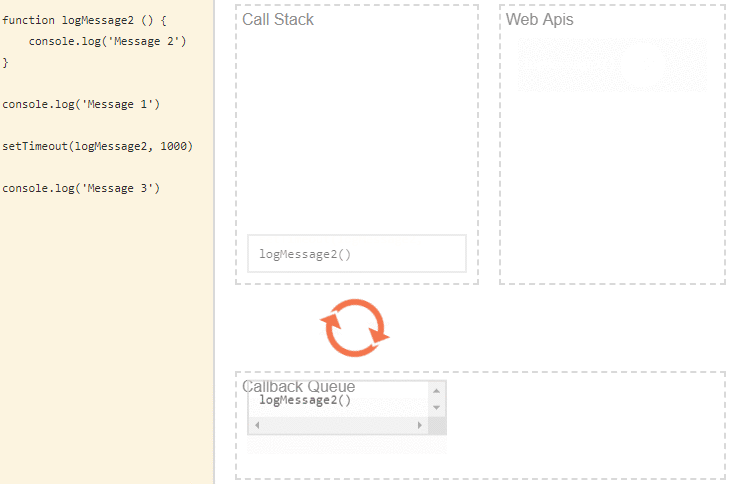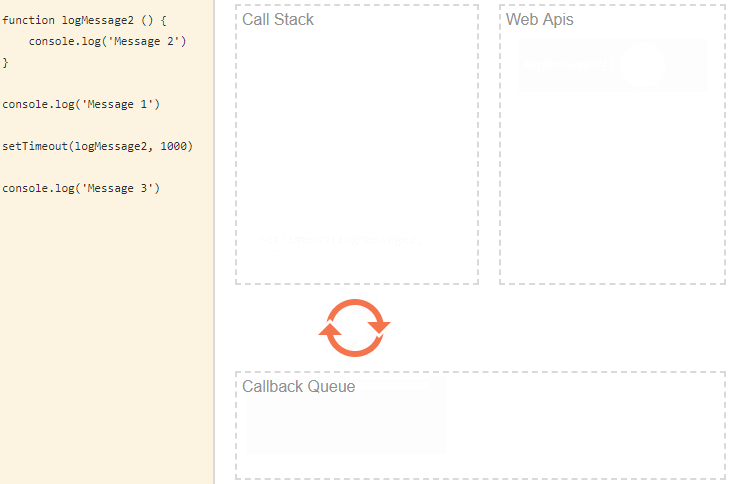
来看一个异步代码示例:
function logMessage2 () {
console.log('Message 2')
}
console.log('Message 1')
setTimeout(logMessage2, 1000)
console.log('Message 3')
上述代码主要是将一些message打印到控制台,利用setTimeout函数来延迟一条消息。我们知道JavaScript是同步的,来看看输出结果。
Message 1
Message 3
Message 2- 打印Message 1
- 调用setTimeout
- 打印Message 3
- 打印Message 2
它首先记录消息3。
稍后,它会记录消息2。
setTimeout是一个API,和大多数浏览器API一样,当它被调用时,它会向浏览器发送一些数据和回调。我们这边是延迟一秒打印Message 2。
调用完setTimeout后,我们的代码继续运行,没有暂停,打印Message 3并执行一些必须先执行的操作。浏览器等待一秒钟,它就会将数据传递给我们的回调函数并将其添加到事件/回调队列(event/callback queue)中。然后停留在
队列中,只有当调用堆栈(call stack)为空时才会被压入堆栈。
闭包与性能优化实践
代码示例
要熟悉JavaScript引擎,最好的方法就是使用它,再来些有意义的例子。
简单的闭包
这个例子中有一个返回函数的函数,并在返回的函数中使用外部的变量,这称为闭包。
function exponent (x) {
return function (y) {
//和math.pow() 或者x的y次方是一样的
return y ** x
}
}
const square = exponent(2)
console.log(square(2), square(3)) // 4, 9
console.log(exponent(3)(2)) // 8
块代码
我们使用无限循环将调用堆栈塞满,会发生什么,回调队列会被阻塞,因为只能在调用堆栈为空时添加回调队列。
function blockingCode() {
const startTime = new Date().getSeconds()
// 延迟函数250毫秒
setTimeout(function() {
const calledAt = new Date().getSeconds()
const diff = calledAt - startTime
// 打印调用此函数所需的时间
console.log(`Callback called after: ${diff} seconds`)
}, 250)
// 用循环阻塞堆栈2秒钟
while(true) {
const currentTime = new Date().getSeconds()
// 2 秒后退出
if(currentTime - startTime >= 2) break
}
}
blockingCode() // 'Callback called after: 2 seconds'
我们试图在250毫秒之后调用一个函数,但因为我们的循环阻塞了堆栈,所花了两秒钟,所以回调函数实际是两秒后才会执行,这是JavaScript应用程序中的常见错误。
setTimeout不能保证在设置的时间之后调用函数。相反,更好的描述是,在至少经过这段时间之后调用这个函数。
延迟函数
当setTimeout设置为0时,情况是怎样的?
function defer () {
setTimeout(() => console.log('timeout with 0 delay!'), 0)
console.log('after timeout')
console.log('last log')
}
defer()
你可能期望它被立即调用,但是,事实并非如此。
执行结果:
after timeout
last log
timeout with 0 delay!
它会立即被推到回调队列,但它仍然会等待调用堆栈为空才会执行。
用闭包来缓存
Memoization是缓存函数调用结果的过程。
例如,有一个添加两个数字的函数add。调用add(1,2)返回3,当再次使用相同的参数add(1,2)调用它时,这次不是重新计算,而是记住1 + 2是3的结果并直接返回对应的结果。Memoization可以提高代码运行速度,是一个很好的工具。我们可以使用闭包实现一个简单的memoize函数。
// 缓存函数,接收一个函数
const memoize = (func) => {
// 缓存对象
// keys 是 arguments, values are results
const cache = {}
// 返回一个新的函数
// it remembers the cache object & func (closure)
// ...args is any number of arguments
return (...args) => {
// 将参数转换为字符串,以便我们可以存储它
const argStr = JSON.stringify(args)
// 如果已经存,则打印
console.log('cache', cache, !!cache[argStr])
cache[argStr] = cache[argStr] || func(...args)
return cache[argStr]
}
}
const add = memoize((a, b) => a + b)
console.log('first add call: ', add(1, 2))
console.log('second add call', add(1, 2))
执行结果:
cache {} false
first add call: 3
cache { '[1,2]': 3 } true
second add call 3
第一次调用add方法时,缓存对象是空的,它调用我们的传入函数来获取值3。然后它将args/value键值对存储在缓存对象中。在第二次调用中,缓存中已经有了,查找到并返回值。
对于add函数来说,有无缓存看起来无关紧要,甚至效率更低,但是对于一些复杂的计算,它可以节省很多时间。这个示例并不是一个完美的缓存示例,而是闭包的实际应用。
代码部署后可能存在的BUG没法实时知道,事后为了解决这些BUG,花了大量的时间进行log调试,这边顺便给大家推荐一个好用的BUG监控工具Fundebug。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值。
D3.js 比例尺与坐标轴的配置详解
2026-11-05 16:54:46
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19