

JavaScript 数据类型存储机制:栈与堆的深度解析
深入解析 JavaScript 中基本数据类型与引用数据类型的内存存储差异。文章详细阐述原始值(如 String、Number)直接存储在栈中,而引用类型(如 Object、Array)在栈中仅保存指向堆内存的指针。通过图解与代码示例,说明变量复制时的行为区别,揭示为何复杂对象需置于堆中以平衡时间与空间效率。
引言:内存管理的重要性
作为非科班出身的开发者,初学编程时往往忽视内存管理等基础概念,导致后续理解“变量存在于栈中,栈内仅存储引用”这类表述时感到困惑。
随着对内存知识了解的深入,这部分内容显得尤为必要。
基本数据结构概述
在探讨 JavaScript 之前,先回顾几种基本数据结构。
栈(Stack)
栈是一种只允许在一端进行插入或删除操作的线性表,遵循先进后出(LIFO)的原则。
堆(Heap)
堆通常基于散列算法构建的数据结构。
队列(Queue)
队列是一种遵循先进先出(FIFO)原则的数据结构。
JavaScript 数据类型的存储机制
在 JavaScript 中,数据类型主要分为基本数据类型和引用数据类型,两者的核心区别之一在于存储位置的不同。
理解这一区别是掌握 JS 内存模型的关键。
基本数据类型
JavaScript 中的基本数据类型包括:
- String(字符串)
- Number(数字)
- Boolean(布尔值)
- Undefined(未定义)
- Null(空值)
- Symbol(符号,暂不深入讨论)
基本数据类型通常表示简单的数据段,它们直接存储在栈内存中。
引用数据类型
JavaScript 中的引用数据类型主要包括:
- Array(数组)
- Object(对象)
引用数据类型的数据实际存储在堆内存中,而栈内存中仅保存一个指向堆内存中实际对象的引用地址。因此,JavaScript 对引用数据类型的操作,本质上是对该对象引用的操作,而非直接操作对象本身。
可以这样理解:栈内存中保存了一个地址,该地址与堆内存中的实际值相关联。
内存存储图解分析
图解分析
让我们通过声明几个变量来观察内存分配情况。
var name="axuebin";
var age=25;
var job;
var arr=[1,2,3];
var obj={age:25};
下图展示了数据类型在内存中的具体存储方式。
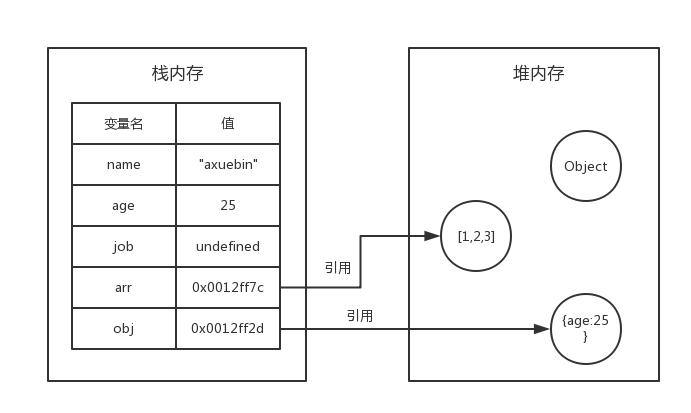
此时,name、age、job 这三种基本数据类型直接存储在栈内存中;而 arr 和 obj 在栈内存中仅存储了一个地址,用于表示对堆内存中实际对象的引用。
变量复制的行为差异
变量复制行为
基本数据类型的复制
对于基本数据类型,执行复制操作时,系统会自动为新的变量在栈内存中分配一个新的值,这一过程直观且易于理解。
引用数据类型的复制
对于数组、对象等引用数据类型,复制行为则有所不同。
系统同样会为新的变量在栈内存中分配一个值,但该值仅是一个地址。这意味着,复制出的变量与原变量拥有相同的地址值,它们共同指向堆内存中的同一个实际对象。
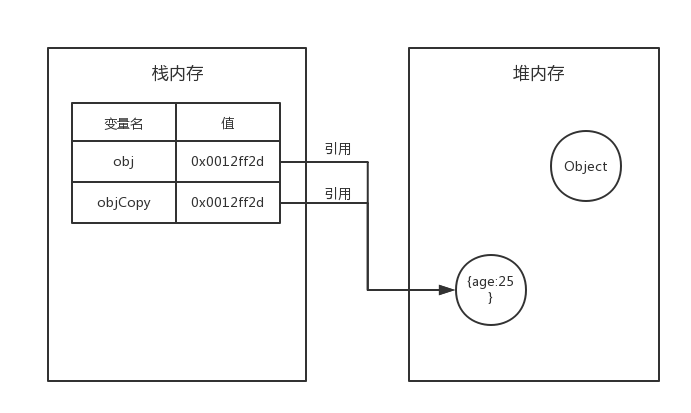
如图所示,执行 var objCopy = obj 后,obj 和 objCopy 具有相同的地址值,指向堆内存中的同一个实际对象。
这种机制带来了什么影响?
当我们修改 obj 或 objCopy 中的任意一个时,另一个变量的值也会随之改变。
为什么会发生这种情况?
栈与堆的设计原理
为什么基本数据类型存储在栈中,而引用数据类型存储在堆中?
- 堆内存容量大于栈内存,但栈内存的访问速度更快。
- 基本数据类型相对稳定,且占用的内存空间较小。
- 引用数据类型的大小是动态的,且理论上可以无限扩展。
- 堆内存采用无序存储方式,可以通过引用直接获取数据。
参考资料与延伸阅读
参考文章
理解 JS 内存分配
原始值与引用值
在 ECMAScript 中,变量可以存放两种类型的值:原始值和引用值。原始值代表基本数据类型(如 Undefined、Null、Number、String、Boolean)的值;引用值则代表复合数据类型(如 Object、Function、Array 及自定义对象等)的值。
栈与堆的对应关系
与原始值和引用值相对应,内存结构分为栈和堆。栈是一种后进先出的数据结构,在 JavaScript 中可以通过 Array 来模拟栈的行为。
原始值存储在栈中,即其值直接存储在变量访问的位置。堆是基于散列算法的数据结构,JavaScript 中的引用值存放在堆中。引用值是存储在堆中的对象,变量处存储的是一个指针,指向堆中的实际对象。
例如:var obj = new Object(); obj 存储在栈中,它指向 new Object() 这个对象,而 new Object() 存放在堆中。既然都在内存中,为何不放在一起?让我们探索答案。
function Person(id,name,age){
this.id = id;
this.name = name;
this.age = age;
}
var num = 10;
var bol = true;
var str = "abc";
var obj = new Object();
var arr = ['a','b','c'];
var person = new Person(100,"笨蛋的座右铭",25);
观察以下代码及其内存分析图。
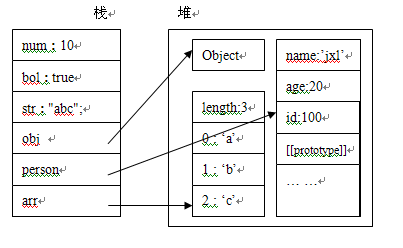
变量 num、bol、str 为基本数据类型,其值直接存放在栈中;obj、person、arr 为复合数据类型,其引用变量存储在栈中,指向堆中的实际对象。
由上图可知,我们无法直接操作堆中的数据,即无法直接操纵对象,但可以通过栈中对对象的引用来操作对象,类似于通过遥控器操作电视机,区别在于电视机本身没有控制按钮。
现在回答为什么引用值放在堆中,而原始值放在栈中。
记住一句话:能量守恒,无非是用时间换空间,或用空间换时间。
堆比栈大,栈的运算速度比堆快。对象结构复杂且可自由扩展(如数组无限扩充、对象自由添加属性),将它们放在堆中是为了不影响栈的效率,通过引用查找堆中实际对象进行操作。相比之下,简单数据类型稳定且占用内存小,若放在堆中,通过引用查找实际对象所花费的时间成本远大于直接从栈中获取值的成本。因此,简单数据类型的值直接存放在栈中。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38