

Node.js 爬虫实战:使用 Superagent 和 Cheerio 抓取博客园数据
本文介绍如何使用 Node.js 结合 Superagent 和 Cheerio 模块编写简易爬虫,抓取博客园首页的文章标题、用户名、阅读数及头像。通过 HTTP 请求、DOM 解析、文件系统操作及流式下载,实现数据保存到本地文本和图片文件,适合初学者学习 Node.js 网络编程与数据处理。
前言与项目概述
前言
此前已了解爬虫技术,近期开始学习 Node.js,并编写了一个爬虫项目(https://github.com/leichangchun/node-crawlers/tree/master/superagent_cheerio_demo)。该程序用于抓取博客园首页的文章标题、用户名、阅读数、推荐数以及用户头像,现对此过程进行简要总结。
本项目主要涉及以下技术点:
1、Node.js 核心模块——文件系统(fs)
2、用于发起 HTTP 请求的第三方模块——superagent
3、用于解析 HTML DOM 的第三方模块——cheerio
各模块的详细讲解及 API 文档请参阅相关官方链接,本示例仅展示基础用法。
环境准备与模块引入
准备工作
使用 npm 管理项目依赖,依赖信息将记录在 package.json 文件中。
//安装用到的第三方模块
cnpm install --save superagent cheerio
在代码中引入所需的功能模块。
//引入第三方模块,superagent用于http请求,cheerio用于解析DOM
const request = require('superagent');
const cheerio = require('cheerio');
const fs = require('fs');
发起请求与页面解析
请求并解析页面内容
若要抓取博客园首页数据,首先需向首页地址发起 HTTP 请求以获取返回的 HTML 源码。此处使用 superagent 进行 HTTP 请求,其基本使用方法如下:
request.get(url)
      .end(error,res){
      //do something
}
向指定的 URL 发起 GET 请求,若请求发生错误,回调函数中会返回 error 参数(无错误时该参数为 null 或 undefined),res 参数则包含返回的数据。
获取 HTML 源码后,需提取目标数据,此时需使用 cheerio 解析 DOM。cheerio 需先加载目标 HTML,再进行解析,其 API 与 jQuery 类似,熟悉 jQuery 者可快速上手。具体代码实例如下:
//目标链接 博客园首页
let targetUrl = 'https://www.cnblogs.com/';
//用来暂时保存解析到的内容和图片地址数据
let content = '';
let imgs = [];
//发起请求
request.get(targetUrl)
    .end( (error,res) => {
      if(error){ //请求出错,打印错误,返回
        console.log(error)
        return;
      }
      // cheerio需要先load html
      let $ = cheerio.load(res.text);
      //抓取需要的数据,each为cheerio提供的方法用来遍历
      $('#post_list .post_item').each( (index,element) => {
        //分析所需要的数据的DOM结构
        //通过选择器定位到目标元素,再获取到数据
        let temp = {
          '标题' : $(element).find('h3 a').text(),
          '作者' : $(element).find('.post_item_foot > a').text(),
          '阅读数' : +$(element).find('.article_view a').text().slice(3,-2),
          '推荐数' : +$(element).find('.diggnum').text()
        }
        //拼接数据
        content += JSON.stringify(temp) + '\n';
        //同样的方式获取图片地址
        if($(element).find('img.pfs').length > 0){
          imgs.push($(element).find('img.pfs').attr('src'));
        }
      });
      //存放数据
      mkdir('./content',saveContent);
      mkdir('./imgs',downloadImg);
    })
数据存储与图片下载
存储数据
上述 DOM 解析后,已拼接出所需信息并获取到图片 URL,接下来进行存储操作:将文本内容保存至指定目录的 txt 文件中,同时将图片下载至指定目录。
首先创建目录,利用 Node.js 核心文件系统模块实现。
//创建目录
function mkdir(_path,callback){
  if(fs.existsSync(_path)){
    console.log(`${_path}目录已存在`)
  }else{
    fs.mkdir(_path,(error)=>{
      if(error){
        return console.log(`创建${_path}目录失败`);
      }
      console.log(`创建${_path}目录成功`)
    })
  }
  callback(); //没有生成指定目录不会执行
}
创建好指定目录后,即可写入数据。由于 txt 文件内容已准备好,可直接调用 writeFile() 方法进行写入。
//将文字内容存入txt文件中
function saveContent() {
  fs.writeFile('./content/content.txt',content.toString());
}
获取到图片链接后,需再次使用 superagent 下载图片至本地。superagent 可直接返回响应流,配合 Node.js 的管道(pipe)功能,即可将图片内容直接写入本地文件。
//下载爬到的图片
function downloadImg() {
  imgs.forEach((imgUrl,index) => {
    //获取图片名
    let imgName = imgUrl.split('/').pop();

    //下载图片存放到指定目录
    let stream = fs.createWriteStream(`./imgs/${imgName}`);
    let req = request.get('https:' + imgUrl); //响应流
    req.pipe(stream);
    console.log(`开始下载图片 https:${imgUrl} --> ./imgs/${imgName}`);
  } )
}
运行效果与总结
效果展示
运行该 demo,观察结果,数据已成功抓取。
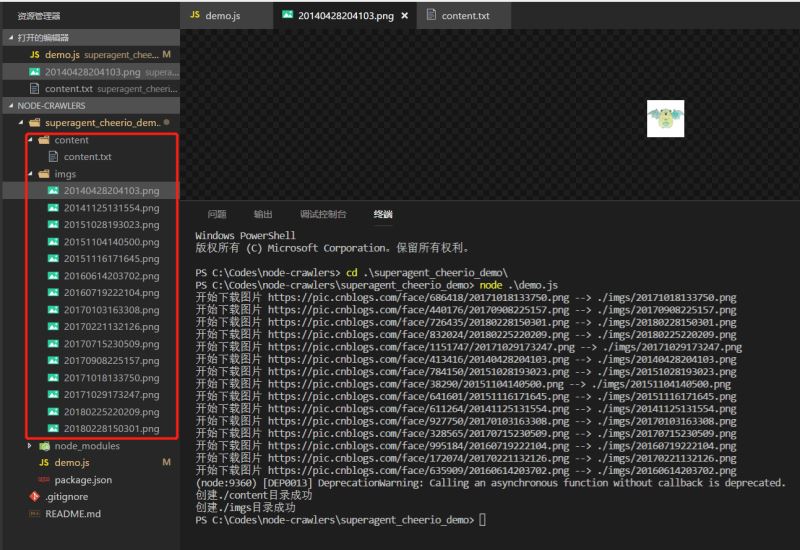
这是一个非常简单的 demo,逻辑可能不够严谨,但标志着 Node.js 学习迈出了第一步。
总结
以上介绍了使用 Node.js 结合 Superagent 和 Cheerio 进行初步爬虫开发的流程,希望对大家有所帮助。如有任何疑问,欢迎留言,作者会及时回复。感谢大家的支持!
Java和JavaScript应用场景对比:企业级后端 vs Web前端与Node.js
2026-11-04 16:42:01
JavaScript模块化开发入门:CommonJS与ES Module的区别
2026-11-03 23:31:34
怎么创建并运行第一个js文件
2026-11-03 21:49:02
JavaScript运行环境怎么搭建?Node.js官方下载与安装教程
2026-11-03 20:03:04
NestJS 集成 TypeORM 或 Prisma 实现数据库持久化操作
2026-11-03 18:56:13