

基于Node.js与JSON的轻量级ORM设计思路
本文探讨在Node.js环境下实现ORM的一种新思路。针对传统ORM以实体类为核心导致的代码冗余与效率问题,提出以关系型数据库字段映射为核心的轻量级方案。通过原生支持JSON的特性,利用运行时动态修改实体属性,避免实体类爆炸,并直接生成SQL语句,提升批量操作效率。
ORM设计背景与现状分析
ORM即对象关系映射,旨在连接面向对象编程与关系型数据库。两者既有共通点也存在差异,这种既相似又不同的特性使得映射机制成为必要。
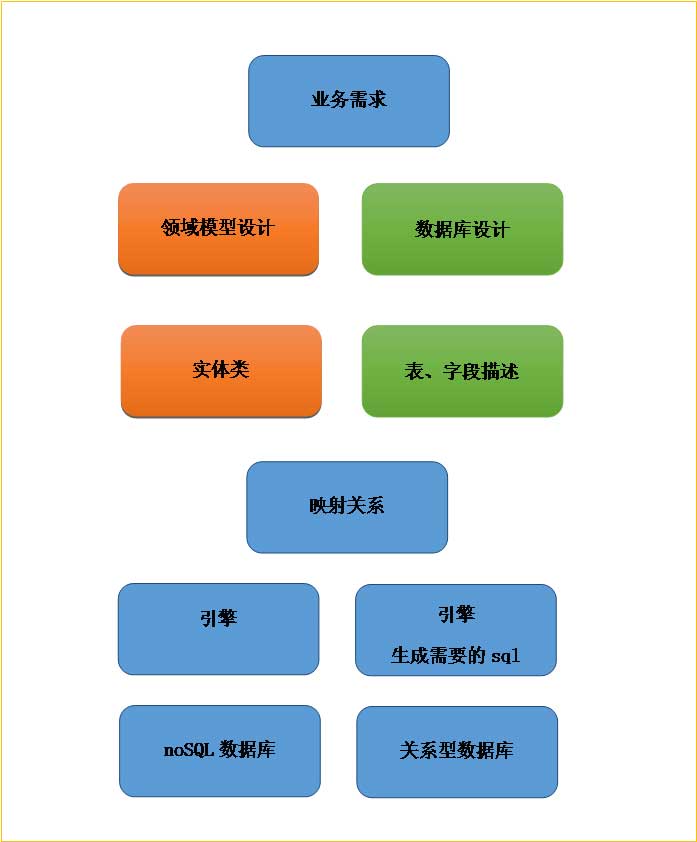
理想的设计流程应基于关系型数据库的业务特点构建数据库结构,同时依据面向对象的需求设计实体模型,最后再处理二者之间的映射。然而,理想与现实往往存在差距,实际开发中很难完全遵循这一完美路径。
目前市面上鲜见完全按照上述理想模式设计的ORM框架,也少见专家采用此种设计方式。那么实际的主流做法如何?以.NET平台下的Entity Framework为例进行说明。
DB First(数据库优先)模式要求先完成数据库设计,随后根据数据库中的表结构、主外键关系自动生成实体类,并可通过LinQToSQL进行数据操作。这种生成的实体类往往缺乏面向对象设计的灵活性与特色。
Code First(代码优先)模式则相反,先定义实体类,再依据实体类及其特性自动生成数据库表、主外键及约束。为确保严谨性,定义实体类时需明确标注具有关系型数据库特征的主外键等信息。
具体结构可参考下图所示示例。
Node.js选型与JSON优势
当前计划使用Node.js构建一套引擎。鉴于刚接触Node.js,不确定是否已有现成的ORM框架及其实现方式,暂不深究现有方案,首要任务是理清自身的实现思路。
选择Node.js的主要原因在于其原生支持JSON格式。JSON在前端开发中占据主导地位,JavaScript原生支持JSON使得前后端交互流畅便捷。然而在后端如C#环境中,JSON仅被视为字符串或需通过实体类序列化,处理过程繁琐且易出错。
采用Node.js后,后端同样可以使用JavaScript编码,从而原生支持JSON处理。这使得前端创建JSON(对应实体模型)后直接提交给后端,后端接收后直接进行安全验证与业务处理,并直接持久化数据,流程更为顺畅。
Node.js的另一优势在于支持在运行时动态定义实体类的属性,例如动态增加属性。这一特性在C#等静态类型语言中难以实现。
支持运行时修改实体类的核心目的在于避免实体类数量的无限膨胀。
回顾现有项目,随着项目规模扩大,定义的实体类数量往往随之激增。当业务需求变更需要为实体类添加属性时,即便有Visual Studio等工具辅助,仍需修改大量代码。
因此,支持在运行时自由修改实体类能极大减少代码修改的工作量,因为动态生成的属性无需预先编写静态代码。
基于JSON的轻量级ORM实现思路
本文主要阐述设计思路,首先通过一个简单的JSON结构示例进行初步设计。
设计该JSON结构的目的是让引擎能够根据JSON内容拼接生成SQL语句,并提交给数据库执行。
{
 "operationMode":"add",// add\update\delete\select
 "tableCount":1, //支持多表的级联添加、修改
 "fieldInfo":[{//主表的字段,参与操作的字段,不参与的不用写。第一个字段是主键(不支持多主键)
 "tableName": "t1", //表名。
 "primaryKey":"id",//主键字段名。我不想把主键字段名限制为必须是“ID”
 "_sqlCache": "" ,//缓存的sql语句,每次都拼接sql也挺烦的,弄个缓存存放拼接好的sql。
 "fieldList":{ //涉及到的字段,并不需要把表里的字段都放进来,根据业务需求设计
   //客户端提交的json与之对应
 "field1Name":"field1Value",
 "field2Name":"field2Value"
 }
 },
 { //从表的字段,可以不设置
 "primaryKey": "id", //主键字段名。我不想把主键字段名限制为必须是“ID”
 "foreignKey": "foreignKeyid", //主键字段名。我不想把主键字段名限制为必须是“ID”
 "_sqlCache": "", //缓存的sql语句,每次都拼接sql也挺烦的,弄个缓存存放拼接好的sql。
 "fieldList": { //涉及到的字段(不含外键字段),并不需要把表里的字段都放进来,根据业务需求设计
   //客户端提交的json与之对应
 "field1Name": "field1Value",
 "field2Name": "field2Value"
 }
 } // 从表的字段,参与操作的字段,不参与的不用写。第一个字段是主键,第二个字段是外键
 ],
 "findCol":[{
 "colName":"col1",
 "key1":"abc",
 "key2":"abc", //范围查询时使用,比如从几号到几号
 "findKind":" {colName} like {key}" //查询方式:like、not Like、in、=、between等
 }]
}
传统ORM通常以实体类为核心,要求实体类的完整性,即一个实体类需完整映射一个数据库表。例如,下架商品时,常规做法是从数据库读取商品实例,修改标记属性(字段),再将整个实体类持久化保存。
然而,此类操作仅需执行一条UPDATE语句,无需先读取数据,传统方式反而造成不必要的性能损耗。
若需将某分类下所有商品下架,须先提取该分类内全部商品,随后批量修改其属性值,最后执行批量持久化操作。
若直接编写SQL语句,只需调整查询条件,无需加载数据对象,执行效率显著高于传统ORM方式。
本文提出的思路并非以面向对象为核心,而是以关系型数据库为核心。
这意味着不将实体类与表进行整体映射,而是将实体类的属性与数据库字段进行映射。即从表中提取部分字段构建一个轻量级实体类进行操作,以下架商品为例进行说明。
涉及的数据表为商品表。
需要更新的字段为isxiajia,设值为1。
查询条件可根据需求设定,如id=1用于单商品下架,cate=2用于按分类下架。
引擎根据上述信息生成相应的UPDATE语句并执行。
这是一个独立的轻量级实体类,无需包含商品的其他无关属性,仅服务于下架操作。查询条件也不局限于ID,可基于其他字段(如分类字段)进行查询,从而显著提升操作效率。
总结
以上介绍了基于Node.js实现ORM的一种设计思路,希望能对读者有所启发。如有任何疑问,欢迎留言交流,小编将及时回复。感谢大家对本站的支持!
Java和JavaScript应用场景对比:企业级后端 vs Web前端与Node.js
2026-11-04 16:42:01
JavaScript模块化开发入门:CommonJS与ES Module的区别
2026-11-03 23:31:34
怎么创建并运行第一个js文件
2026-11-03 21:49:02
JavaScript运行环境怎么搭建?Node.js官方下载与安装教程
2026-11-03 20:03:04
NestJS 集成 TypeORM 或 Prisma 实现数据库持久化操作
2026-11-03 18:56:13