

Node.js 使用 nodejieba 进行文本分词与关键词提取实战
本文介绍如何在 Node.js 环境中使用 nodejieba 库进行中文文本分词和关键词抽取。通过加载自定义用户词典调整权重,并结合白名单过滤机制,实现针对特定业务场景(如文章 Tag 自动生成)的精准关键词提取,提升内容处理的规范性与效率。
在深入技术细节之前,先轻松一下。
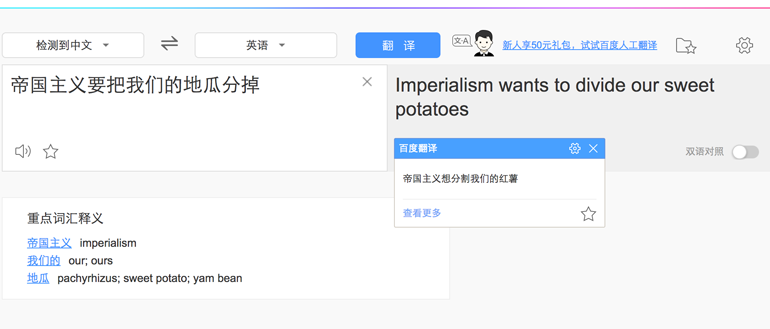
Node.js 文本分词与关键词提取背景
众成翻译平台的文章包含标签(tag)字段,用户可据此快速筛选感兴趣的内容,系统也能依据标签关联进行文章推荐。然而,目前这些标签仅在推荐环节设置,且全为英文。人工设定标签往往存在不规范和不完整的问题。尽管文章发布后支持手动编辑,但无法期望用户或管理员能随时维护出精准的标签。因此,我们需要借助自动化工具来生成标签。
在现有的开源分词工具中,jieba 是一款功能强大且性能优异的分词组件。幸运的是,它提供了 Node.js 版本。
nodejieba 安装与自定义词典配置
nodejieba 的安装与使用过程非常简便:
我们可以加载自定义词典,并在词典中为每个词指定权重和词性:
编辑 user.utf8 文件,内容示例如下:\n地瓜 9999 n\n金箍 9999 n\n棒就棒在 9999\n随后通过 nodejieba.load 方法加载该字典。
关键词提取与白名单过滤实战
除了分词功能,我们还可以利用 nodejieba 提取关键词:
const content = `HTTP、HTTP/2与性能优化
本文旨在通过对比分析,阐述为何应从 HTTP 迁移至 HTTPS,以及为何应支持 HTTP/2。在对比 HTTP 与 HTTP/2 之前,先了解 HTTP 的基本概念。
什么是HTTP
HTTP 是万维网通信的一组规则。作为应用层协议,它运行在 TCP/IP 层之上。当用户通过浏览器请求网页时,HTTP 负责处理请求并在 Web 服务器与客户端之间建立连接。
引入 HTTP/2 后,即使不使用雪碧图、压缩或拼接技术,也能提升性能。但这并不意味着这些技术不再适用。这清楚地表明了我们从 HTTP/1.1 迁移到 HTTP/2 的必要性。\n`;
const nodejieba = require("nodejieba");
const result = nodejieba.extract(content, 20);
console.log(result);
输出结果大致如下:
[ { word: 'HTTP', weight: 140.8704516850025 },
 { word: '请求', weight: 14.23018001394 },
 { word: '应该', weight: 14.052171126120001 },
 { word: '万维网', weight: 12.2912397395 },
 { word: 'TCP', weight: 11.739204307083542 },
 { word: '1.1', weight: 11.739204307083542 },
 { word: 'Web', weight: 11.739204307083542 },
 { word: '雪碧图', weight: 11.739204307083542 },
 { word: 'HTTPS', weight: 11.739204307083542 },
 { word: 'IP', weight: 11.739204307083542 },
 { word: '应用层', weight: 11.2616203224 },
 { word: '客户端', weight: 11.1926274509 },
 { word: '浏览器', weight: 10.8561552143 },
 { word: '拼接', weight: 9.85762638414 },
 { word: '比较', weight: 9.5435285574 },
 { word: '网页', weight: 9.53122979951 },
 { word: '服务器', weight: 9.41204128224 },
 { word: '使用', weight: 9.03259988558 },
 { word: '必要性', weight: 8.81927328699 },
 { word: '添加', weight: 8.0484751722 } ]
我们在字典中添加一些新的关键词:
性能\nHTTP/2
输出结果如下:
[ { word: 'HTTP', weight: 105.65283876375187 },
 { word: 'HTTP/2', weight: 58.69602153541771 },
 { word: '请求', weight: 14.23018001394 },
 { word: '应该', weight: 14.052171126120001 },
 { word: '性能', weight: 12.61259281884 },
 { word: '万维网', weight: 12.2912397395 },
 { word: 'IP', weight: 11.739204307083542 },
 { word: 'HTTPS', weight: 11.739204307083542 },
 { word: '1.1', weight: 11.739204307083542 },
 { word: 'TCP', weight: 11.739204307083542 },
 { word: 'Web', weight: 11.739204307083542 },
 { word: '雪碧图', weight: 11.739204307083542 },
 { word: '应用层', weight: 11.2616203224 },
 { word: '客户端', weight: 11.1926274509 },
 { word: '浏览器', weight: 10.8561552143 },
 { word: '拼接', weight: 9.85762638414 },
 { word: '比较', weight: 9.5435285574 },
 { word: '网页', weight: 9.53122979951 },
 { word: '服务器', weight: 9.41204128224 },
 { word: '使用', weight: 9.03259988558 } ]
在此基础上,我们采用白名单方式过滤出可作为 tag 的词汇:
const content = `HTTP、HTTP/2与性能优化
本文旨在通过对比分析,阐述为何应从 HTTP 迁移至 HTTPS,以及为何应支持 HTTP/2。在对比 HTTP 与 HTTP/2 之前,先了解 HTTP 的基本概念。
什么是HTTP
HTTP 是万维网通信的一组规则。作为应用层协议,它运行在 TCP/IP 层之上。当用户通过浏览器请求网页时,HTTP 负责处理请求并在 Web 服务器与客户端之间建立连接。
引入 HTTP/2 后,即使不使用雪碧图、压缩或拼接技术,也能提升性能。但这并不意味着这些技术不再适用。这清楚地表明了我们从 HTTP/1.1 迁移到 HTTP/2 的必要性。\n`;
const nodejieba = require("nodejieba");
nodejieba.load({
 userDict: './user.utf8',
});
const result = nodejieba.extract(content, 20);
const tagList = ['HTTPS', 'HTTP', 'HTTP/2', 'Web', '浏览器', '性能'];
console.log(result.filter(item => tagList.indexOf(item.word) >= 0));
最终得到:
[ { word: 'HTTP', weight: 105.65283876375187 },
 { word: 'HTTP/2', weight: 58.69602153541771 },
 { word: '性能', weight: 12.61259281884 },
 { word: 'HTTPS', weight: 11.739204307083542 },
 { word: 'Web', weight: 11.739204307083542 },
 { word: '浏览器', weight: 10.8561552143 } ]
这就是我们期望的结果。
以上介绍了分词库 nodejieba 的基本使用方法。未来,我们可以利用它对众成翻译发布的译文进行自动分析并添加相应 tag,从而为译者和读者提供更优质的用户体验。
以上是关于使用 Node.js 对文本内容进行分词和关键词抽取的介绍,希望对大家有所帮助。如有任何疑问,请留言,小编会及时回复。在此感谢大家对本站的支持!
Java和JavaScript应用场景对比:企业级后端 vs Web前端与Node.js
2026-11-04 16:42:01
JavaScript模块化开发入门:CommonJS与ES Module的区别
2026-11-03 23:31:34
怎么创建并运行第一个js文件
2026-11-03 21:49:02
JavaScript运行环境怎么搭建?Node.js官方下载与安装教程
2026-11-03 20:03:04
NestJS 集成 TypeORM 或 Prisma 实现数据库持久化操作
2026-11-03 18:56:13