

JS数组基础取值:索引访问与解构赋值用法
系统解析JavaScript数组取值的两大基础核心途径:基于下标偏移量的索引访问与基于模式匹配的ES6解构赋值。涵盖语法细节、越界处理、默认值机制及二者关键差异与选型指南。
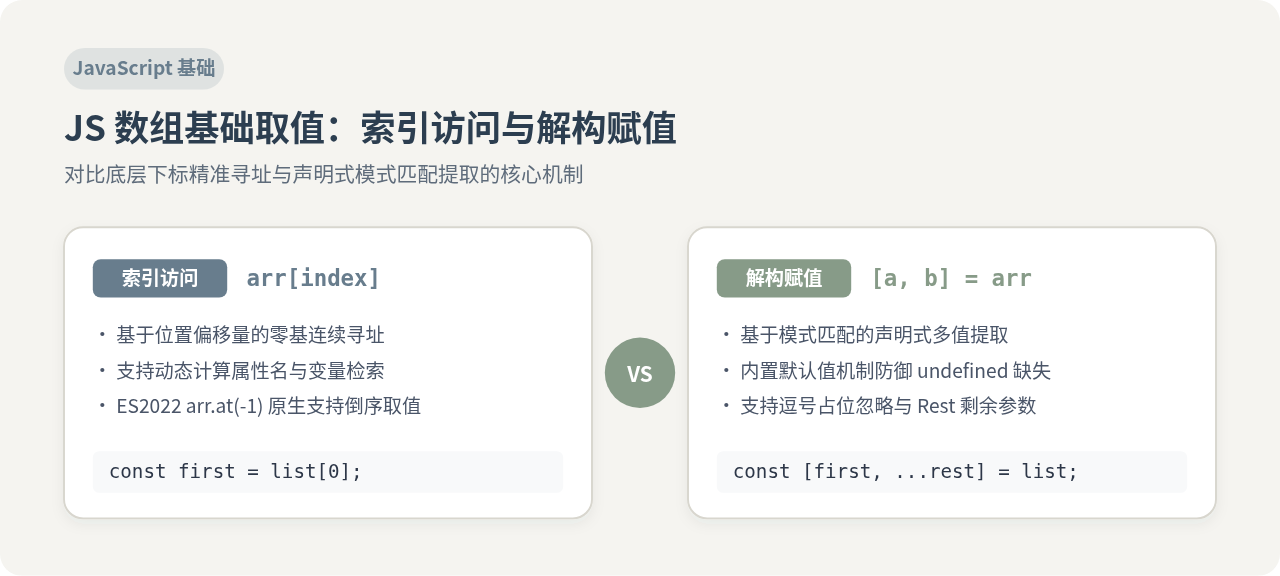
一、基于数字索引的数组取值
JavaScript 数组在本质上是特殊的对象,其属性名被规范化为从 0 开始的非负整数。通过下标访问元素是语言中最原始、执行开销最低的寻址方式。
1. 零基正向索引基础用法
访问数组元素的基本语法为 array[index]。因为索引以 0 为起始基数,数组中第 1 个元素的索引为 0,第 N 个元素的索引则为 N - 1。这种方括号语法不仅接受整数字面量,还允许传入任意计算结果为非负整数或能转为字符串的表达式。
const fruits = ['苹果', '香蕉', '橙子', '葡萄'];

// 1. 常规索引读取首项与中间项
const firstItem = fruits[0];  // 示例输出: '苹果'
const secondItem = fruits[1]; // 示例输出: '香蕉'

// 2. 使用变量或动态表达式读取
let targetIndex = 2;
const selected = fruits[targetIndex]; // 示例输出: '橙子'
2. 末尾取值与 ES2022 的 at() 方法
在传统的 JavaScript 中,如果需要读取数组的末尾元素,开发者通常必须依赖数组长度进行减法计算,即 fruits[fruits.length - 1]。这种写法虽然常见,但在数组表达式较长时容易产生重复引用。
ECMAScript 2022 正式引入了 Array.prototype.at() 方法,允许传入负整数作为参数。传入 -1 表示倒数第 1 个元素,-2 表示倒数第 2 个元素,在语义上极大简化了反向寻址的代码表达。
// 传统写法:借助 length 计算下标
const lastItemOld = fruits[fruits.length - 1]; // 示例输出: '葡萄'

// ES2022 标准写法:负向索引直接取值
const lastItem = fruits.at(-1);     // 示例输出: '葡萄'
const penultimate = fruits.at(-2);  // 示例输出: '橙子'
3. 下标越界的静默行为
与其他严格类型语言(如 Java 或 C# 会直接抛出越界异常 IndexOutOfBoundsException)不同,JavaScript 在索引越界时采取静默策略。当访问一个超出当前数组长度的索引时,引擎不会中断程序,而是返回 undefined。
// 越界访问不会报错,直接返回 undefined
const outOfBound = fruits[100];
console.log(outOfBound); // 示例输出: undefined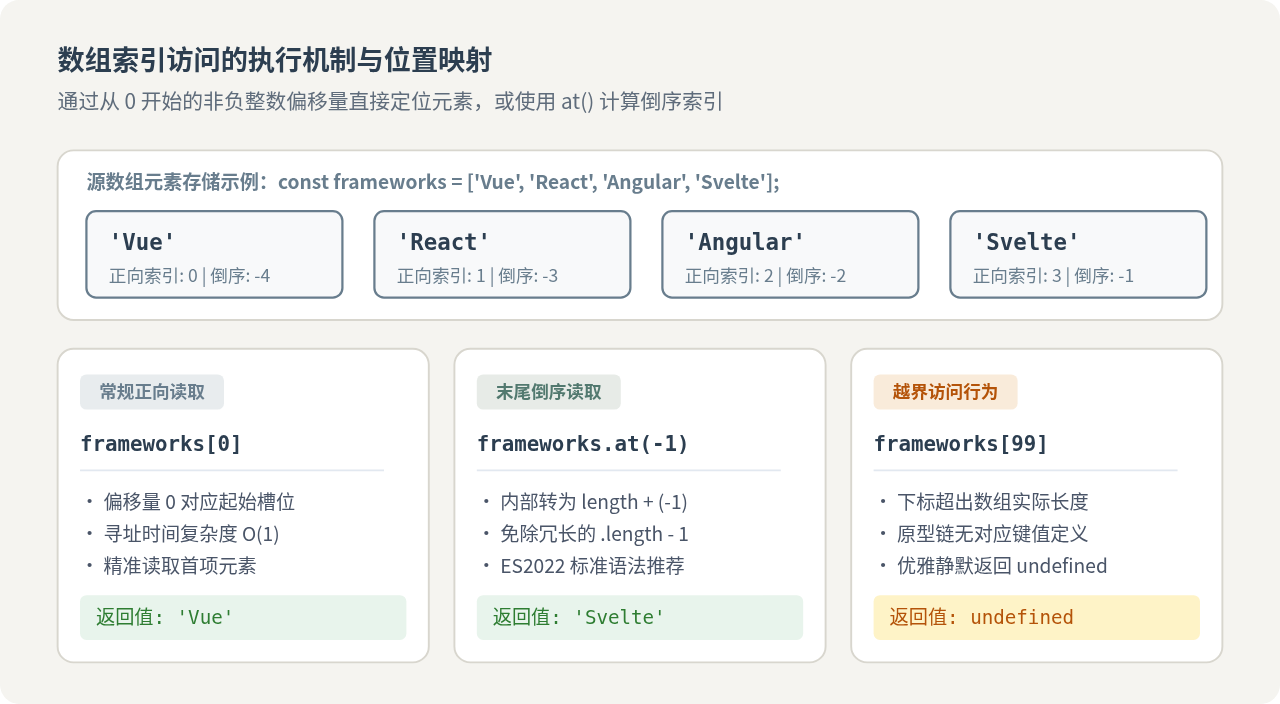
二、基于 ES6 解构赋值的模式匹配取值
ECMAScript 6 (ES2015) 引入了解构赋值语法(Destructuring Assignment)。它允许我们按照数组内部的元素排布模式,将数组中的数据直接“解开”并快速映射到对应的独立变量上。
1. 模式匹配与变量声明
解构赋值通过在赋值操作符左侧书写方括号 [var1, var2, ...] 来建立模式映射。引擎会按从左到右的位置顺序依次遍历数组,并将提取到的值绑定给对应的变量。
const coordinates = [120.19, 30.26, 15.5];

// 一步声明并提取前两项元素
const [longitude, latitude] = coordinates;
console.log(longitude); // 示例输出: 120.19
console.log(latitude);  // 示例输出: 30.26
2. 逗号占位跳过不需要的项
解构赋值并不要求提取数组中的每一个元素。如果中间某几个位置的数据不需要使用,可以在解构模式中直接保留逗号 , 占位,而不填写变量名。被跳过的位置不会分配任何内存变量。
const colors = ['红色', '绿色', '蓝色', '黄色'];

// 提取第 1 项和第 3 项,跳过第 2 项
const [primaryColor, , secondaryColor] = colors;
console.log(primaryColor);   // 示例输出: '红色'
console.log(secondaryColor); // 示例输出: '蓝色'
3. 默认值兜底机制
解构赋值允许为变量设置默认值,语法为 [var = defaultValue]。这是解构赋值相对于索引访问的一大关键优势:
undefined(包括因索引越界未定义、空槽位、或显式存储了 undefined)时,默认值才会生效。如果对应项是 null、0、false 或空字符串 "",默认值都不会被触发。
const config = ['https://api.example.com'];

// timeout 设置默认值 5000
const [apiUrl, timeout = 5000] = config;
console.log(apiUrl);  // 示例输出: 'https://api.example.com'
console.log(timeout); // 示例输出: 5000 (因为原数组缺少第 2 项)

// 严格匹配测试:null 不会触发默认值
const [val = 100] = [null];
console.log(val); // 示例输出: null
4. 结合剩余参数(Rest Element)
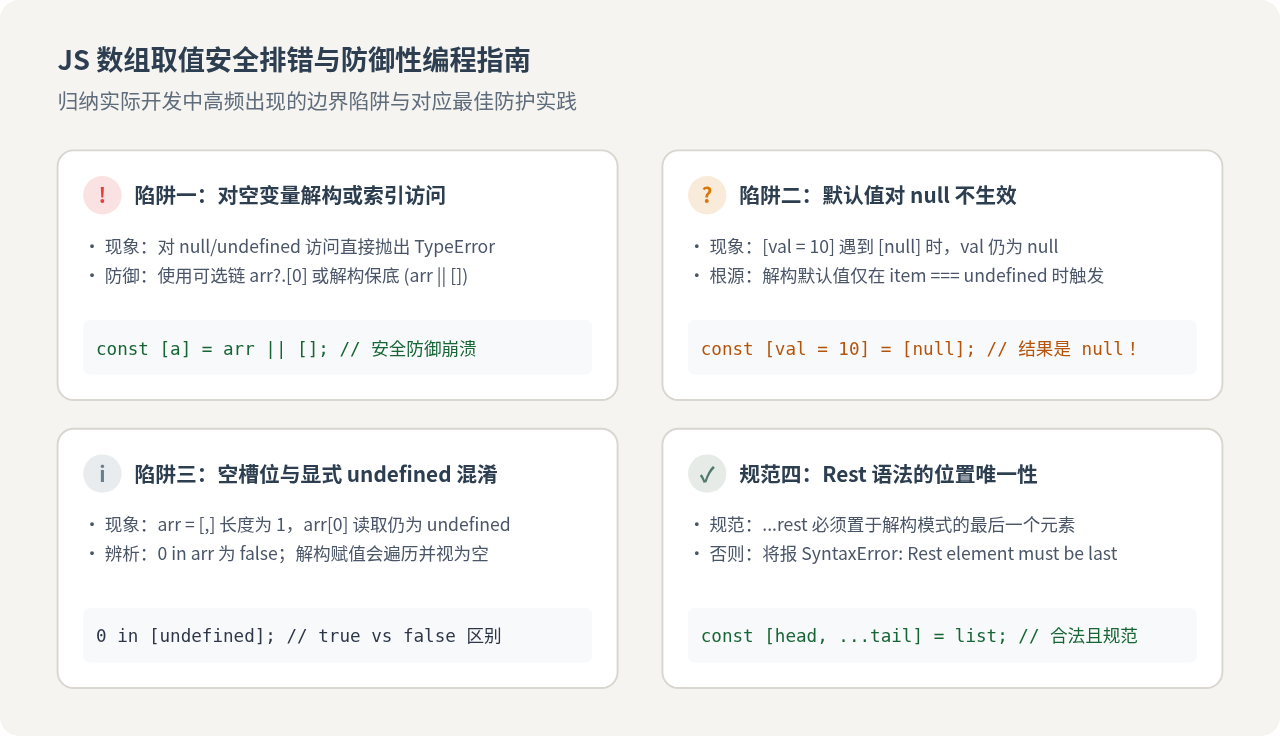
如果在提取前几个元素之后,希望把数组中剩余的所有元素归集到一个新数组中,可以使用由三个点 ... 开头的剩余参数模式。规范明确规定:剩余元素必须置于解构模式的末尾,否则会抛出语法错误。
const ranking = ['冠军', '亚军', '季军', '第四名', '第五名'];

const [winner, runnerUp, ...others] = ranking;
console.log(winner);   // 示例输出: '冠军'
console.log(runnerUp); // 示例输出: '亚军'
console.log(others);   // 示例输出: ['季军', '第四名', '第五名']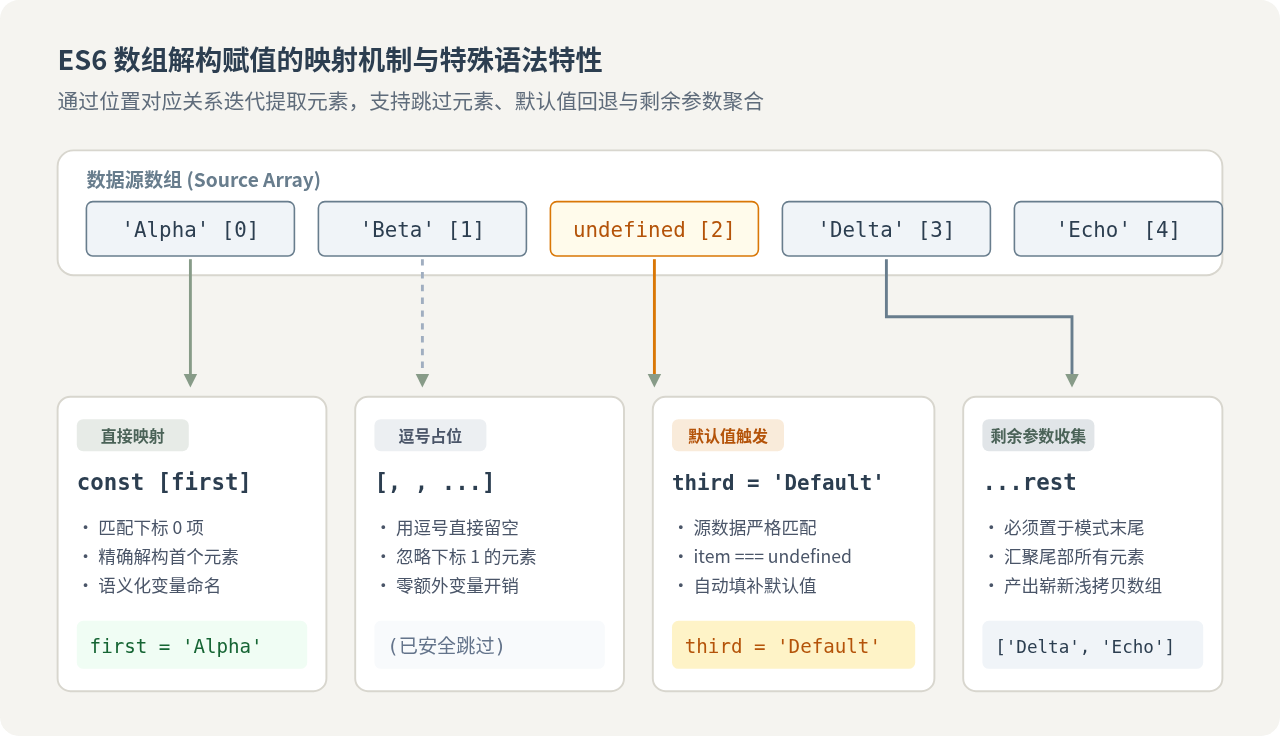
三、两种取值方式的关键差异与场景对照
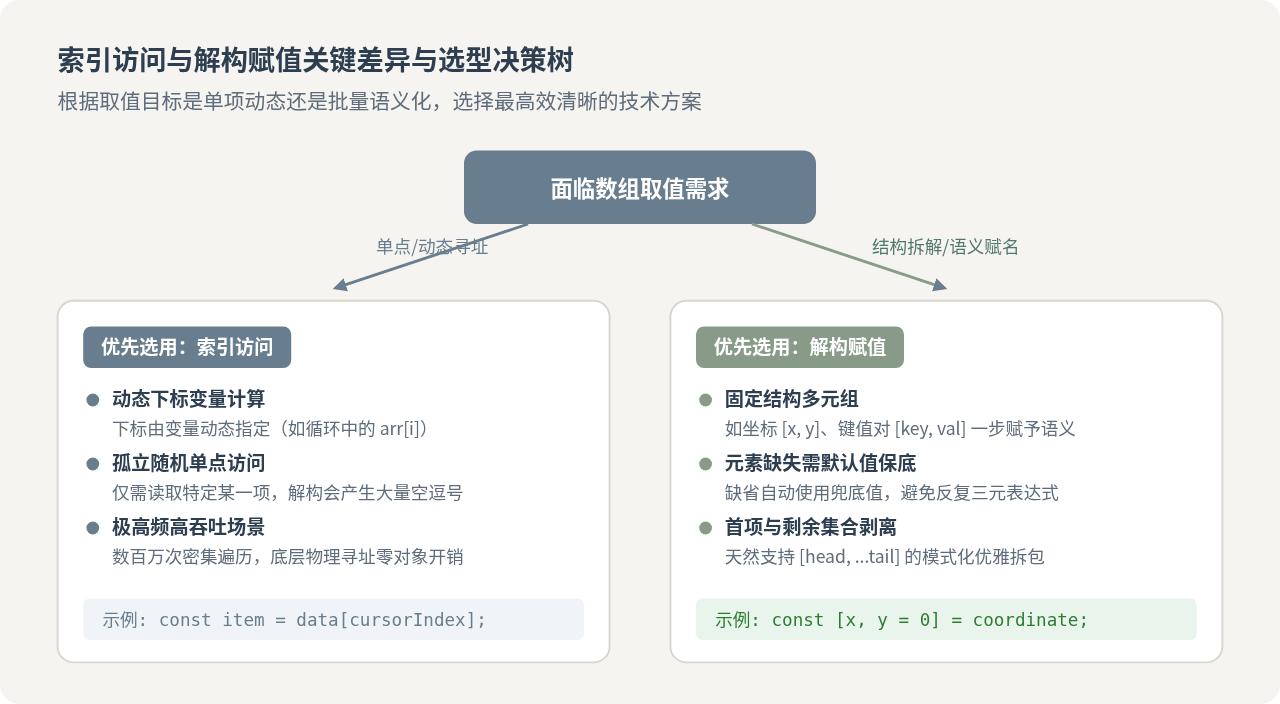
为了在实际开发中做出恰当的技术选择,我们需要在相同的需求条件下对比索引访问与解构赋值的差异。这种差异之所以重要,是因为它们在语义表达目的、动态灵活性以及容错成本上存在根本不同。
| 对比维度 | 索引访问 (arr[i] / at()) | 解构赋值 ([a, b] = arr) |
|---|---|---|
| 本质目的 | 按位置序号进行底层内存偏移量寻址 | 按数据形状进行声明式模式匹配与变量赋名 |
| 单值 vs 批量 | 适合单一、离散、特定位置的高频读取 | 擅长多值一次性拆解提取 |
| 动态下标支持 | 天然支持变量与运行时计算(如 arr[index]) |
模式在书写时位置相对固定,不可传入变量动态决定解构第几项 |
| 缺省容错机制 | 默认返回 undefined,需配合三元或空值合并运算符 ?? |
原生支持等号赋默认值(如 [a = 1]),语义更紧凑 |
| 剩余项收集 | 需调用 arr.slice(start) 手动截取 |
原生支持 ...rest 一步聚合成新数组 |
| 执行开销 | 纯基址偏移访问,接近机器指令,性能极高 | 需调用数组迭代器协议(Iterator),有微弱的对象与上下文创建开销 |
从上表可以看出:索引访问偏向“操作”,解构赋值偏向“映射”。当开发者面对 const [x, y] = point 时,能瞬间理解这是二维坐标的解包;而如果看到 const x = point[0]; const y = point[1];,代码则充满了命令式的冗余杂讯。相反,如果需要根据用户点击的按钮序号动态获取列表项,items[buttonIndex] 则是唯一合理的选择,使用解构赋值反而会产生极大别扭与代码坏味道。
四、常见边界问题与防御性排错清单
数组取值虽然是语言的基础操作,但在处理非受信数据(如网络请求响应、用户表单输入)时,经常会由于环境边界未覆盖而引发运行时异常。以下是四种典型陷阱与防御方案:
1. 防御 null 或 undefined 导致的 TypeError
如果尝试对一个值为 null 或 undefined 的变量进行解构或下标访问,JavaScript 引擎会立即抛出 TypeError: Cannot read properties of undefined。这是生产环境最常见的奔溃原因之一。
// 危险写法:如果 getUserTags 返回 null,程序直接崩溃
// const [mainTag] = getUserTags(); // TypeError!

// 防御方案 A:解构保底空数组
const [mainTag = '通用'] = getUserTags() || [];

// 防御方案 B:可选链结合索引访问
const tags = getUserTags();
const primaryTag = tags?.[0] ?? '通用';
2. 明确默认值触发的严格边界
在前后端交互中,后端接口经常返回 null 来表示字段为空。许多初学者误以为 [item = '默认'] = [null] 会触发默认值,导致程序最终拿到了 null 并在后续调用方法时报错。
undefined。如果后端字段可能返回 null,且需要给它赋予备用值,解构默认值无法单独拦截,必须配合空值合并运算符 ?? 使用。
const response = [null];
let [userName = '游客'] = response;
console.log(userName); // 仍是 null,未触发 '游客'

// 正确的双重防御:结合空值合并操作符
userName = userName ?? '游客';
console.log(userName); // 示例输出: '游客'
3. 识别稀疏数组(Sparse Array)中的空槽洞
使用 new Array(3) 或在字面量中多打逗号 [1, , 3] 会创建具有“空槽位(Empty Hole)”的稀疏数组。通过索引访问 arr[1] 时,虽然返回 undefined,但使用 1 in arr 检查会发现该属性实际上并不存在。解构赋值在遍历稀疏数组时,会将空槽位视为 undefined 并触发对应的默认值。
五、知识梳理与最佳实践
总结而言,JavaScript 数组的取值方式遵循着清晰的设计哲学:
- 使用数字索引(
arr[i]):适用于循环迭代、指针跳转、根据变量动态获取元素,以及需要从大型数据集高频单点寻址的性能敏感场景。 - 使用倒序索引(
arr.at(-1)):在需要获取尾部元素的场景中,坚决替代冗长的arr[arr.length - 1],保持代码简练明了。 - 使用解构赋值(
[a, b] = arr):适用于元组、函数返回值拆包、前置元素赋名、提取首项同时收集尾部集合,以及需要直接赋予缺省默认值的场景。 - 编写防御性代码:时刻谨记数据源可能为
null或undefined,优先使用arr?.[0]或(arr || [])解构保底,确保程序具备足够的健壮性。
JavaScript异步发送HTTP请求时怎么优雅地处理错误
2026-11-05 17:10:44
5款主流JS在线运行工具对比:CodePen、JSFiddle与StackBlitz怎么选
2026-11-05 17:04:04
JavaScript入门书籍避坑:这些书不适合初学者
2026-11-05 16:31:15
JS使用Math.round实现保留两位小数的原理与代码
2026-11-05 15:35:55
JavaScript 原生 Date 对象怎么实现日期加减
2026-11-05 14:30:00
相关标签:







