JS递归函数执行机制详解:调用栈是怎么工作的
深入解析JavaScript中递归函数的执行机制与调用栈工作原理,通过阶乘运算推导压栈与弹栈两阶段时序、解构栈帧微观内存布局,并探讨栈溢出原因及工程优化方案。
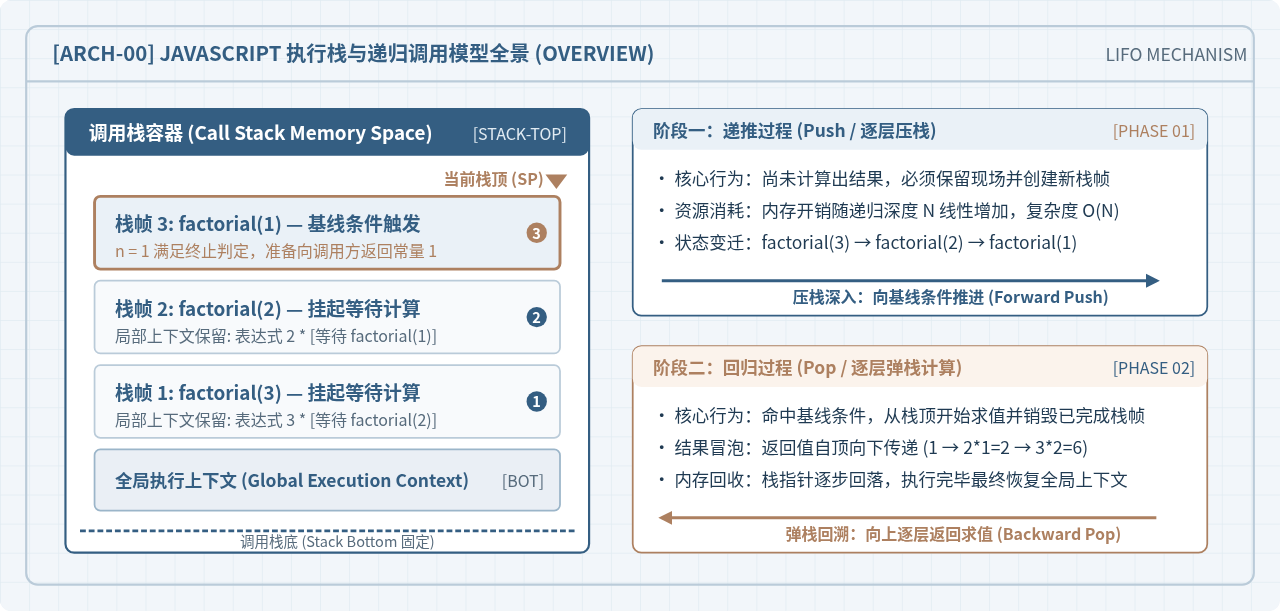
在 JavaScript 中,递归函数的底层运行完全依赖于引擎内部的调用栈(Call Stack)。每次函数调用自身时,JavaScript 引擎会为当前执行上下文创建一个独立的栈帧(Stack Frame)压入调用栈;直到代码命中预设的基线条件(Base Case),函数不再发起新的调用,栈顶函数完成计算并依次出栈返回结果。这个过程严格遵循“后进先出”(LIFO)法则,在宏观上表现为“递推”(Push 压栈)与“回归”(Pop 弹栈求值)两个互为因果的连续阶段。本文将结合经典阶乘函数,逐步拆解调用栈的运行轨迹、栈帧内部的数据结构、栈溢出的成因以及对应的工程治理方案。
一、JavaScript 调用栈的基本工作法则
JavaScript 是一门单线程执行语言,在主线程上同一时刻只能处理一段执行上下文代码。为了严谨地管理函数与函数之间的多层嵌套调用关系,JavaScript 引擎在内存中维护了一块专门的数据结构——调用栈。
调用栈的工作原理可以概括为以下三项核心规则:
- 后进先出(LIFO, Last-In-First-Out):最新被调用的函数总是被放置在栈顶(Stack Top),栈顶的函数拥有当前的 CPU 执行权;最先被调用的函数(如全局全局上下文)则始终沉在栈底(Stack Bottom)。
- 单向阻塞挂起:当父函数执行到调用子函数的代码行时,父函数本身的执行状态会被立刻挂起(Suspended),直到子函数执行完毕并返回结果,父函数才能恢复执行后续逻辑。
- 严格的作用域隔离与销毁:每个处于栈中的函数都拥有独立的栈帧空间,内部保存其局部变量与实参。只有当函数执行到达
return或代码末尾,对应的栈帧才会被从栈顶弹出(Pop)并释放。
二、递归执行的全周期推导:以 factorial(3) 为例
递归并不是某种底层的独立运算模式,而是利用函数反复压栈的结构性技巧。一个合法的递归函数必须由两部分组成:判定终止条件的基线条件(Base Case)与缩小问题规模的递归推进步骤(Recursive Step)。
我们以最常见的正整数阶乘函数为例展开跟踪:
function factorial(n) {
  if (n <= 1) {
    return 1; // 基线条件:触达递归终点
  }
  return n * factorial(n - 1); // 递归调用:缩小问题规模并向内深入
}

// 在全局执行上下文中发起调用
const result = factorial(3);
当执行 factorial(3) 时,整个调用栈经历了从 [T1] 到 [T6] 的完整状态演化:
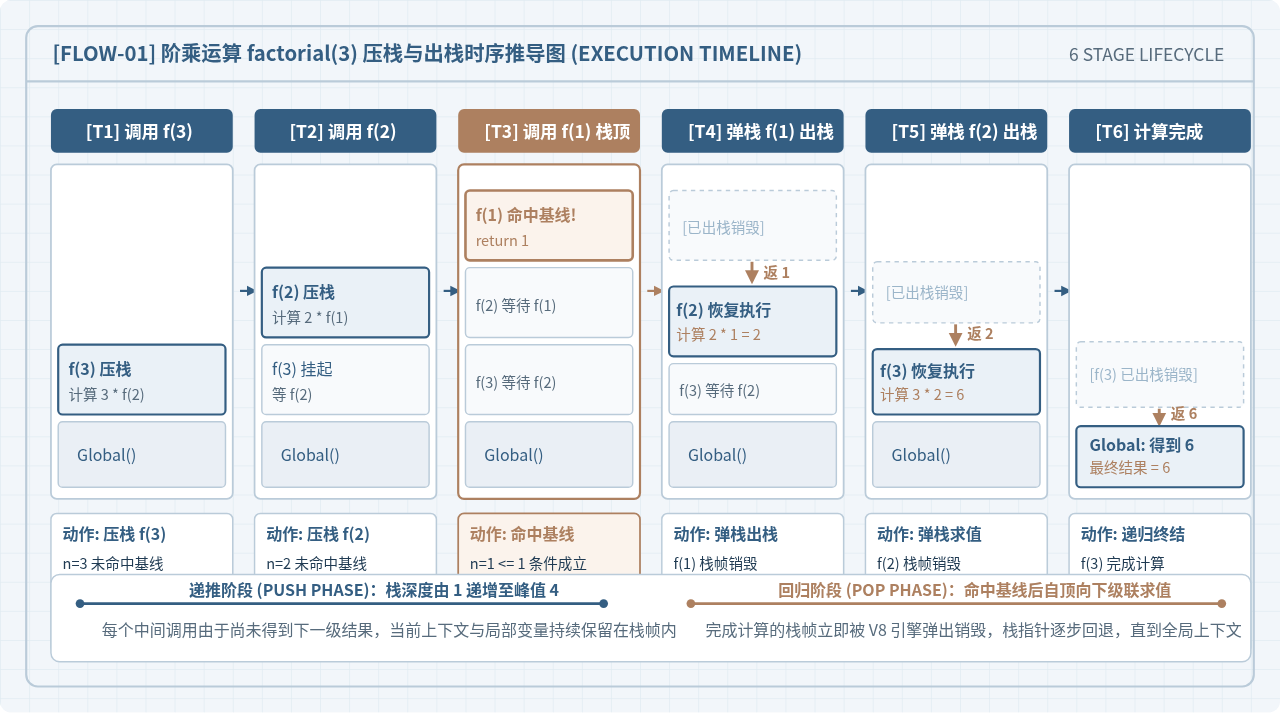
阶段一:递推过程(Push / 逐层压栈)
- 时刻 T1(发起初始调用):全局上下文调用
factorial(3),引擎为factorial(3)分配栈帧并压入栈顶。函数执行检查n <= 1为假,执行到return 3 * factorial(2)。此时因为factorial(2)的值尚未产生,乘法运算无法完成,factorial(3)被挂起。 - 时刻 T2(二次深入):引擎为
factorial(2)创建新的栈帧压入栈顶。同样n <= 1为假,执行到return 2 * factorial(1),计算挂起,等待factorial(1)返回。此时栈内累计了 3 个栈帧(含全局上下文)。 - 时刻 T3(触及基线与栈深峰值):引擎为
factorial(1)创建栈帧压入栈顶,此时调用栈达到最大深度(Peak Depth = 4)。函数检查n <= 1成立,命中基线条件,执行return 1。递推阶段在此彻底终止。
阶段二:回归过程(Pop / 逐层弹栈与求值)
- 时刻 T4(栈顶弹栈):
factorial(1)执行完毕返回数值1,其栈帧立即从栈顶弹出销毁。执行权交还给其下方的factorial(2)。 - 时刻 T5(恢复中间计算):
factorial(2)收到返回值1,唤醒此前挂起的操作数,执行2 * 1 = 2。随后执行return 2,其栈帧完成使命并被弹出销毁,栈指针进一步回缩。 - 时刻 T6(终结并交付全局):
factorial(3)接收到返回值2,唤醒被挂起的乘法,计算3 * 2 = 6,并将结果6返回给全局上下文。至此,所有递归栈帧全部弹出并被垃圾回收,全局变量result赋值为6。
三、栈帧(Stack Frame)的微观解构
很多初学者会疑惑:“为什么递归层数一多,内存消耗就会急剧增加?”答案就在于每个栈帧内部所承载的数据体量。
在 V8 引擎执行过程中,每个栈帧并不是一个简单的行号标记,而是一块结构紧凑的内存分区,主要存储以下五大核心要素:
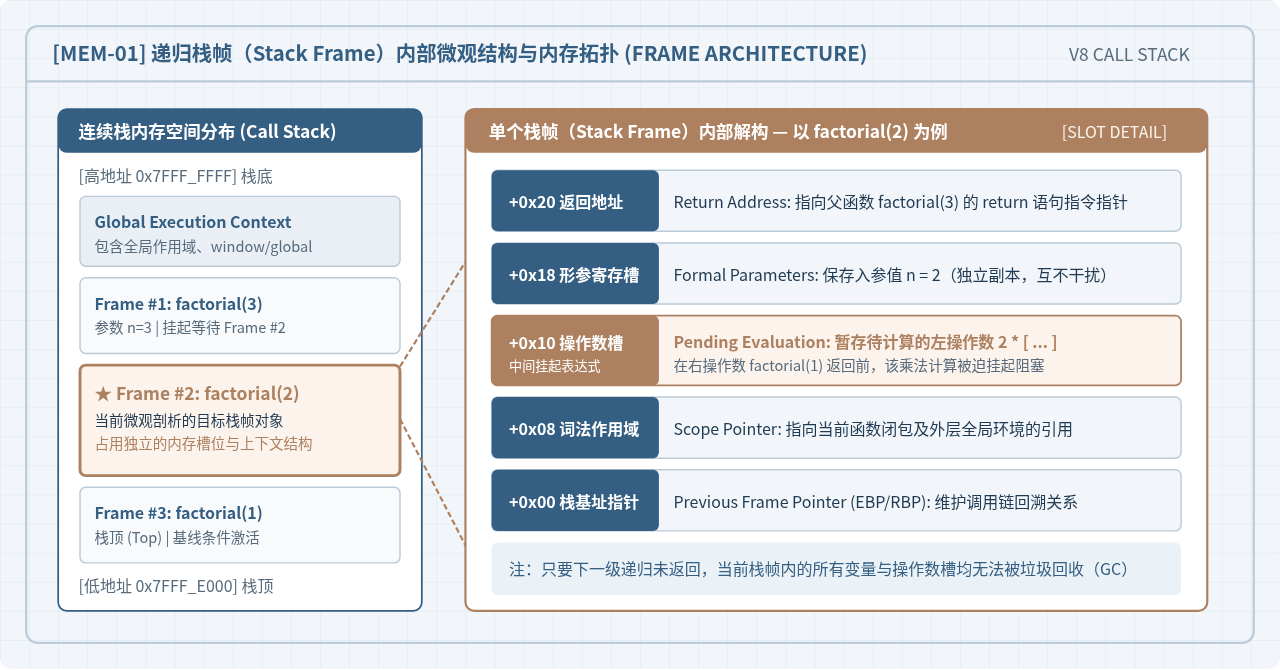
- 返回地址(Return Address / Instruction Pointer):记录当本层函数执行完返回后,应该跳回父函数代码的哪一行继续执行。例如在
factorial(2)的栈帧中,返回地址精确指向父函数return 3 * [此处等待]的指令偏移处。 - 形参存储区(Formal Arguments):保存传递给当前调用的入参副本。在
factorial(2)中,参数槽分配保存n = 2。每一层递归的形参在内存中互不干扰。 - 操作数栈与挂起表达式槽(Evaluation Stack / Pending Expressions):当代码执行到
3 * factorial(2)时,左操作数3必须被存放在操作数槽中持续驻留,直到右操作数计算完成。 - 词法环境引用(Lexical Scope Pointer):维护函数的作用域链引用,确保函数内部能够访问外层闭包变量及全局对象。
- 基址指针与状态标头(Frame Pointer / EBP):用于在弹栈时快速恢复父函数栈帧的基地址,维持调用链的物理完整性。
由此可见,每一个挂起的栈帧都在占用真实的物理内存空间。在回归完成前,这些内存由于处于活跃引用状态,绝对不会被 JavaScript 的垃圾回收器(Garbage Collector)回收。因此,递归深度为 \(N\) 时,调用栈所占用的内存空间严格为 \(O(N)\)。
四、边界失效与栈溢出(Stack Overflow)
当递归逻辑出现缺陷导致基线条件无法被触达时,调用栈将面临致命的栈溢出(Stack Overflow)。
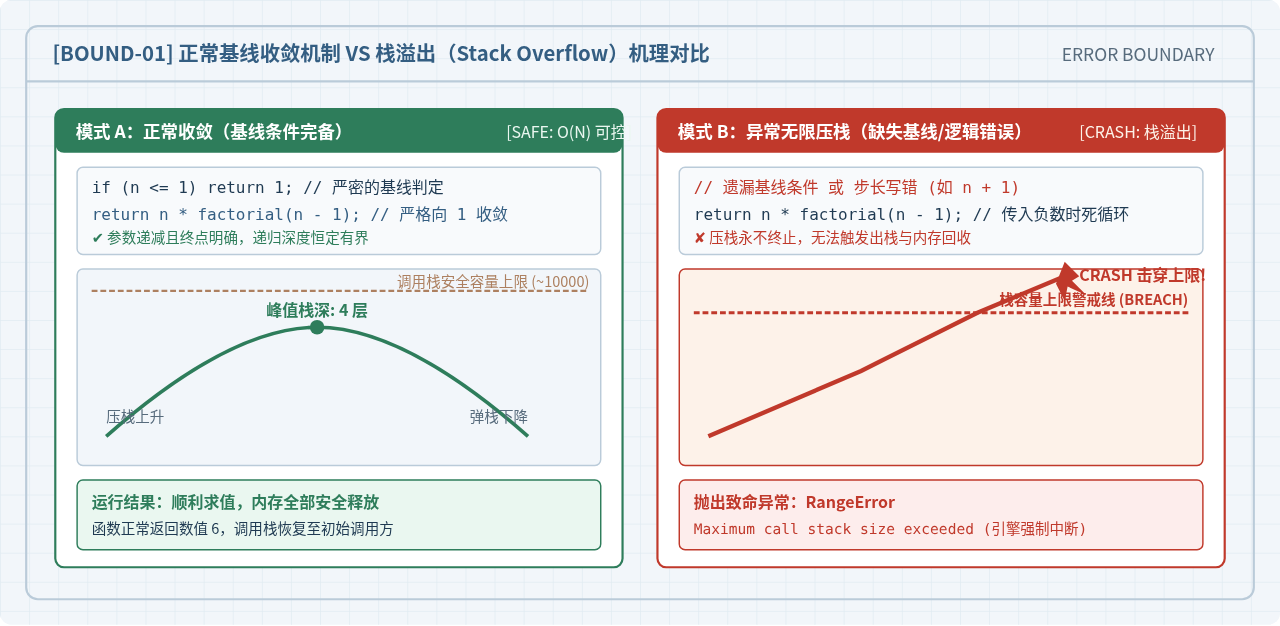
1. 栈溢出的典型触发场景
在实际编码中,导致栈溢出最常见的两种错误包括:
- 遗漏基线条件:代码中未编写
if退出判断,函数无条件发起下一层自身调用。 - 步长方向错误或不收敛:例如把递减表达式写成了递增
factorial(n + 1),或者未对浮点数、负数等异常输入做边界兜底,导致判断条件n === 1永远被跳过。
// 错误示例:传入负数时将永远无法命中 n === 1
function faultyFactorial(n) {
  if (n === 1) return 1; // 仅判定严格等于 1
  return n * faultyFactorial(n - 1);
}
faultyFactorial(-1); // 导致 RangeError: Maximum call stack size exceeded
2. 引擎的保护机制
为了防止无限压栈耗尽操作系统所有物理内存导致浏览器标签页或 Node.js 进程卡死,现代 JavaScript 引擎设立了严格的最大调用栈深度(Maximum Call Stack Size)警戒线。在 Google Chrome(V8 引擎)中,通常在递归嵌套达到约 10,000 到 15,000 层左右时,引擎会立刻中止代码执行,并抛出系统级异常:
RangeError: Maximum call stack size exceeded这是引擎在调用栈指针跨越预设警戒线时执行的硬中断保护,防止宿主进程崩溃。
五、工程实践中的递归防爆栈与优化方案
在日常业务开发中,处理树状数据(如菜单树、组织架构、DOM 节点、深拷贝)时使用递归非常直观,但面对海量数据或未知深度时,必须采取工程防御手段。
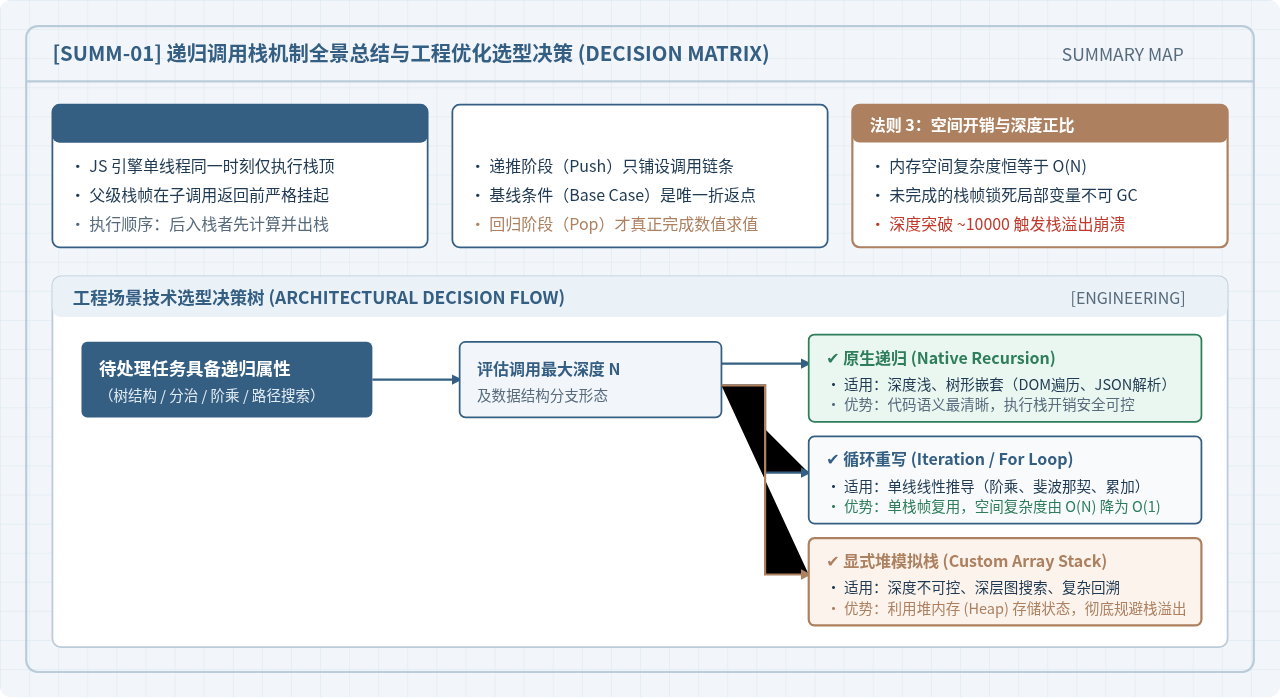
方案一:转换为循环迭代(Iteration)
任何线性递推的递归逻辑,都可以等价转换为 while 或 for 循环。循环不会开辟新的栈帧,仅在一个栈帧内通过更新局部变量反复复用寄存器,空间复杂度从 \(O(N)\) 直降为 \(O(1)\)。
// 循环改写阶乘:零压栈风险,内存占用恒定
function factorialIterative(n) {
  if (n <= 1) return 1;
  let total = 1;
  for (let i = 2; i <= n; i++) {
    total *= i;
  }
  return total;
}
方案二:尾调用优化(Tail Call Optimization, TCO)
ES6 规范明确定义了尾调用优化:如果一个函数的最后一步操作是单纯返回另一个函数的调用结果,且无需对该结果做任何附加运算,引擎可以复用当前的栈帧而不需要额外创建新栈帧。
// 尾递归改写:将累积值作为参数下传
function factorialTail(n, total = 1) {
  if (n <= 1) return total;
  // 必须直接 return 函数调用,外层不能附带乘法或其他计算
  return factorialTail(n - 1, n * total);
}方案三:使用堆内存显式模拟调用栈(Trampoline / Explicit Stack)
当面临复杂的深层树遍历或图搜索且无法简单改写为普通循环时,最佳实践是在堆内存中维护一个自定义数组作为栈。操作系统提供给调用栈的内存极为有限(通常只有几兆字节),而堆内存(Heap)拥有数吉字节的可用空间,可以安全处理百万级节点的遍历需求。
// 显式模拟栈深度优先遍历树节点(避免系统调用栈溢出)
function traverseTreeSafely(root) {
  if (!root) return;
  // 使用自定义数组作为显式栈,分配在堆内存中
  const stack = [root];

  while (stack.length > 0) {
    const currentNode = stack.pop();
    // 执行具体节点业务逻辑
    console.log(currentNode.value);

    // 将子节点逆序压入显式栈
    if (currentNode.children && currentNode.children.length > 0) {
      for (let i = currentNode.children.length - 1; i >= 0; i--) {
        stack.push(currentNode.children[i]);
      }
    }
  }
}
六、核心要点与排查速查
下表总结了调用栈在处理递归时的关键概念与开发排查要点:
| 概念维度 | 底层工作机制 | 代码审查与排查要点 |
|---|---|---|
| 基线条件 (Base Case) | 作为折返点,终止递推(Push),触发首个返回值并开启回归(Pop) | 必须确保边界覆盖完备(包含 0、负数、空指针等防御判断) |
| 递归步骤 (Recursive Step) | 每次调用必须使传入参数更趋近基线条件 | 检查每一步参数的演进方向,避免死循环或步长震荡 |
| 栈帧保留状态 | 等待子函数计算期间,当前函数的作用域、参数、局部运算全部锁死在栈内存中 | 递归过深会导致内存占用陡增,深层大数据应优先选用循环或模拟栈 |
| 栈溢出报错 | 调用栈深度突破宿主引擎的安全限额(约 10,000 ~ 15,000 层) | 浏览器 DevTools 中查看 Call Stack 面板,单步回溯查看是哪层调用未收敛 |
在日常调试中,如果遇到疑似递归调用异常,可在浏览器的 DevTools 中打开 Sources(来源) 面板,在递归函数的第一行打上断点,观察右侧的 Call Stack(调用栈) 面板。你可以清晰地看到一个个以当前函数名命名的栈帧随着单步执行逐级叠加,并在命中基线条件后逐步逐层消减,从而直观验证函数的执行机制与边界收敛是否符合预期。
JS大数值转字符串出现科学计数法怎么办
2026-11-05 17:09:21
JS split切割后出现空字符串怎么过滤
2026-11-05 16:00:30
在 React 或 Vue 项目中封装使用 JS 节流防抖
2026-11-05 15:27:29
JavaScript中怎么将带小数的字符串转为整数?
2026-11-05 14:32:38
怎么用JavaScript策略模式重构电商促销计算逻辑?
2026-11-05 14:01:09
相关标签: