

深入理解 React 虚拟 DOM 与 Diff 算法工作原理
深入解析 React 虚拟 DOM 的设计本质与 Diff 算法的核心运作机制,涵盖启发式三大策略、节点复用判定、Fiber 双缓存对比以及实际开发中的性能优化准则。
一、虚拟 DOM 的本质:不仅是性能缓冲,更是状态抽象
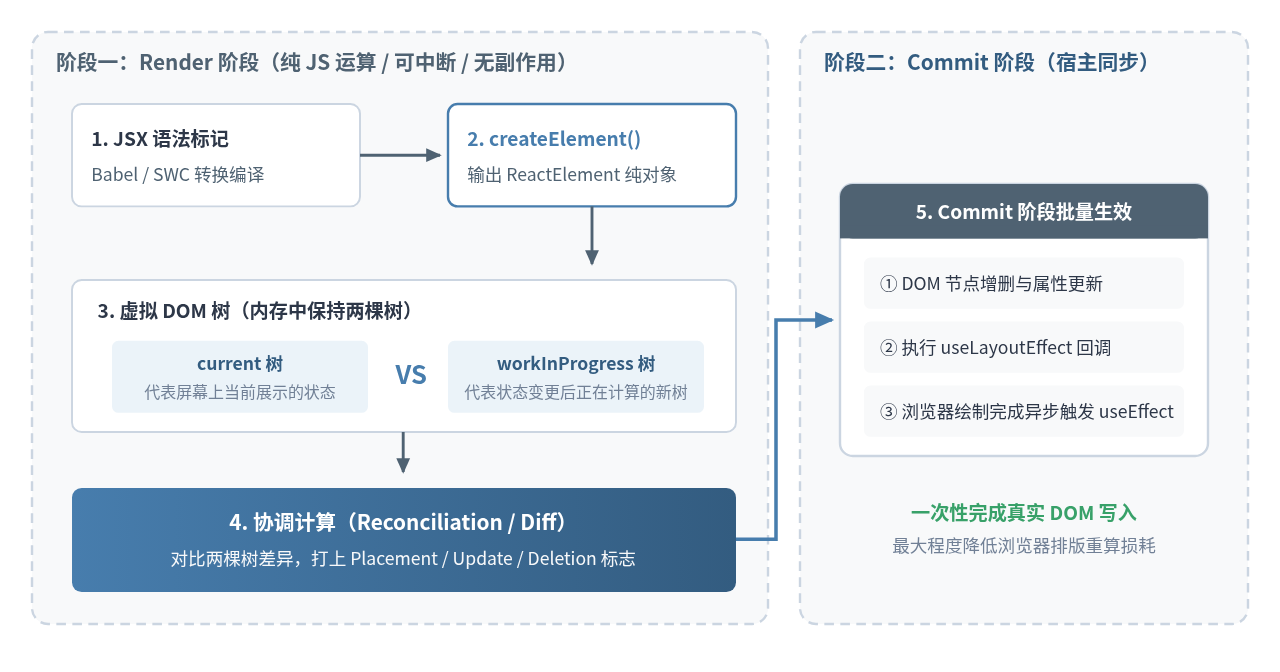
在传统的前端开发模式中,直接操作真实 DOM(Document Object Model)往往伴随着显著的性能开销。浏览器原生的 DOM 节点十分沉重,一个普通的 <div> 元素原型链上挂载了数百个属性、样式计算机制和事件监听器。每一次对真实 DOM 结构的增删或几何属性修改,都极易引发浏览器的样式重算(Recalculate Style)、重排(Reflow/Layout)和重绘(Repaint)。
React 引入的虚拟 DOM(Virtual DOM)并不是真实 DOM 的简单克隆,而是使用纯 JavaScript 对象建立的一套轻量级节点树。它作为开发者编写的声明式代码与宿主真实环境之间的抽象缓冲层,核心属性非常精简,仅包含标签名、属性集合与子节点指针。
// 一个 JSX 标签与编译后生成的虚拟 DOM (ReactElement) 结构对应示例
// JSX 源代码:
// <div className="card" key="item-1">
//   <h3>标题</h3>
//   <span>内容描述</span>
// </div>

// React.createElement 生成的 Virtual DOM 对象结构:
const vnode = {
  $$typeof: Symbol.for('react.element'), // 标识安全 React 元素
  type: 'div',                          // 标签名或组件构造函数
  key: 'item-1',                        // 唯一标识,用于高效 Diff
  ref: null,
  props: {
    className: 'card',
    children: [
      {
        $$typeof: Symbol.for('react.element'),
        type: 'h3',
        key: null,
        props: { children: '标题' }
      },
      {
        $$typeof: Symbol.for('react.element'),
        type: 'span',
        key: null,
        props: { children: '内容描述' }
      }
    ]
  }
};
通过将 UI 抽象为纯 JavaScript 对象树,React 获得了两项关键能力:
- 跨平台统一渲染:虚拟 DOM 与浏览器环境完全解耦。同一套虚拟节点树可以由
react-dom渲染为浏览器 DOM,由react-native渲染为移动端原生视图,或由服务端渲染引擎输出为 HTML 字符串。 - 批量与最小化更新:状态发生多次连续变更时,React 在内存中先完成所有虚拟节点的合并与对比计算,将计算结果聚合成一次批处理补丁(Patch),避免了频繁直接操作真实 DOM 导致的多次回流。
二、传统 Tree Diff 与 React 的三大启发式策略
如果将两棵任意完整的树形结构进行对比并计算出将一棵树转换为另一棵树所需的最小操作步骤(树编辑距离 Tree Edit Distance),学术上的通用最小算法复杂度为 $O(n^3)$(其中 $n$ 为树中节点的总数)。这意味着如果一个页面包含 1,000 个节点,一次更新对比就需要进行 $10^9$ 次运算,这在任何现代浏览器的单线程运行环境中都会直接导致页面假死。
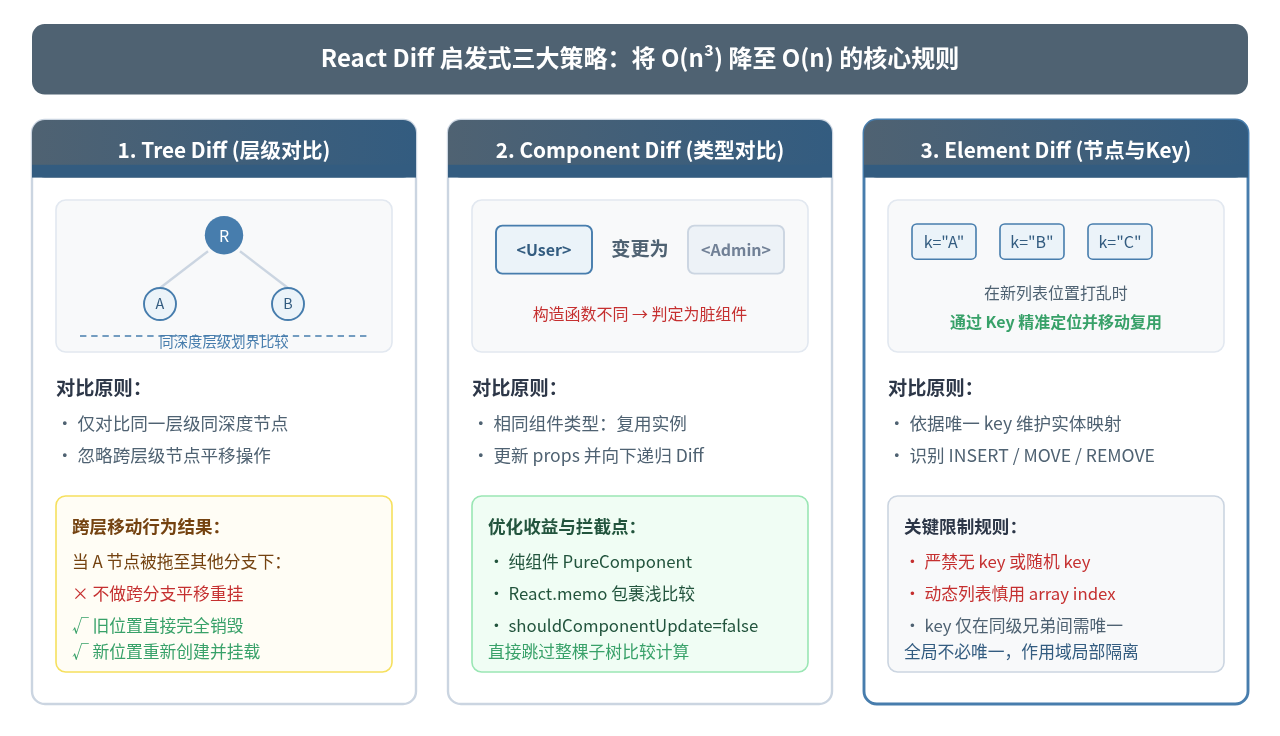
React 并没有采用完全通用的树编辑距离算法,而是结合前端 Web 应用的实际开发特征,制定了三项启发式假设(Heuristic Hypotheses),成功将算法复杂度降至 $O(n)$:
1. Tree Diff(同层对比,不跨级移动)
在绝大多数 UI 交互场景中,DOM 节点几乎很少发生跨层级的长距离移动,往往是在同父节点下增删或在同层展开。因此,React 只对两棵虚拟树中处于同一深度的同层节点进行对比。
算法采用广度优先方式从根节点同级推进。当发现某个父节点在旧树中存在而在新树中消失时,React 会直接卸载销毁该父节点及其下属整棵子树,而不会尝试去深入探查它的子节点是否被移到了树的另外一个分支。若确实发生了跨层级移动(例如将某个 <p> 从 <div> 内部移至同级 <section> 下),React 会执行“在旧位置销毁重建、在新位置全新挂载”的操作,以局部创建成本换取了全局遍历复杂度的剧烈下降。
2. Component Diff(组件类型对比)
对于组件类型的节点,React 采取以下判定准则:
- 类型相同(同一组件类或函数):该组件实例保持复用,React 仅将其新的
props和context传入,随后递归对比该组件内部返回的下一层子虚拟 DOM 树。若开发者实现了shouldComponentUpdate或使用了React.memo,则可在此处直接拦截跳过后续整棵子树的比对。 - 类型不同(如将
<Header>换成了<Banner>,或将<div>换成了<p>):React 直接判定该组件为脏组件(Dirty Component),哪怕两个组件渲染出来的结构极其相似,也会完全销毁旧组件的整棵子树及其所有状态,重新生成并挂载新组件。
3. Element Diff(同级兄弟节点的 Key 机制)
当子节点处于同一层级且拥有相同的父节点时,React 提供了三种基本操作:INSERT_MARKUP(插入)、MOVE_EXISTING(移动)与 REMOVE_NODE(删除)。
为了精准识别集合中发生的是“位置调换”还是“内容更替”,React 引入了显式的 key 属性。key 是节点在当前兄弟集合中的唯一稳定业务标识。通过 key,React 可以在 $O(1)$ 时间复杂度内从旧节点哈希表中检索出同名旧节点,将其在内存中直接复用并调整 DOM 位置,而不是机械地按照索引位置逐一销毁并重建。
三、Element Diff 深度拆解:节点复用与位移算法
在三大策略中,对业务日常代码性能影响最直接的是 Element Diff。列表渲染在前端极其常见,如果列表顺序发生变化,算法如何判定一个节点是该被复用、被移动还是被销毁?
1. 缺少 Key 时的降级对比
当同级子元素没有显式声明 key 时,React 默认只能根据数组的自然索引(Index)自左向右逐个对比。假定旧列表为 [<li>北京</li>, <li>上海</li>],我们在列表头部插入了一个新元素 <li>广州</li>,新列表变为 [<li>广州</li>, <li>北京</li>, <li>上海</li>]:
- 对比 Index 0:旧为“北京”,新为“广州”,React 判定内容改变,更新真实 DOM 文本为“广州”;
- 对比 Index 1:旧为“上海”,新为“北京”,React 判定内容改变,更新真实 DOM 文本为“北京”;
- 对比 Index 2:旧无节点,新为“上海”,创建新 DOM 并插入“上海”。
原本仅需一次“在头部插入新元素”的操作,退化成了三次 DOM 修改。更危险的是,如果列表中包含带非受控内部状态的表单组件(如 <input />),由于复用了错误位置的 DOM 实例,用户在输入框中填写的文字将直接留在原位,导致致命的状态错位 Bug。
2. 拥有 Key 时的节点移动与 lastIndex 算法
在赋予每个节点唯一且稳定的 key 之后,React 会首先将旧子节点集合以 key 为键构建一个哈希映射表(Map/Object)。随后,React 顺序遍历新集合,通过维护一个名为 lastIndex(已访问过的旧节点在旧集合中的最大索引值)的游标变量来判定节点是否需要发生物理位移:
// 算法判定逻辑核心伪代码说明
let lastIndex = 0;

for (let i = 0; i < nextChildren.length; i++) {
  const nextChild = nextChildren[i];
  const oldChild = prevChildrenMap.get(nextChild.key);

  if (oldChild) {
    // 节点在旧集合中存在,可以复用 DOM
    if (oldChild._mountIndex < lastIndex) {
      // 旧位置小于已访问的最大索引,说明该节点在旧集合中排在更前的位置
      // 为了符合新集合的当前顺序,该节点必须向右发生实际 DOM 位移
      enqueueMove(oldChild, i);
    } else {
      // 旧位置大于或等于 lastIndex,说明其相对顺序保持不变,无需移动
      // 将 lastIndex 更新为当前节点在旧集合中的索引
      lastIndex = oldChild._mountIndex;
    }
  } else {
    // 旧集合中不存在,说明是全新节点,执行创建插入
    enqueueInsert(nextChild, i);
  }
}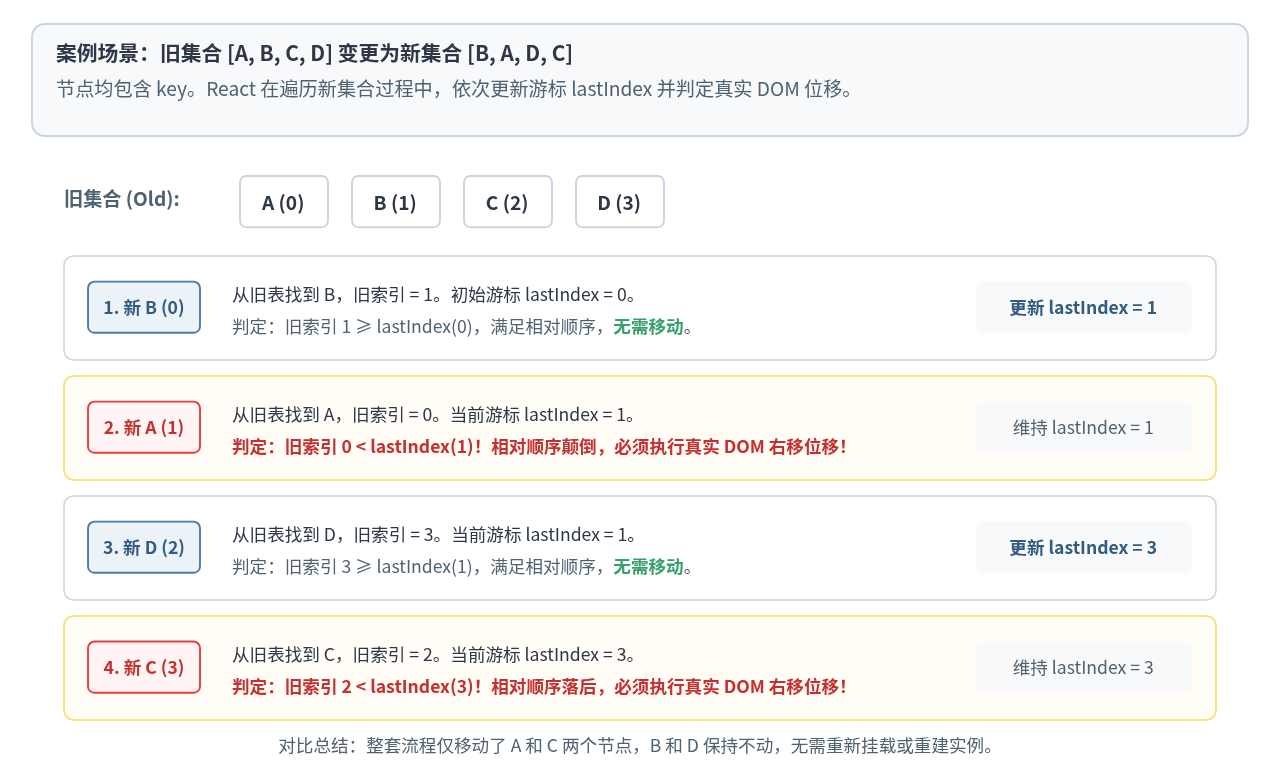
[A, B, C, D] 变为 [D, A, B, C]):D 的旧索引为 3,直接使得 lastIndex 跃升为 3。后续比对 A、B、C 时,由于它们的旧索引(0, 1, 2)均小于 3,React 会判定 A、B、C 全部需要向右移动。在性能敏感列表设计中,应尽量避免单纯为了把尾部项置顶而打乱整体列表结构。
四、Fiber 架构下的两轮遍历 Diff 实现
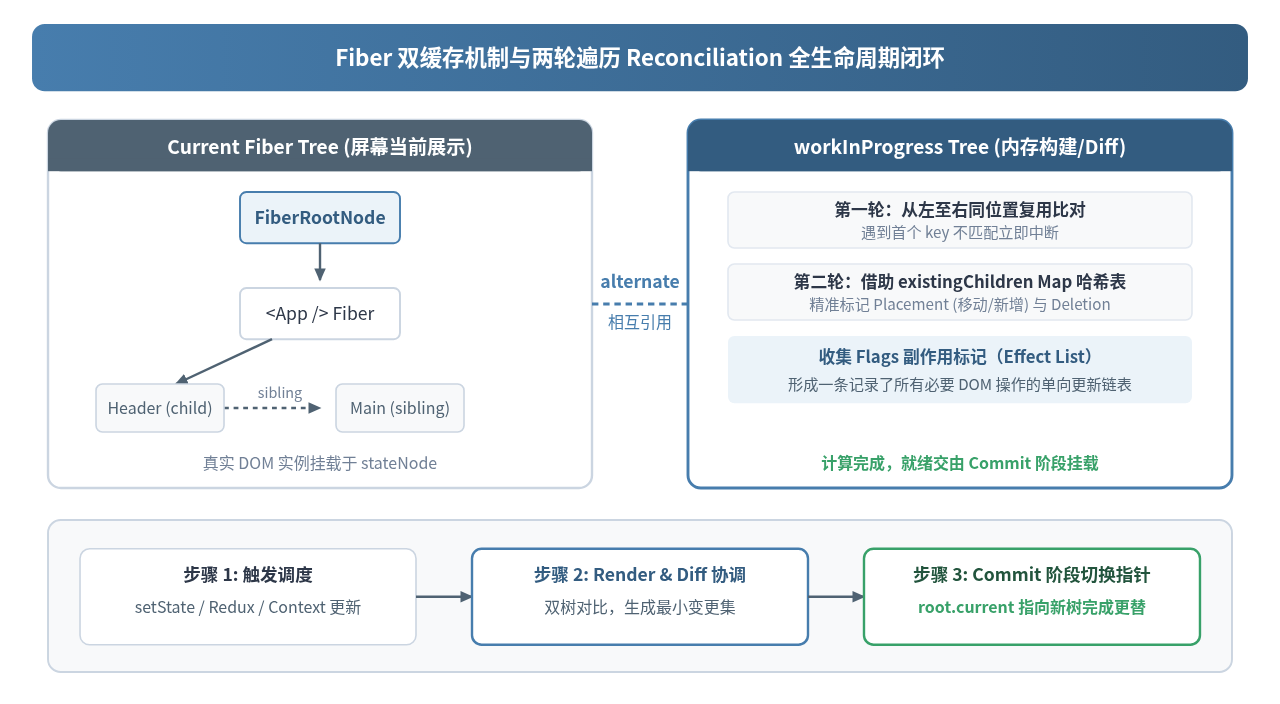
在 React 16 之后,React 引入了 Fiber 架构。虚拟 DOM 的内部形态由原先的嵌套对象树转变为以 child(子节点)、sibling(兄弟节点)和 return(父节点)为特征的单链表结构。
因为单链表只能单向向后遍历,无法像数组一样直接支持快速双向索引或双端对比(Vue 所采用的 Diff 方案),React Fiber 在处理同级多节点 Diff(reconcileChildrenArray)时,设计了极其精巧的两轮遍历机制:
第一轮遍历:处理同位置的连续更新(Update)
在大多数日常业务渲染中,节点的更新以“修改文本、切换样式或修改 props”为主,节点位置发生大幅度变动的情况相对较少。因此第一轮遍历专攻同位置的高效复用:
- 同时遍历旧的 Fiber 链表与新的 JSX 元素数组;
- 如果新旧节点的
key相同,且类型相同,则直接复用旧 Fiber 节点并更新属性; - 一旦遇到
key不匹配,第一轮遍历立即终止,跳出循环。
第二轮遍历:处理节点的移动、插入与删除
跳出第一轮遍历后,可能出现三种不同边界情况:
- 新数组已遍历完毕,旧 Fiber 链表仍有剩余:说明后续节点已被移除,直接将剩余所有旧 Fiber 打上
Deletion标志,在 commit 阶段批量销毁。 - 旧 Fiber 链表已耗尽,新数组仍有剩余:说明后续均为新增节点,直接遍历新数组创建全新 Fiber 并打上
Placement标志。 - 新数组与旧链表均有剩余:说明发生了乱序或移动。此时 React 会将剩余的未匹配旧 Fiber 存入一个名为
existingChildren的哈希 Map 中(以key或未设置 key 时的index为键)。随后继续遍历新数组,从 Map 中通过 key 快速查找复用,并结合lastPlacedIndex判定是否打上Placement(移动)标记。遍历结束后,Map 中剩余未被匹配到的旧 Fiber 全部打上Deletion标记删除。
| 算法机制维度 | 传统 Stack Reconciler Diff | 现代 Fiber Reconciler Diff |
|---|---|---|
| 底层数据结构 | 树状递归嵌套对象(Stack 递归) | 单向链表 Fiber 节点(child, sibling, return) |
| 可中断性 | 不可中断,调用栈一旦启动必须同步完成 | 支持按时间切片(Time Slicing)中断与恢复任务 |
| 多节点 Diff 策略 | 单层数组索引映射遍历 | 两轮遍历(先同位比对,再借助 Map 处理乱序) |
| 双缓存机制 | 单一在内存中比较并打补丁 | current 树与 workInProgress 树交替切换 |
五、面向 Diff 算法特性的实际开发优化准则
理解了虚拟 DOM 与 Diff 算法在底层的工作约束后,我们在日常编写 React 业务代码时,应当遵循以下具体的工程实践准则:
1. 保证 Key 的唯一性与绝对稳定性
千万不要使用动态生成的随机数(如 Math.random())或时间戳(如 Date.now())作为 key。若每次渲染 key 都在改变,React 会在 Diff 阶段将每一个组件均视作全新节点,导致无条件卸载并重新创建整棵子树,造成严重的性能损耗与页面闪烁。
对于会发生排序、过滤、插入或删除的动态列表,坚决避免直接使用数组索引 index 作为 key。仅当列表完全是静态展示(纯展示、永不重新排序或过滤)时,使用索引才算安全。
2. 保持 DOM 结构的层级稳定性
由于 Tree Diff 只会做同层级对比,如果在 JSX 中根据状态随意添加或移除包裹层,即使内部内容毫无变化,整棵子树也会被销毁重建:
// 不推荐的做法:条件改变导致结构层级发生改变,引发内部子组件完全重建
function BadComponent({ isWrapped, children }) {
  return isWrapped ? (
    <div className="wrapper">
      <ComplexChild />
    </div>
  ) : (
    <section className="wrapper">
      <ComplexChild />
    </section>
  );
}

// 推荐的做法:保持最外层结构一致,仅动态改变属性,从而复用内部的 ComplexChild
function GoodComponent({ isWrapped, children }) {
  return (
    <div className={isWrapped ? "wrapper active" : "wrapper"}>
      <ComplexChild />
    </div>
  );
}
3. 借助记忆化技术主动拦截 Diff 递归
虽然 React 的 Diff 算法已经是极速的 $O(n)$ 线性复杂度,但当应用规模达到数万节点时,对未发生状态改变的子树进行不必要的虚拟 DOM 创建和遍历依然会占用大量主线程时间。通过在父子组件边界合理使用 React.memo、useMemo 与 useCallback,开发者可以主动切断 Component Diff 的向下递归深度,直接返回上一轮缓存的 Fiber 节点,从而将整体耗时降到极致。
React与Vue框架选型对比:基于JavaScript前端开发视角
2026-11-04 09:50:04
React中使用Chart.js绘制动态更新饼状图
2026-11-03 22:13:19
详解 dva Model 结构:state、reducers 与 effects 写法指南
2026-11-03 18:15:14
排查 UmiJS 常见构建报错与路由失效问题
2026-11-03 12:47:41
React、Vue、Angular三大主流前端框架详解与初始化示例
2026-10-31 21:18:04






