

JS数组合并与去重:concat、展开运算符及Set实战
深入解析JavaScript中数组合并与去重的实战方案,对比Array.prototype.concat与ES6展开运算符的底层差异,剖析Set结合SameValueZero的去重机制,并提供针对基础类型与对象数组的高性能解决方案。
... 或 concat 将多个数据源拍平合并,再利用 ES6 的 Set 集合数据结构天然的唯一性过滤重复值,最后转换回标准数组。一行代码 [...new Set([...arrA, ...arrB])] 即可搞定大多数基础类型场景。然而,不同合并方式在类数组处理与内存表现上存在差异,Set 对引用类型(如对象数组)的“去重失效”也是实际业务中极易忽视的陷阱。本文将深入讲解合并与去重的完整实现流程、底层原理、核心差异及对象数组的扩展解法。
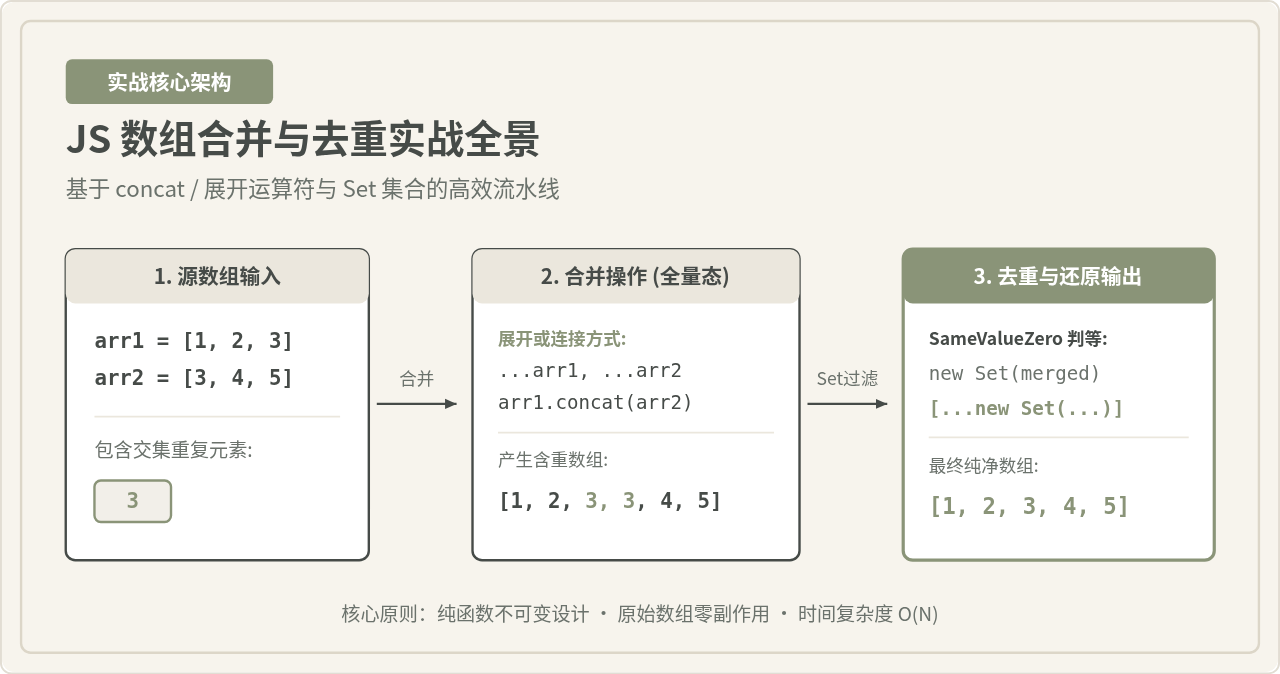
一、数组合并的双雄:concat 与展开运算符实战
在 ES6 出现之前,合并数组主要依赖 Array.prototype.concat();而在现代 JavaScript 中,基于迭代器协议的展开运算符(Spread Operator)... 成为了开发者的首选。二者都能完成拼接任务,且均遵循纯函数设计——返回新数组而不修改原数组(不可变操作),但在调用机制和边界表现上各有不同。
1.1 Array.prototype.concat() 的标准用法与浅拷贝本质
concat() 方法用于合并两个或多个数组。该方法不会更改现有数组,而是返回一个包含了所有数组或参数值的新数组。
const listA = [1, 2, 3];
const listB = [3, 4, 5];

// 示例:使用 concat 合并数组
const merged = listA.concat(listB);

// 输出示例:[1, 2, 3, 3, 4, 5]
console.log(merged);

// 原数组均保持不变
console.log(listA); // [1, 2, 3]
console.log(listB); // [3, 4, 5]
关于类数组与展开标识的辨析:concat() 默认只对数组进行平铺。如果你向 concat 传入一个类数组对象(例如 DOM NodeList 或手写的 { 0: 'a', length: 1 }),concat 默认不会将其内部元素展开,而是将整个类数组对象当作单个元素直接塞入结果数组。除非该对象显式声明了 [Symbol.isConcatSpreadable]: true。
1.2 ES6 展开运算符 (...) 的灵活机制
展开运算符 ... 基于 ECMAScript 的可迭代协议(Iterable Protocol),能够在数组字面量中就地将任何可迭代对象展开为离散元素。与 concat 相比,它的语法更为精炼,并且支持在数组的头部、中间或尾部任意混合拼接非数组元素。
const arr1 = [10, 20];
const arr2 = [30, 40];

// 示例:展开运算符合并,并在任意位置插入新项
const combined = [0, ...arr1, 25, ...arr2];

// 输出示例:[0, 10, 20, 25, 30, 40]
console.log(combined);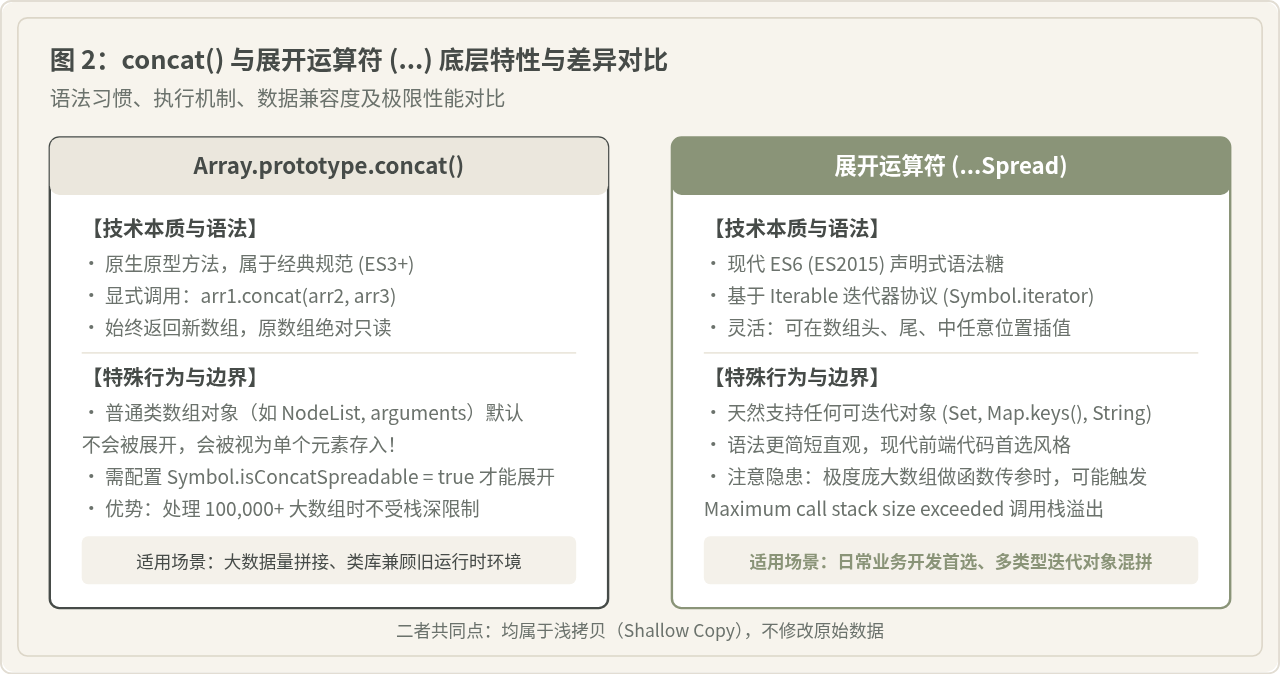
func(...hugeArray) 这类调用会受执行上下文的传参栈深限制(一般在 65,536 项左右)。如果待合并的数组单体长度超过 10 万项,直接使用 arr1.concat(arr2) 或 push 循环分块处理能更有效地防止 RangeError: Maximum call stack size exceeded。
二、元素去重的基石:Set 数据结构与核心机制
Set 是 ES6 引入的一种新的集合数据结构,类似于数组,但其成员的值都是唯一的,没有重复值。理解 Set 的去重机制,是写出健壮代码的关键。
2.1 Set 的去重原理与 SameValueZero 规则
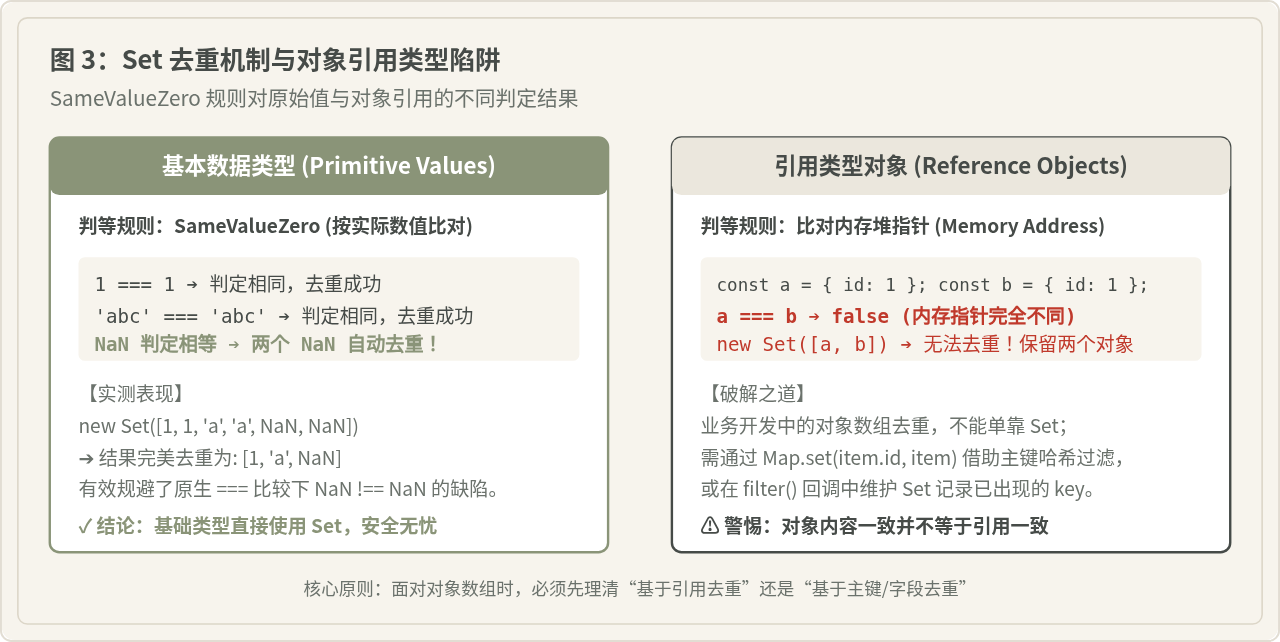
许多开发者认为 Set 内部去重使用的是全等运算符 ===。这种说法看似符合大部分直觉,但并不完全准确。
Set 内部的判等依据是 ECMAScript 规范中定义的 SameValueZero 算法。它与 === 的核心差异在于对特殊值 NaN 的处理:
- 在原生 JavaScript 中,根据 IEEE 754 浮点数规范,
NaN === NaN返回false。如果使用传统的indexOf或===遍历去重,数组中的多个NaN无法被剔除。 - 在
Set的 SameValueZero 规则下,NaN与NaN被判定为同一元素,因此多个NaN会被正确去重,最终只保留一个。 - 对于正负零
+0与-0,SameValueZero 同样将其视为相等。
// 验证 SameValueZero 对 NaN 的去重
const messy = [1, 1, NaN, NaN, 'js', 'js', +0, -0];
const uniqueSet = new Set(messy);

// 输出示例:Set(4) { 1, NaN, 'js', 0 }
console.log(uniqueSet);
2.2 从 Set 还原为 Array 的两种方案
new Set() 返回的是一个 Set 集合实例,而不是数组。在继续进行 map、filter 等数组链式操作前,必须将其还原为标准 Array。常见的方式有两种:
- 使用展开运算符:
[...setInstance]—— 现代语法,简洁直观,社区普及率最高。 - 使用 Array.from():
Array.from(setInstance)—— 语义明确,同时还支持传入第二参数作为 mapFn 映射函数,执行一步转换。
三、合并并去重的一体化实战模式
将合并操作与 Set 去重结合,就构成了现代前端处理数组数据的基础模式。
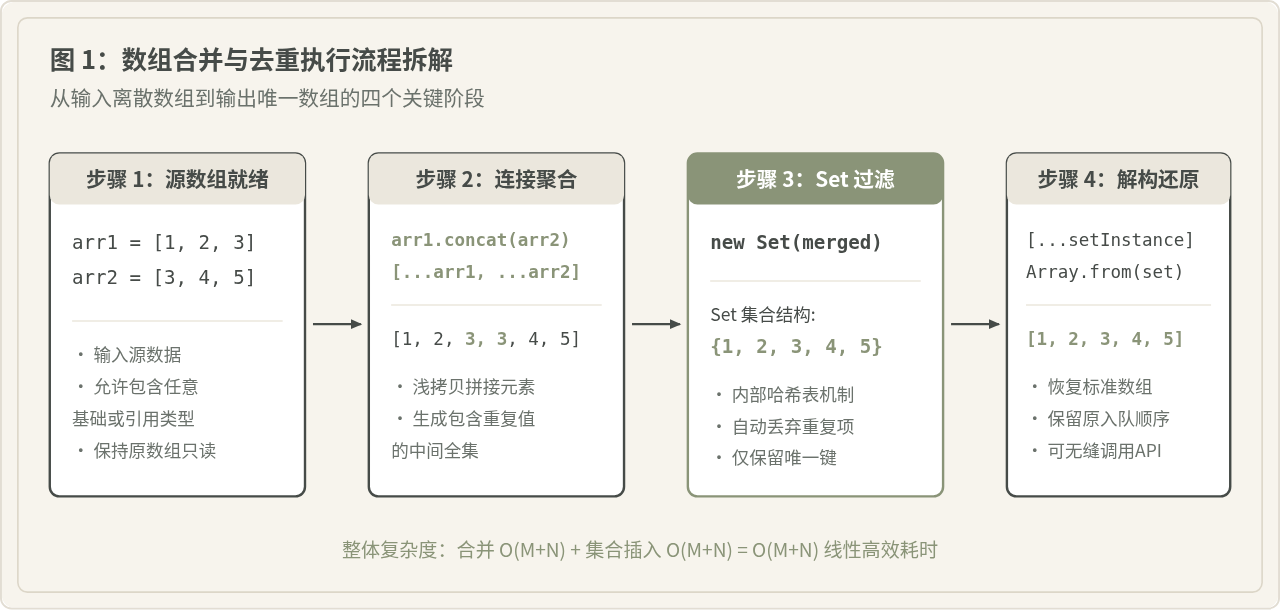
3.1 经典一行流写法与步骤拆解
对于纯基本数据类型(数字、字符串、布尔值等),最推荐的一体化代码如下:
const arrA = [1, 2, 3, 4];
const arrB = [3, 4, 5, 6];

// 方式一:展开运算符 + Set (最常用)
const result1 = [...new Set([...arrA, ...arrB])];
console.log(result1); // 输出示例:[1, 2, 3, 4, 5, 6]

// 方式二:concat + Array.from
const result2 = Array.from(new Set(arrA.concat(arrB)));
console.log(result2); // 输出示例:[1, 2, 3, 4, 5, 6]
执行阶段分解:
[...arrA, ...arrB]执行浅拷贝拼接,产生含重复项的临时数组[1, 2, 3, 4, 3, 4, 5, 6];new Set(...)遍历临时数组,根据 SameValueZero 规则构建无重复哈希表,剔除重复的3和4;- 外部的
[...]触发 Set 的迭代器,将其元素逐个展开回新数组中。
3.2 多数组与动态数组的通用去重
当需要合并去重的数据源不仅有两个,而是动态数组列表(如 [arr1, arr2, arr3, ...])时,可以结合 flat() 或解构函数:
// 示例:合并 N 个数组并去重
function mergeAndDedup(...arrays) {
  // 使用 flat(1) 打平一层并去重
  return [...new Set(arrays.flat(1))];
}

const list1 = ['苹果', '香蕉'];
const list2 = ['香蕉', '橙子'];
const list3 = ['橙子', '西瓜'];

const fruits = mergeAndDedup(list1, list2, list3);
console.log(fruits);
// 输出示例:['苹果', '香蕉', '橙子', '西瓜']
四、业务深水区:对象数组去重的真相与解决方案
在实际项目开发中,后端接口返回的数据往往是对象数组(如用户列表 [{ id: 1, name: 'Alice' }, ...])。直接使用 new Set() 去重会立即“失效”。
4.1 为什么 Set 无法直接去重对象数组?
在 JavaScript 中,对象是引用类型,变量存储的是指向堆内存空间的引用地址(指针)。
const obj1 = { id: 1, name: 'Tom' };
const obj2 = { id: 1, name: 'Tom' };

console.log(obj1 === obj2); // 输出 false!因为在堆内存中位于两个不同的地址

const set = new Set([obj1, obj2]);
console.log(set.size); // 输出 2,无法去重!
因为 obj1 和 obj2 指向不同内存地址,Set 判定二者是两个独立的对象。因此,针对对象数组,必须根据具体的业务主键(如 id 或 code)来设计去重逻辑。
4.2 方案一:借助 Map 以业务主键哈希去重(高效率推荐)
Map 允许以任意类型的值作为键(Key)。遍历合并后的数组,将对象的唯一属性作为 Map 的键,整项对象作为值。由于 Map 的同一个键只能赋值一次,后进入的项会覆盖先进入的项(若想保留第一项,只需在 set 前判断 has 即可)。
const usersA = [
  { id: 101, name: '张三', role: '开发' },
  { id: 102, name: '李四', role: '测试' }
];

const usersB = [
  { id: 102, name: '李四', role: '主管' }, // ID 与 usersA 重复,但角色更新
  { id: 103, name: '王五', role: '运维' }
];

// 实现:后出现的项覆盖先出现的项(更新为最新状态)
function mergeUsersLatest(...lists) {
  const map = new Map();
  lists.flat().forEach(user => {
    map.set(user.id, user);
  });
  return Array.from(map.values());
}

const latestResult = mergeUsersLatest(usersA, usersB);
console.log(latestResult);
/* 输出示例:
[
  { id: 101, name: '张三', role: '开发' },
  { id: 102, name: '李四', role: '主管' },
  { id: 103, name: '王五', role: '运维' }
]
*/
4.3 方案二:利用 Array.prototype.filter 结合临时 Set 过滤(保留首次出现的项)
如果业务要求保留“首次出现的元素”,则可以使用 filter 配合一个记录已见 ID 的 Set。这种写法无需额外还原 Map,语法连贯自然。
function mergeUsersFirstSeen(...lists) {
  const seenIds = new Set();
  return lists.flat().filter(item => {
    if (seenIds.has(item.id)) {
      return false; // 已经存在,剔除
    }
    seenIds.add(item.id);
    return true;
  });
}

const firstResult = mergeUsersFirstSeen(usersA, usersB);
console.log(firstResult[1].role);
// 输出示例:'测试'(保留了 usersA 中先出现的状态)
五、工程选型指南与性能边界
在工程项目中,技术选型不仅需要考虑代码是否能够运行,还应衡量内存开销、可维护性以及潜在的边界异常。
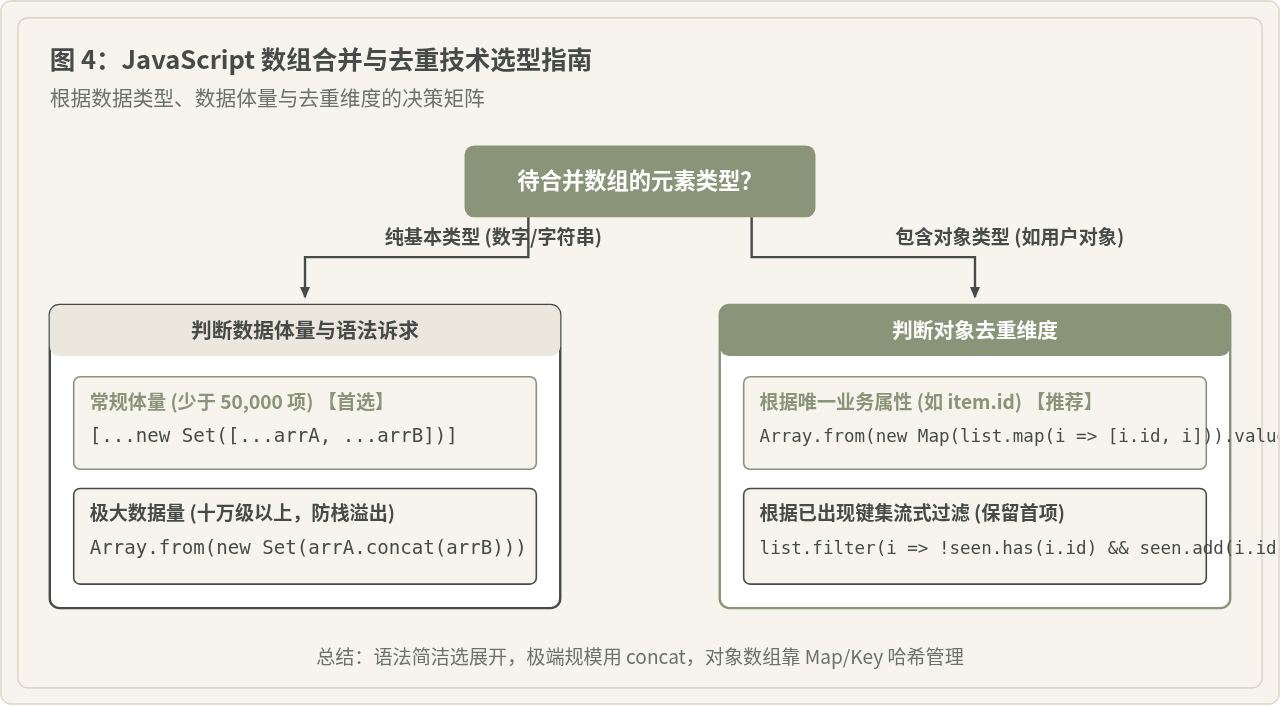
5.1 方案特性与适用场景全景对比
| 技术组合方案 | 适用数据类型 | 时间复杂度 | 内存消耗 | 主要优势与适用场景 |
|---|---|---|---|---|
[...new Set([...a, ...b])] |
基础数据类型 | O(M + N) | 需分配临时数组与 Set | 代码极其紧凑,可读性好,绝大部分业务场景的首选方案。 |
Array.from(new Set(a.concat(b))) |
基础数据类型 | O(M + N) | 单次缓冲,无调用栈隐患 | 适合十万级以上大数组合并,有效防御参数栈溢出。 |
Map.prototype.set(key, item) |
包含对象类型 | O(M + N) | 哈希索引存储 | 根据业务唯一主键(如 id)去重,可控制新老数据覆盖策略。 |
filter() + Set(seenKeys) |
包含对象类型 | O(M + N) | 轻量键记录 | 流式过滤,天然保留原序列中首次出现的对象。 |
5.2 容易混淆说法的澄清与辨析
-
混淆点 1:“展开运算符性能永远比 concat 快”
辨析:在现代 V8 引擎中,针对十万项以内常规数组,两者的执行性能差异通常在微秒级别,均极为高效。但展开运算符在底层被转译为函数入参展开时,会受引擎参数调用栈上限约束;而concat属于原生内部方法,在超大规模数组拼接时更加平稳。 -
混淆点 2:“Set 去重使用的是全等比较 ===”
辨析:正如前文所述,Set 使用的是SameValueZero。最关键的修正点是对于NaN的判定——如果使用===进行手动去重,NaN无法去重;但在Set中,NaN会被正确去重。 -
混淆点 3:“去重操作会深拷贝对象”
辨析:无论是展开运算符、concat还是Set,都只执行浅拷贝(Shallow Copy)。去重后数组中包含的对象,仍然指向原对象的堆内存地址。修改结果数组中对象的属性,依然会同步影响原数组中的对象。如果需要彻底断开引用,必须显式结合结构化克隆(如structuredClone())进行深拷贝。
[...new Set([...arr1, ...arr2])] 是一劳永逸的标准解法;处理对象数组时,切忌直接套用 Set,而应结合 Map 或基于主键的 Set 记录表进行哈希筛选,才能保证业务逻辑的准确与高效。
JavaScript怎么准确判断数据类型:typeof、instanceof与Object.prototype.toString
2026-11-05 17:09:21
JS中将数组和对象混合组装为JSON字符串
2026-11-05 16:41:42
JS运算符优先级与结合性的区别是什么?
2026-11-05 13:22:02
JS Map怎么只遍历Key或Value
2026-11-05 13:00:36
D3.js 与 ECharts 选型对比:灵活性 vs 开发效率
2026-11-05 09:45:01







