

JavaScript数组操作实例:去重、排序与映射的高效写法
全面解析JavaScript中数组去重、排序与映射的高效写法,包含基础值与对象数组去重、sort排序机制与陷阱、map与flatMap转换、链式调用性能优化及四幅内联SVG架构流程图。
日常前端与服务端数据处理中,数组的去重、排序与映射构成了最基础也最高频的处理链路。掌握这些操作的高效写法,不仅能大幅精简代码行数,更能规避如引用丢失、NaN比较失效、字符字典序陷阱以及多轮循环带来的性能损耗。本文将针对这三类场景,直接给出生产环境适用的标准代码范式,并结合底层运作原理解释各写法的边界条件与最佳实践。
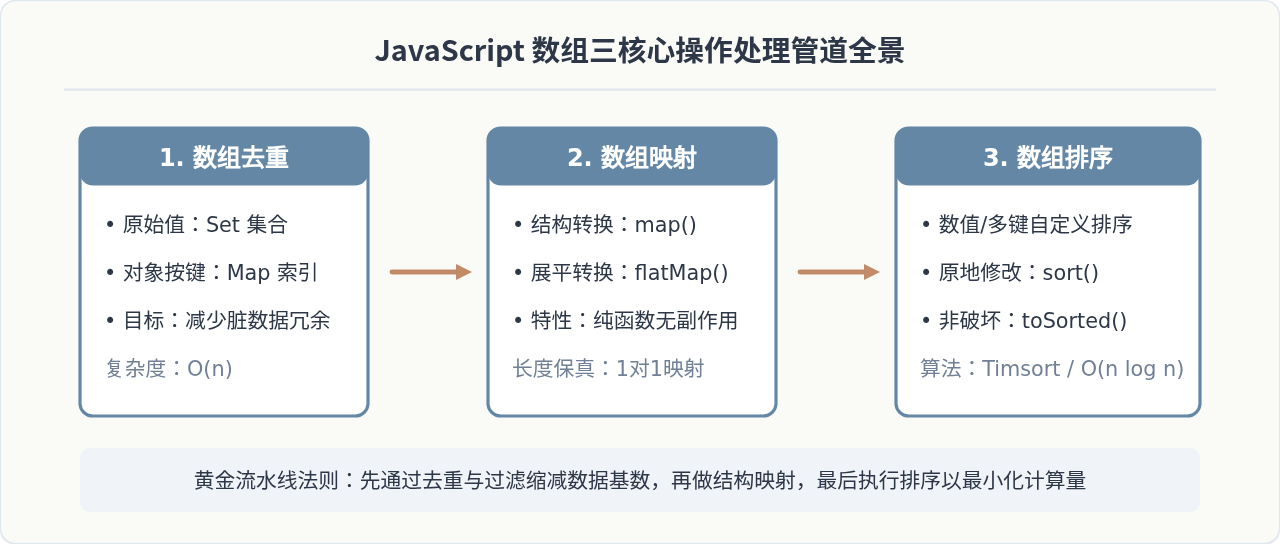
一、数组去重的高效写法与边界条件
去重操作的目标是消除数据集中的重复项。由于 JavaScript 存在基本类型(Primitive)与引用类型(Object/Array)之分,去重的方案需要根据数据结构明确选型。
1. 基础类型数组去重:Set 展开法
对于只包含数字、字符串、布尔值等基本类型的数据,现代 JavaScript 最标准且高效的方式是利用 Set 数据结构结合展开运算符(Spread Operator):
// 示例:基础类型数组去重
const rawNumbers = [1, 2, 2, 3, 4, 4, 5, 1, 0, -0, NaN, NaN];
const uniqueNumbers = [...new Set(rawNumbers)];

console.log(uniqueNumbers);
// 输出示例:[1, 2, 3, 4, 5, 0, NaN]机制与优势:Set 内部采用类似 SameValueZero 的比较算法。与传统的全等比较 === 相比,它能够正确将多个 NaN 判定为相同并去重,同时会将 +0 与 -0 视为重复。其查找与插入平均时间复杂度为 O(1),因此整段代码执行时间为 O(n)。
2. 对象数组按特定字段去重:Map 键值映射法
在实际业务中,接口返回的数据多为对象数组,例如包含多个用户对象,需要根据 id 去重。此时 Set 无法直接奏效,因为即使两个对象的属性值完全一致,其内存引用地址也不同。推荐使用 Map 高效过滤:
// 示例:按对象属性 id 去重
const users = [
  { id: 101, name: "张三", role: "admin" },
  { id: 102, name: "李四", role: "user" },
  { id: 101, name: "张三 (新)", role: "admin" },
  { id: 103, name: "王五", role: "editor" }
];

// 写法 1:保留最后一次出现的元素
const uniqueByLast = [...new Map(users.map(item => [item.id, item])).values()];

// 写法 2:保留首次出现的元素(使用 filter + Map)
const seen = new Map();
const uniqueByFirst = users.filter(item => !seen.has(item.id) && seen.set(item.id, 1));

console.log(uniqueByFirst);
// 输出示例:保留了 id 为 101 的张三,排除了后续重复项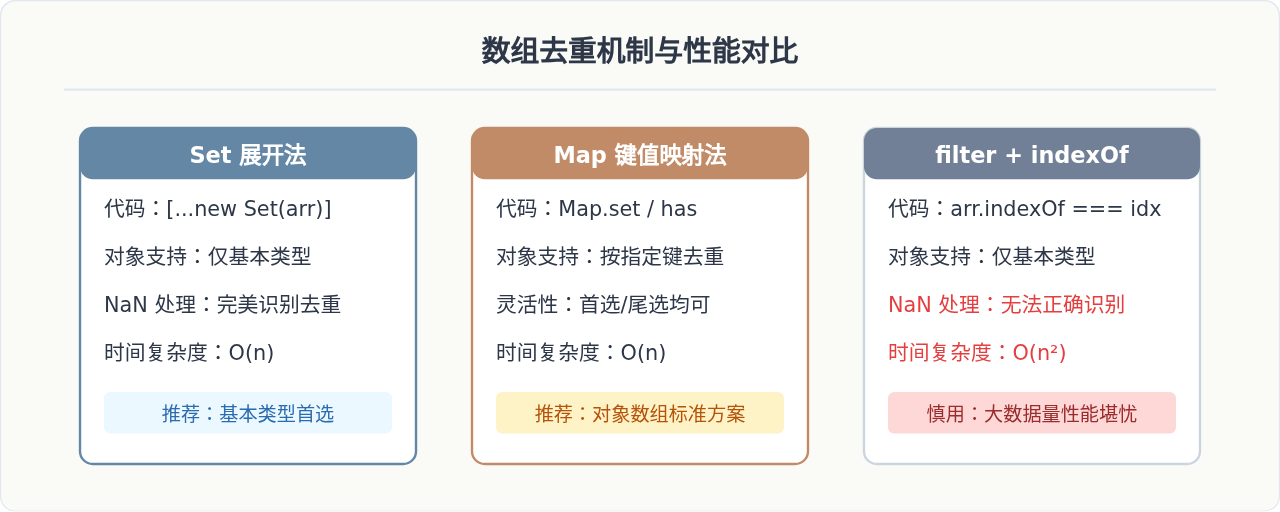
二、数组排序的正确姿势与避坑指南
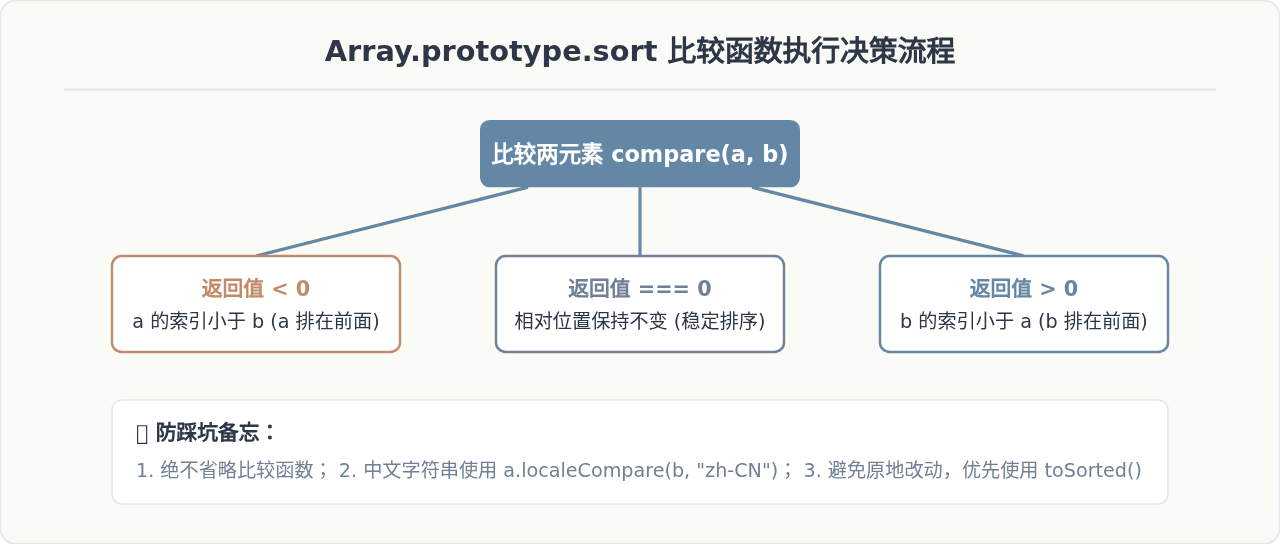
JavaScript 原生提供的 Array.prototype.sort() 是最常被误用的方法之一。如果不传递比较函数,它默认会将所有元素转为字符串后按照 Unicode 码点顺序排序,导致诸如 [10, 2, 5].sort() 输出 [10, 2, 5] 的经典错误。
1. 正确的数值升序与降序
const scores = [85, 92, 100, 78, 64, 92];

// 升序排列 (从小到大)
const ascending = scores.slice().sort((a, b) => a - b);

// 降序排列 (从大到小)
const descending = scores.slice().sort((a, b) => b - a);

console.log(ascending);  // [64, 78, 85, 92, 92, 100]
console.log(descending); // [100, 92, 92, 85, 78, 64]sort() 会直接修改原数组并返回该数组的引用。在 React 状态管理或函数式编程中,直接 arr.sort() 会破坏不可变数据原则(Immutability)。现代浏览器与 Node.js 20+ 已全面支持非破坏性方法 arr.toSorted((a, b) => a - b);在低版本环境中,建议使用 [...arr].sort(...) 或 arr.slice().sort(...)。
2. 对象数组多条件排序
在电商列表或员工管理中,常常需要先按某个主字段排序(如部门层级),在主字段相同时再按次要字段排序(如入职日期或薪资):
const products = [
  { name: "键盘", category: "电子", price: 299, sales: 1200 },
  { name: "鼠标", category: "电子", price: 99,  sales: 3400 },
  { name: "插座", category: "数码", price: 49,  sales: 5000 },
  { name: "显示器", category: "电子", price: 999, sales: 800 }
];

// 多条件排序:先按品类字典序,同品类按销售量降序
const sortedProducts = [...products].sort((a, b) => {
  // 1. 比较品类(中文字符使用 localeCompare)
  const categoryCompare = a.category.localeCompare(b.category, "zh-CN");
  if (categoryCompare !== 0) {
    return categoryCompare;
  }
  // 2. 品类相同时,按销量降序排列
  return b.sales - a.sales;
});
三、数组映射与形态转换实战
映射操作通过遍历原数组的每个元素,依次执行指定的变换逻辑,最终返回一个长度相同、结构全新的新数组。它是实现纯函数式数据流的核心工具。
1. 属性提取与数据整形:map()
前端对接后端接口时,常常需要将后端的复杂实体裁剪为轻量级的 UI 呈现模型:
// 原始后端接口数据
const apiUsers = [
  { userId: "u_1", profile: { nick: "Alpha", avatar: "a.jpg" }, status: 1 },
  { userId: "u_2", profile: { nick: "Beta", avatar: "b.jpg" }, status: 0 }
];

// 高效映射为 Select 控件所需的键值对
const userOptions = apiUsers.map(({ userId, profile, status }) => ({
  value: userId,
  label: profile.nick,
  disabled: status !== 1
}));

console.log(userOptions);
// 输出:[{ value: "u_1", label: "Alpha", disabled: false }, ...]
2. 嵌套结构拍平与映射:flatMap()
当每个元素本身包含一个子数组,并且需要将其全部提取成单层列表时,使用 arr.map().flat() 会创建中间数组并产生两次完整遍历。此时应优先使用 flatMap(),在单次遍历中直接完成“映射 + 深度为1的拍平”:
const orders = [
  { orderId: "A01", items: ["手机", "保护壳"] },
  { orderId: "A02", items: ["笔记本电脑"] },
  { orderId: "A03", items: [] }
];

// 一步提取所有商品,过滤空订单
const allPurchasedItems = orders.flatMap(order => order.items);

console.log(allPurchasedItems);
// 输出:["手机", "保护壳", "笔记本电脑"]
四、链式组合与性能优化法则
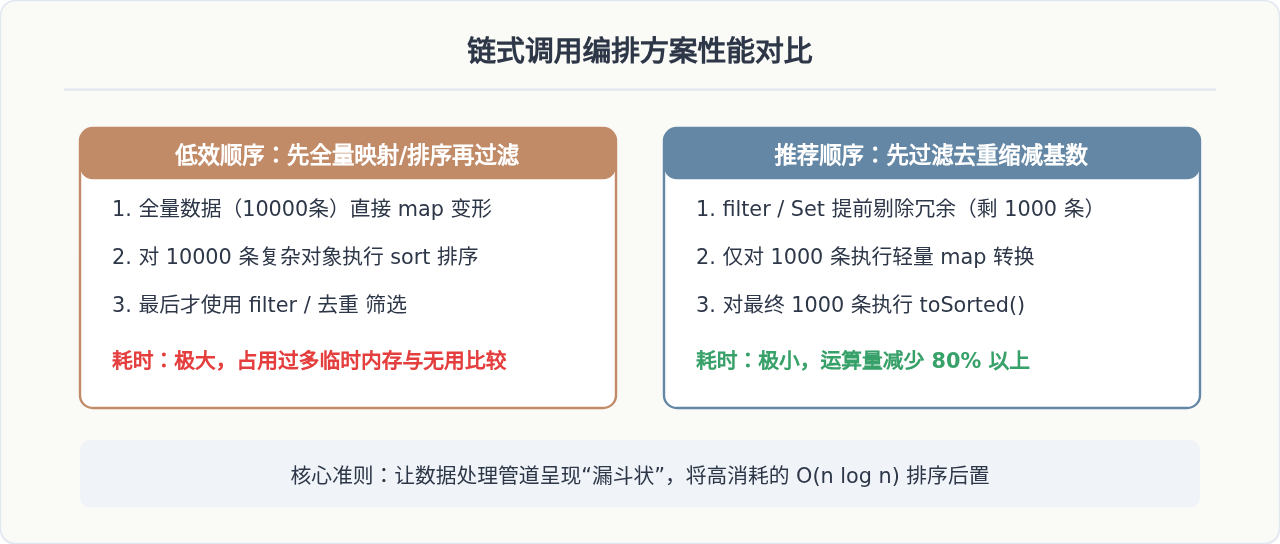
去重、映射、排序往往不是孤立出现的,而是组合成完整的数据处理管道。编写链式调用时,操作的先后顺序对性能有着决定性影响。
1. 最佳流水线编排顺序
在长链式调用中,务必遵循“尽早缩减数据规模”的原则:
- 第一步(去重/过滤):使用
filter()或Set/Map尽早剔除无效与重复项,将待处理数据从 10000 条缩减至 1000 条。 - 第二步(结构映射):使用
map()转换保留下来的有效项。 - 第三步(最终排序):排序算法的理论下限是 O(n log n),只对最终清洗完毕的最小数据集执行
sort()。
2. 完整工业级实战范例
结合上述三个维度,以下给出一段处理高并发交易日志的完整实用函数:
// 原始交易流水:存在重复交易号、包含已作废流水
const transactions = [
  { txId: "TX_100", amount: 250, status: "SUCCESS", timestamp: 1698001000 },
  { txId: "TX_101", amount: 80,  status: "FAILED",  timestamp: 1698001200 },
  { txId: "TX_100", amount: 250, status: "SUCCESS", timestamp: 1698001000 }, // 重复项
  { txId: "TX_102", amount: 1500, status: "SUCCESS", timestamp: 1698002000 },
  { txId: "TX_103", amount: 620, status: "SUCCESS", timestamp: 1698001800 }
];

// 高效管道化处理函数
function getTopSuccessTransactions(list, topN = 3) {
  // 1. 去重并保留成功状态 (使用 Map,O(n))
  const uniqueSuccessMap = new Map();
  for (const item of list) {
    if (item.status === "SUCCESS" && !uniqueSuccessMap.has(item.txId)) {
      uniqueSuccessMap.set(item.txId, item);
    }
  }

  // 2. 映射与排序 (对缩小后的集合操作)
  return Array.from(uniqueSuccessMap.values())
    .map(({ txId, amount, timestamp }) => ({
      id: txId,
      amountFormatted: `¥${amount.toFixed(2)}`,
      rawAmount: amount,
      date: new Date(timestamp * 1000).toISOString().split("T")[0]
    }))
    // 3. 按金额降序排序,并截取前 topN 项
    .sort((a, b) => b.rawAmount - a.rawAmount)
    .slice(0, topN);
}

const result = getTopSuccessTransactions(transactions);
console.log(result);
/* 最终输出结果:
[
  { id: "TX_102", amountFormatted: "¥1500.00", rawAmount: 1500, date: "2023-10-22" },
  { id: "TX_103", amountFormatted: "¥620.00",  rawAmount: 620,  date: "2023-10-22" },
  { id: "TX_100", amountFormatted: "¥250.00",  rawAmount: 250,  date: "2023-10-22" }
]
*/
五、总结与高频疑问解答
掌握数组操作的高效写法,核心在于建立清晰的算法复杂度直觉:
- 基本类型去重首选
[...new Set(arr)],不仅语义清晰,而且内部已解决NaN匹配陷阱; - 对象按键去重首选
Map收集,避免在filter内嵌套findIndex导致时间复杂度蜕化为 O(n²); - 排序严禁裸用
sort(),必须显式传递对比函数,同时使用toSorted()或解构克隆避免破坏原数组; - 链式组合遵循漏斗模型,始终“先过滤、后映射、再排序”,在保证代码可读性的同时获取最优吞吐表现。
JS语法错误会阻止加载吗?区分SyntaxError与资源加载失败
2026-11-05 16:08:46
JavaScript常见SyntaxError语法错误排查与修复方法
2026-11-05 13:58:44
JS中slice、substring和substr截取字符串的区别
2026-11-05 13:43:47
JS 转 TS 手动迁移最佳实践:从配置 tsconfig 到消除 any 类型
2026-11-05 11:53:32
为什么JS数组push后得到的是数字而不是数组?
2026-11-05 09:59:18







