100个JavaScript经典实例中涉及的数组处理技巧
系统梳理100个JavaScript经典实例中高频涉及的核心数组技巧,涵盖数据流水线清洗、不可变更新、多维扁平化、去重与集合运算、进阶归纳及方法选型。
在各类经典的JavaScript实战案例与算法实例中,绝大部分数据处理需求最终都会落到数组的操作上。对这100个涵盖购物车结算、用户列表筛选、树状菜单转换、数据去重与图表统计的经典实例进行归纳后可以发现,其核心代码并不在于死记某种冷门API,而在于掌握几套稳定、高复用且不易产生副作用的数组处理模式。本文系统拆解这100个实例中最具代表性的核心技巧,结合原理解析与代码实操,帮助读者建立系统清晰的数组处理思维。
一、数据流水线:链式操作与流式清洗
在处理列表查询、表单提交数据归一化等业务实例时,最常见的方式是构建由 filter、map、reduce 组成的无副作用数据处理流水线。通过流水线方式,原始数据按步骤过滤脏数据、提取目标字段并完成指标聚合,避免编写大量中间临时变量与混乱的嵌套循环。
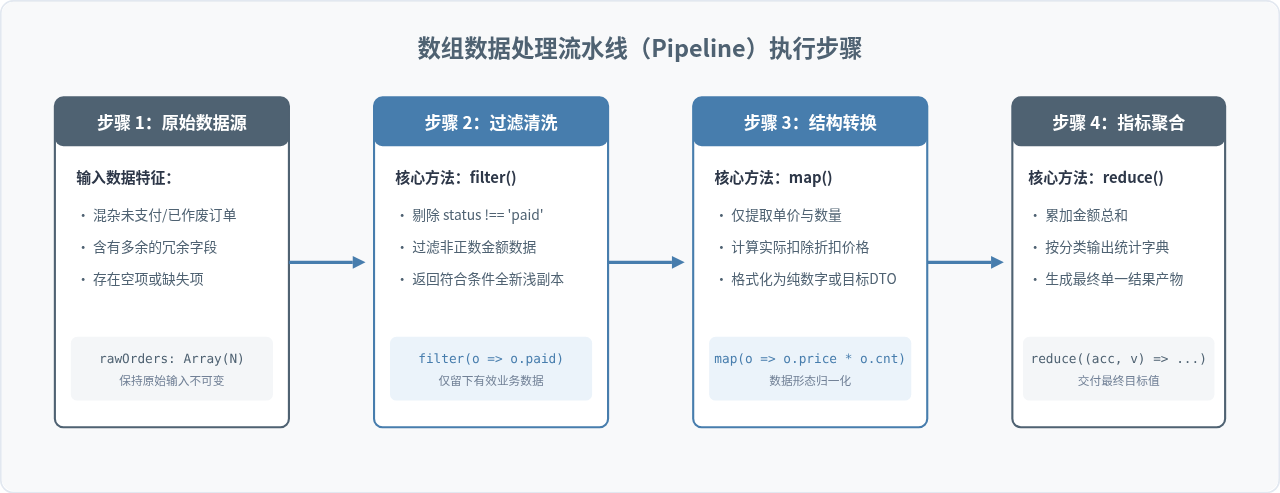
以下代码展示了一个标准的多步骤链式清洗实例:从包含未结算、非法字段的原始订单数组中,提取有效交易额并计算累计销售总额。
// 模拟来自服务端的订单实例数据
const rawOrders = [
  { orderId: 'A101', status: 'completed', price: 99.5, quantity: 2 },
  { orderId: 'A102', status: 'cancelled', price: 340.0, quantity: 1 },
  { orderId: 'A103', status: 'completed', price: 45.0, quantity: 3 },
  { orderId: 'A104', status: 'completed', price: -10.0, quantity: 1 }, // 脏数据
];

// 采用链式调用完成过滤、映射与统计
const totalRevenue = rawOrders
  .filter(order => order.status === 'completed' && order.price > 0)
  .map(order => order.price * order.quantity)
  .reduce((accumulator, subtotal) => accumulator + subtotal, 0);

// 输出示例:334 (即 99.5*2 + 45.0*3)
console.log('有效订单总收入:', totalRevenue);
二、变异与不可变:避免副作用的防御式更新
在前端UI组件开发(如React/Vue状态变更)及多模块通信实例中,最隐蔽的缺陷往往源自意外的原地修改(In-place Mutation)。传统的 sort()、reverse()、splice() 会直接改变原数组内部元素排列,当该数组被其他视图或计算逻辑引用时,就会引发难以追踪的竞态异常。
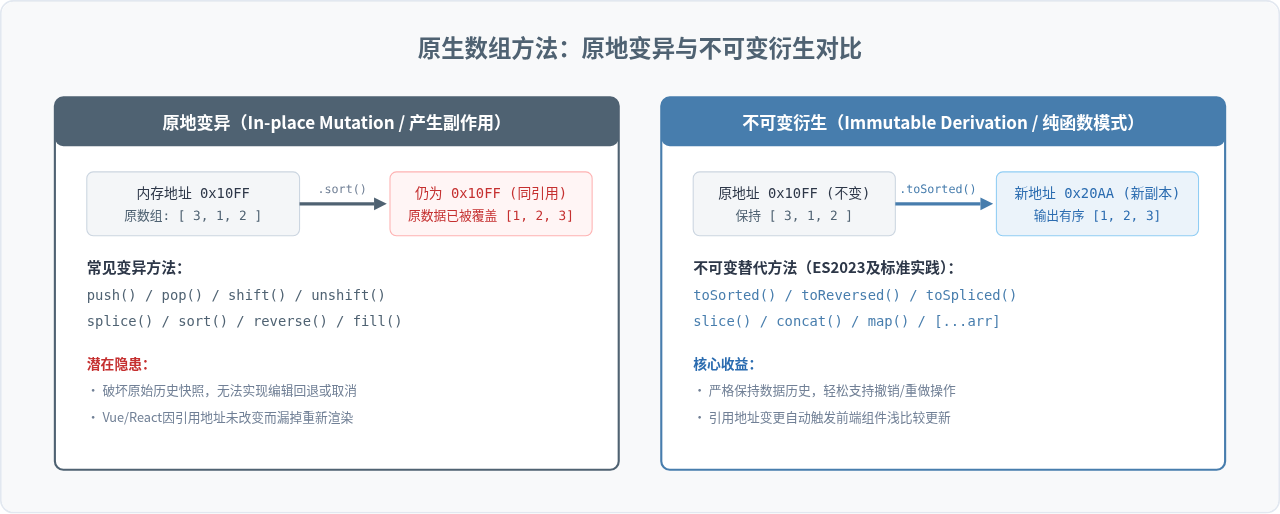
为了保障数据安全性,现代代码实例普遍遵循“浅拷贝后操作”或直接使用 ES2023 引入的不可变专属 API(如 toSorted、toSpliced):
const scores = [88, 72, 95, 60];

// 【经典旧写法】:先拷贝,再排序
const sortedScoresOld = [...scores].sort((a, b) => a - b);

// 【现代标准写法】:使用 toSorted 直接返回新排序数组,原数组不受影响
const sortedScoresModern = scores.toSorted((a, b) => a - b);

// 原数组保持不变
console.log('原数组:', scores); // [88, 72, 95, 60]
console.log('排序后新数组:', sortedScoresModern); // [60, 72, 88, 95]

// 针对指定索引的安全修改,避免 scores[1] = 80 的直接变异:
const updatedScores = scores.with(1, 80);
console.log('替换索引1后的新数组:', updatedScores); // [88, 80, 95, 60]
三、高维降解与集合运算:拍平、去重与交并差
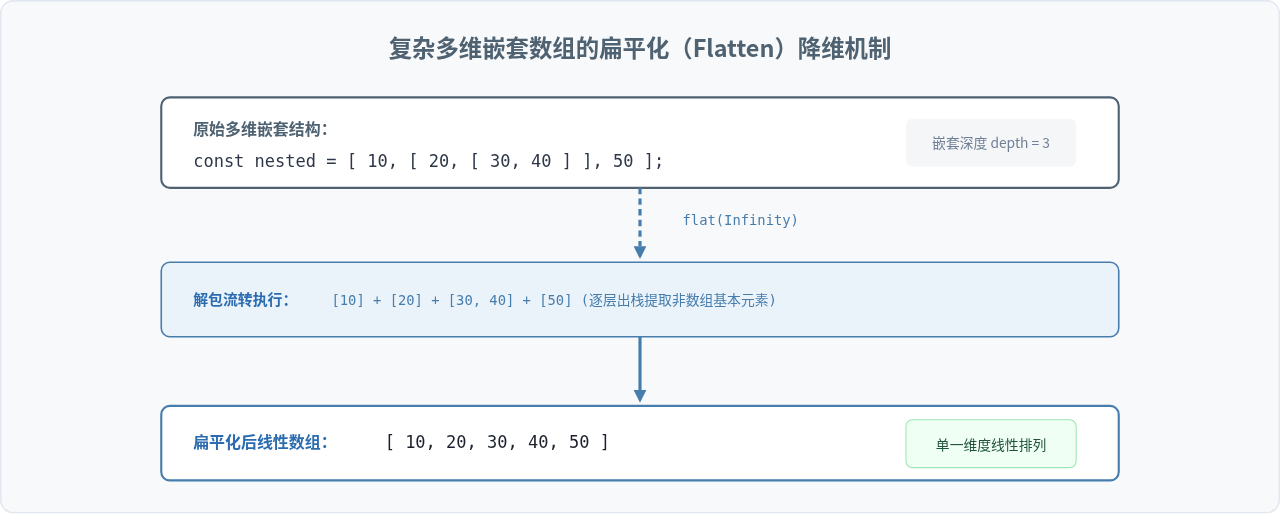
处理多级评论、无限级分类菜单或树形组织架构时,高维数组向一维平铺结构的转化属于高频需求。原生提供的 flat() 与 flatMap() 彻底替代了早期低效的多次递归拼接。
1. 数组去重方案选型
对于基础类型数组,直接利用 Set 的元素唯一性是最快且代码量最少的方法;但面对包含重复 id 的复杂对象数组时,使用 Map 才能做到以 O(N) 线性时间复杂度精准去重。
// 基础数值/字符串数组去重
const primitiveList = [1, 2, 2, 3, 4, 4, 5];
const uniquePrimitives = [...new Set(primitiveList)]; // [1, 2, 3, 4, 5]

// 业务对象数组去重:根据特定唯一主键(如 id)去重
const users = [
  { id: 101, name: 'Alice' },
  { id: 102, name: 'Bob' },
  { id: 101, name: 'Alice (Duplicate)' },
];

const uniqueUsers = Array.from(
  users.reduce((map, user) => {
    // 遇到重复id时保留首次出现的记录
    if (!map.has(user.id)) {
      map.set(user.id, user);
    }
    return map;
  }, new Map()).values()
);
console.log('对象数组去重结果:', uniqueUsers);
2. 集合运算(并集、交集、差集)
在权限比对、标签求交以及角色差异计算等实例中,结合 Set.prototype.has 的 O(1) 检索特性,可以高效完成两个数组的集合运算:
const setA = [1, 2, 3, 4];
const setB = [3, 4, 5, 6];

const cacheB = new Set(setB);

// 1. 交集 (Intersection)
const intersection = setA.filter(item => cacheB.has(item)); // [3, 4]

// 2. 差集 (Difference: 存在于 A 但不存在于 B)
const difference = setA.filter(item => !cacheB.has(item)); // [1, 2]

// 3. 并集 (Union)
const union = [...new Set([...setA, ...setB])]; // [1, 2, 3, 4, 5, 6]
四、聚合与分组:数据重构与矩阵切片
在报表输出或分页加载实例中,经常需要将连续数组拆分为定长的“批次(Chunk)”,或按某项业务属性对数组元素归类打包。
1. 数据分块(Chunking)
针对前端批量上报数据、虚拟表格分页展示场景,可以通过简单的步长循环实现无副作用分块:
function chunkArray(array, size) {
  if (!Array.isArray(array) || size <= 0) return [];
  const result = [];
  for (let i = 0; i < array.length; i += size) {
    result.push(array.slice(i, i + size));
  }
  return result;
}

// 示例:将10条数据按每页3条切分
const rawData = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
const pages = chunkArray(rawData, 3);
// 结果:[[1, 2, 3], [4, 5, 6], [7, 8, 9], [10]]
2. 动态分组归类
现代标准环境支持 Object.groupBy(),无需再手动编写复杂的 reduce 累加器即可按规则快速分类:
const inventory = [
  { name: 'Apple', type: 'fruit', stock: 12 },
  { name: 'Carrot', type: 'vegetable', stock: 25 },
  { name: 'Banana', type: 'fruit', stock: 5 },
];

// 使用原生标准分组方法
const groupedByType = Object.groupBy(inventory, item => item.type);
/*
输出结构示例:
{
  fruit: [
    { name: 'Apple', type: 'fruit', stock: 12 },
    { name: 'Banana', type: 'fruit', stock: 5 }
  ],
  vegetable: [
    { name: 'Carrot', type: 'vegetable', stock: 25 }
  ]
}
*/
五、方法选型与性能避坑指南
不同数组处理方法在执行机制与资源消耗上存在显著差异。在实际开发中,需要根据目标场景精准匹配相应的方法,规避无谓的遍历开销。
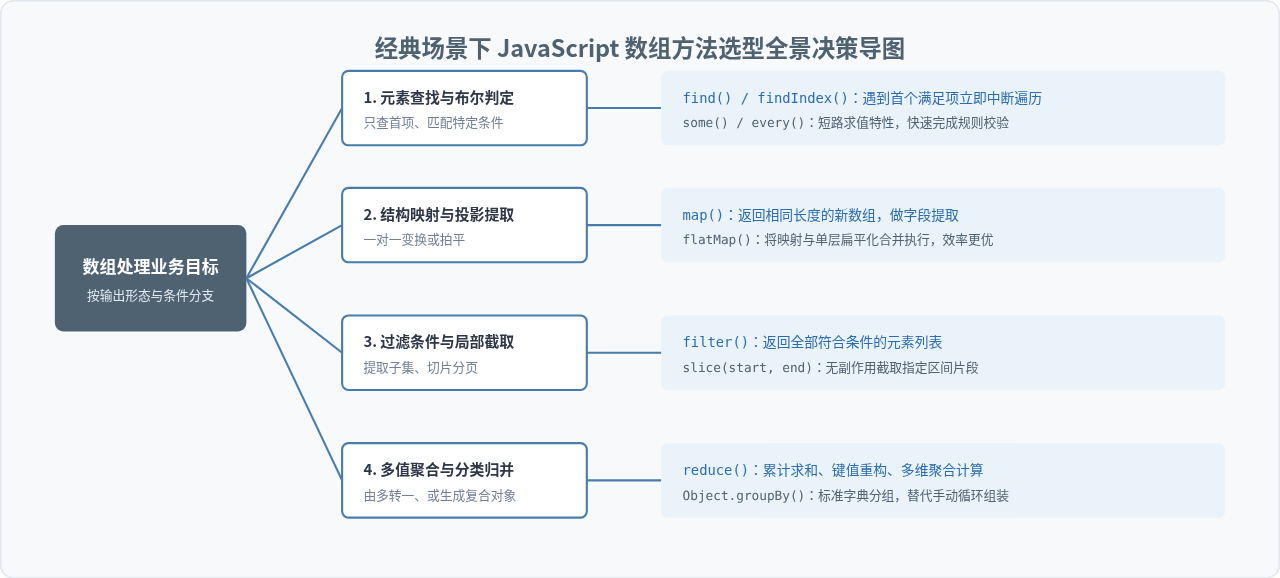
- 慎用
forEach进行存在性检查:forEach无法在中途通过break或return跳出。若仅需验证“是否存在”,务必改用短路求值的some()或find()。 - 大数据量场景避免长链式调用:当数组规模超过十万级时,过长的
.filter().map().filter()会多次在内存中分配临时中转数组。此时建议改用单次for...of循环或通过单次reduce一并处理完成。 - 保持排序回调返回数字:在使用
sort()或toSorted()时,比较函数必须返回确定性的正数、负数或零(例如a - b),切勿返回布尔值(如a > b),否则会导致各浏览器引擎排序结果不一致。
掌握以上数据管道化、不可变衍生、降维集合以及方法决策策略,便能从容应对绝大部分高频JavaScript实例中的数组操作挑战,写出既健壮又易于维护的高质量代码。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13