

图解JavaScript:深入理解作用域、作用域链与闭包机制
本文深入解析JavaScript中的作用域、作用域链及闭包的核心概念。详细阐述变量访问流程、作用域链的形成与延长机制,并通过实验数据对比分析查找距离与节点变量对性能的影响。同时介绍闭包的实现方式、应用场景及注意事项,帮助开发者理解内存管理与封装原理。
JavaScript作用域基础
什么是作用域?
作用域是一套在代码编译阶段即已确定的规则,它定义了变量和函数可以被访问的范围。全局变量具备全局作用域,而局部变量则处于局部作用域中。JavaScript是一种不具备块级作用域的语言,这意味着if、for等语句的花括号代码块,或者独立的花括号代码块,均无法形成局部作用域。因此,JavaScript中局部作用域的创建仅有一种方式,即通过函数花括号内定义的代码块来形成函数作用域。
作用域链机制
什么是作用域链?
作用域链是作用域规则的具体实现机制。通过作用域链,变量可以在其所属的作用域内被访问,函数也可以在其作用域内被调用。
作用域链是一个单向访问的链表结构。链表中的每个节点代表执行上下文的变量对象(在代码执行期间称为活动对象)。单向链表的头部(即第一个可被访问的节点)始终是当前正在被调用执行的函数的变量对象(活动对象),而链表的尾部则始终是全局活动对象。
作用域链的形成?
我们可以通过一段代码的执行过程来观察作用域链是如何形成的。
function fun01 () {
 console.log('i am fun01...');
 fun02();
}
function fun02 () {
 console.log('i am fun02...');
}
fun01();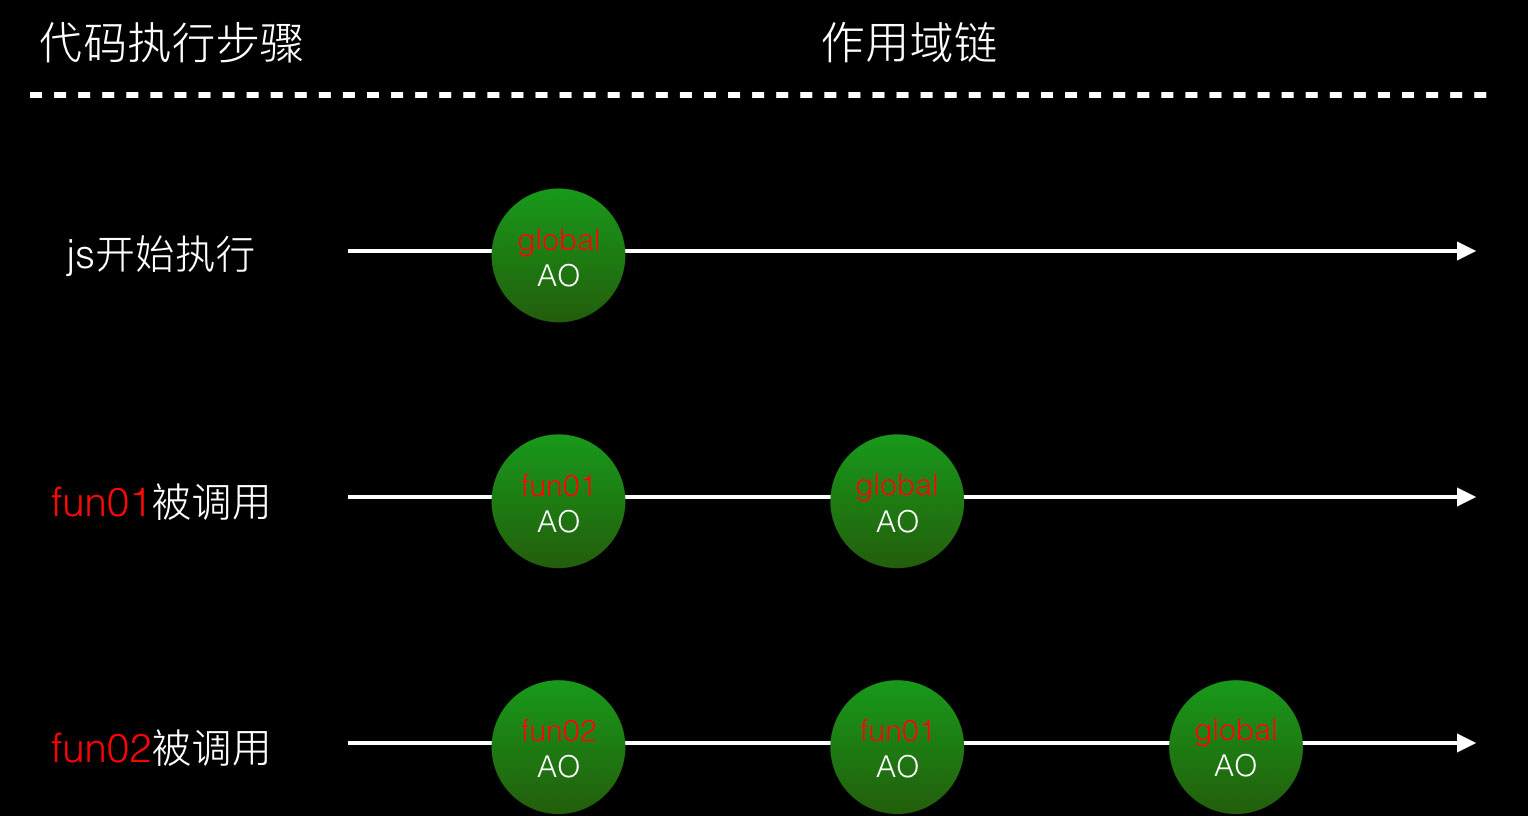
数据访问流程
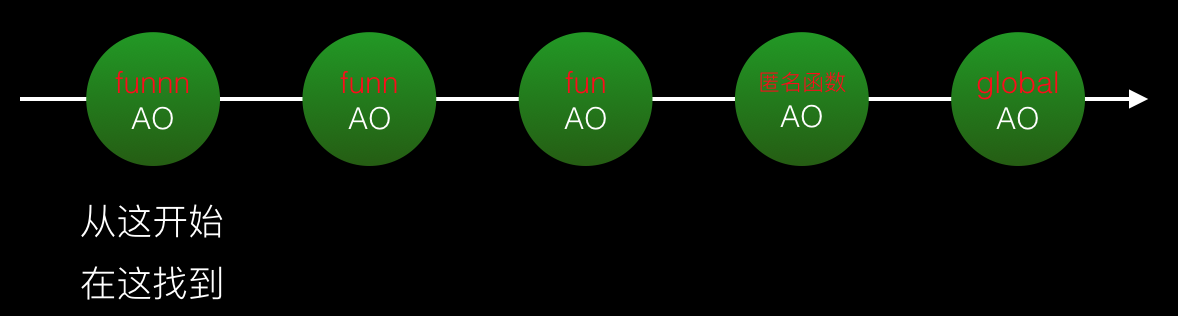
如上图所示,当程序尝试访问一个变量时,依据作用域链的单向访问特性,系统首先会在头节点的活动对象(AO)中查找。如果未找到,则继续向下一个节点的AO查找,直至到达尾节点(global AO)。若在此过程中找到变量,则返回该值;若遍历完整个链仍未找到,则报错undefined。
延长作用域链
从上述作用域链的形成过程可以看出,链表上的每个节点是在函数被调用执行时,将当前函数的AO通过unshift操作插入到链头形成的。此外,节点的形成还有另一种方式,即“延长作用域链”,也就是在作用域链的头部插入一个特定的对象作用域。延长作用域链主要有两种方式:
1.with语句
function fun01 () {
 with (document) {
  console.log('I am fun01 and I am in document scope...')
 }
}
fun01();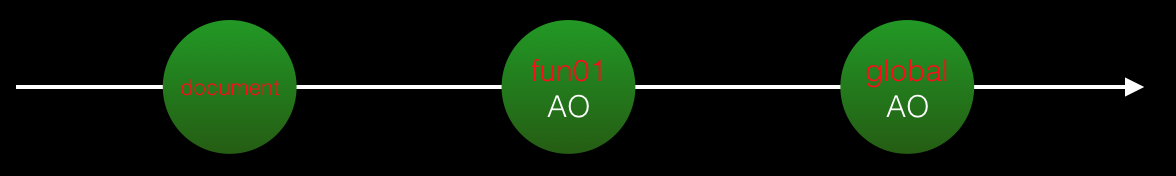
2.try-catch语句的catch块
function fun01 () {
 try {
  console.log('Some exceptions will happen...')
 } catch (e) {
  console.log(e)
 }
}
fun01();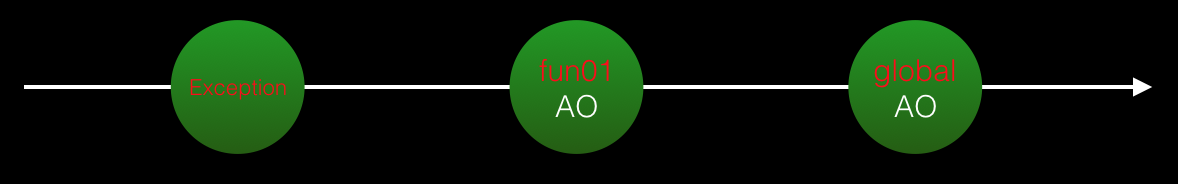
ps:个人感觉with语句使用需求不多,try-catch的使用也是看需求的。个人对这两种使用不多,但是在进行这部分整理过程中萌发了一点点在作用域链层面的不成熟的性能优化小建议。
作用域链性能优化分析
由作用域链引发的关于性能优化的一点不成熟的小建议
1.减少变量的作用域链的访问节点
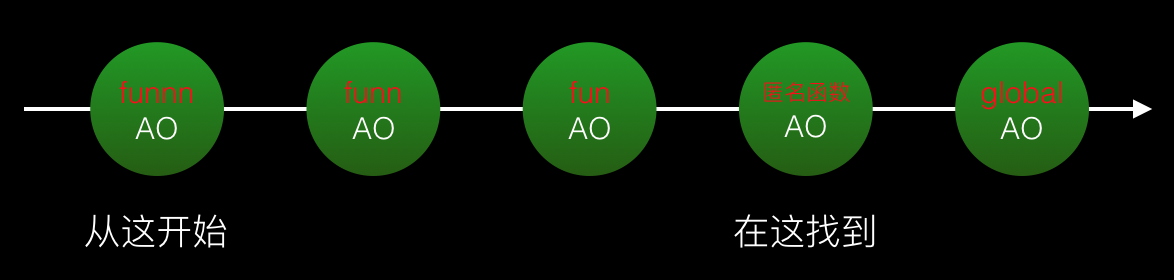
这里我们自定义一个名词叫做“查找距离”,表示程序访问到一个非undefined变量在作用域链中经过的节点数。因为如果在当前节点没有找到变量,就跳到下一个节点查找,还要进行判断下一个节点中是否存在被查找变量。“查找距离”越长,要做的“跳”动作和“判断”动作也就越多,资源开销就越大,从而影响性能。这种性能带来的差距可能少数的几次变量查找操作不会带来太多性能问题,但如果是多次进行变量查找,性能对比则比较明显了。
(function(){
 console.time()
 var find = 1      //这个find变量需要在4个作用域链节点进行查找
 function fun () {
  function funn () {
   var funnv = 1;
   var funnvv = 2;
   function funnn () {
    var i = 0
    while(i <= 100000000){
     if(find){
      i++
     }
    }
   }
   funnn()
  }
  funn()
 }
 fun()
 console.timeEnd()
})()
(function(){
 console.time()
 function fun () {
  function funn () {
   var funnv = 1;
   var funnvv = 2;
   function funnn () {
    var i = 0
    var find = 1      //这个find变量只在当前节点进行查找
    while(i <= 100000000){
     if(find){
      i++
     }
    }
   }
   funnn()
  }
  funn()
 }
 fun()
 console.timeEnd()
})()
在mac pro的chrome浏览器下做实验,进行1亿次查找运算。
实验结果:前者运行5次平均耗时85.599ms,后者运行5次平均耗时63.127ms。
2.避免作用域链内节点AO上过多的变量定义
过多的变量定义造成性能问题的原因主要是查找变量过程中的“判断”操作开销较大。我们使用with来进行性能对比。
(function(){
 console.time()
 function fun () {
  function funn () {
   var funnv = 1;
   var funnvv = 2;
   function funnn () {
    var i = 0
    var find = 10
    with (document) {
     while(i <= 1000000){
      if(find){
       i++
      }
     }
    }
   }
   funnn()
  }
  funn()
 }
 fun()
 console.timeEnd()
})()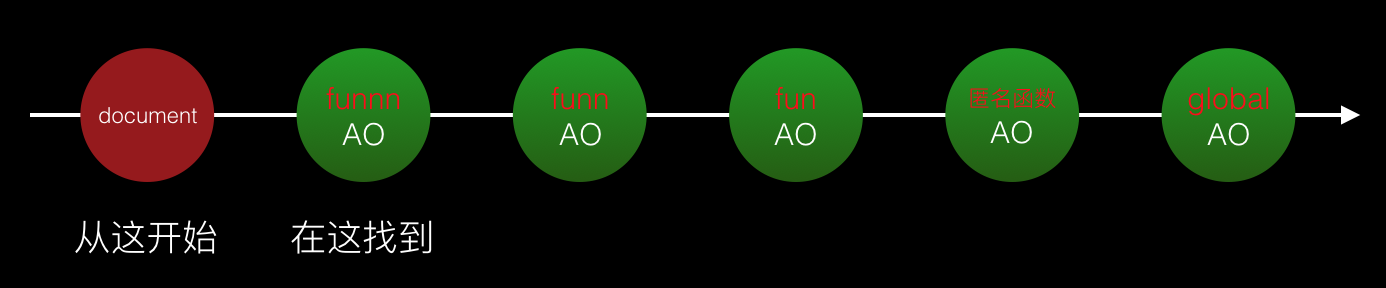
在mac pro的chrome浏览器下做实验,进行100万次查找运算,借助with使用document进行的延长作用域链,因为document下的变量属性比较多,可以测试在多变量作用域链节点下进行查找的性能差异。
实验结果:5次平均耗时558.802ms,而如果删掉with和document,5次平均耗时0.956ms。
当然,这两个实验是在我们假设的极端环境下进行的,结果仅供参考!
闭包原理与应用
关于闭包
1.什么是闭包?
函数对象可以通过作用域链相互关联起来,函数体内的数据(变量和函数声明)都可以保存在函数作用域内,这种特性在计算机科学文献中被称为“闭包”。既函数体内的数据被隐藏于作用于链内,看起来像是函数将数据“包裹”了起来。从技术角度来说,js的函数都是闭包:函数都是对象,都关联到作用域链,函数内数据都被保存在函数作用域内。
2.闭包的几种实现方式
实现方式就是函数A在函数B的内部进行定义了,并且当函数A在执行时,访问了函数B内部的变量对象,那么B就是一个闭包。如下:
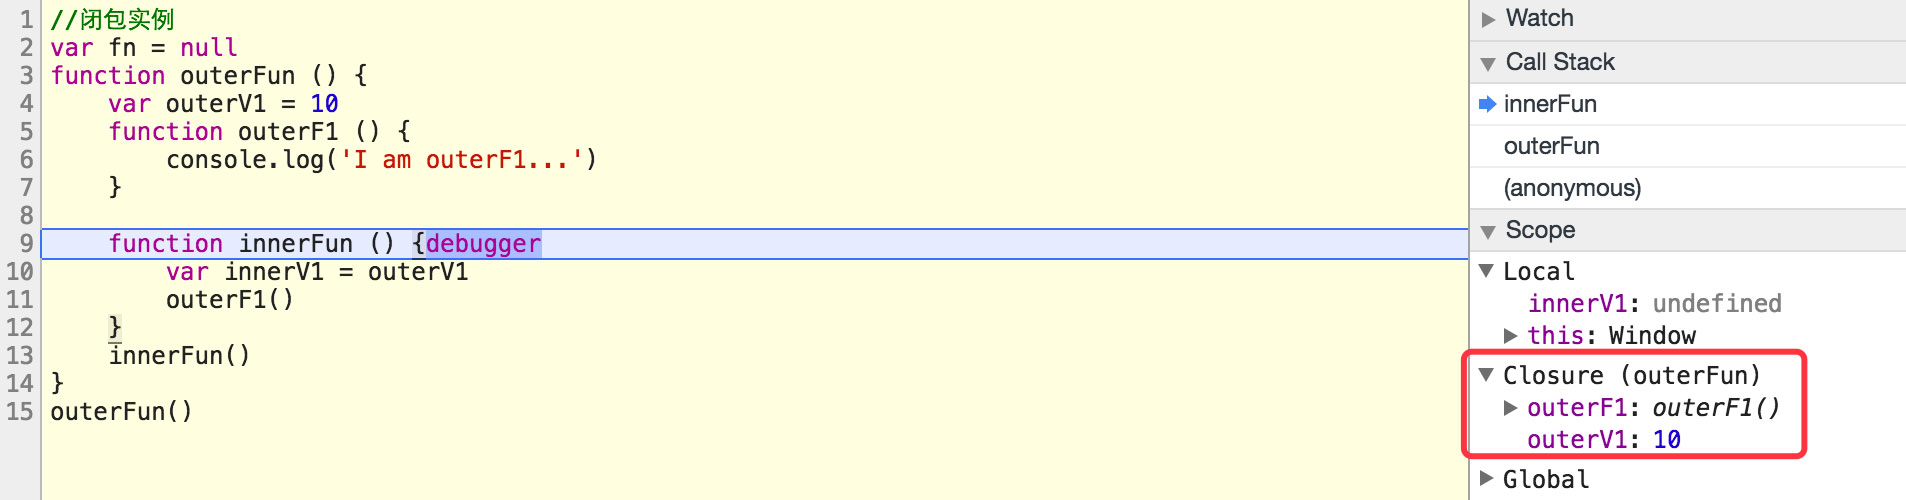
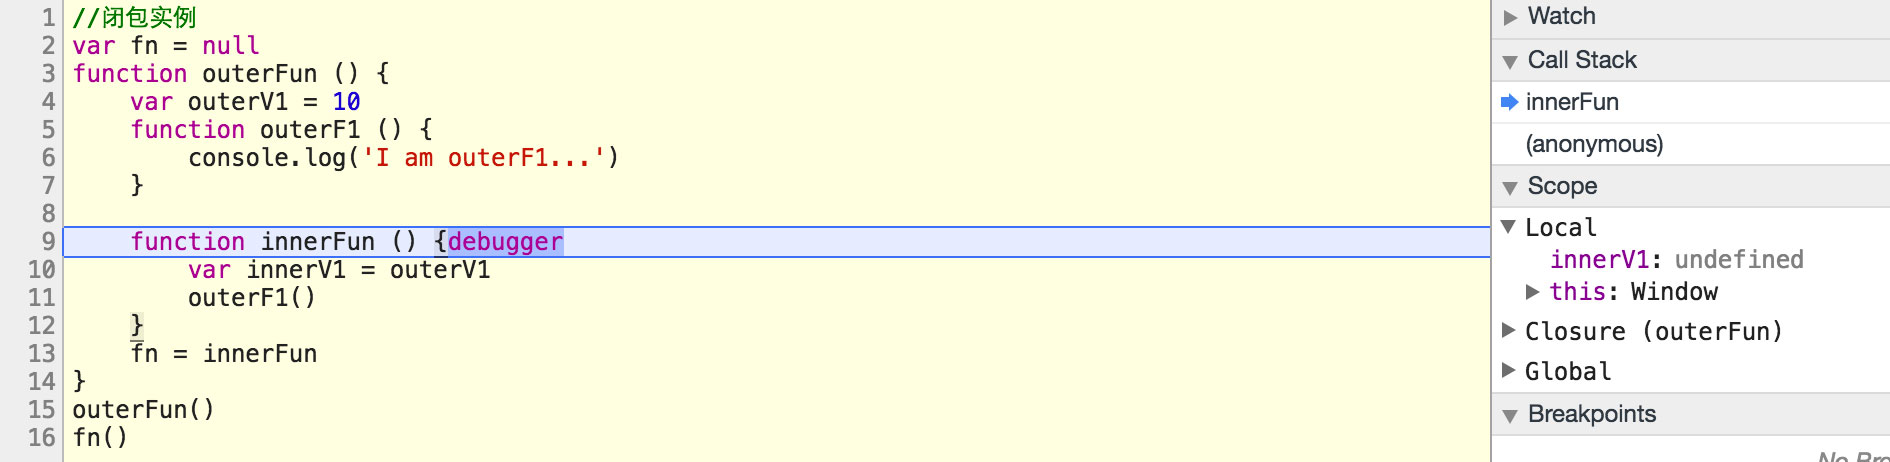
如上两图所示,是在chrome浏览器下查看闭包的方法。两种方式的共同点是都有一个外部函数outerFun(),都在外部函数内定义了内部函数innerFun(),内部函数都访问了外部函数的数据。不同的是,第一种方式的innerFun()是在outerFun()内被调用的,既声明和被调用均在同一个执行上下文内。而第二种方式的innerFun()则是在outerFun()外被调用的,既声明和被调用不在同一个执行上下文。第二种方式恰好是js使用闭包常用的特性所在:通过闭包的这种特性,可以在其他执行上下文内访问函数内部数据。
我们更常用的一种方式则是这样的:
//闭包实例
function outerFun () {
 var outerV1 = 10
 function outerF1 () {
  console.log('I am outerF1...')
 }
 function innerFun () {
  var innerV1 = outerV1
  outerF1()
 }
 return innerFun //return回innerFun()内部函数
}
var fn = outerFun()  //接到return回的innerFun()函数
fn()     //执行接到的内部函数innerFun()
此时它的作用域链是这样的:
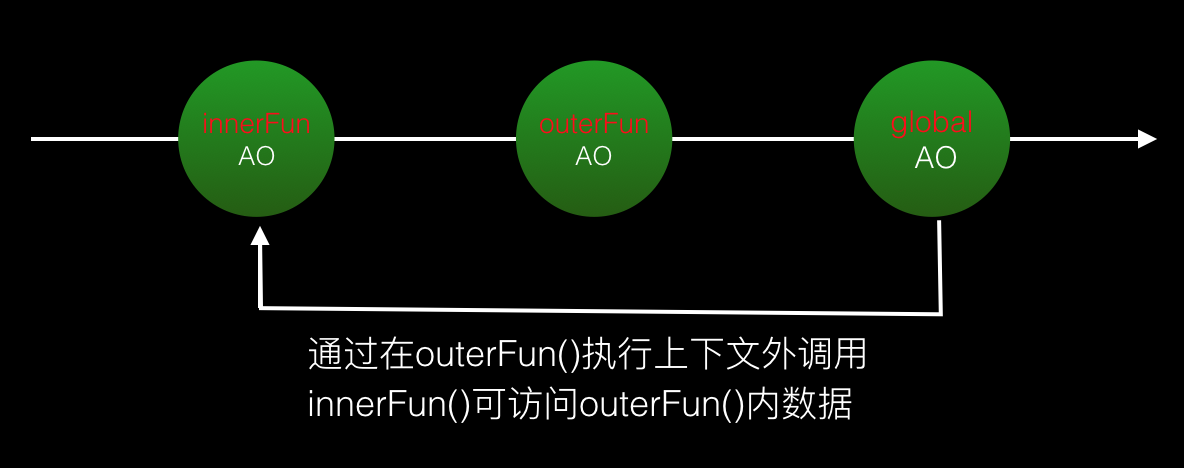
3.闭包的好处及使用场景
js的垃圾回收机制可以粗略的概括为:如果当前执行上下文执行完毕,且上下文内的数据没有其他引用,则执行上下文pop出call stack,其内数据等待被垃圾回收。而当我们在其他执行上下文通过闭包对执行完的上下文内数据仍然进行引用时,那么被引用的数据则不会被垃圾回收。就像上面代码中的outerV1,放我们在全局上下文通过调用innerFun()仍然访问引用outerV1时,那么outerFun执行完毕后,outerV1也不会被垃圾回收,而是保存在内存中。另外,outerV1看起来像不像一个outerFun的私有内部变量呢?除了innerFun()外,我们无法随意访问outerV1。所以,综上所述,这样闭包的使用情景可以总结为:
(1)进行变量持久化。
(2)使函数对象内有更好的封装性,内部数据私有化。
进行变量持久化方面举个栗子:
我们假设一个需求时写一个函数进行类似id自增或者计算函数被调用的功能,普通青年这样写:
 var count = 0
 function countFun () {
  return count++
 }
这样写固然实现了功能,但是count被暴露在外,可能被其他代码篡改。这个时候闭包青年就会这样写:
function countFun () {
 var count = 0
 return function(){
  return count++
 }
}
var a = countFun()
a()
这样count就不会被不小心篡改了,函数调用一次就count加一次1。而如果结合“函数每次被调用都会创建一个新的执行上下文”,这种count的安全性还有如下体现:
function countFun () {
 var count = 0
 return {
  count: function () {
   count++
  },
  reset: function () {
   count = 0
  },
  printCount: function () {
   console.log(count)
  }
 }
}
var a = countFun()
var b = countFun()
a.count()
a.count()
b.count()
b.reset()
a.printCount()  //打印:2 因为a.count()被调用了两次
b.printCount()  //打印出:0 因为调用了b.reset()
以上便是闭包提供的变量持久化和封装性的体现。
4.闭包的注意事项
由于闭包中的变量不会像其他正常变量那种被垃圾回收,而是一直存在内存中,所以大量使用闭包可能会造成性能问题。
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,同时也希望多多支持本站!
JavaScript怎么准确判断数据类型:typeof、instanceof与Object.prototype.toString
2026-11-05 17:09:21
JS中将数组和对象混合组装为JSON字符串
2026-11-05 16:41:42
JS运算符优先级与结合性的区别是什么?
2026-11-05 13:22:02
JS Map怎么只遍历Key或Value
2026-11-05 13:00:36
D3.js 与 ECharts 选型对比:灵活性 vs 开发效率
2026-11-05 09:45:01