Ramda与Lodash/fp:JavaScript函数式编程库怎么选
面对JavaScript函数式编程库选型,本文从核心设计哲学、参数顺序与柯里化、不可变状态更新、打包体积及团队迁移成本等多维度深入对比Ramda与Lodash/fp,并给出明确的场景选型指南。
假设你正在重构一个电商订单统计模块:业务需要从数十个层级嵌套的订单中过滤出已支付订单、按用户所在区域分组、累加计算优惠后实付金额,并生成最终对账数据。若直接采用原生 map、filter 与深层结构解构,代码层层嵌套,一旦出现临时状态变更极易引发副作用;而若是引入辅助库,又面临一个经典抉择——是用严格纯正的 Ramda,还是选用与老牌工具库一脉相承的 Lodash/fp?结论明确:如果项目从零构建、追求严格的无副作用函数组合与精细的 Lens 数据透镜操作,优先选择 Ramda;如果项目已深嵌 Lodash 依赖、注重团队平滑迁移与现成工具函数的丰富性,选择 Lodash/fp 是更低风险且高效的选择。
一、为什么是它们?共同的核心:Data-Last 与自动柯里化
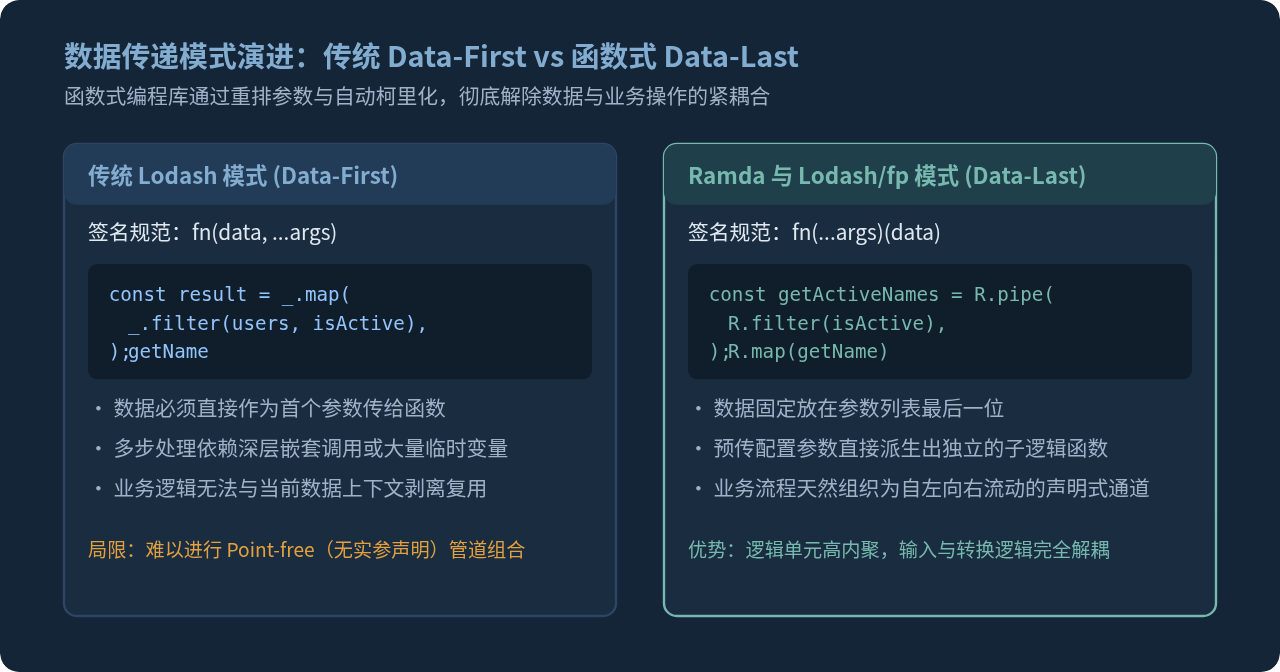
传统的 JavaScript 工具库(包括默认的 Lodash 或 Underscore)多采用“数据优先”(Data-First)的 API 签名设计,例如 _.map(collection, iteratee)。这种设计的首个参数必须是待操作的数据集。当业务流程由多个步骤连续串联时,开发者要么建立大量中间变量,要么写出由内向外阅读的嵌套调用:_.map(_.filter(users, isActive), getName),不仅视觉负担重,更切断了函数的独立复用能力。
Ramda 与 Lodash/fp 共同解决的痛点正是这一点。它们均确立了两项基础规范:
- 数据置后(Data-Last):所有函数的配置参数(如谓词函数、转换规则、路径)均位于前列,而被处理的数据始终作为最后一个参数传入。
- 自动柯里化(Curried by default):所有多参数函数默认全部柯里化。未传满参数时,函数不会执行,而是返回一个等待接收剩余参数的新函数。
这两项特性让“先组装业务流程、后灌入业务数据”的管道式编程(Pipeline)成为现实,开发者可以使用 compose(从右向左)或 pipe(从左向右)将零散的微小函数拼装为完整的处理流水线。
二、核心机制与编码体验差异
虽然表面上两库都支持 pipe 与 curry,但底层的设计理念决定了它们在实际编码体验上的深刻差异。
1. 柯里化与参数元数(Arity)控制
Ramda 的设计宗旨是纯粹的代数结构与函数式规范。Ramda 函数在声明时严格保证固定的参数个数(Arity)。无论调用形式如何,传足参数才会出值,未足则恒等返回柯里化形态。Ramda 还提供了全局占位符 R.__,允许在非末尾参数缺失时灵活插桩。
Lodash/fp 则是基于既有 Lodash 函数库的自动适配层。原版 Lodash 充斥着大量支持可选参数、多态参数的函数(如 _.parseInt(string, [radix]))。为了让这些多参数函数适应柯里化,Lodash/fp 对所有原生方法执行了“固定元数(Fixed Arity)”限制。例如在 lodash/fp 中,map 的回调只接收 1 个参数 value,而原生 Lodash 的 index 和 collection 被主动舍弃,以此避免在柯里化组合中产生意外的求值副作用。
2. 不可变数据修改:Lens 透镜 vs 路径字符串
在深层对象更新时,两者提供了截然不同的抽象高度:
- Ramda 的 Lens(透镜)模型:将数据的定位(Getter)与更新(Setter)打包成一个一等公民实体。通过
R.lensPath(['user', 'profile', 'email'])获得透镜后,可以分别通过R.view查看值、R.set替换值、R.over应用转换函数,整个过程原对象完全不可变且组合能力极强。 - Lodash/fp 的 Path 更新:延续了 Lodash 惯用的属性路径字符串或数组语法,如
fp.set('user.profile.email', 'new@work.com')或fp.update('count', fp.add(1))。概念更加直接,没有代数透镜的心智负担。
三、实际代码对比:完成同一业务任务
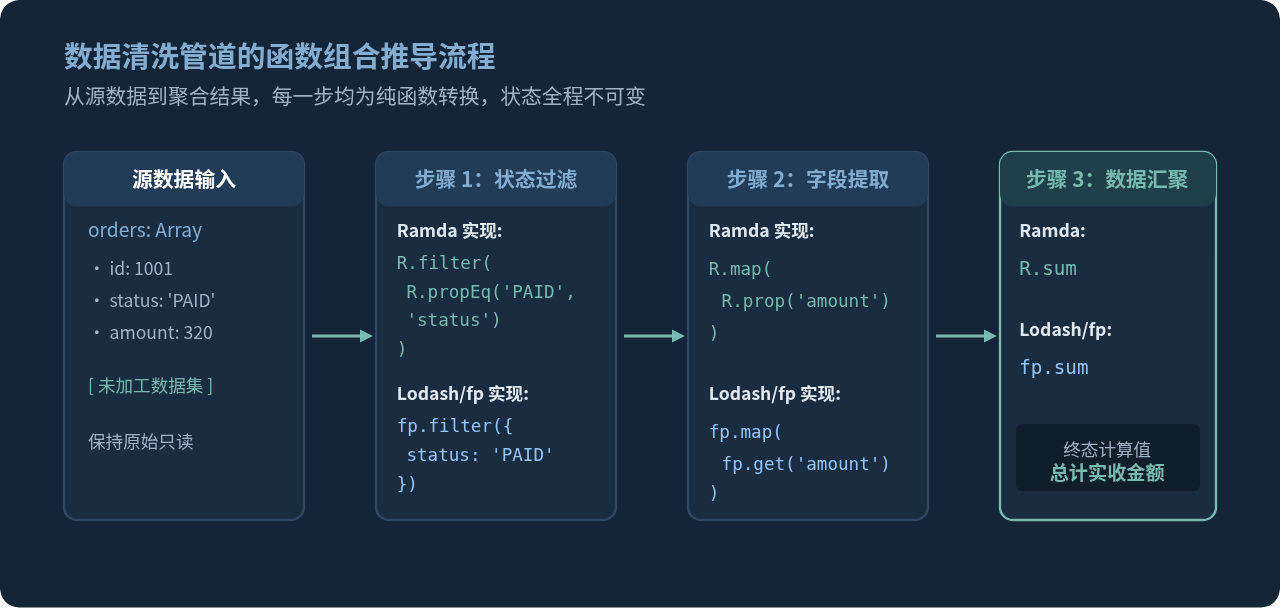
为了直观感受两者在书写风格上的不同,我们用一个包含嵌套更新和分组统计的实际业务案例进行对照。
需求:统计活跃用户在指定分类下的消费总额
给定包含用户基础信息和订单明细的原始对象,需要:筛选 isActive: true 的用户,挑出 category: 'electronics' 的订单项,提取支付金额并求和,最终以结构化数据输出。
1. Ramda 编写方式:
import * as R from 'ramda';

const calculateCategoryTotal = (targetCategory) => R.pipe(
  // 1. 过滤出有效用户
  R.filter(R.propEq(true, 'isActive')),
  // 2. 扁平化映射所有订单项
  R.chain(R.propOr([], 'orders')),
  // 3. 过滤出目标类别的订单
  R.filter(R.propEq(targetCategory, 'category')),
  // 4. 提取金额
  R.map(R.propOr(0, 'price')),
  // 5. 求和
  R.sum
);

// 执行计算
const total = calculateCategoryTotal('electronics')(userList);
2. Lodash/fp 编写方式:
import fp from 'lodash/fp';

const calculateCategoryTotal = (targetCategory) => fp.pipe(
  // 1. 过滤出有效用户
  fp.filter({ isActive: true }),
  // 2. 扁平化映射所有订单项
  fp.flatMap(fp.getOr([], 'orders')),
  // 3. 过滤出目标类别的订单
  fp.filter({ category: targetCategory }),
  // 4. 提取金额
  fp.map(fp.getOr(0, 'price')),
  // 5. 求和
  fp.sum
);

// 执行计算
const total = calculateCategoryTotal('electronics')(userList);
从代码中可以看出:
- Lodash/fp 允许直接传入匹配对象
{ isActive: true }作为断言谓词,对熟悉常规 Lodash 的工程师而言极其亲切,无需额外引入propEq这类概念。 - Ramda 的表达更加严格,谓词与属性访问必须使用明确的纯函数进行合成,保证每一处逻辑都具有完全可控的代数透明度。
四、工程全景对比:设计哲学、生态与打包体积
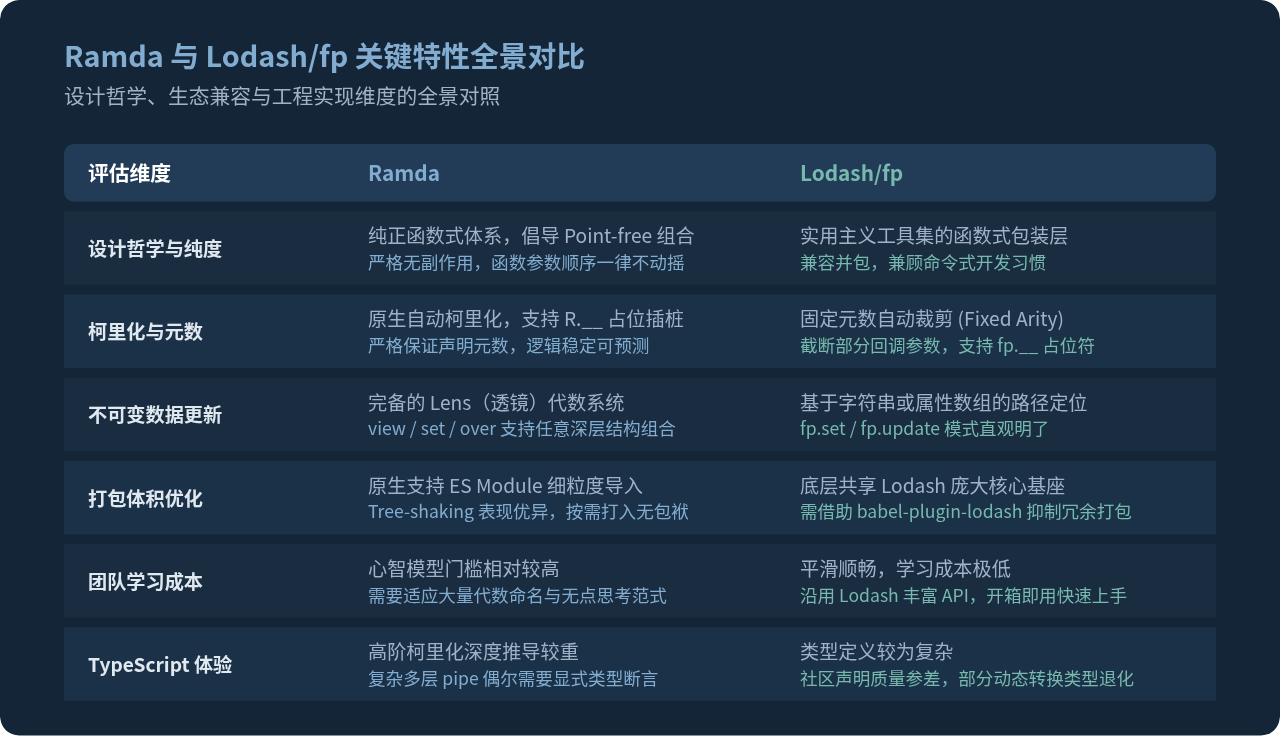
1. 打包体积与构建优化
在前端打包场景中,体积控制是关键指标:
- Ramda:采用模块化结构编写,若在项目中书写
import pipe from 'ramda/src/pipe';或使用支持 ES Module 的现代构建工具(如 Vite, Rollup, Webpack 5),Tree-shaking 能够精准剔除未引用的函数。单函数引入的开销极低。 - Lodash/fp:因为
lodash/fp是在整个 lodash 基础库上通过运行时的包装逻辑生成的,如果直接执行import fp from 'lodash/fp',构建工具极难剔除未用代码,往往会打包数十 KB 的完整库体。要实现按需引入,必须单独书写深层路径(如import map from 'lodash/fp/map'),或者在构建流程中配置babel-plugin-lodash。
2. TypeScript 支持现状
在强类型项目中,两者的高阶柯里化推导都会遇到类型系统极限:
由于 JavaScript 的自动柯里化允许任意部分应用(Partial Application),在 TypeScript 中需要通过大量函数重载(Overloads)来模拟推导。无论是 @types/ramda 还是 @types/lodash/fp,在传递多于 4-5 个步骤的 pipe 管道时,泛型推导都可能发生类型断层,退化为 any 或报错。在大型 TypeScript 项目中,如果涉及复杂的深层管道,往往需要辅助手写返回值类型注释。
五、技术选型决策流程与落地建议
做选型时,切忌脱离团队技术现状去追求理论上的“纯粹”。根据以下决策树,你可以迅速锁定适合本项目的技术方案:
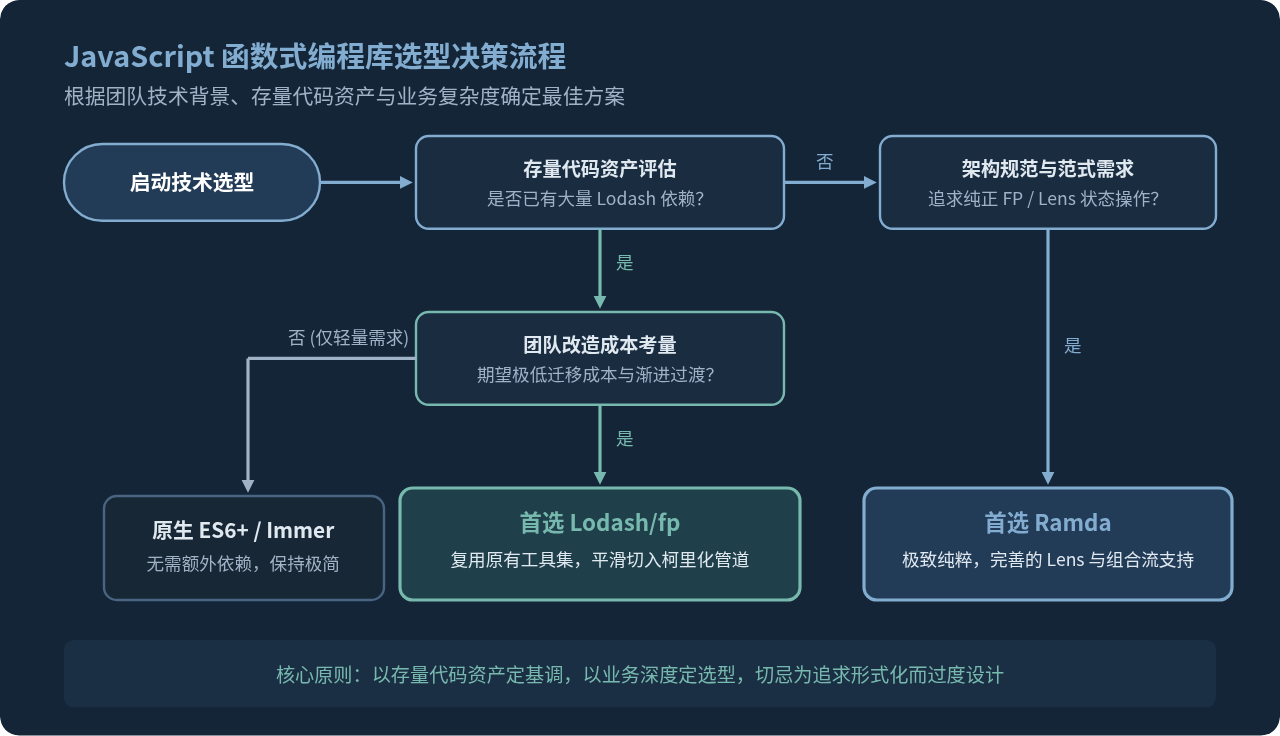
明确的适用场景归类:
- 推荐选用 Ramda 的场景:
- 全新技术项目:没有历史代码羁绊,团队希望建立高一致性、以不可变数据为核心的架构底座。
- 状态推演极其复杂:应用中包含复杂的嵌套树状数据模型,需要利用
Lens优雅地提取和更新节点,避免大量展开运算符破坏可读性。 - 注重纯函数式代码规范:团队熟悉或希望实践 Point-free 风格与代数数据类型。
- 推荐选用 Lodash/fp 的场景:
- 存量项目平滑改造:工程中已有成百上千处常规 Lodash 调用。引入
lodash/fp几乎零学习成本,同一依赖包内即可享用数据后置与柯里化特性。 - 重度依赖实用算法工具:需要使用如节流防抖、深度克隆、字符串多态转换等 Lodash 特有的实用方法,这些往往超出纯代数库的关注范畴。
- 团队成员背景多样:团队中有不少习惯命令式开发的新成员,Lodash/fp 容错性更好,上手阻力小。
- 存量项目平滑改造:工程中已有成百上千处常规 Lodash 调用。引入
六、实践避坑与调试指南
为了让函数式流水线在实际生产环境中稳健运行,建议遵守以下工程规范:
- 插入 Tap 探针调试:无论在 Ramda 还是 Lodash/fp 中,不要破坏纯函数的流动结构去打印日志。善用
R.tap(console.log)或fp.tap(console.log),它可以在不改变流动数据的前提下截获当前步骤的中间值。 - 关注大型集合的不可变性能开销:函数式库在更新对象时均会生成浅拷贝新对象。如果是在动画帧、高频 WebSocket 消息推送等热点循环中处理数万条记录,频繁的对象分配可能引发 GC(垃圾回收)停顿。这种极端性能瓶颈处应局部降级为受控的可变操作。
- 业务函数命名语义化:拆分到 pipe 中的每一个小函数务必给出明确业务含义的具名命名(例如
const isPaidOrder = R.propEq('PAID', 'status')),切忌在 pipe 内部内联大量复杂的匿名三元表达式。
JS语法错误会阻止加载吗?区分SyntaxError与资源加载失败
2026-11-05 16:08:46
JavaScript常见SyntaxError语法错误排查与修复方法
2026-11-05 13:58:44
JS中slice、substring和substr截取字符串的区别
2026-11-05 13:43:47
JS 转 TS 手动迁移最佳实践:从配置 tsconfig 到消除 any 类型
2026-11-05 11:53:32
为什么JS数组push后得到的是数字而不是数组?
2026-11-05 09:59:18