

国内大型网站JavaScript应用解析:淘宝、知乎的技术选型
深入解析国内两大典型互联网平台——淘宝与知乎在不同业务形态驱动下的JavaScript技术栈选型、架构演进路径与性能优化策略。
评估一个大型网站的技术选型,不能脱离它所承载的核心商业模式与用户交互场景。淘宝代表了极高流量吞吐、强交易属性、营销活动变动频繁且依赖端渲染能力的大型电商平台;知乎则代表了强文本阅读、重度依赖搜索引擎抓取(SEO)、社区交互即时性高且拥有复杂长文富文本创作的内容社区。本文将直入核心,解析淘宝与知乎在前端 JavaScript 架构演进中的选型考量、落地做法与工程权衡,帮助开发者建立体系化的大型网站架构推导能力。
一、业务形态决定技术选型的底层逻辑
前端技术从来不是孤立演进的。框架与运行时的更迭,其背后本质是商业效率、研发协作规模与端侧性能指标之间的动态平衡。淘宝与知乎在 JavaScript 栈选型上的巨大分野,直接源于两者在以下核心诉求上的不同:
- 页面首屏诉求与加载容忍度:电商场景下,首屏渲染时长每增加 100 毫秒就会直接导致转化率与 GMV 的统计学下滑,因此淘宝对纯静态秒开、预加载和端侧渲染容器有着近乎苛刻的要求;内容社区虽然重视首屏,但用户对长文、回答列表的加载有更高的心理预期,核心在于能否快速呈现可读文本。
- 搜索引擎抓取与社交分享索引:知乎极其依赖百度、搜狗以及微信等外部蜘蛛爬取全网问答,因此完整的 HTML 服务端生成(SSR)是不可撼动的底线;而淘宝的移动端核心链路绝大多数封闭在 App 内,公网搜索引擎抓取并非主战场,技术重心放在私域流转与端内加速。
- 组件与模块变动频次:淘宝大促期间各业务线(天猫、聚划算、各行业频道)需要频繁组装会场模块,要求前端具备极强的模块解耦与动态下发能力;知乎的页面骨架相对稳定,变化主要集中于内容本身的流式呈现与互动挂件。
二、淘宝的 JavaScript 应用架构演进与选型实践
淘宝的前端历程堪称国内 Web 工业化演进的缩影。从 PC 时代的自主造轮子,到移动时代的跨端容器,再到现代化微前端与流式渲染体系,其技术选型始终围绕“海量业务并行研发”与“极端性能优化”展开。
1. 从自研库 KISSY 到跨端框架 Rax
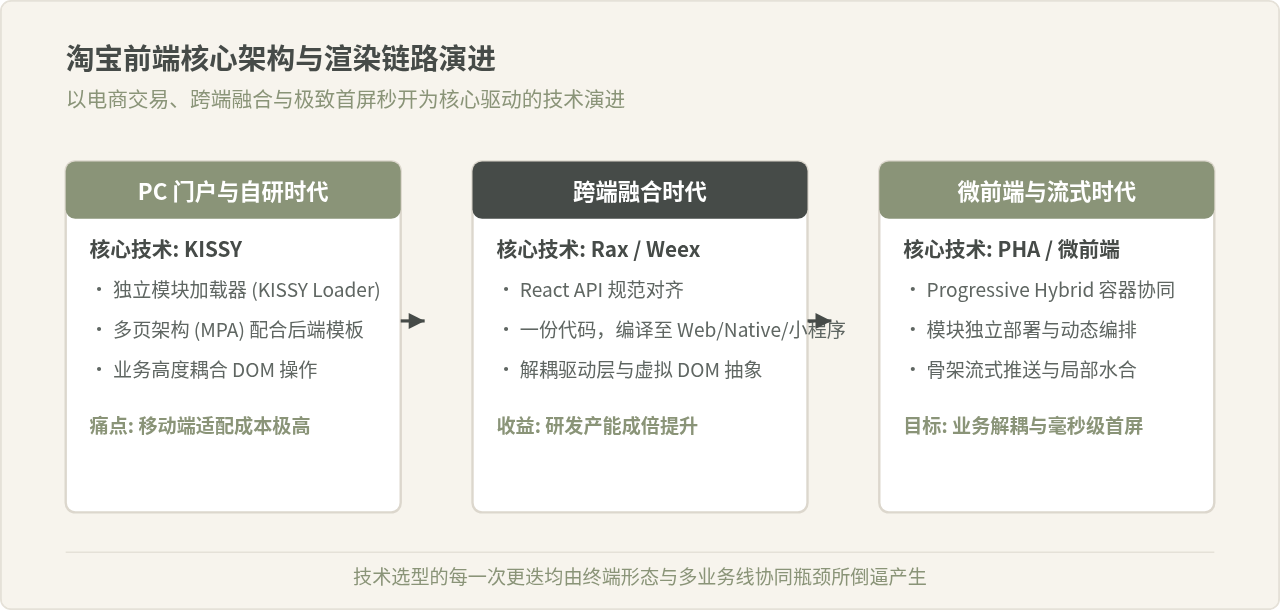
在 PC 鼎盛时期,淘宝团队主导开发了类 YUI 风格的轻量前端框架 KISSY。在模块化标准尚未普及的年代,KISSY 通过内置的 Loader、DOM 操作封装与动画库支撑了整个淘宝体系。然而随着移动互联网爆发,KISSY 过于紧密耦合浏览器 DOM 的设计无法平滑过渡到移动端 Hybrid 与 Weex 容器。
面对多端(Web、iOS、Android、小程序)重复开发的高昂成本,淘宝团队转向了组件化与虚拟 DOM 体系,自主孵化了类 React API 的轻量跨端渲染引擎 Rax。Rax 的核心优势在于将虚拟 DOM 逻辑与底层渲染驱动解耦,上层编写符合 React 规范的 JavaScript 代码,底层可以无缝映射为浏览器 DOM、Weex 原生组件或小程序原生组件,大幅压缩了多端适配的人力消耗。
2. 现代淘宝前端架构:微前端与 PHA 流式渲染
随着业务体量持续膨胀,淘宝主站演进为海量微应用的聚合体。在复杂的导购会场中,不同卡片由不同的业务团队开发与维护。此时单体应用打包发布的方式彻底失效,淘宝演进出了以模块联邦(Module Federation)与微前端为核心的运行架构。
在性能极致追求下,淘宝在移动 App 端推出了 Progressive Hybrid App(PHA)架构。它结合了 Web 资源的动态性与原生 App 的多线程渲染能力:通过在 Native 层预拉取数据、预创建 WebView,并借助流式 SSR 在服务端提前输出骨架,JavaScript 运行时只需在客户端快速执行局部挂载,从而实现接近纯原生应用的秒开体验。
为了在大促高并发下保证绝对可用,淘宝的 JavaScript 资源加载设计中贯彻了多级降级策略。以下代码展示了电商微前端卡片异步加载与降级控制的标准设计模式:
/**
 * 示例:电商动态会场模块加载器与静态降级保障逻辑
 * @param {string} moduleName 模块注册名
 * @param {string} fallbackHtml 预置降级静态片段
 */
async function loadPromotionalBlock(moduleName, fallbackHtml) {
  const container = document.getElementById(`slot-${moduleName}`);
  try {
    // 1. 设置超时竞速,防止慢网络或单模块脚本挂死主线程
    const timeoutPromise = new Promise((_, reject) =>
      setTimeout(() => reject(new Error('Module Load Timeout')), 2500)
    );

    // 2. 动态加载远程模块联邦清单(或 UMD 脚本)
    const loadPromise = window.__FEDERATED_CONTAINER__.get(moduleName);
    const moduleFactory = await Promise.race([loadPromise, timeoutPromise]);
    const Component = moduleFactory();

    // 3. 正常挂载与水合
    Component.mount(container, {
      traceId: window.__TRACE_ID__,
      inApp: Boolean(window.__NATIVE_BRIDGE__)
    });
  } catch (error) {
    console.warn(`[Federation Fallback] 模块 ${moduleName} 加载降级:`, error);
    // 4. 极端异常触发:静默降级为内联骨架或预渲染静态 HTML,确保交易链路不中断
    container.innerHTML = fallbackHtml;
  }
}
三、知乎的 JavaScript 应用架构演进与选型实践
与淘宝强调会场拼装与端容器不同,知乎的技术重心始终围绕“内容的可读性”、“搜索引擎可抓取性”与“沉浸式社区交互”展开。知乎的前端技术栈历经了从 Python 模板混合 jQuery,到 React 单页应用(SPA),再到大规模 React 服务端渲染(SSR)的演进。
1. 从 SPA 的 SEO 阵痛到 React SSR 体系
知乎早期曾尝试将全站迁移为纯客户端渲染的 React 单页应用(CSR)。然而随之而来的问题是:搜索引擎爬虫对纯客户端渲染的抓取率显著下降,外部流量引入严重受损;同时,大型长问答页面中,巨大的 JavaScript Bundle 在中低端移动端设备上解析耗时过长,白屏时间激增。
为此,知乎迅速调整技术路线,全面押注 React SSR。通过在 Node.js 服务端直接执行 React 组件渲染,输出携带完整文字内容的直出 HTML,爬虫可以在握手后立即提取完整的文章与回答结构;真实用户也能在首个数据包返回时即刻阅读正文,大幅降低首屏内容呈现时间(FCP)。
2. 注水(Hydration)优化与富文本编辑器隔离
直出 HTML 解决了文本可见性问题,但知乎面临着另一个严峻挑战:注水开销(Hydration Cost)。当一个长篇讨论包含数百条回答时,浏览器端执行 hydrateRoot 需要遍历极深且庞大的虚拟 DOM 树,导致主线程长期卡顿,用户“看得见文字却无法点赞或展开评论”。
知乎团队采取的核心优化策略包括:
- 选择性注水与视口注水(Selective Hydration):仅对首屏视口内的核心问答结构执行水合操作,非可视区域的评论列表、推荐卡片延迟到用户滚动接近时再加载对应的 JavaScript 代码。
- 富文本编辑器的沙箱化解耦:知乎的内容生产端(创作问答、专栏文章)拥有功能极其庞大的富文本与公式编辑器(基于 Draft.js/ProseMirror 深度定制)。知乎将其严格拆分为独立动态 Chunk,在读者仅浏览内容时绝不加载编辑器相关的任何运行时代码。
- 全栈数据脱水(Dehydration)控制:在 Node.js 端过滤多余的状态树字段,仅序列化首屏必需的数据注入到
window.__INITIAL_STATE__中,严格控制初始 HTML 的体积。
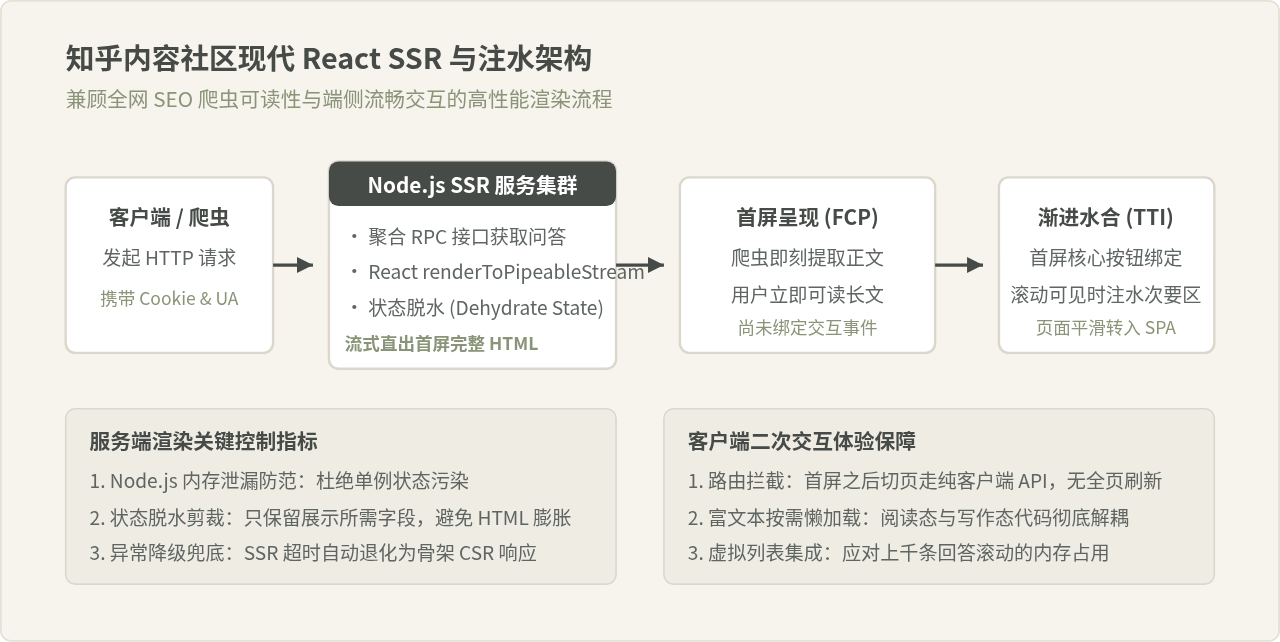
知乎式 SSR 架构的核心在于服务端脱水与客户端水合的一致性约束。以下示例呈现了现代 React 18+ 架构下流式渲染服务端与客户端状态恢复的基础实现结构:
// server/render.js (Node.js 服务端流式输出核心逻辑)
import { renderToPipeableStream } from 'react-dom/server';
import App from '../src/App';

export function handleRequest(req, res) {
  const articleData = await fetchArticleDetail(req.params.id);
  // 精简脱水数据,避免敏感信息与无用冗余字段泄露至客户端
  const dehydratedState = {
    article: {
      id: articleData.id,
      title: articleData.title,
      htmlContent: articleData.sanitizedHtml,
      author: articleData.authorBrief
    }
  };

  const stream = renderToPipeableStream(
    <App serverState={dehydratedState} />,
    {
      bootstrapScripts: ['/static/bundle.main.js'],
      onShellReady() {
        res.statusCode = 200;
        res.setHeader('Content-Type', 'text/html; charset=utf-8');
        // 先行下发 HTML 骨架与注入脱水状态
        res.write(`<!DOCTYPE html><html><head><title>${articleData.title}</title>`);
        res.write(`<script>window.__INITIAL_STATE__=${JSON.stringify(dehydratedState)}</script></head><body>`);
        res.write('<div id="root">');
        stream.pipe(res);
      },
      onAllReady() {
        res.write('</div></body></html>');
      },
      onError(err) {
        console.error('[SSR Fatal Error] 降级至 CSR 空骨架:', err);
        res.status(500).send('<div id="root"></div><script src="/static/bundle.main.js"></script>');
      }
    }
  );
}
四、大型前端应用技术选型推导步骤
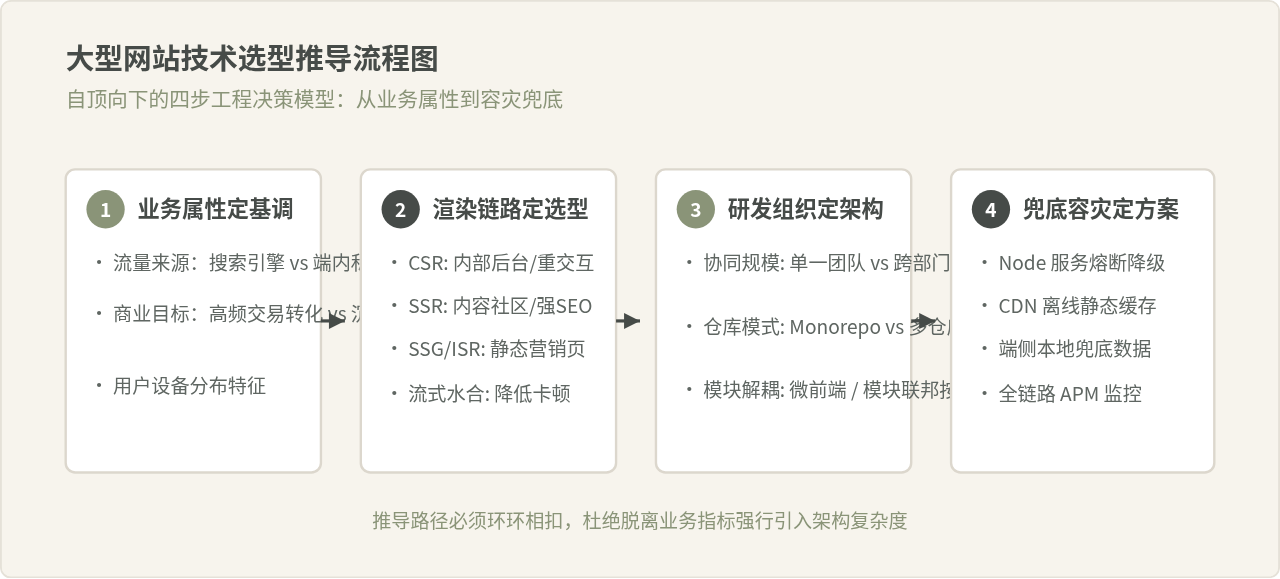
在设计千万级 PV 级别的系统时,选型不应是一次拍脑袋的“跟风大厂”,而是一套自顶向下的严密推导流程。以下推导步骤帮助架构师明确选型路径:
- 步骤一:量化核心商业指标与流量特征
明确首要指标是 SEO 权重、白屏耗时(LCP)、可交互耗时(TTI)还是极端并发承载能力。若 80% 流量来自于外部搜索引擎,则必须采用具备 SSR 或静态生成的架构;若流量集中在端内且存在极其频繁的个性化卡片组装,则倾向于构建微前端或端容器规范。
- 步骤二:确立渲染架构与缓存层级
在 CSR、SSR、SSG(静态生成)与 ISR(增量静态再生成)之间做减法。电商详情页适合采用“静态模板 CDN 缓存 + 客户端局部异步获取库存价格”的混合模式;而知乎式动态问答适合“Node.js 动态 SSR + Redis 页面片段缓存 + 流式水合”。
- 步骤三:划定团队协作界面与工程打包策略
根据团队组织架构决定代码组织形式。单团队多功能业务应优先采用 Monorepo 体系;若跨越数十个独立部门、各团队独立发版上线,微前端与模块联邦是隔离技术栈和发布风险的必要手段,但需承担运行时沙箱与包体积重复的成本。
- 步骤四:构建容灾降级与监控回滚闭环
所有服务端渲染(Node.js)都存在 CPU 密集型运算导致的雪崩风险,必须在架构设计之初实现自动降级机制:当 Node.js 负载超过 80% 或渲染超时时,应立即退化为返回纯静态 HTML 或纯客户端渲染脚本,确保主交易或主内容链路永不中断。
五、常见认知误区与理性辨析
在前端架构设计讨论中,常有一些看似合理却存在明显前提局限的说法。我们需要在具体场景下剖析其背后的成立条件与修正方案:
说法一:“SSR 性能一定优于 CSR,是解决首屏缓慢的终极方案。”
辨析:这个说法只在“内容首次呈现时间(FCP)”这一单一维度上成立。SSR 确实能把拼装好的 HTML 快速推送给浏览器,极大提升纯文字和图片排版的呈现速度。然而,SSR 的代价是大幅增加了服务端 Node.js 的计算开销(TTFB 可能因服务端并发压力而拉长),并且由于客户端仍需执行全量虚拟 DOM 树的水合(Hydration),可交互时间(TTI)往往并没有显著缩短,甚至在低端机型上会出现“界面已有内容却点击无效”假死现象。知乎之所以坚持 SSR,核心驱动力在于“SEO 爬虫抓取 + 长文阅读属性”;若是一个无需搜索引擎抓取的重型交互管理后台,无脑上 SSR 只会徒增运维成本与服务端服务器开销。
说法二:“大型复杂系统必须采用微前端,才能彻底解决技术债务与发版冲突。”
辨析:微前端本质上是用“运行时的性能损耗与工程复杂度”换取“组织协作的自治性”。淘宝之所以重度依赖微前端与模块联邦,是因为其面临数十个业务事业部独立开发活动模块的现实,组织壁垒决定了无法把所有代码放在同一个工程里集成。微前端方案天然带来了公共依赖重复加载、样式与全局变量沙箱隔离损耗、跨应用通信脆弱等副作用。如果团队规模较小(例如在 20 人以内),采用统一规范的 Monorepo 与完善的 CI/CD 自动化流水线,其迭代效率和运行性能往往显著优于微前端。
六、淘宝与知乎技术选型对比与选型总结
为了直观展现两者在具体选型维度的差异,下表归纳了淘宝与知乎的核心技术指标与实践选型:
| 对比维度 | 淘宝(电商交易型平台) | 知乎(内容社区型平台) |
|---|---|---|
| 业务核心特征 | 高并发营销、秒杀、会场快速组装、强交易管控 | 图文长文排版、问答流、富文本创作、社交互动 |
| 主选框架与生态 | React 规范 / Rax / PHA 端混合容器 | React / Next.js 体系 / 深度自研 SSR 中台 |
| 首屏与渲染策略 | 端内预拉取 + 离线包 + 静态模板 CDN 直出 | Node.js 动态 SSR + 流式传输 + 选择性水合 |
| SEO 依赖程度 | 低(核心交易封闭在移动 App 私域环境) | 极高(高度依赖公网搜索爬虫引流与分享外链) |
| 架构解耦手段 | 微前端 / 模块联邦 / 动态配置驱动 DSL | Monorepo / 按路由分包 / 创作端沙箱独立分包 |
| 极端容灾机制 | 静态 HTML 降级兜底、秒级熔断切静态缓存 | Node.js 集群熔断退化为客户端渲染(CSR)骨架 |
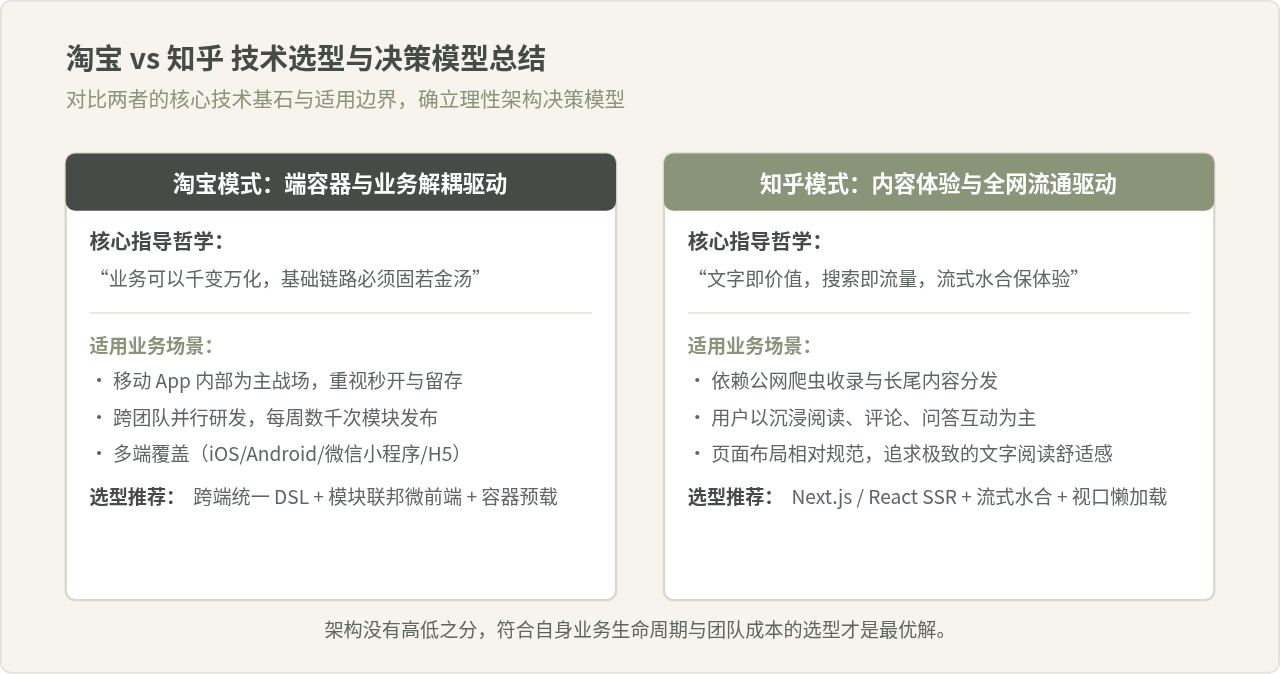
综上所述,淘宝与知乎的 JavaScript 技术选型,向我们展示了两种完全成立且高度工业化的演进范式。对于中大型团队而言,学习大厂技术选型,切忌机械复制具体的库和框架,而应深入体察其在商业指标约束、组织架构协作与用户交互链路上的权衡脉络。在架构推导中,以终为始,紧扣业务场景与性能指标,方能设计出经得起真实流量检验的高可用前端架构。
React 与 Vue 3 核心差异解析:技术选型参考
2026-11-05 13:25:04
利用JS三目运算符简化React和Vue组件中的条件渲染
2026-11-05 12:50:09
Vite 与 Webpack 在 React 项目中的配置差异
2026-11-05 10:13:11
React Hooks 实战:useState 与 useEffect 使用规范
2026-11-04 18:46:10
基于 UmiJS 与 Ant Design Pro 搭建企业级中后台系统
2026-11-03 16:42:02






