

JavaScript常见算法源代码:排序与查找算法实现实例
本文系统讲解JavaScript常见排序与查找算法的源代码实现,包含冒泡排序、选择排序、插入排序、快速排序、线性查找与二分查找,通过完整代码、逐行分析、图示演示与复杂度对比,帮助读者掌握算法实现及工程应用。
Array.prototype.sort() 和 Array.prototype.find() 等方法,但理解底层经典排序与查找算法的实现机制,不仅能帮助开发者在复杂数据场景下写出高性能代码,也是排查性能瓶颈和应对算法评估的基础技能。本文将通过具体可运行的 JavaScript 源代码实例,逐层解析冒泡排序、选择排序、插入排序、快速排序,以及线性查找与二分查找的实现原理与边界条件。
一、基础排序算法实现
基础排序算法通常采用就地(in-place)比对与元素交换策略,其平均时间复杂度普遍为 O(n²),但在逻辑简单性和小规模数据集处理上具有直观易懂的优势。
1. 冒泡排序(Bubble Sort)
冒泡排序通过相邻元素的连续两两比对,如果前面的元素大于后面的元素就将两者交换位置。每一轮遍历结束后,当前未就位序列中的最大元素都会如同“气泡”一般浮动到末尾。
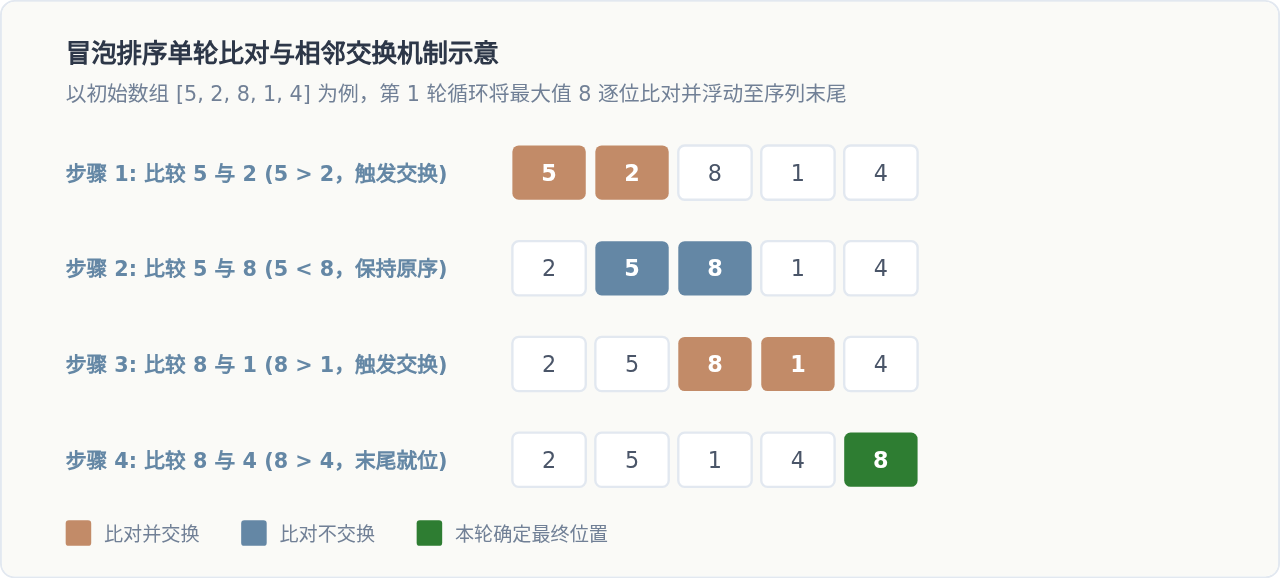
以下为冒泡排序的基础实现及带有提前终止优化的完整源代码:
/**
 * 冒泡排序(优化版)
 * @param {number[]} arr 待排序数组
 * @returns {number[]} 排序后的原数组引用
 */
function bubbleSort(arr) {
  const len = arr.length;
  // 外层循环控制遍历轮数
  for (let i = 0; i < len - 1; i++) {
    let hasSwapped = false; // 标记本轮是否发生了元素交换

    // 内层循环负责相邻元素比对,len - 1 - i 之后的元素已处于正确位置
    for (let j = 0; j < len - 1 - i; j++) {
      if (arr[j] > arr[j + 1]) {
        // 利用 ES6 解构赋值进行元素就地交换
        [arr[j], arr[j + 1]] = [arr[j + 1], arr[j]];
        hasSwapped = true;
      }
    }

    // 若整轮遍历没有发生任何交换,说明数组已经完全有序,可提前结束循环
    if (!hasSwapped) {
      break;
    }
  }
  return arr;
}

// 示例运行
const testData1 = [5, 2, 8, 1, 4];
console.log('冒泡排序结果:', bubbleSort(testData1)); // 输出: [1, 2, 4, 5, 8]
2. 选择排序(Selection Sort)
选择排序的运行逻辑是:在未排序序列中找到最小(或最大)元素,将其存放到序列的起始位置,然后再从剩余未排序元素中继续寻找最小元素,放到已排序序列的末尾。与冒泡排序不同,选择排序每轮只进行一次真正的数组交换操作。
/**
 * 选择排序
 * @param {number[]} arr 待排序数组
 * @returns {number[]} 排序后数组
 */
function selectionSort(arr) {
  const len = arr.length;
  for (let i = 0; i < len - 1; i++) {
    let minIndex = i; // 假定当前起始索引元素为最小值

    // 在未排序区域寻找真实最小值的索引
    for (let j = i + 1; j < len; j++) {
      if (arr[j] < arr[minIndex]) {
        minIndex = j;
      }
    }

    // 若最小值索引发生变化,则交换至当前轮次起始位置
    if (minIndex !== i) {
      [arr[i], arr[minIndex]] = [arr[minIndex], arr[i]];
    }
  }
  return arr;
}

// 示例运行
const testData2 = [29, 10, 14, 37, 13];
console.log('选择排序结果:', selectionSort(testData2)); // 输出: [10, 13, 14, 29, 37]
3. 插入排序(Insertion Sort)
插入排序模拟的是日常摸牌理牌的过程。它将整个数组分为“已排序前缀”和“未排序后缀”。每次取出未排序部分的第一个元素,在已排序部分从后向前扫描,遇到比它大的元素就依次向后移动一位,直到找到合适位置插入。
/**
 * 插入排序
 * @param {number[]} arr 待排序数组
 * @returns {number[]} 排序后数组
 */
function insertionSort(arr) {
  const len = arr.length;
  for (let i = 1; i < len; i++) {
    const current = arr[i]; // 取出当前待插入元素
    let j = i - 1;

    // 从后往前比对,将大于 current 的元素逐个后移
    while (j >= 0 && arr[j] > current) {
      arr[j + 1] = arr[j];
      j--;
    }
    // 空出的位置放入 current
    arr[j + 1] = current;
  }
  return arr;
}

// 示例运行
const testData3 = [12, 11, 13, 5, 6];
console.log('插入排序结果:', insertionSort(testData3)); // 输出: [5, 6, 11, 12, 13]
二、高效排序算法:快速排序(Quick Sort)
快速排序是现代工程中最常用的排序算法之一,核心基于“分治法”(Divide and Conquer)。它的执行步骤包含三个关键环节:选择基准值(Pivot)、分区(Partition)以及递归求解左右子数组。
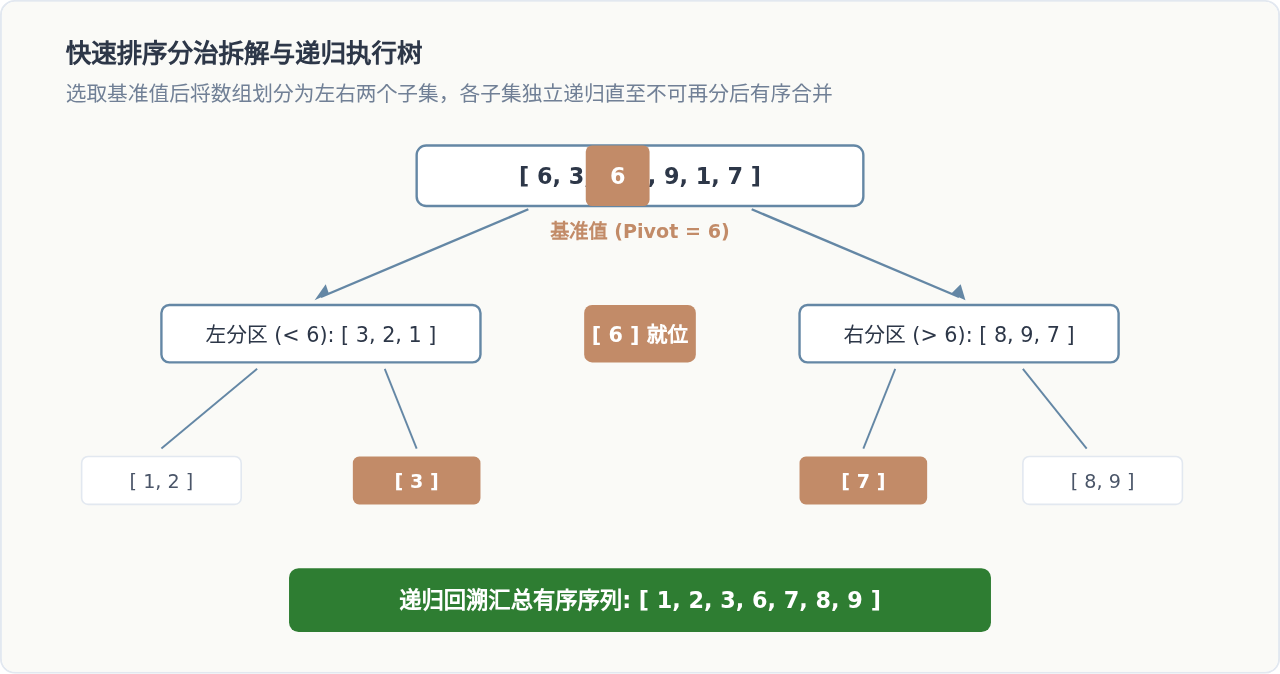
为了达到工业级的执行效率与空间节省,通常推荐使用原地分区(In-place Partition)的双指针实现方式,避免频繁创建临时子数组产生多余的垃圾回收开销:
/**
 * 快速排序主入口
 * @param {number[]} arr 待排序数组
 * @param {number} [left=0] 分区左边界
 * @param {number} [right=arr.length - 1] 分区右边界
 * @returns {number[]} 排序后数组
 */
function quickSort(arr, left = 0, right = arr.length - 1) {
  if (left < right) {
    // 获取经过分区操作后基准值的最终索引
    const pivotIndex = partition(arr, left, right);
    // 递归对基准值左侧子数组进行排序
    quickSort(arr, left, pivotIndex - 1);
    // 递归对基准值右侧子数组进行排序
    quickSort(arr, pivotIndex + 1, right);
  }
  return arr;
}

/**
 * 原地分区函数(Lomuto 分区方案)
 * @param {number[]} arr 数组引用
 * @param {number} left 左边界
 * @param {number} right 右边界
 * @returns {number} 基准元素最终位置
 */
function partition(arr, left, right) {
  // 选择最右侧元素作为基准值
  const pivot = arr[right];
  let i = left; // i 指向小于基准值区域的右侧边界

  for (let j = left; j < right; j++) {
    if (arr[j] < pivot) {
      [arr[i], arr[j]] = [arr[j], arr[i]];
      i++;
    }
  }

  // 将基准值放到小于区与大于区的中间交界处
  [arr[i], arr[right]] = [arr[right], arr[i]];
  return i;
}

// 示例运行
const testData4 = [6, 3, 8, 2, 9, 1, 7];
console.log('快速排序结果:', quickSort(testData4)); // 输出: [1, 2, 3, 6, 7, 8, 9]
三、查找算法实现
查找算法的目标是在集合中定位指定元素或其索引位置。在 JavaScript 数据处理中,最常见的为线性查找与二分查找两类。
1. 线性查找(Linear Search)
线性查找适用于元素无序排列的场景。它从数组的首项开始逐项对比,直到找到目标值或遍历至数组末尾。虽然逻辑直接,但在大规模数据检索下时间复杂度为 O(n)。
/**
 * 线性查找
 * @param {any[]} arr 目标数组
 * @param {any} target 待查找的值
 * @returns {number} 找到返回对应下标,未找到返回 -1
 */
function linearSearch(arr, target) {
  for (let i = 0; i < arr.length; i++) {
    if (arr[i] === target) {
      return i; // 找到即刻返回对应下标
    }
  }
  return -1; // 完整遍历后仍未找到
}

// 示例运行
const users = ['Alice', 'Bob', 'Charlie', 'David'];
console.log('查找 Charlie 索引:', linearSearch(users, 'Charlie')); // 输出: 2
console.log('查找 Frank 索引:', linearSearch(users, 'Frank'));     // 输出: -1
2. 二分查找(Binary Search)
二分查找(又称折半查找)是一种极其高效的查找算法,但它有一个严格的前置约束:目标数组必须预先按照升序或降序排列。二分查找每次都与当前区间的中间元素比对,通过一次比较即可排除一半的候选元素,将时间复杂度压缩至 O(log n)。
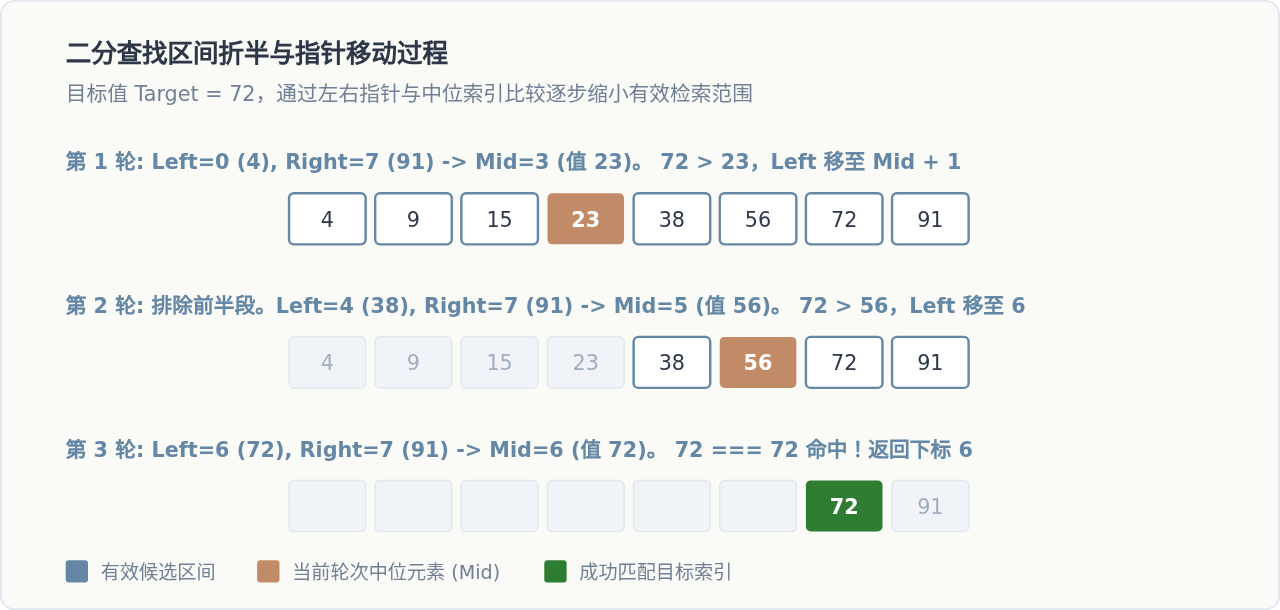
以下为使用双闭区间双指针循环迭代实现二分查找的标准源代码:
/**
 * 二分查找(迭代版)
 * @param {number[]} sortedArr 已经升序排列的数组
 * @param {number} target 查找目标值
 * @returns {number} 目标值的索引下标,若未命中返回 -1
 */
function binarySearch(sortedArr, target) {
  let left = 0;
  let right = sortedArr.length - 1;

  // 使用双闭区间 [left, right],因此循环条件必须为 left <= right
  while (left <= right) {
    // 采用无符号右移或 Math.floor 计算中位数,避免部分语言中的大整型加法溢出
    const mid = left + Math.floor((right - left) / 2);

    if (sortedArr[mid] === target) {
      return mid; // 命中目标
    } else if (sortedArr[mid] < target) {
      // 目标值在右半区间,左边界右移
      left = mid + 1;
    } else {
      // 目标值在左半区间,右边界左移
      right = mid - 1;
    }
  }

  return -1; // 区间完全交错后仍未命中
}

// 示例运行
const sortedData = [4, 9, 15, 23, 38, 56, 72, 91];
console.log('二分查找 72 结果:', binarySearch(sortedData, 72)); // 输出: 6
console.log('二分查找 100 结果:', binarySearch(sortedData, 100)); // 输出: -1
四、算法复杂度综合对比与选型原则
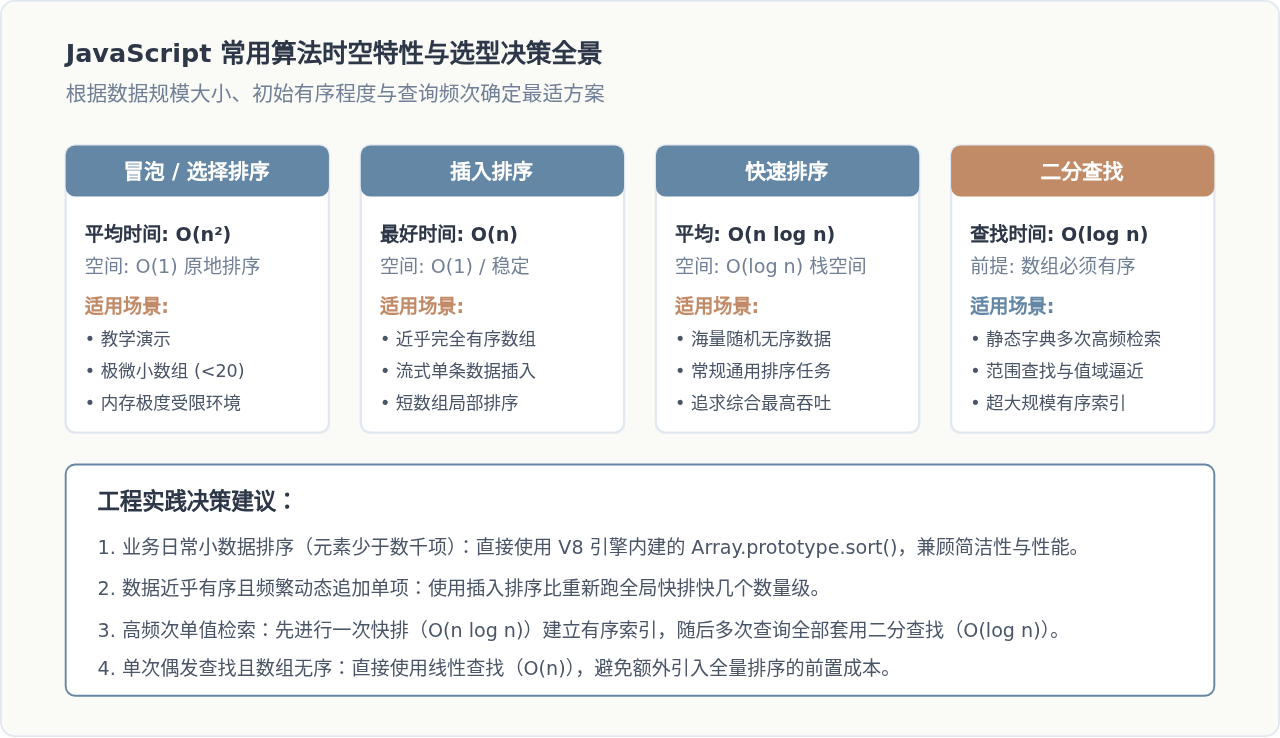
不同算法在时间复杂度、空间占用及稳定性上有明显分化。没有绝对“最好”的算法,只有最契合具体数据特征和业务约束的选择。
| 算法名称 | 最好时间复杂度 | 平均时间复杂度 | 最坏时间复杂度 | 空间复杂度 | 算法稳定性 |
|---|---|---|---|---|---|
| 冒泡排序 (Bubble Sort) | O(n) | O(n²) | O(n²) | O(1) | 稳定 |
| 选择排序 (Selection Sort) | O(n²) | O(n²) | O(n²) | O(1) | 不稳定 |
| 插入排序 (Insertion Sort) | O(n) | O(n²) | O(n²) | O(1) | 稳定 |
| 快速排序 (Quick Sort) | O(n log n) | O(n log n) | O(n²) | O(log n) | 不稳定 |
| 线性查找 (Linear Search) | O(1) | O(n) | O(n) | O(1) | - |
| 二分查找 (Binary Search) | O(1) | O(log n) | O(log n) | O(1) | - |
五、JavaScript 常见陷阱与注意事项
JavaScript 中原生
Array.prototype.sort() 在不传入比对函数时,会将元素转为字符串后比对 UTF-16 代码单元值。例如 [10, 2, 5].sort() 的结果是 [10, 2, 5] 而非 [2, 5, 10]。在数值排序时,务必显式传入比较器:arr.sort((a, b) => a - b)。
在实现二分查找时,若写成
left < right 但分支写为 left = mid 时,当区间只剩两个元素时会导致 mid 无法推进,程序陷入无限死循环。务必采用规范的双闭区间模板:循环条件为 left <= right,两端收缩严格写为 left = mid + 1 与 right = mid - 1。
若数组本身已有序,而分区时每次都机械选择端点作为基准值,快速排序将退化为 O(n²),并在处理海量数据时引发
Maximum call stack size exceeded 错误。实际工程中可采用三数取中法(Median-of-three)或随机基准值策略规避退化。
D3.js 比例尺与坐标轴的配置详解
2026-11-05 16:54:46
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19







