JavaScript数组处理源代码:map、filter与reduce实战实例
深入解析JavaScript中map、filter与reduce三大核心数组处理方法。提供清晰的原理解析、源码级Polyfill实现、高频业务实战代码示例及执行避坑指南。
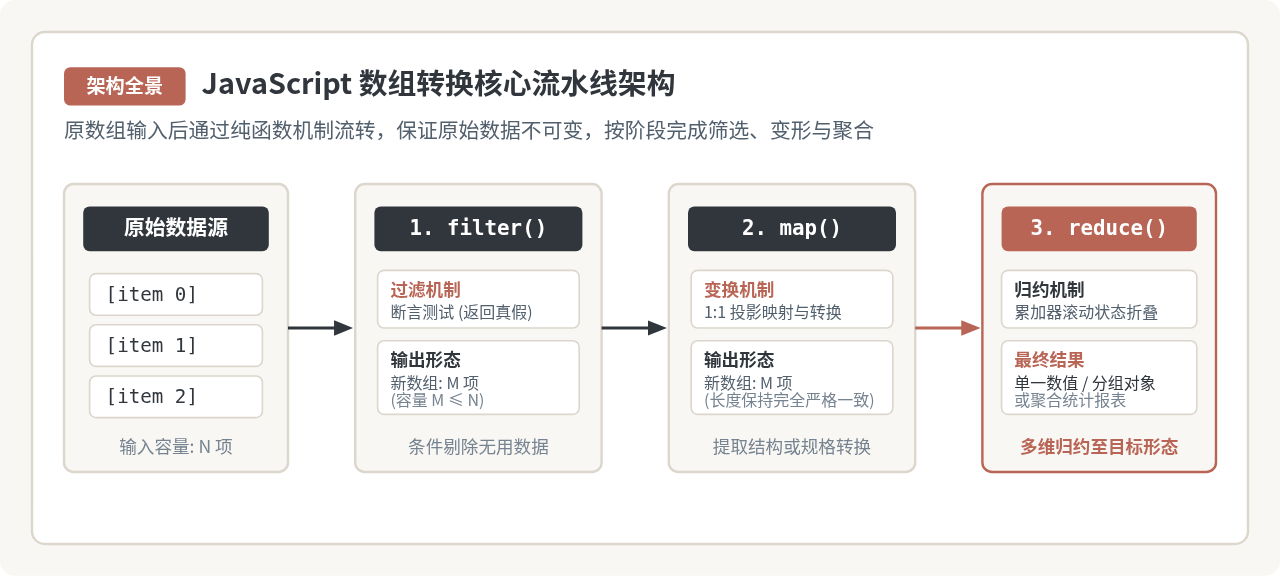
map、filter 和 reduce。map 负责数据结构的一对一转换映射,filter 负责依据布尔条件进行子集筛选,而 reduce 则通过累加器机制将整个数组聚合为任意预期形态(如数值、键值字典或嵌套结构)。掌握这三个方法的输入输出特征、执行机制与组合方式,能够替代繁琐且容易引入临时状态变量的命令式 for 循环,编写出简洁、健壮的声明式代码。
一、核心概念与执行原理对比
ECMAScript 5 正式将 map、filter 与 reduce 纳入标准库规范。它们均属于高阶函数(Higher-Order Functions),即接收函数作为核心参数。理解它们的首要前提是认清它们对原数组的纯函数保护特性:这三个方法都不会直接修改原数组本身,而是通过遍历计算生成新数组或新值。
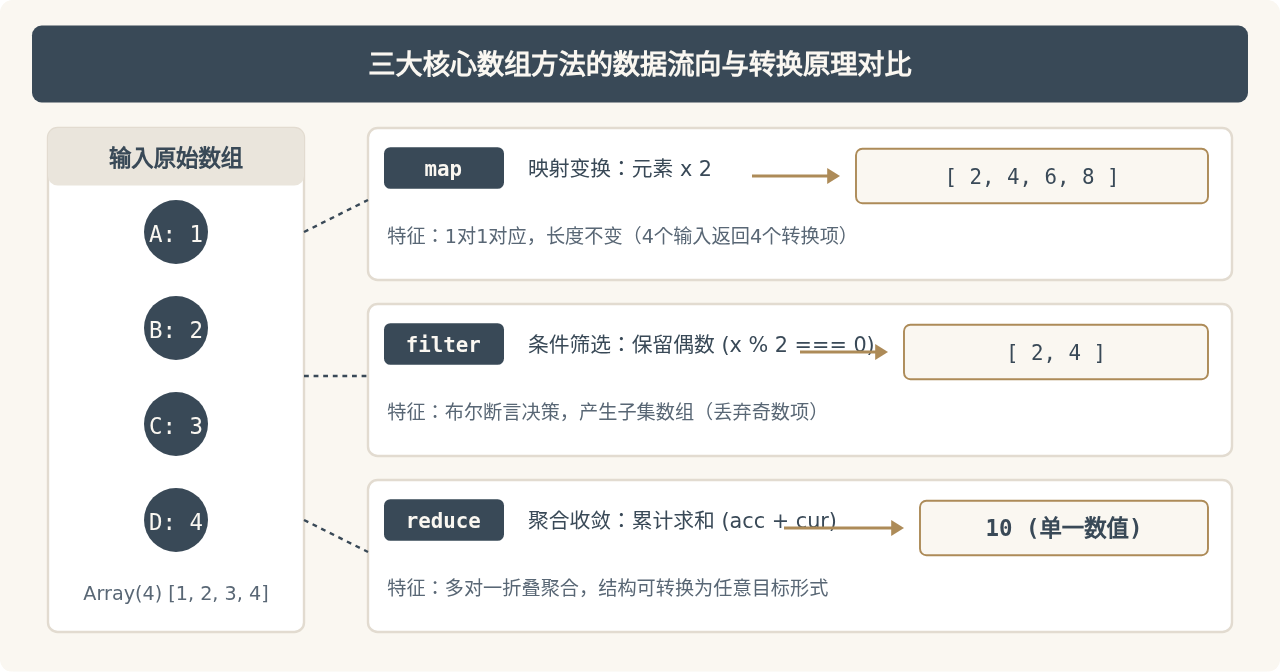
为了在实际编码时快速做出准确的方法选择,下表梳理了三者的核心设计差异与返回值规则:
| 方法名称 | 核心设计定位 | 回调参数签名 | 返回值类型与特征 |
|---|---|---|---|
map |
数据投影与结构转换 | (currentValue, index, array) |
返回新数组,元素数量与原数组严格相等 |
filter |
元素筛选与过滤提取 | (currentValue, index, array) |
返回新数组,长度介于 0 到原数组长度之间 |
reduce |
数据累加聚合与结构收敛 | (accumulator, currentValue, index, array) |
返回累加器最终值(类型由业务逻辑或初始值决定) |
它们在运行时的数据流动形态存在本质差别。map 保持原有排列长度逐一重塑内容;filter 根据真假判定进行舍弃或保留;reduce 则将分散的元素汇入累加器滚雪球式折叠。
二、map 实战应用与内部执行机制
map 的核心应用场景是对数据结构进行解构、提取或重组。例如,从后端接口获取到用户原始数据列表后,常常需要转换出适合前端组件渲染的展示对象,或者提取单一字段数组。
1. 实战范例:接口返回对象字段精简与价格格式化
// 原始商品数据列表
const rawProducts = [
  { id: 101, name: "机械键盘", priceCents: 39900, stock: 12 },
  { id: 102, name: "无线鼠标", priceCents: 12900, stock: 0 },
  { id: 103, name: "4K显示器", priceCents: 189900, stock: 5 }
];

// 使用 map 提取并转换为渲染所需的展示模型
const displayProducts = rawProducts.map((product) => {
  return {
    id: product.id,
    title: product.name,
    formattedPrice: `¥${(product.priceCents / 100).toFixed(2)}`,
    isAvailable: product.stock > 0
  };
});

console.log(displayProducts);
/* 输出示例:
[
  { id: 101, title: '机械键盘', formattedPrice: '¥399.00', isAvailable: true },
  { id: 102, title: '无线鼠标', formattedPrice: '¥129.00', isAvailable: false },
  { id: 103, title: '4K显示器', formattedPrice: '¥1899.00', isAvailable: true }
]
*/
2. 原生底层实现:手写 myMap 剖析
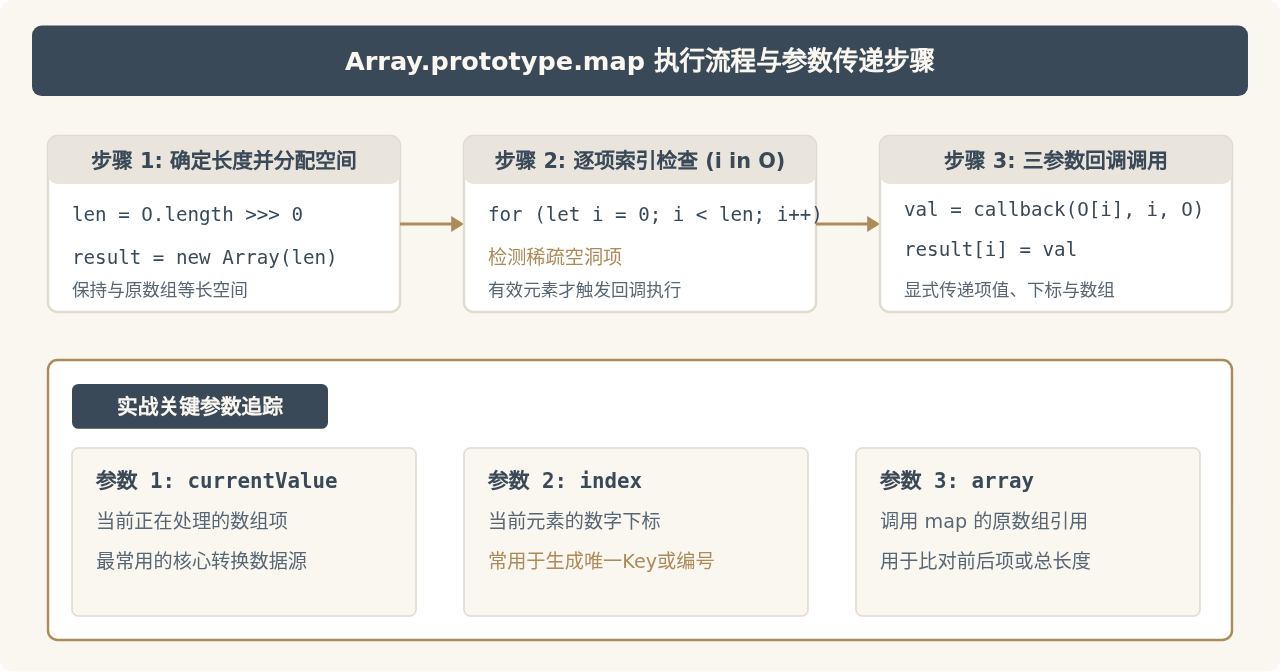
为了透彻理解 map 的底层运转逻辑,我们来看符合规范的基础 Polyfill 源代码实现。需要注意的是,原生规范中要求处理稀疏数组中的空位(empty slot),并在执行时支持绑定 thisArg 上下文:
Array.prototype.myMap = function(callback, thisArg) {
  // 1. 类型校验:调用目标必须是数组对象
  if (this == null) {
    throw new TypeError("Array.prototype.myMap called on null or undefined");
  }
  if (typeof callback !== "function") {
    throw new TypeError(callback + " is not a function");
  }

  const O = Object(this);
  const len = O.length >>> 0; // 无符号右移确保索引长度为正整数
  const result = new Array(len);

  // 2. 依次遍历每个索引位
  for (let i = 0; i < len; i++) {
    // 使用 in 操作符检查索引是否存在,跳过稀疏数组的空洞位
    if (i in O) {
      result[i] = callback.call(thisArg, O[i], i, O);
    }
  }

  return result;
};初学者容易写出 ['1', '2', '3'].map(parseInt),预期输出 [1, 2, 3],但实际输出却是 [1, NaN, NaN]。原因在于 map 在调用回调函数时传入了三个参数:(item, index, array)。而 parseInt 接收的第二个参数为基数(radix)。遍历第二项时执行的是 parseInt('2', 1),一进制中不存在数字2,因此返回 NaN。正确写法应显式声明传参:['1', '2', '3'].map((str) => parseInt(str, 10)) 或 ['1', '2', '3'].map(Number)。
三、filter 实战应用与多条件复合筛选
filter 方法专注于“子集提取”。其回调函数必须返回一个能够被转换为真值(Truthy)或假值(Falsy)的结果。当返回真值时,该元素被浅拷贝推入新数组;反之则被丢弃。
1. 实战范例:复合条件过滤与假值清洗
const records = [
  { id: 1, user: "Alice", active: true, score: 88 },
  { id: 2, user: "Bob", active: false, score: 92 },
  { id: 3, user: "Charlie", active: true, score: 59 },
  { id: 4, user: "David", active: true, score: 95 }
];

// 业务需求:筛选出状态激活且分数大于等于 80 分的合规用户
const qualifiedUsers = records.filter((item) => {
  return item.active && item.score >= 80;
});

console.log(qualifiedUsers);
// 输出: [{ id: 1, user: 'Alice', active: true, score: 88 }, { id: 4, user: 'David', active: true, score: 95 }]

// 技巧:快速清洗数组中的 falsy 假值(null, undefined, 0, "", false, NaN)
const mixedValues = [0, "hello", null, undefined, 42, "", false];
const cleanValues = mixedValues.filter(Boolean);

console.log(cleanValues);
// 输出: ["hello", 42]
2. 原生底层实现:手写 myFilter 剖析
Array.prototype.myFilter = function(callback, thisArg) {
  if (this == null) {
    throw new TypeError("Array.prototype.myFilter called on null or undefined");
  }
  if (typeof callback !== "function") {
    throw new TypeError(callback + " is not a function");
  }

  const O = Object(this);
  const len = O.length >>> 0;
  const result = [];

  for (let i = 0; i < len; i++) {
    if (i in O) {
      const element = O[i];
      // 只有回调返回显式真值时,才推入结果数组
      if (callback.call(thisArg, element, i, O)) {
        result.push(element);
      }
    }
  }

  return result;
};在性能层面,filter 会产生一个全新分配的数组。当面对十万级以上的大数组且筛选条件极其动态时,应当避免在短时间内高频连续调用 filter 产生多个临时丢弃数组,以降低垃圾回收(GC)开销。
四、reduce 核心进阶与多维状态聚合
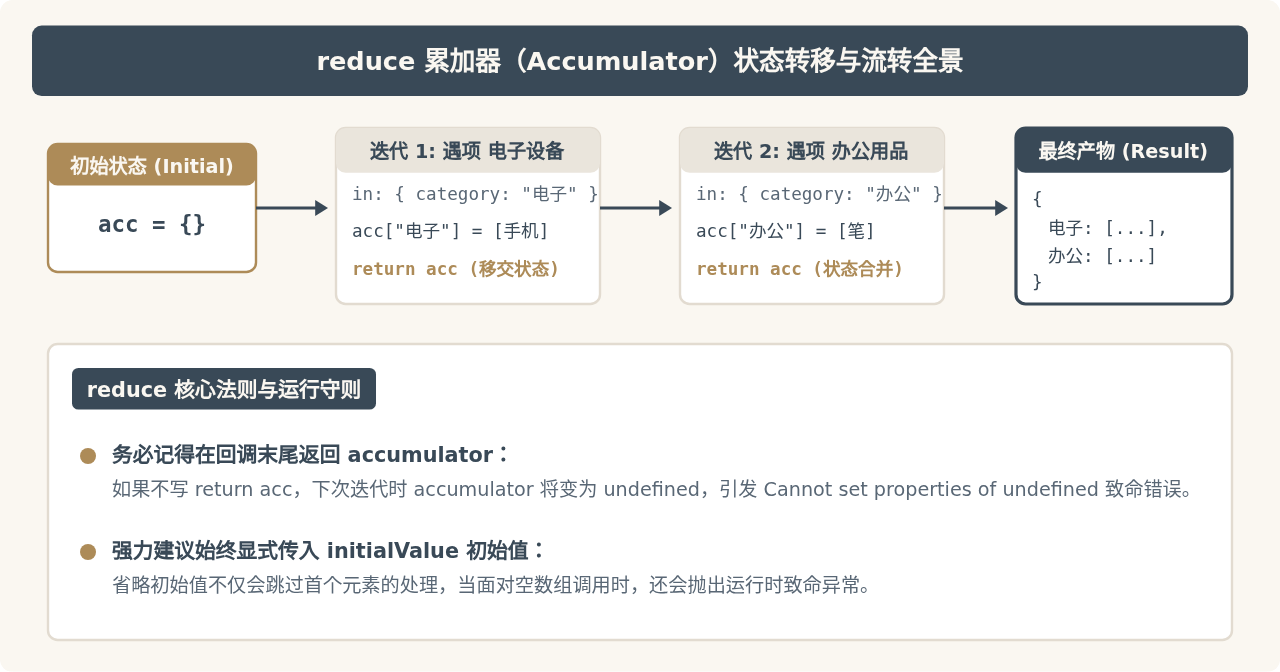
在所有内置数组方法中,reduce 是灵活性最高且表达力最强的一个。任何使用 map 或 filter 表达的逻辑,本质上都可以用 reduce 来实现。它的核心机制在于“累加器(accumulator)”跨步保持,并将每一步的计算结果作为下一次迭代的输入。
1. 实战范例:数组项分组统计与归类字典构建
在日常数据报表和界面渲染中,将扁平列表按照某类属性归类为 Key-Value 字典是极其普遍的需求:
const inventory = [
  { category: "电子设备", name: "手机", count: 15 },
  { category: "办公用品", name: "签字笔", count: 120 },
  { category: "电子设备", name: "平板电脑", count: 8 },
  { category: "办公用品", name: "笔记本", count: 45 },
  { category: "食品生鲜", name: "苹果", count: 30 }
];

// 需求:按分类聚合并计算每个类别的总库存量
const categorySummary = inventory.reduce((acc, item) => {
  const key = item.category;
  if (!acc[key]) {
    acc[key] = { items: [], totalCount: 0 };
  }
  acc[key].items.push(item.name);
  acc[key].totalCount += item.count;
  return acc; // 必须返回累加器以供下一次循环使用
}, {}); // 第二个参数传入初始值空对象 {}

console.log(categorySummary);
/* 输出结果:
{
  '电子设备': { items: ['手机', '平板电脑'], totalCount: 23 },
  '办公用品': { items: ['签字笔', '笔记本'], totalCount: 165 },
  '食品生鲜': { items: ['苹果'], totalCount: 30 }
}
*/
2. 原生底层实现:手写 myReduce 剖析
reduce 的实现难点在于初始值(initialValue)的有无。如果未提供初始值,数组的第一个有效元素将作为累加器的初始状态,遍历将从第二个有效元素开始;如果数组为空且未提供初始值,则必须抛出 TypeError。
Array.prototype.myReduce = function(callback, initialValue) {
  if (this == null) {
    throw new TypeError("Array.prototype.myReduce called on null or undefined");
  }
  if (typeof callback !== "function") {
    throw new TypeError(callback + " is not a function");
  }

  const O = Object(this);
  const len = O.length >>> 0;
  let k = 0;
  let accumulator;

  // 1. 判断是否传入了初始值实参
  if (arguments.length >= 2) {
    accumulator = initialValue;
  } else {
    // 未提供初始值:寻找第一个有效(非空洞)元素作为初始累加器
    let kPresent = false;
    while (k < len && !kPresent) {
      if (k in O) {
        accumulator = O[k];
        kPresent = true;
      }
      k++;
    }
    // 空数组且无初始值,直接报错
    if (!kPresent) {
      throw new TypeError("Reduce of empty array with no initial value");
    }
  }

  // 2. 依次迭代后续元素
  for (; k < len; k++) {
    if (k in O) {
      accumulator = callback(accumulator, O[k], k, O);
    }
  }

  return accumulator;
};
五、实战组合:链式调用与性能权衡
在现实项目开发中,复杂的业务需求往往不是单一方法可以孤立完成的。filter 与 map 均返回新数组,这为函数式链式调用(Method Chaining)提供了极佳的语法基础。
1. 综合业务案例:已支付订单金额转换与总消费计算
const orders = [
  { orderId: "T101", status: "PAID", amount: 150.00, refund: false },
  { orderId: "T102", status: "PENDING", amount: 80.00, refund: false },
  { orderId: "T103", status: "PAID", amount: 320.50, refund: false },
  { orderId: "T104", status: "PAID", amount: 99.00, refund: true },
  { orderId: "T105", status: "CANCELLED", amount: 210.00, refund: false }
];

// 业务流程:
// 1. 过滤:只保留已支付且无退款的有效订单 (filter)
// 2. 转换:提取积分换算值(每消费1元赠送10积分,满200再加赠50) (map)
// 3. 聚合:汇总计算所有订单产生的总积分 (reduce)

const totalPoints = orders
  .filter((order) => order.status === "PAID" && !order.refund)
  .map((order) => {
    const basePoints = Math.floor(order.amount * 10);
    const bonus = order.amount >= 200 ? 50 : 0;
    return basePoints + bonus;
  })
  .reduce((sum, points) => sum + points, 0);

console.log("有效总积分:", totalPoints);
// 计算过程:
// T101: 150 * 10 = 1500
// T103: 320.5 * 10 = 3205 + 50 = 3255
// 总积分: 1500 + 3255 = 4755
2. 链式调用的性能权衡与合并策略
虽然 filter().map().reduce() 的链式调用拥有极高的语义可读性,但每一次链式节点都会完整遍历数组并生成一个新的中间数组。当数组包含上万甚至十万条数据时,多次创建大数组会造成明显的内存分配与 GC 压力。
在此类性能敏感场景下,推荐将链式操作收敛为单次 reduce 遍历:
// 性能优化版:仅遍历一次数组,无中间数组分配
const optimizedTotalPoints = orders.reduce((sum, order) => {
  // 内联 filter 条件
  if (order.status === "PAID" && !order.refund) {
    // 内联 map 转换与 reduce 累加
    const basePoints = Math.floor(order.amount * 10);
    const bonus = order.amount >= 200 ? 50 : 0;
    return sum + basePoints + bonus;
  }
  return sum;
}, 0);
六、选型决策指南与全景总结
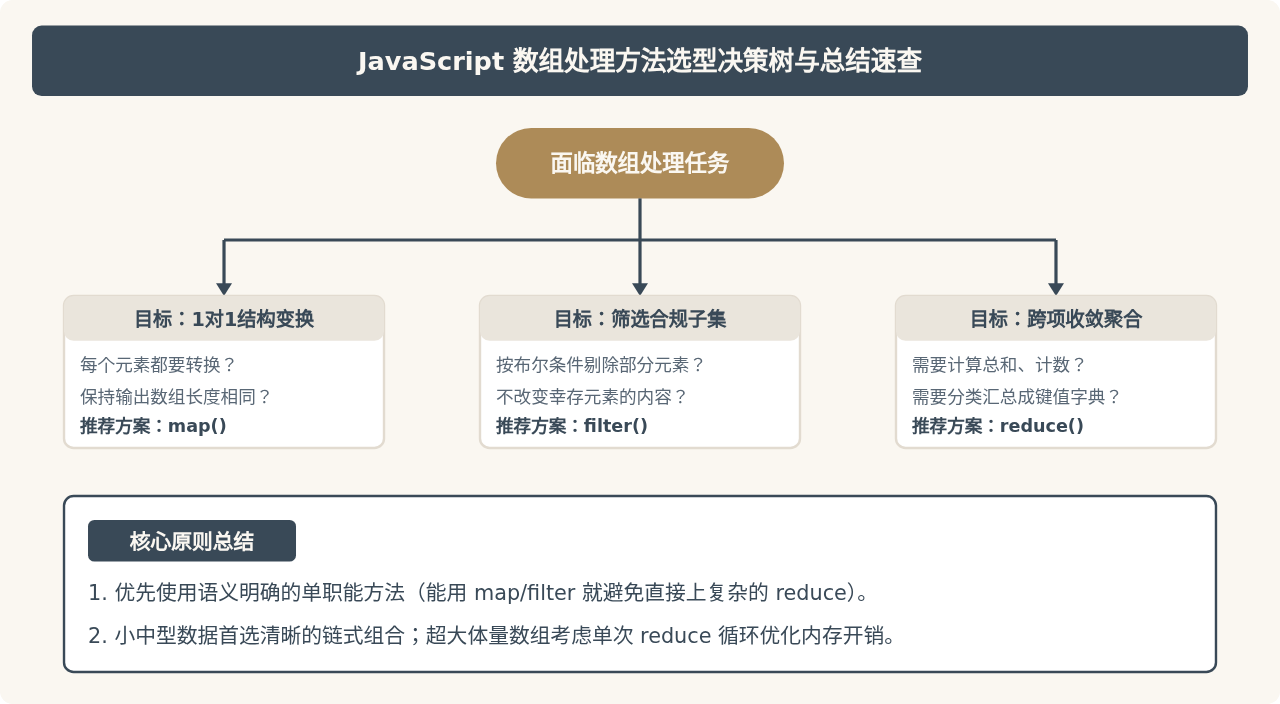
面对具体的业务需求,应当如何选择最合适的方法?核心决策取决于三个问题:
- 是否需要保留每一个元素并进行形态转换? 如果长度严格一致,果断使用
map。 - 是否需要剔除不符合条件的项? 如果只需按规则收缩集合,使用
filter。 - 最终输出是否需要降维、汇总或聚合成复合数据结构? 如果需要输出单值、字典或统计结构,首选
reduce。
怎么用 Promise 封装 JavaScript sleep 函数实现异步延时
2026-11-05 17:49:14
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
相关标签: