

怎么用JavaScript实现数组去重?附4种代码实例
深入讲解在JavaScript中实现数组去重的4种实用方法,包括Set集合、filter配合indexOf、reduce配合includes以及Map哈希表去重,附带完整代码示例与对比分析。
在日常的 JavaScript 开发中,数组去重是一项非常高频的基础操作。不论是清洗接口返回的重合数据、提取用户多选标签的唯一值,还是合并本地存储的状态列表,都需要快速且可靠地剔除重复项。数组去重的核心逻辑很直观:遍历目标数组,在保留首次出现元素的同时,过滤掉后续重复的项。本文提供 4 种常用且逻辑清晰的去重代码实例,剖析其底层机制、时间复杂度与边界特点,帮助开发者在不同业务场景中做出恰当选择。
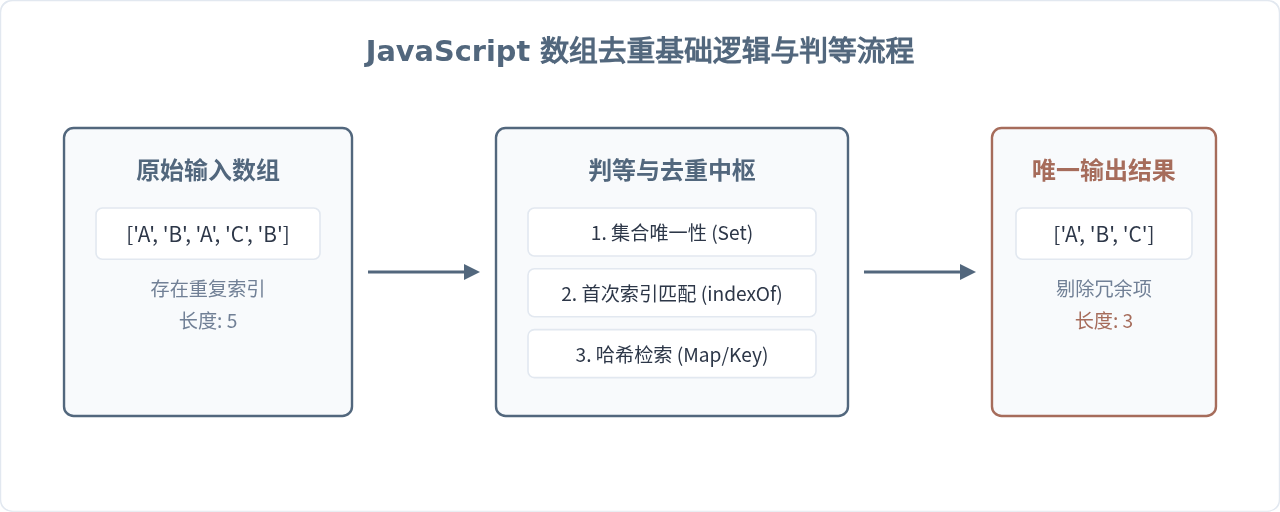
实例一:利用 ES6 Set 与扩展运算符(最推荐的现代写法)
ES6 引入了新的数据结构 Set(集合)。Set 的主要特征之一就是其内部成员的值都是唯一的,绝不会出现相同元素。将数组转为 Set 后再转回数组,是当前现代前端开发中最常用、书写最简短的去重方案。
// 方法 1:使用 Set 与扩展运算符
function uniqueWithSet(arr) {
  return [...new Set(arr)];
}

// 示例验证
const list = [1, 2, 2, 'hello', 'hello', true, true, false];
const result = uniqueWithSet(list);
console.log(result);
// 输出: [1, 2, 'hello', true, false]
机制与注意点:
- 时间复杂度:平均时间复杂度为
O(n),由底层哈希结构支撑,执行速度非常快。 - 特殊值处理:
Set内部使用类似于精确相等的算法(SameValueZero)。它能够正确识别并去重NaN(即[NaN, NaN]会被正确去重为[NaN]),同时能精准区分数字1与字符串'1'。 - 引用类型局限:对于对象或数组等引用类型,只有指向同一个内存地址时才会被视为相同。两个结构相同但引用不同的对象(如
{ a: 1 }和{ a: 1 })不会被去重。
实例二:使用 filter 与 indexOf 按首次出现索引过滤
在没有 ES6 支持的环境中,或者希望完全基于标准数组迭代 API 解决问题时,filter 结合 indexOf 是非常经典的实现。其核心思想是:利用 indexOf(item) 永远返回该元素在数组中第一次出现的索引,将其与当前遍历的索引 index 对比。
// 方法 2:filter 结合 indexOf
function uniqueWithFilter(arr) {
  return arr.filter((item, index) => arr.indexOf(item) === index);
}

// 示例验证
const nums = [1, 3, 2, 3, 1, 4];
const result = uniqueWithFilter(nums);
console.log(result);
// 输出: [1, 3, 2, 4]
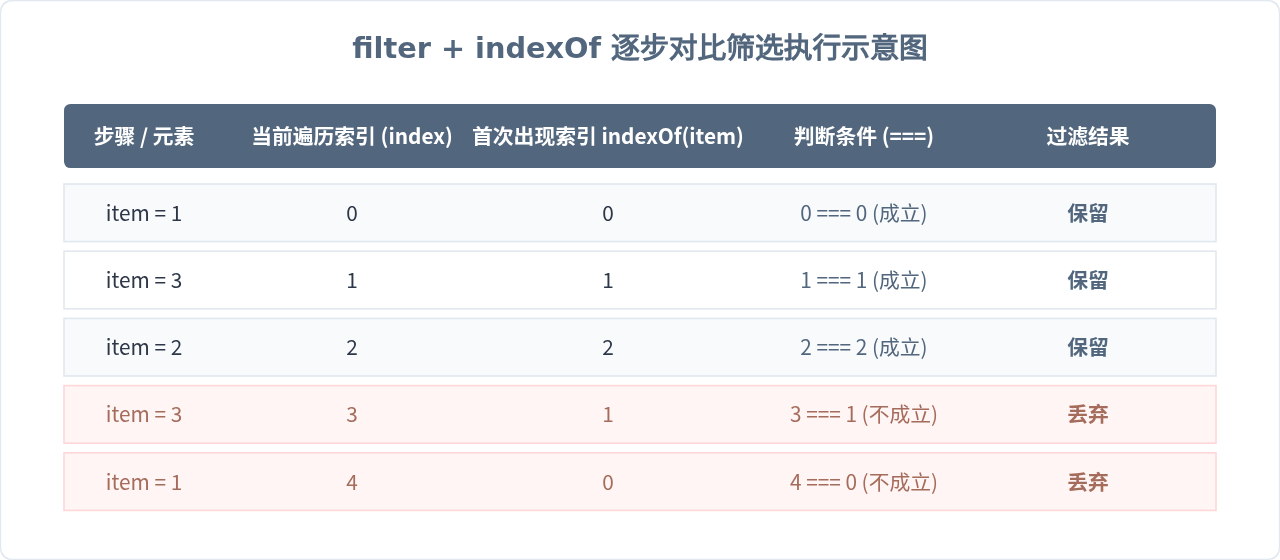
filter 内部每次执行都会调用一次 indexOf(整体属于嵌套循环遍历),其时间复杂度为 O(n²)。当数组规模达到上万条时,性能会明显下降。此外,indexOf 无法识别 NaN(arr.indexOf(NaN) 始终返回 -1),因此包含 NaN 的数组在使用此方法时会将所有 NaN 误判并过滤掉。
实例三:使用 reduce 与 includes 累加去重
reduce 是处理数组聚合与状态累加的强大工具。在去重场景中,我们可以把一个初始为空的数组作为累加器容器(accumulator),在迭代过程中通过 includes 检查累加器中是否已经包含当前元素。如果尚未包含,则追加进去;否则直接跳过。
// 方法 3:reduce 结合 includes
function uniqueWithReduce(arr) {
  return arr.reduce((acc, current) => {
    if (!acc.includes(current)) {
      acc.push(current);
    }
    return acc;
  }, []);
}

// 示例验证
const mixed = ['apple', 'banana', 'apple', 'orange', NaN, NaN];
const result = uniqueWithReduce(mixed);
console.log(result);
// 输出: ['apple', 'banana', 'orange', NaN]
机制与优势:
- 弥补 indexOf 的 NaN 缺陷:ES7 引入的
includes能够准确判断NaN的存在。因此相比实例二,reduce + includes不会丢失NaN。 - 利于扩展业务逻辑:使用
reduce的最大优势在于便于在去重过程中同步执行计数、格式转换或属性过滤等附加操作。 - 性能特征:与
indexOf类似,includes本身也是线性扫描,因此该方案的整体时间复杂度同样是O(n²)。
实例四:基于 Map 哈希映射的高效去重(适合大数据量与对象数组)
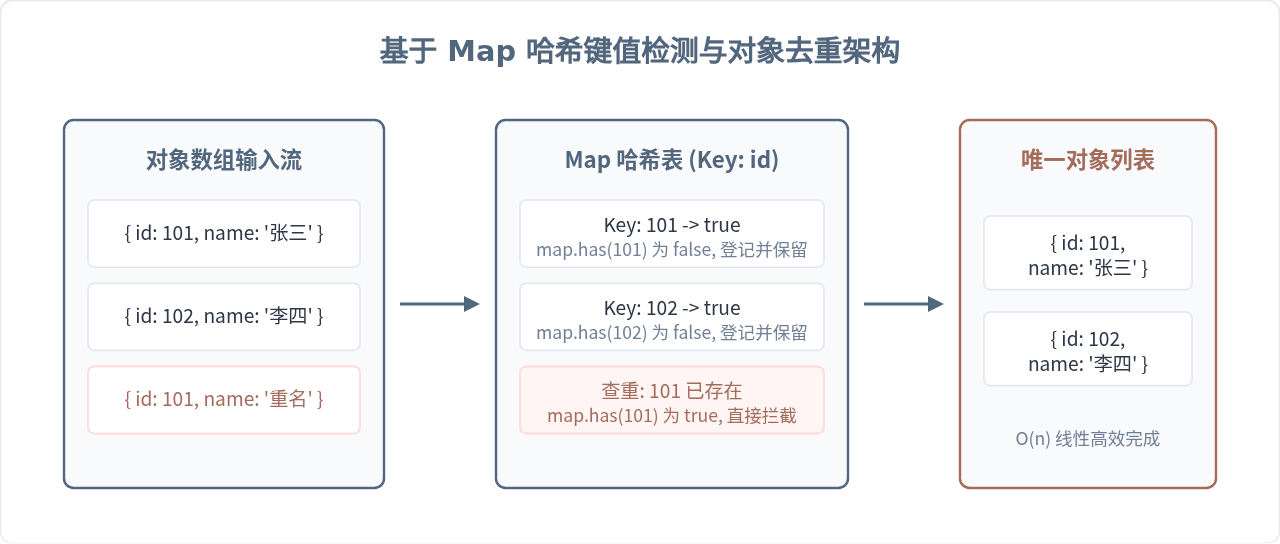
当处理大规模数据集,或者需要对“对象数组”按特定唯一属性(如 id)去重时,前面 O(n²) 的方法开销过大,而基础 Set 又无法对比对象内部属性。此时,借助 ES6 Map 的哈希查找特性(has 操作为 O(1))是兼顾性能与灵活性的最优解法。
// 方法 4.1:基础数据类型的 Map 高效去重
function uniqueWithMap(arr) {
  const map = new Map();
  return arr.filter(item => !map.has(item) && map.set(item, true));
}

// 方法 4.2:对象数组按指定字段 key 去重
function uniqueByKey(arr, key) {
  const map = new Map();
  return arr.filter(item => {
    const val = item[key];
    if (!map.has(val)) {
      map.set(val, true);
      return true;
    }
    return false;
  });
}

// 示例验证:对象数组根据 id 去重
const userList = [
  { id: 101, name: '张三' },
  { id: 102, name: '李四' },
  { id: 101, name: '张三(重复提交)' }
];
const uniqueUsers = uniqueByKey(userList, 'id');
console.log(uniqueUsers);
// 输出: [{ id: 101, name: '张三' }, { id: 102, name: '李四' }]
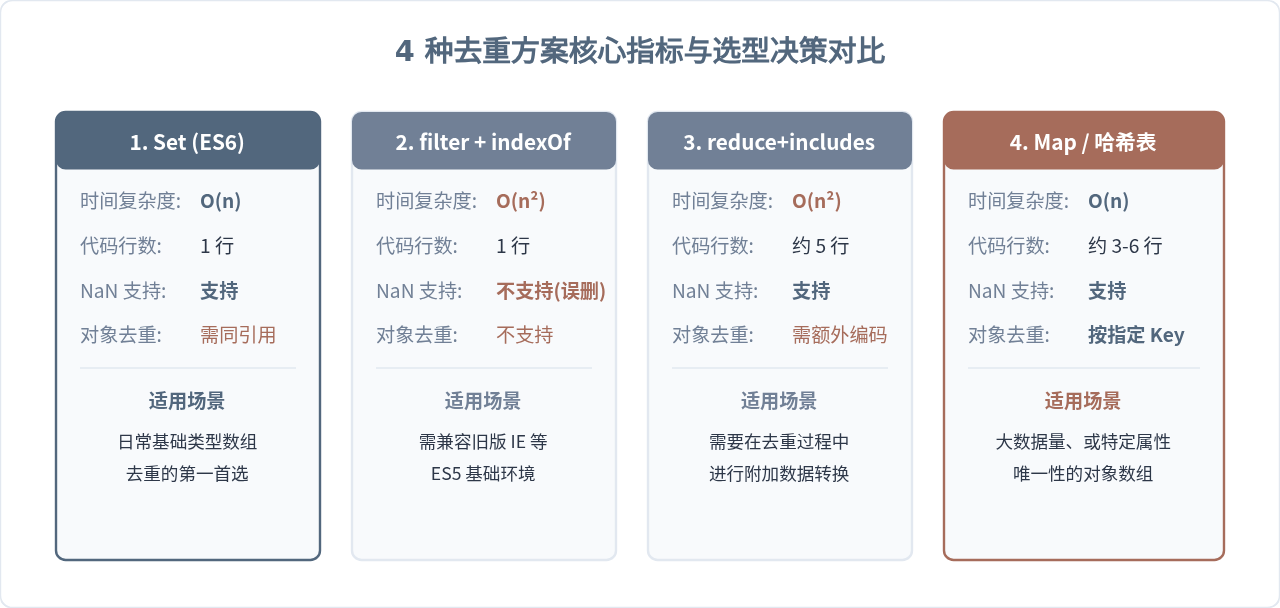
4 种实现方式横向对比与技术选型
为了让不同场景下的选型更加清晰,下表从代码复杂度、时间复杂度、特殊值兼容性及适用业务场景对这 4 种方案进行系统性总结:
总结建议
综合以上分析,针对实际业务开发提出两条简明建议:
- 常规基本类型数组(字符串、数字、布尔值等):毫不犹豫地优先选择
[...new Set(arr)]。语法极为精炼,语义清晰,且具备O(n)的优良性能与完善的现代浏览器支持。 - 业务实体对象数组(如用户列表、商品列表):优先推荐使用封装好的
uniqueByKey(arr, 'id')方案,基于Map维护唯一标识,不仅性能可靠,而且能精准控制业务主键的一致性。
JS大数值转字符串出现科学计数法怎么办
2026-11-05 17:09:21
JS split切割后出现空字符串怎么过滤
2026-11-05 16:00:30
在 React 或 Vue 项目中封装使用 JS 节流防抖
2026-11-05 15:27:29
JavaScript中怎么将带小数的字符串转为整数?
2026-11-05 14:32:38
怎么用JavaScript策略模式重构电商促销计算逻辑?
2026-11-05 14:01:09







