JavaScript数组处理实例:map、filter与reduce实战用法
深入讲解 JavaScript 中 map、filter 与 reduce 三大数组高阶函数的实战用法,通过具体代码实例、内部执行原理图解与链式调用管道设计,帮助开发者掌握声明式数据清洗与状态聚合技巧。
日常前端与 Node.js 业务开发中,大部分数据清洗、接口数据重构与状态计算本质上都是针对数组的操作。相比传统命令式的 for 循环,map、filter 与 reduce 提供了清晰的声明式语义。本文将以具体实际业务场景为切入点,逐一拆解这三个核心方法的内部流转机制、参数边界与经典实例,并展示如何通过管道式链式调用优雅地处理复杂结构。
一、核心特性速查与定位区分
虽然这三个方法都属于 Array.prototype 上的高阶遍历方法,且默认不会修改调用它们的原数组(返回新数组或新值),但在输入输出对应关系与语义设计上有严格的区别:
| 方法名称 | 核心语义 | 返回值特征 | 输入与输出数量关系 | 典型应用场景 |
|---|---|---|---|---|
map |
投射转换 | 全新数组,元素为每次回调返回值 | 恒等(输入 N 个,输出必为 N 个) | 接口字段重命名、单位换算、提取属性 |
filter |
条件筛选 | 全新数组,仅包含判定为真的元素 | 过滤收缩(输出 0 到 N 个元素) | 搜索过滤、空值剔除、状态鉴权筛选 |
reduce |
聚合累加 | 单一大对象、基础类型数值或集合 | 任意(折叠聚合为单一目标产物) | 求和求积、多维扁平化、分组分类(groupBy) |
二、map 实战:一对一映射与数据形态转换
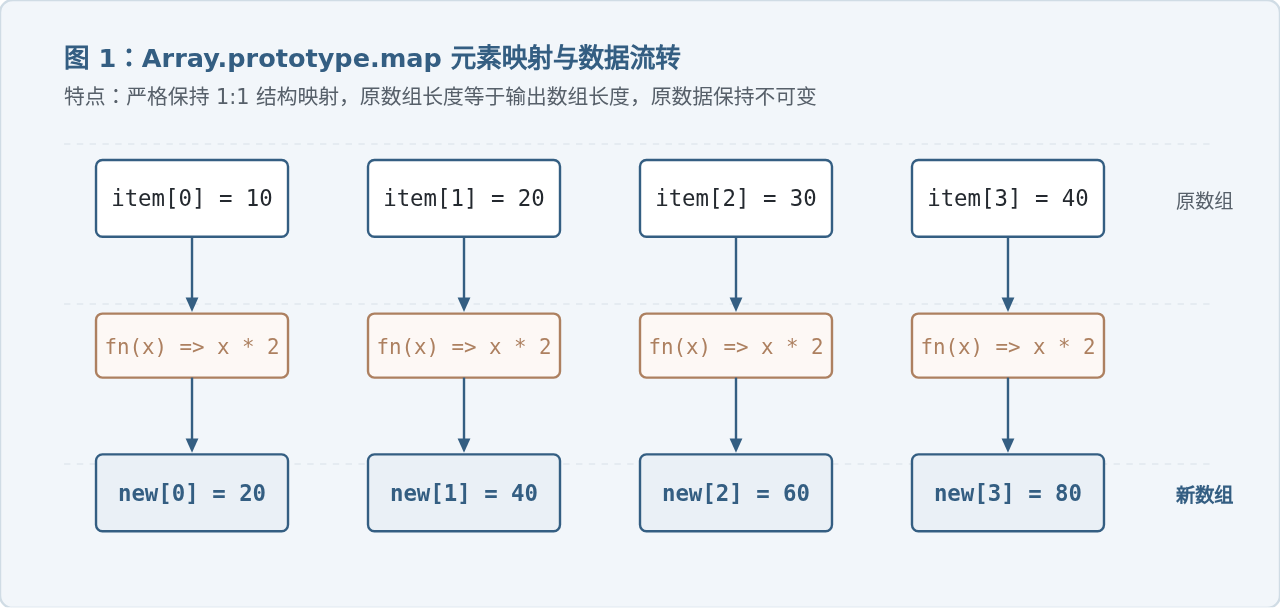
map 的核心目的是“转换”。它会按照顺序遍历原数组的每一个元素,将元素传入回调函数,并将该函数每次的返回值按顺序放入一个新的数组中返回。无论回调逻辑如何,新数组的长度必定与原数组一致。
1. map 内部流转推导
在映射过程中,原数组中的每个单元都独立经过回调函数 callback(item, index, array) 的加工,生成新数组对应槽位的元素。原数组在整个执行周期中保持只读不变。
2. 实战示例:重构后端接口返回的用户实体
真实场景中,后端返回的字段名往往与前端 UI 组件库规范(如 Select 组件需要的 label 和 value)不一致。利用 map 可以在极少代码量下完成解构与字段重塑:
// 原始服务端响应数据
const rawUsers = [
  { user_id: 101, first_name: "张", last_name: "三", is_vip: true },
  { user_id: 102, first_name: "李", last_name: "四", is_vip: false },
  { user_id: 103, first_name: "王", last_name: "五", is_vip: true }
];

// 使用 map 进行字段重组与衍生数据计算
const userOptions = rawUsers.map((user) => {
  return {
    value: user.user_id,
    label: `${user.first_name}${user.last_name}`,
    badge: user.is_vip ? "VIP会员" : "常规用户"
  };
});

// 输出示例:
// [
//   { value: 101, label: "张三", badge: "VIP会员" },
//   { value: 102, label: "李四", badge: "常规用户" },
//   { value: 103, label: "王五", badge: "VIP会员" }
// ]map 回调中直接修改原对象属性(如 user.first_name = 'xxx'),因为对象数组中的元素是引用传递,直接修改会破坏外部数据源。始终应当通过对象展开运算符 { ...user, newKey: val } 返回全新对象。另外,若不需要返回值,应使用 forEach 而非 map。
三、filter 实战:集合清洗与条件萃取
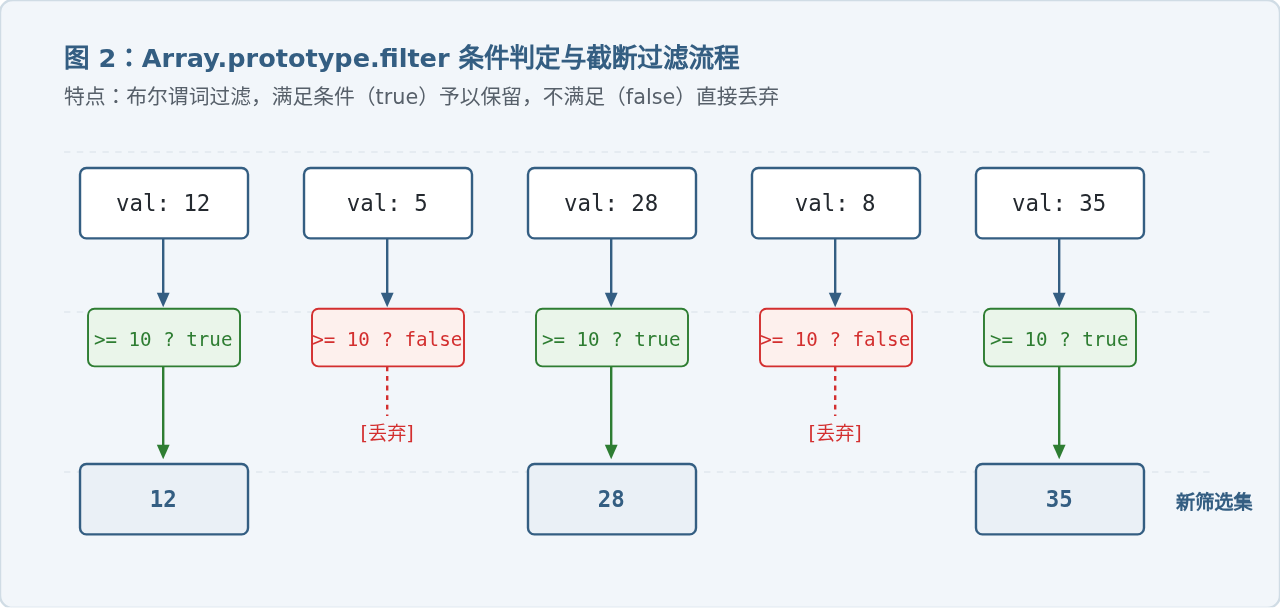
filter 用于从原数组中“挑选”满足特定条件的元素。它的回调函数需要返回一个布尔值(或可转换为布尔值的真假值):若返回 true,当前项被存入新数组;若返回 false,则被忽略跳过。
1. filter 条件断言流程
filter 不会改变原数组中被选中元素的内部数据,只会将通过谓词(Predicate)检查的元素浅拷贝存放到新集合中,输出数组的长度区间在 0 到 原数组长度 之间。
2. 实战示例:多条件搜索与脏数据清洗
在前端表格展示数据前,常需要剔除空对象、失效记录,或根据关键字实现即时检索:
const dataset = [
  { id: 1, title: "Vue3 组件封装指南", tags: ["frontend", "vue"], status: "published" },
  { id: 2, title: "草稿:Node 原理分析", tags: ["backend"], status: "draft" },
  { id: 3, title: "JavaScript 异步编程", tags: ["frontend", "es6"], status: "published" },
  { id: 4, title: null, tags: [], status: "archived" }
];

// 业务需求:过滤出已发布 (published)、标题非空,且包含 'frontend' 标签的文章
const publishedFrontendArticles = dataset.filter((article) => {
  const hasValidTitle = Boolean(article.title && article.title.trim());
  const isPublished = article.status === "published";
  const containsFrontendTag = article.tags.includes("frontend");

  return hasValidTitle && isPublished && containsFrontendTag;
});

// 输出示例:
// [
//   { id: 1, title: "Vue3 组件封装指南", tags: ["frontend", "vue"], status: "published" },
//   { id: 3, title: "JavaScript 异步编程", tags: ["frontend", "es6"], status: "published" }
// ]
另外,剔除数组中虚假值(如 0, false, null, undefined, "")的最简雅写法是直接传入构造函数:const cleanList = rawList.filter(Boolean);。
四、reduce 实战:累加折叠与复杂状态聚合
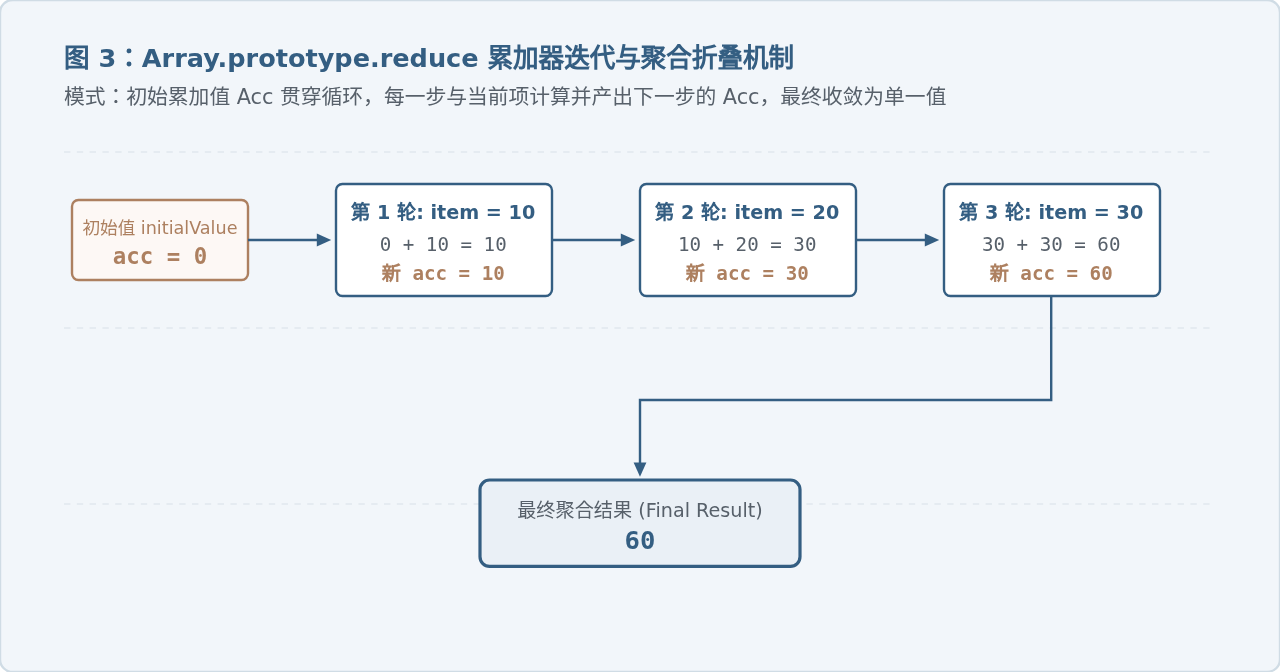
reduce 是数组中最强大且最容易被误解的方法。它的核心动作是“折叠”(Fold):接收一个累加器(Accumulator)和当前元素,在每次迭代中计算出新的累加器值,并传递给下一次迭代,最终将整个数组折叠为一个单一产物。
1. reduce 累加器迭代与聚合机制
理解 reduce 的关键在于明确“累加器”的状态流转。每次迭代的返回值都会作为下一次迭代的 accumulator 参数输入。
2. 实战示例 1:对元素集合进行分类分组(groupBy 模式)
虽然许多人仅用 reduce 来做数字累加,但它最强大之处在于折叠成对象。例如在原生未提供 Object.groupBy 的环境中,按部门对员工进行分组:
const staffList = [
  { name: "Alice", department: "Engineering", salary: 12000 },
  { name: "Bob", department: "Marketing", salary: 9000 },
  { name: "Charlie", department: "Engineering", salary: 15000 },
  { name: "David", department: "HR", salary: 8500 }
];

// 利用 reduce 将数组聚合为一个以 department 为键的对象
const groupedByDept = staffList.reduce((accumulator, staff) => {
  const key = staff.department;
  // 如果当前部门在累加器中尚未建立数组,先初始化空数组
  if (!accumulator[key]) {
    accumulator[key] = [];
  }
  accumulator[key].push(staff);
  return accumulator;
}, {}); // 注意:第二个参数传入空对象 {} 作为初始累加器

// 输出结构:
// {
//   Engineering: [ { name: "Alice", ... }, { name: "Charlie", ... } ],
//   Marketing: [ { name: "Bob", ... } ],
//   HR: [ { name: "David", ... } ]
// }
3. 实战示例 2:统计词频与频次分布表
const accessLogs = ["/home", "/goods", "/home", "/cart", "/goods", "/goods"];

const pageHits = accessLogs.reduce((acc, path) => {
  acc[path] = (acc[path] || 0) + 1;
  return acc;
}, {});

// 输出结果: { "/home": 2, "/goods": 3, "/cart": 1 }2. 一旦输入为空数组
[] 且未提供初始值时,JavaScript 运行时会直接抛出致命错误:TypeError: Reduce of empty array with no initial value。
五、实战贯通:链式调用构建数据清洗流水线
在工程实际业务中,单一方法往往难以应对综合性需求。由于 filter 和 map 均返回新的数组实例,我们能够以管道(Pipeline)的形式将它们串联,最后通过 reduce 收敛结果。
1. 电商订单多步计算场景
假定我们有一个电商购物车商品列表,业务计算目标为:
1. 过滤掉无库存(inStock === false)和已下架商品;
2. 针对有效商品,结合数量与单价计算小计金额,并折算折扣;
3. 统计这批有效商品的应付总金额。
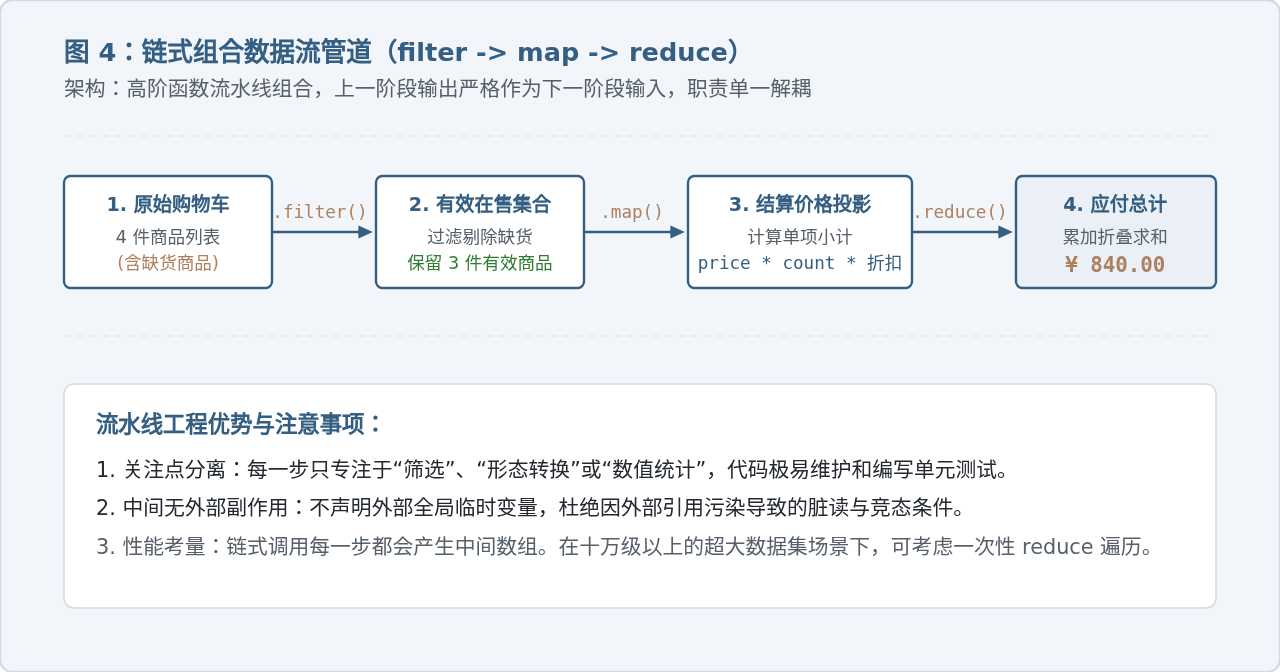
2. 链式调用代码实现
const cart = [
  { id: "A01", name: "机械键盘", price: 300, count: 1, discount: 0.9, inStock: true },
  { id: "A02", name: "无线鼠标", price: 120, count: 2, discount: 1.0, inStock: true },
  { id: "A03", name: "定制键帽", price: 80,  count: 3, discount: 0.8, inStock: false }, // 缺货
  { id: "A04", name: "超大桌垫", price: 50,  count: 2, discount: 1.0, inStock: true }
];

// 构建声明式计算管道
const totalPrice = cart
  // 步骤 1: 筛选有库存的商品
  .filter((item) => item.inStock)
  // 步骤 2: 将商品实体映射为其实际应付小计 (subtotal)
  .map((item) => item.price * item.count * item.discount)
  // 步骤 3: 累加所有小计
  .reduce((total, subtotal) => total + subtotal, 0);

console.log("最终支付金额:", totalPrice);
// 步骤 1 保留: A01, A02, A04
// 步骤 2 计算: [270, 240, 100]
// 步骤 3 累加: 0 + 270 + 240 + 100 = 610
六、避坑指南与最佳实践
-
坚持纯函数原则:传入
map、filter和reduce的回调函数应该尽量是纯函数(Pure Function)。避免在回调内部修改外部作用域的变量,或者直接修改当前传入的item对象引用。 -
注意
parseInt与map的经典陷阱:
执行['1', '2', '3'].map(parseInt)会得到[1, NaN, NaN]。原因在于map会向回调传递三个参数(element, index, array),而parseInt接收的第二个参数是进制基数(radix)。当把parseInt作为回调直接传入时,index(0、1、2)被当作进制传入,导致非法的二进制或非法格式。正确写法应显式指定参数:['1', '2', '3'].map((str) => parseInt(str, 10))或直接使用Number构造器:['1', '2', '3'].map(Number)。 -
中途跳出循环(Break/Early Return):这三个高阶函数不支持类似传统循环中的
break或continue。如果业务场景需要在满足某个条件时立刻中止遍历(例如查找首个匹配项),应选择find、findIndex或some/every,而不是强行用filter遍历整个长列表。 -
超长数组性能权衡:链式调用(如
filter().map().map())可读性极高,但每个链式节点都会遍历并分配一个完整的中间数组。当数组规模达到数十万量级时,应合并入单次reduce或直接使用for...of循环,以避免不必要的内存分配与垃圾回收压力。
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19
JS对象数组转字符串为什么推荐用JSON.stringify()
2026-11-05 09:40:31