

JavaScript数组常用方法清单:增删改查与遍历API详解
系统梳理 JavaScript 数组常用方法,按增、删、改、查与遍历五个维度全面解析,重点阐释原地修改与非破坏性 API 的机制差异、参数细节、代码实践及图解全景速查。
在日常 JavaScript 业务开发中,数据大多以数组(Array)形式组织与传递。熟练运用数组 API,核心在于准确区分“增、删、改、查、遍历”的适用场景,并清晰分辨哪些方法会“原地修改原数组”(Mutating),哪些方法会“返回全新数组”(Immutable)。本文系统拆解高频数组方法,提供参数规范、代码示例与图解速查清单。
一、核心基石:原地修改(In-Place)与非破坏性(Immutable)
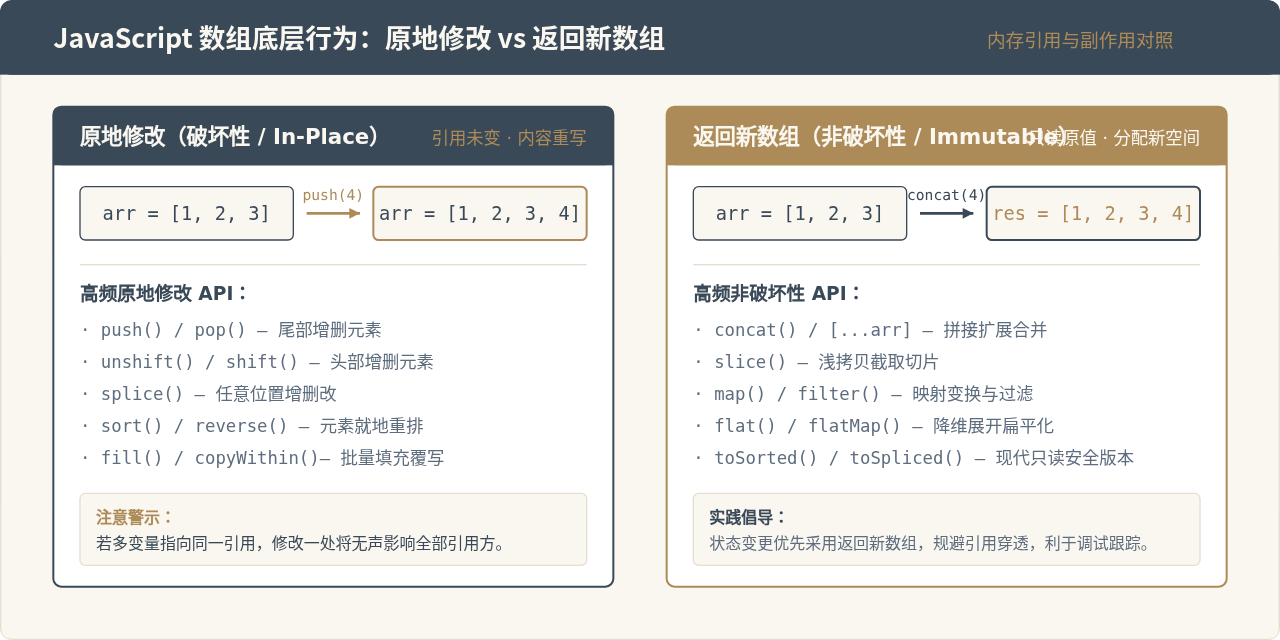
理解数组操作的第一道分水岭是内存行为。JavaScript 中的数组是引用类型(Reference Type)。当我们调用某一个方法时,有两种截然不同的操作机制:
-
原地修改(破坏性方法 / In-Place Mutation):直接覆写原数组底层内存中的元素序列。原数组长度与内容发生改变,但数组的内存引用地址保持不变。典型方法包括
push()、pop()、shift()、unshift()、splice()、sort()、reverse()。 -
非破坏性方法(纯函数式 / Pure & Immutable):读取原数组内容并计算,随后分配新的堆内存返回一个全新的数组对象,原始数组纹丝不动。典型方法包括
concat()、slice()、filter()、map()、flat(),以及 ES2023 引入的toSorted()、toReversed()、toSpliced()。
在现代前端框架(如 React、Vue 3)的状态管理中,非破坏性方法能有效避免意外的浅层副作用,并驱动单向数据流的正确响应。
二、增:向数组中添加元素的常用方法
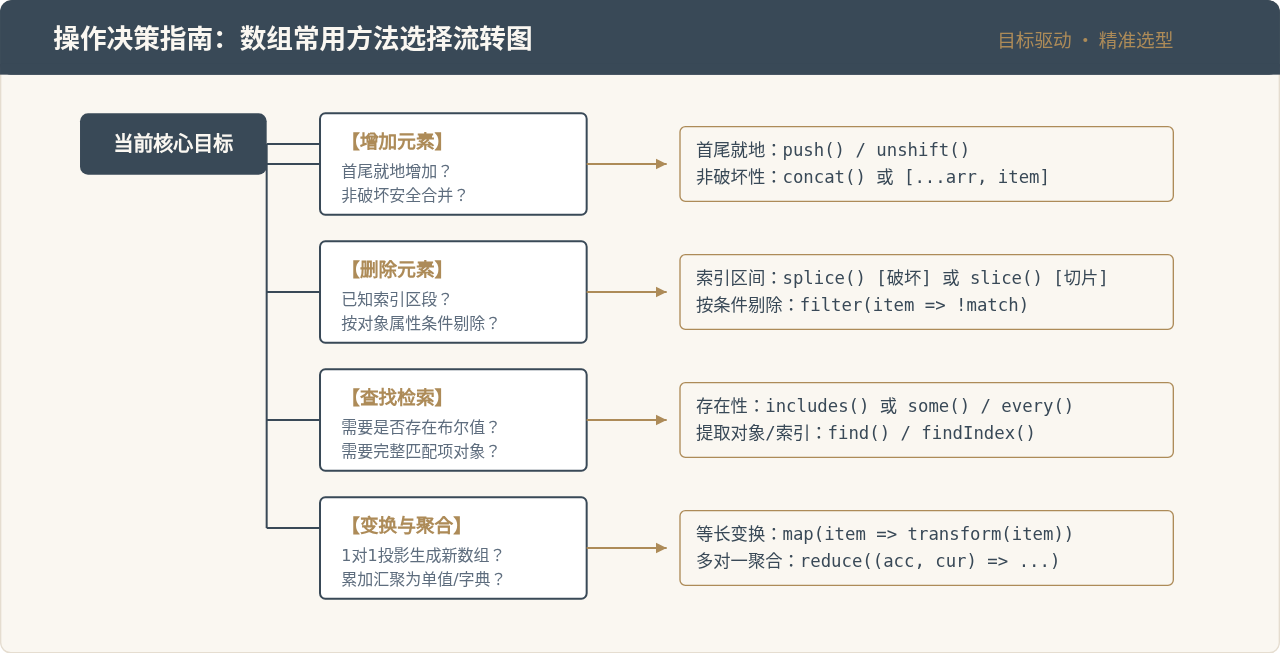
添加元素的核心选择在于:元素需要放在首部、尾部还是中间指定位置,以及是否允许改变原始数组。
1. push() 与 unshift()
push(...items) 将一个或多个元素追加至数组尾部,并返回操作后数组的最新长度。对应地,unshift(...items) 将一个或多个元素插入到数组头部,同样返回新长度。两函数均会原地修改原数组。
const fruits = ['apple', 'banana'];

// 尾部追加
const newLen = fruits.push('cherry', 'date');
console.log(newLen); // 输出示例: 4
console.log(fruits); // 输出示例: ['apple', 'banana', 'cherry', 'date']

// 头部插入
fruits.unshift('avocado');
console.log(fruits); // 输出示例: ['avocado', 'apple', 'banana', 'cherry', 'date']push() 在现代 V8 引擎中时间复杂度接近 O(1);而 unshift() 由于需要将已有全部索引向后平移,在超长数组场景下具有 O(n) 的开销。
2. concat() 与展开语法(Spread Syntax)
若希望安全地追加或合并元素,且不改变原数组,推荐使用 concat() 或 ES6 展开语法 [...arr]。
const base = [1, 2, 3];

// concat 合并
const mergedA = base.concat(4, [5, 6]);
console.log(mergedA); // 输出示例: [1, 2, 3, 4, 5, 6]
console.log(base);    // 输出示例: [1, 2, 3] (原数组保持不变)

// 展开语法 (目前最常用)
const mergedB = [0, ...base, 4];
console.log(mergedB); // 输出示例: [0, 1, 2, 3, 4]
三、删:从数组中剔除元素的常用方法
删除操作涵盖首尾删除、指定索引区段删除,以及基于条件判定剔除。
1. pop() 与 shift()
pop() 移除并返回数组的最后一个元素;若数组为空则返回 undefined。shift() 移除并返回数组的第一个元素。二者均为原地修改。
const stack = [10, 20, 30];
const last = stack.pop();
console.log(last);  // 输出示例: 30
console.log(stack); // 输出示例: [10, 20]

const queue = ['task1', 'task2'];
const first = queue.shift();
console.log(first); // 输出示例: 'task1'
console.log(queue); // 输出示例: ['task2']
2. splice() 与 slice() 的深层辨析
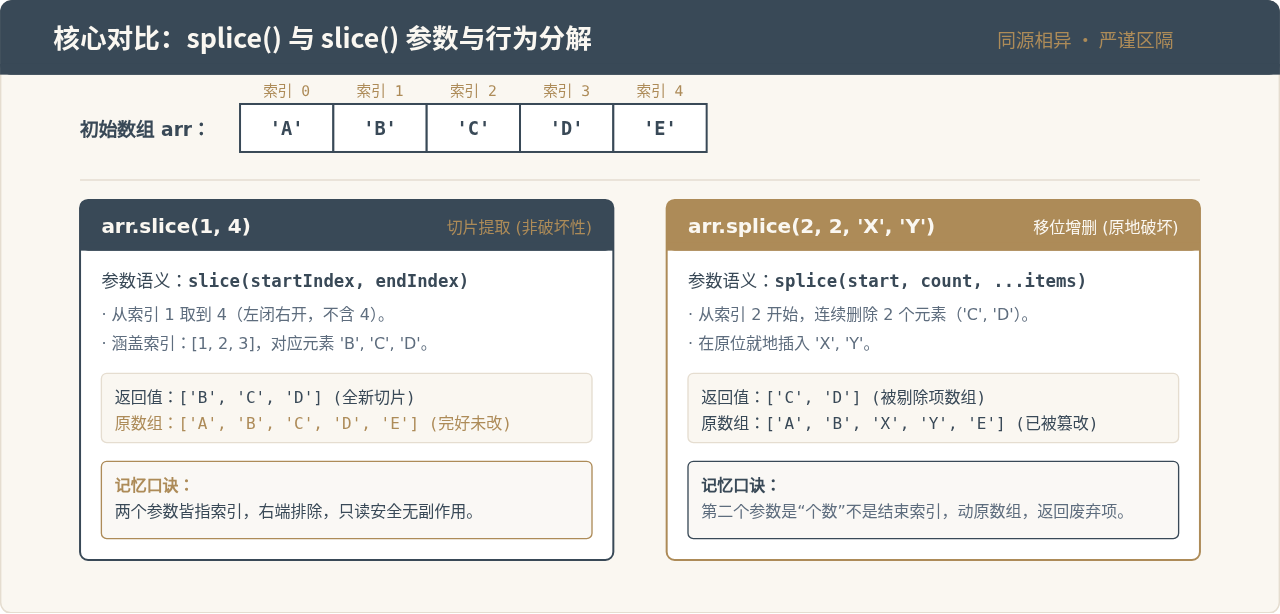
初学者极易混淆 splice() 与 slice()。核心区别可总结为:splice 是“就地开刀手术”,slice 是“切片复印备份”。
-
arr.splice(start, deleteCount, ...items):从start索引开始,删除指定数量的元素,并在该位置可选插入新元素。它会直接改变原数组,其返回值是被删除项构成的数组。 -
arr.slice(start, end):提取索引区间为[start, end)(左闭右开,不含 end)的元素切片。它完全不修改原数组,返回截取出的浅拷贝副本。
3. filter():条件驱动的纯函数删除
在大多数面向数据的业务逻辑中,我们并不清楚某项所在的具体索引,而是依据某个属性剔除(例如删除 id === targetId 的数据)。此时使用 filter() 最为自然规范。
const tasks = [
  { id: 101, name: '编写代码', done: true },
  { id: 102, name: '修复缺陷', done: false },
  { id: 103, name: '部署发布', done: false }
];

// 剔除已完成事项 (不破坏原 tasks 数组)
const remaining = tasks.filter(task => !task.done);
console.log(remaining.length); // 输出示例: 2
四、改:修改数组元素的常见方式
针对数组元素的变更操作,主要包含精确单点更新、区域批量填充,以及现代规范提供的非破坏性替换。
1. 索引直接赋值与 splice() 替换
最原始的修改方式是利用下标访问:arr[index] = newValue,该方式同样属于原地更新。而 splice(index, 1, newValue) 则是在原地删除 1 项的同时插入新值,能同步获得被替换掉的原项。
2. 批量填充:fill() 与 copyWithin()
fill(value, start, end) 用于将一个固定值填充到数组指定范围区间,常用于初始化指定长度的填充数组:
// 快速生成 5 个默认值的数组
const zeros = new Array(5).fill(0);
console.log(zeros); // 输出示例: [0, 0, 0, 0, 0]
3. 现代规范安全更新:toSpliced() 与 with()
ECMAScript 2023(ES14)正式增加了“Change Array by Copy”系列 API,直接解决了过去必须手动深浅拷贝才能进行不可变修改的痛点:
arr.with(index, value):返回一个在index位置替换为value的新数组,不改动原数组。arr.toSpliced(start, deleteCount, ...items):语法与splice()一致,但原地不发生变更,直接返回处理后的新数组。
const origin = ['Vue', 'React', 'Angular'];

// 使用 with 进行安全更新
const updated = origin.with(2, 'Svelte');
console.log(origin);  // 输出示例: ['Vue', 'React', 'Angular']
console.log(updated); // 输出示例: ['Vue', 'React', 'Svelte']
五、查:定位、检索与条件断言 API
查找元素是逻辑分支判断的核心。JavaScript 提供了由简单字面匹配到复杂谓词判断的全套 API。
1. 基础值检索:indexOf() 与 includes()
indexOf(searchElement, fromIndex):返回首个匹配项的索引,若无匹配则返回-1。底层采用严格全等(===),无法定位NaN。includes(searchElement, fromIndex):返回布尔值(true或false)。遵循 SameValueZero 规范,可准确判断NaN是否存在。
2. 谓词检索:find()、findIndex()、findLast() 与 findLastIndex()
当目标是对象或需要按动态表达式查找时,需传入测试回调函数 (item, index, array) => boolean:
const users = [
  { id: 1, role: 'user', score: 85 },
  { id: 2, role: 'admin', score: 92 },
  { id: 3, role: 'admin', score: 76 }
];

// 查找首个满足条件的元素对象
const firstAdmin = users.find(u => u.role === 'admin');
console.log(firstAdmin.id); // 输出示例: 2

// 查找最后一个满足条件的索引 (ES2023 引入)
const lastAdminIdx = users.findLastIndex(u => u.role === 'admin');
console.log(lastAdminIdx);  // 输出示例: 2
3. 全局断言:some() 与 every()
当仅需要确认“是否存在某个满足项”或“是否全量达标”时,使用短路断言方法效率最高:
some():只要数组中有至少 1 个元素满足条件,即刻终止遍历并返回true;全部不满足才返回false。every():只要发现有 1 个元素不满足条件,即刻短路返回false;所有元素均通过测试才返回true。
六、遍历与高阶聚合:现代开发主力 API
在以声明式编程为主流的当下,命令式的 for 循环逐渐退居性能极端敏感场景,而 forEach、map、reduce 与 flatMap 构成了集合处理的中枢。
1. forEach() 与 map() 的本质区别
forEach(callback):纯粹的副作用驱动。它遍历每一项并执行逻辑,但始终返回undefined,无法链式调用。map(callback):标准的等长投影变换。它将每个元素经由回调计算后的返回值聚集成一个长度完全一致的新数组返回。
const nums = [1, 2, 3];

// 错误做法:试图用 forEach 产生新数组并赋值
const badResult = nums.forEach(x => x * 2);
console.log(badResult); // 输出示例: undefined

// 正确做法:使用 map 产出投影数据
const doubled = nums.map(x => x * 2);
console.log(doubled);   // 输出示例: [2, 4, 6]
2. reduce():全能型归约聚合
reduce(callback, initialValue) 是灵活性最高的数组方法。其回调签名是 (accumulator, currentValue, index, array)。无论是求和、统计频次还是按属性将数组归组为对象(分组 Grouping),均可胜任:
const cart = [
  { item: '键盘', price: 299, count: 1 },
  { item: '鼠标', price: 99, count: 2 },
  { item: '连接线', price: 29, count: 3 }
];

// 计算购物车总金额
const totalPrice = cart.reduce((sum, product) => {
  return sum + product.price * product.count;
}, 0);

console.log(totalPrice); // 输出示例: 584reduce() 时务必显式传入第二个参数 initialValue。如果省略,数组首项将作为初始累计值,并从索引 1 开始迭代;若在空数组上调用且未传初始值,将直接抛出 TypeError: Reduce of empty array with no initial value 运行时异常。
3. flat() 与 flatMap():矩阵与嵌套数组解构
当数据结构存在多重嵌套层级时:
flat(depth):按照指定的深度展开子数组,默认depth = 1;如需无限拍平,可传入Infinity。flatMap(callback):相当于先对每项执行map()映射,再对结果执行深度为 1 的flat()拍平,执行性能优于分别调用两函数。
七、全景速查矩阵与工程最佳实践
为了便于在日常编写与代码审查时快速核对,下表将全部高频数组 API 按功能分类,整理其返回值类型及是否修改原数组:
| 分类 | API 方法 | 原地修改 (Mutates) | 返回值类型 | 典型适用场景 |
|---|---|---|---|---|
| 增 | push() / unshift() |
是 | number (最新数组长度) |
快速在队尾/队首注入数据 |
concat() / [...spread] |
否 | Array (新数组) |
只读追加合并,框架状态派生 | |
| 删 | pop() / shift() |
是 | any (被弹出的元素) |
模拟堆栈(LIFO)与队列(FIFO) |
splice() |
是 | Array (被删除项列表) |
根据明确索引进行区段切除或插桩 | |
slice() / filter() |
否 | Array (新数组) |
分页截取、条件过滤剔除 | |
| 改 | fill() / sort() / reverse() |
是 | Array (原数组本身) |
矩阵初始化重置、元素物理排序 |
with() / toSorted() |
否 (ES2023) | Array (新数组) |
非破坏性单点更新、纯函数排序 | |
| 查 | indexOf() / includes() |
否 | number / boolean |
字面量原始值定位与包含判断 |
find() / findIndex() |
否 | any / number |
对象数组的谓词条件检索 | |
| 遍历/聚合 | forEach() |
否 (只读遍历) | undefined |
遍历打印、触发外部接口调用 |
map() / reduce() |
否 | Array / any |
数据结构清洗转换、多维指标统计 |
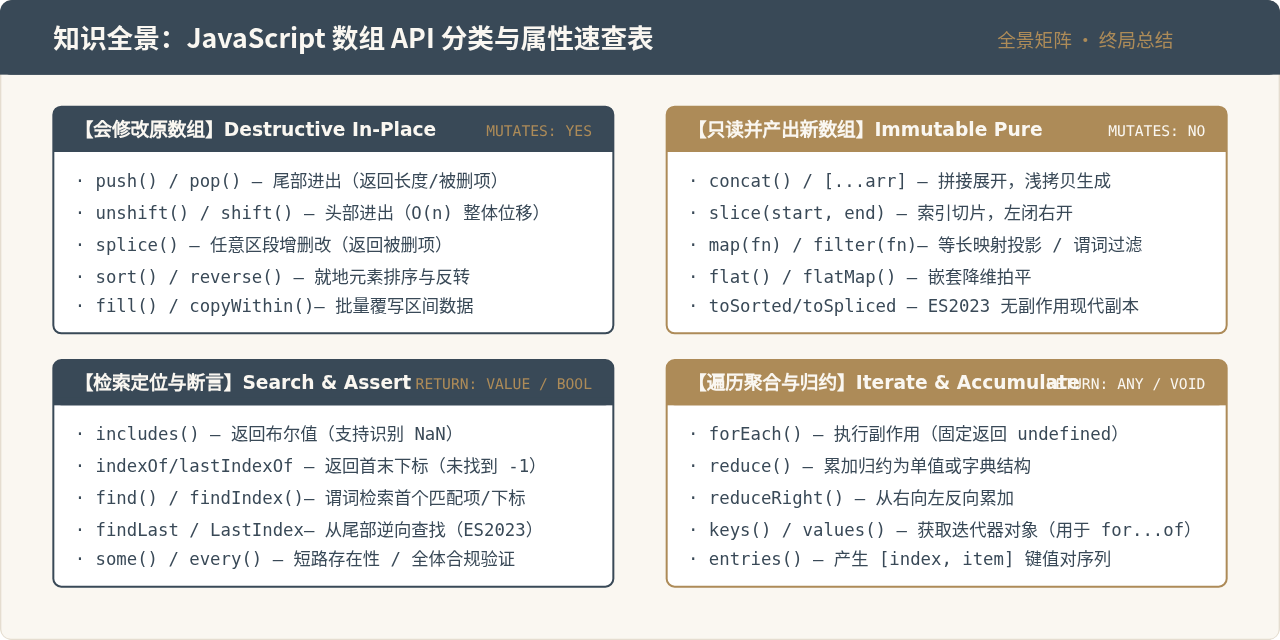
- 优先保证不可变性:在状态管理与核心业务流程中,优先采用
filter、map、slice、[...spread]以及 ES2023 的toSorted()、toSpliced(),从源头消灭对象引用意外串扰。 - 精准选取检索方法:只判断是否存在用
includes()或some();提取具体实体用find();避免用filter()[0]模拟查找,后者无法提前短路退出,存在全量扫描的性能浪费。 - 善用链式管道:合理串联
arr.filter(...).map(...),保持每一层只做单一维度的清晰转换,兼顾代码的可读性与健壮性。
JS大数值转字符串出现科学计数法怎么办
2026-11-05 17:09:21
JS split切割后出现空字符串怎么过滤
2026-11-05 16:00:30
在 React 或 Vue 项目中封装使用 JS 节流防抖
2026-11-05 15:27:29
JavaScript中怎么将带小数的字符串转为整数?
2026-11-05 14:32:38
怎么用JavaScript策略模式重构电商促销计算逻辑?
2026-11-05 14:01:09







