

JavaScript中Unicode字符串转换为UTF-8编码的实现原理与方法
本文详细解析JavaScript中Unicode字符串转换为UTF-8编码的原理。通过手动实现字节补码逻辑,展示英文字符'A'和汉字'中'的转换过程,并对比使用encodeURI/encodeURIComponent等内置方法的简便性,帮助开发者理解底层编码机制及实际应用。
JavaScript与UTF-8编码基础
JavaScript的字符集基础
JavaScript程序是基于Unicode字符集编写的。Unicode作为ASCII和Latin-1的超集,支持全球几乎所有语言。根据ECMAScript3规范,JavaScript必须支持Unicode2.1及更高版本;而ECMAScript5则要求支持Unicode3及后续版本。因此,所有JavaScript程序内部均使用Unicode进行编码处理。
JavaScript程序,都是使用Unicode编码的。
UTF-8编码简介
UTF-8(UTF8-bit Unicode Transformation Format)是一种针对Unicode的可变长度字符编码方案,属于前缀码。
它能够表示Unicode标准中的任何字符,且其编码中的第一个字节与ASCII兼容。这意味着原有处理ASCII字符的软件无需或只需少量修改即可继续使用。因此,UTF-8逐渐成为电子邮件、网页及其他存储或发送文字应用中的首选编码方式。
目前大部分的网站,都是使用的UTF-8编码。
Unicode转UTF-8的应用场景
应用场景:Unicode转UTF-8
如标题所述,这种应用场景十分常见。例如,当向服务器发送二进制数据时,若服务器规定该二进制内容的编码必须为UTF-8,则必须通过程序将JavaScript生成的Unicode字符串转换为UTF-8编码字符串。
手动实现Unicode转UTF-8编码
转换方法概述
在转换之前,我们必须了解Unicode的编码结构是固定的。
可以通过String的charCodeAt方法验证,观察返回的charCode所占字节数。
英文字符占1个字符,汉字占2个字符。
然而,UTF-8的编码结构长度是根据单个字符的大小来决定占用多少字节。
下面列出了单个字符大小占用的字节数,单个Unicode字符编码后的最大长度为6个字节。
•1个字节:Unicode码为0 - 127 •2个字节:Unicode码为128 - 2047 •3个字节:Unicode码为2048 - 0xFFFF •4个字节:Unicode码为65536 - 0x1FFFFF •5个字节:Unicode码为0x200000 - 0x3FFFFFF •6个字节:Unicode码为0x4000000 - 0x7FFFFFFF
具体请看图片:
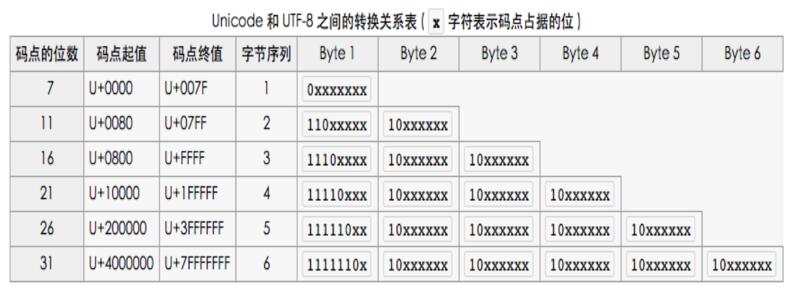
因为英文字符的Unicode码为0 - 127,所以英文在Unicode和UTF-8中的长度和字节数一致,只占用1个字节。这也解释了为什么UTF-8是Unicode的超集。
现在我们再来讨论汉字,因为汉字的Unicode码区间为0x2e80 - 0x9fff,所以汉字在UTF-8中的长度最长为3个字节。
那么汉字是如何从Unicode的2个字节转换为UTF-8的三个字节的呢?
假设我需要把汉字"中"转为UTF-8的编码
1、获取汉字Unicode值大小
var str = '中';
var charCode = str.charCodeAt(0);
console.log(charCode); // => 20013
2、根据大小判断UTF-8的长度
由上一步我们得到汉字"中"的charCode为20013。然后我们发现20013位于2048 - 0xFFFF这个区间里,所以汉字"中"应该在UTF-8中占3个字节。
3、补码处理
既然知道汉字"中"需要占3个字节,那么这3个字节如何得到呢?
这就需要涉及到补码,具体补码逻辑如下:
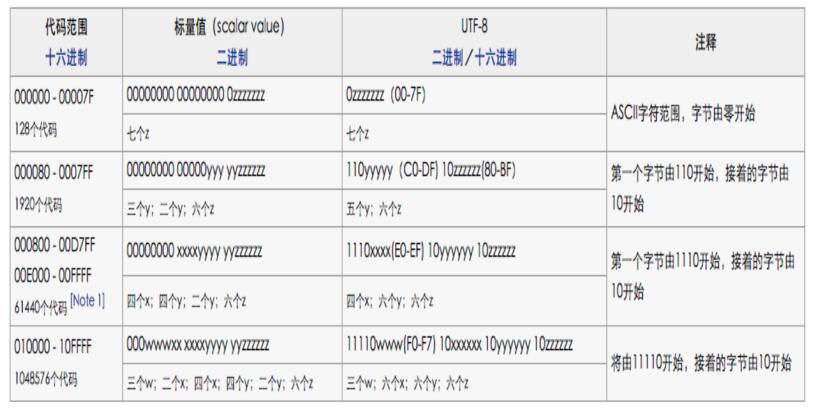
好吧,我知道这个图你们也看不明白,还是我来讲吧!
具体的补位码如下,"x"表示空位,用来补位的。
•0xxxxxxx •110xxxxx 10xxxxxx •1110xxxx 10xxxxxx 10xxxxxx •11110xxx 10xxxxxx 10xxxxxx 10xxxxxx •111110xx 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx •1111110x 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx
warning:有没有发现?补位码第一个字节前面有几个1就表示整个UTF-8编码占多少个字节!UTF-8解码为Unicode就是利用的这个特点哦~
我们先举个简单的例子。把英文字母"A"转为UTF-8编码。
1、“A”的charCode为65 2、65位于0-127的区间,所以“A”占一个字节 3、UTF-8中一个字节的补位为0xxxxxxx,x表示的是空位,是用来补位的。 4、将65转为二进制得到1000001 5、将1000001按照从前到后的顺序,依次补到1xxxxxxx的空位中,得到01000001 6、将11000001转为字符串,得到"A" 7、最终,"A"为UTF-8编码之后“A”
通过这个小例子,我们是否再次验证了UTF-8是Unicode的超集!
好了,我们现在再回到汉字"中"上,之前我们已经得到了"中"的charCode为20013,二进制为01001110 00101101。具体如下:
var code = 20013;
code.toString(2);
// => 100111000101101 等同于 01001110 00101101
然后,我们按照上面“A”补位的方法,来给"中"补位。 将01001110 00101101按照从前到后的顺序依次补位到1110xxxx 10xxxxxx 10xxxxxx上,得到11100100 10111000 10101101。
4、得到UTF-8编码的内容
通过上面的步骤,我们得到了"中"的三个UTF-8字节,11100100 10111000 10101101。
我们将每个字节转为16进制,得到0xE4 0xB8 0xAD; 那么这个0xE4 0xB8 0xAD就是我们最终得到的UTF-8编码了。
我们使用nodejs的buffer来验证一下是否正确。
var buffer = new Buffer('中');
console.log(buffer.length); // => 3
console.log(buffer); // => <Buffer e4 b8 ad>
// 最终得到三个字节 0xe4 0xb8 0xad
因为16进制是不分大小写的,所以是不是跟我们算出来0xE4 0xB8 0xAD一模一样。
将上面的编码逻辑写到一个函数中。
// 将字符串格式化为UTF8编码的字节
var writeUTF = function (str, isGetBytes) {
   var back = [];
   var byteSize = 0;
   for (var i = 0; i < str.length; i++) {
     var code = str.charCodeAt(i);
     if (0x00 <= code && code <= 0x7f) {
        byteSize += 1;
        back.push(code);
     } else if (0x80 <= code && code <= 0x7ff) {
        byteSize += 2;
        back.push((192 | (31 & (code >> 6))));
        back.push((128 | (63 & code)))
     } else if ((0x800 <= code && code <= 0xd7ff)
         || (0xe000 <= code && code <= 0xffff)) {
        byteSize += 3;
        back.push((224 | (15 & (code >> 12))));
        back.push((128 | (63 & (code >> 6))));
        back.push((128 | (63 & code)))
     }
    }
    for (i = 0; i < back.length; i++) {
      back[i] &= 0xff;
    }
    if (isGetBytes) {
      return back
    }
    if (byteSize <= 0xff) {
      return [0, byteSize].concat(back);
    } else {
      return [byteSize >> 8, byteSize & 0xff].concat(back);
    }
}

writeUTF('中'); // => [0, 3, 228, 184, 173]
// 前两位表示后面utf8字节的长度。因为长度为3,所以前两个字节为`0,3`
// 内容为`228, 184, 173`转成16进制就是`0xE4 0xB8 0xAD`
// 读取UTF8编码的字节,并专为Unicode的字符串
var readUTF = function (arr) {
  if (typeof arr === 'string') {
    return arr;
  }
  var UTF = '', _arr = this.init(arr);
  for (var i = 0; i < _arr.length; i++) {
    var one = _arr[i].toString(2),
        v = one.match(/^1+?(?=0)/);
    if (v && one.length == 8) {
      var bytesLength = v[0].length;
      var store = _arr[i].toString(2).slice(7 - bytesLength);
      for (var st = 1; st < bytesLength; st++) {
        store += _arr[st + i].toString(2).slice(2)
      }
      UTF += String.fromCharCode(parseInt(store, 2));
      i += bytesLength - 1
    } else {
      UTF += String.fromCharCode(_arr[i])
    }
  }
  return UTF
}

readUTF([0, 3, 228, 184, 173]); => '中'
使用encodeURI简化UTF-8转换
另外一种将中文解析得到UTF-8字节码的方法
另外一种比较简单的将中文转为UTF-8字节码的方法比较简单,浏览器也提供了一个方法,而且这个方法大家都一直在用,是什么呢?就是encodeURI。当然,encodeURIComponent也是可以的。
没错,就是这个方法。那么这个方法是怎么将一个Unicode编码的中文转为UTF-8的字节码呢?
var str = '中';

var code = encodeURI(str);

console.log(code); // => %E4%B8%AD
有没有发现得到了一个转义后的字符串,而且这个字符串中的内容和我之前在上面得到的字节码是一样的~~~。
下面我们将%E4%B8%AD转为一个number数组。
var codeList = code.split('%');

codeList = codeList.map(item => parseInt(item,16));

console.log(codeList); // => [228, 184, 173]
如此简单,有木有~~~
这个简便方法的原理是什么?
这里就涉及到的URI中的querystring编码的问题了。因为按照规定,URI中的querystring必须按照UTF-8的编码进行传输,而JavaScript是Unicode的,所以浏览器就给我们提供了一个方法,也就是encodeURI/encodeURIComponent方法。这个方法会将 非英文字符(这里考虑下,为什么是非英文字符?)先转为UTF-8的字节码,然后前面加个%进行拼接,所以我们将汉字"中"转义下便得到了"%E4%B8%AD"。
好吧,原理就这些,没有其他的了。
不过,这种方法还有个缺点,那就是只会转义非英文字符,所以当我们需要将英文字符也格式化为UTF-8编码时,这个方法是达不到我们需求的,我们还需要额外的将英文字符也给转义下。
那我想要解析回来应该怎么做呢?用decodeURI/decodeURIComponent就可以了。
var codeList = [228, 184, 173];

var code = codeList.map(item => '%'+item.toString(16)).join('');

decodeURI(code); // => 中
好了,到这里本文也就介绍完UTF-8的编码了。 希望可以帮助大家了解到UTF-8编码的原理。
以上就是小编为大家带来的通过javascript进行UTF-8编码的实现方法全部内容了,希望大家多多支持本站~
JS转整数出现NaN怎么办?常见异常处理方案
2026-11-05 16:27:31
推荐几款免安装的在线JS压缩工具
2026-11-05 14:54:53
JS怎么使用JSON.stringify实现JSON格式化与缩进
2026-11-04 10:47:30
CodePen、JSFiddle 与 StackBlitz:主流 JS 在线编辑器对比
2026-11-03 21:07:49
JS字符串转数字后怎么正确判断是否为有效数值
2026-11-03 20:04:15