

JavaScript正则表达式解析URL的技巧
本文深入解析JavaScript中正则表达式如何用于URL解析,重点讲解捕获型与非捕获型分组的区别。通过拆解parse_url正则表达式,展示如何提取协议、主机、端口、路径及查询参数,帮助开发者理解分组机制并编写更简洁的正则代码。
正则表达式与URL解析概述
正则表达式本质上是用于描述字符模式的一个对象。
本文并非直接提供现成的URL正则表达式及其使用方法,因为网络上此类资源已十分丰富。文章的核心目的是引导读者理解URL正则表达式的构成原理,从而掌握正则表达式的逻辑,以便在未来工作中能够编写出相对简洁的正则表达式。
var parse_url = /^(?:([A-Za-z]+):)?(\/{0,3})([0-9.\-A-Za-z]+)(?::(\d+))?(?:\/([^?#]*))?(?:\?([^#]*))?(?:#(.*))?$/;
var parse_url = /^(?:([A-Za-z]+):)?(\/{,})([-.\-A-Za-z]+)(?::(\d+))?(?:\/([^?#]*))?(?:\?([^#]*))?(?:#(.*))?$/;
 var url = "http://qiji.kerlai.net:/GoodsBasic/Operate/?q#simen";
 var result = parse_url.exec(url);
 var names = ["url","scheme","slash","host","port","path","query","hash"];
 for(var i=; i <names.length;i++){
  console.log(names[i]+":"+result[i]);
 }
 //输出结果
 /*
 url:http://qiji.kerlai.net:/GoodsBasic/Operate/?q#simen
 scheme:http
 slash://
 host:qiji.kerlai.net
 port:
 path:GoodsBasic/Operate/
 query:q
 hash:simen
 */
首先观察以下示例的运行结果:
url:http://qiji123.kerlai.net:81/GoodsBasic/Operate/12678?q#simen scheme:http slash:// host:qiji123.kerlai.net port:81 path:GoodsBasic/Operate/12678 query:q hash:simen
在代码中,result数组包含的元素为['http://qiji123.kerlai.net:81/GoodsBasic/Operate/12678?q#simen','http', '//', 'qiji123.kerlai.net', '81', 'GoodsBasic/Operate/12678', 'q', 'simen']。
正则表达式的分组机制
若尝试将result数组中从第二个元素到最后一个元素依次拼接,得到的字符串为"http // qiji123.kerlai.net 81 GoodsBasic/Operate/12678 q simen"。与原URL相比,该字符串缺失了":?#"等连接符。造成这一现象的原因在于正则表达式中的分组概念。正则表达式包含四种分组类型:捕获型、非捕获型、向前正向匹配和向前负向匹配。此处重点介绍前两种,后两种建议读者自行查阅资料。非捕获型分组的内容不会出现在结果数组中,而由括号()包围的部分构成一个组,会占用结果数组的一个位置。反之,若正则表达式中未使用括号包裹,则匹配到的字符不会出现在exec()方法返回的数组中。正则表达式的分组即通过()括起来的部分。
1、捕获型分组:(...)
2、非捕获型分组:(?: .......)
3、向前正向匹配:(?=........)
4、向前负向匹配:(?!.........)
parse_url正则表达式详解
接下来对parse_url正则表达式进行分解,首先分析第一个分组。
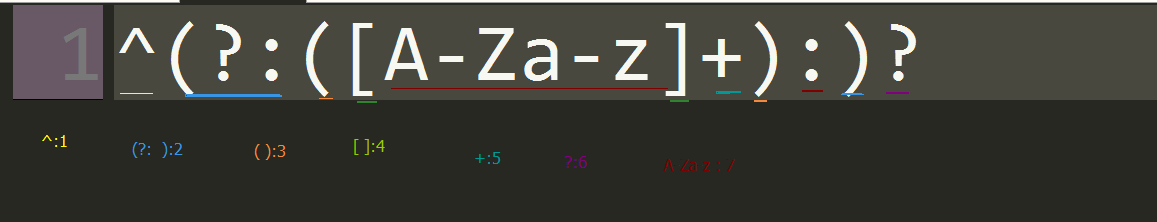
1、^符号表示字符串的开始位置。
整个正则因子用于匹配协议名称,例如http。
2、(?: )表示一个非捕获型分组:即在该括号内但不在其子括号内匹配到的字符,不会放入结果数组中。
3、()表示一个捕获型分组,此括号内匹配到的字符将放入结果数组中,对应URL中的:http字符。
4、[]表示正则表达式类,代表符合中括号内任一一个字符。
7、A-Za-z表示字母A到Z以及a到z的范围。[A-Za-z]表示匹配符合字母A到Z或a到z的任一一个字符。
5、+表示匹配1次或多次。
6、?表示此组为可选匹配条件。
第二个正则因子:(\/{0,3})://
这是一个捕获型分组,\/表示需要匹配的/字符,{0,3}表示\/将被匹配0次或者1到3次之间。
([0-9.\-A-Za-z]+):qiji123.kerlai.net
这是一个捕获型分组,由一个或多个数字、"."、"\-"(转义为"-")、字母A到Z和a到z组成。
(?::(\d+))?:81
前置部分放在非捕获型分组中将不会出现在返回数组中,\d表示匹配数字。整个因子用于匹配前置为:后面跟随一个或多个数字的情况。此分组因子为可选的。
(?:\/([^?#]*))?:GoodsBasic/Operate/12678
该分组以/开始,^在此处表示非的意思,即除?#之外的所有字符,最后一个?表示此正则因子分组可选。
(?:\?([^#]*))? :q
该分组表示包含0个或多个非#字符。
(?:#(.*))?:simen
该分组以#开始,(.)将匹配除结束符以外的所有字符。
$表示这个字符串结束。
至此,URL的所有分组分析完毕。接下来大家可以尝试编写电话号码的正则表达式:既能匹配固定电话又能匹配手机号(这个会用到新的字符:|)。
| 字符 | 含意 |
| \ |
做为转意,即通常在"\"后面的字符不按原来意义解释,如/b/匹配字符"b",当b前面加了反斜杆后/\b/,转意为匹配一个单词的边界。 -或- |
| ^ | 匹配一个输入或一行的开头,/^a/匹配"an A",而不匹配"An a" |
| $ | 匹配一个输入或一行的结尾,/a$/匹配"An a",而不匹配"an A" |
| * | 匹配前面元字符0次或多次,/ba*/将匹配b,ba,baa,baaa |
| + | 匹配前面元字符1次或多次,/ba*/将匹配ba,baa,baaa |
| ? | 匹配前面元字符0次或1次,/ba*/将匹配b,ba |
| (x) | 匹配x保存x在名为$1...$9的变量中 |
| x|y | 匹配x或y |
| {n} | 精确匹配n次 |
| {n,} | 匹配n次以上 |
| {n,m} | 匹配n-m次 |
| [xyz] | 字符集(character set),匹配这个集合中的任一一个字符(或元字符) |
| [^xyz] | 不匹配这个集合中的任何一个字符 |
| [\b] | 匹配一个退格符 |
| \b | 匹配一个单词的边界 |
| \B | 匹配一个单词的非边界 |
| \cX | 这儿,X是一个控制符,/\cM/匹配Ctrl-M |
| \d | 匹配一个字数字符,/\d/ = /[0-9]/ |
| \D | 匹配一个非字数字符,/\D/ = /[^0-9]/ |
| \n | 匹配一个换行符 |
| \r | 匹配一个回车符 |
| \s | 匹配一个空白字符,包括\n,\r,\f,\t,\v等 |
| \S | 匹配一个非空白字符,等于/[^\n\f\r\t\v]/ |
| \t | 匹配一个制表符 |
| \v | 匹配一个重直制表符 |
| \w | 匹配一个可以组成单词的字符(alphanumeric,这是我的意译,含数字),包括下划线,如[\w]匹配"$5.98"中的5,等于[a-zA-Z0-9] |
| \W | 匹配一个不可以组成单词的字符,如[\W]匹配"$5.98"中的$,等于[^a-zA-Z0-9]。 |
|
用re = new RegExp("pattern",["flags"]) 的方式比较好 pattern : 正则表达式 flags: g (全文查找出现的所有 pattern) i (忽略大小写) m (多行查找) |
vaScript动态正则表达式问题 请问正则表达式可以动态生成吗? 例如JavaScript中: var str = "strTemp"; 要生成: var re = /strTemp/; 如果是字符连接: var re = "/" + str + "/"即可 |
怎么用 Promise 封装 JavaScript sleep 函数实现异步延时
2026-11-05 17:49:14
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02