

JavaScript 正则表达式创建、属性与方法详解
本文详细介绍JavaScript中正则表达式的两种创建方式及g、i、m标识含义。深入解析RegExp实例的source、global等属性,以及test和exec方法的返回值结构。同时讲解构造函数静态属性如$1、lastMatch的用法,并对比贪婪匹配与懒惰匹配的行为差异。
前言
正则表达式是JavaScript中极为重要且高频使用的功能,在jQuery等大型前端框架中应用广泛。近期整理并学习了相关知识点,特此记录并与需要的朋友分享。
思维导图
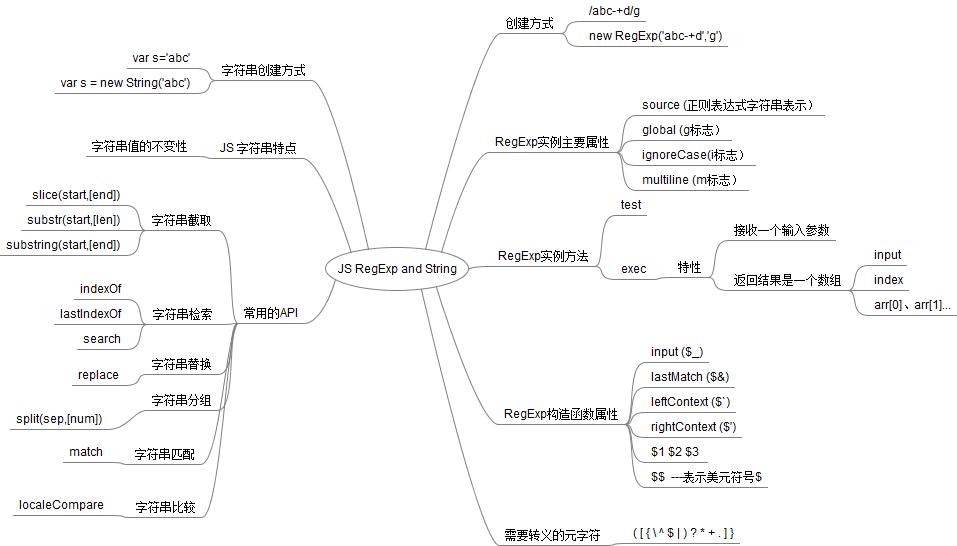
正则表达式的创建方式与标识
RegExp(正则表达式)的创建方式
在JavaScript中,可以通过两种主要方式来创建RegExp对象,具体方法如下:
第一种方式是通过字面量 /…./ 创建正则表达式(注意:字面量两侧不包含单引号或双引号)。第二种方式是通过RegExp构造函数来创建。为了更精确地描述匹配模式,正则表达式提供了三个修饰符标识:g、i、m。
g:全局匹配,即在字符串中查找所有匹配项,而非找到第一个匹配后停止。i:忽略大小写进行匹配。m:多行模式,使得行首^和行末$特殊字符能针对多行字符串中的每一行生效。具体用法可参考下方代码示例以加深理解:
var regx = new RegExp('are','g');
var regx1 = /are/g;  //常用的创建方式
RegExp实例属性与方法
RegExp实例的主要属性
根据RegExp的构造函数,我们可以推测出RegExp实例包含的主要属性。了解这些实例属性即可,但需注意一点:这些实例属性无法通过for...in循环进行遍历获取。
可参照下面代码加深理解:
var regx1 = /are/g; //常用的创建方式
console.log("source:"+regx.source +" global:"+regx.global+" ignoreCase:"+regx.ignoreCase +" multiline:"+regx.multiline);
// source:are global:true ignoreCase:false multiline:false

for(var p in regx) { //不会进入该for循环
 if(regx.hasOwnProperty(p)) {
 console.log(regx[p]);
 }
}
RegExp实例的主要方法 - test
该方法实现简单,仅接收一个参数,常用于验证输入字符串是否与正则表达式模式匹配。若匹配成功返回true,否则返回false。具体用法可参考下方代码示例:
var regx1 = /are/g;
var res = regx.test('you are a good boy!');
console.log(res) ; //true
var res1 = regx.test('I am a good boy!');
 console.log(res1) ; //false
exec方法详解
RegExp实例的主要方法 - exec
exec方法是一个使用频率极高且需要深入理解的方法。它只接收一个参数,即待匹配的字符串,但返回值是一个数组arr。该数组存储了第一个匹配项的详细信息,包括:
input:原始输入字符串,即exec方法的参数值。
index:匹配项在原始字符串中的起始位置索引。
arr[0]:包含与正则表达式模式完全匹配的字符串部分。
arr[1]…arr[n]:分别存储第n个捕获组(括号内内容)匹配的字符串。
使用该方法时需注意:若正则表达式未指定全局标志g,每次执行exec始终返回第一个匹配项的信息;若指定了全局标志g,每次调用exec会在字符串中继续查找并返回下一个新的匹配项。
可参照下面代码加深理解:
 var regx = /fn:(\w+)\s+ln:(\w+)\s/g;
 var s ="your fn:xiaoxin ln:tang right?";
 var result = regx.exec(s);
 console.log(result.input); //your fn:xiaoxin ln:tang right?
 console.log(result.index); //5
 console.log(result[0]); //fn:xiaoxin ln:tang
 console.log(result[1]); //xiaoxin
 console.log(result[2]); //tang
 console.log(result[3]); //undefined 因为只有2个捕获组,所以打印undefined
RegExp构造函数属性
RegExp构造函数属性
这些属性可类比Java等语言中类的静态属性来理解。它们被所有RegExp实例共享,即所有RegExp对象均可访问和修改这些属性。当某个实例执行test或exec方法时,这些构造函数属性的值也会随之动态变化。
关于这些属性,我们可以按照以下逻辑进行记忆:
input:需要进行模式匹配的原始字符串,即test或exec方法的输入参数。参数别名:$-。lastMatch:最近一次匹配到的完整字符串。参数别名:$&。leftContext:匹配项左侧的字符串部分。参数别名:$`。rightContext:匹配项右侧的字符串部分。参数别名:$'。1,2,$3…:对应正则表达式中捕获组的字符串内容。
当然,这些值完全可以通过RegExp实例执行exec返回的结果数组计算得到。那么,为什么还要在构造函数RegExp中单独设置这些属性呢?
可参照下面代码加深理解:
var regx = /fn:(\w+)\s+ln:(\w+)\s/g;
var s ="your fn:xiaoxin ln:tang right?";
var result = regx.exec(s);
console.log(RegExp.input); //your fn:xiaoxin ln:tang right?
console.log(RegExp.lastMatch); //fn:xiaoxin ln:tang
console.log(RegExp.leftContext); //your
console.log(RegExp.rightContext); //right?
console.log(RegExp.$1); //xiaoxin
console.log(RegExp.$2); //tang
元字符与匹配模式
RegExp - 元字符
与其他语言中的正则表达式类似,JavaScript正则表达式中也包含一些具有特殊用途和含义的元字符。因此在使用时,必须对这些字符进行转义处理,即在字符前加上'\'。JavaScript正则表达式中常见的元字符包括:
( [ { \ ^ $ | ) ? * + . ] }
RegExp - 贪婪匹配和懒惰匹配
贪婪匹配是指在正则表达式的匹配过程中,默认情况下会尽可能长地匹配字符串。在JS正则表达式中,懒惰限定符是‘?',在模式末尾添加‘?'则要求采用懒惰匹配(尽可能短地匹配)。具体行为可参照下方代码来理解:
var s = 'I am a good boy,you are also a good boy !';
var regx = /good.*boy/g; //贪婪匹配
console.log(regx.exec(s)[0]); //good boy,you are also a good boy
var regx1 = /good.*?boy/g; //懒惰匹配
console.log(regx1.exec(s)[0]); //good boy
以上内容是小编给大家分享的javascript正则表达式和字符串RegExp and String(一),下篇文章给大家分享javascript正则表达式和字符串RegExp and String(二)希望大家喜欢。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38