

基于jQuery的HTML元素数据去重实现
作者:小圆点时间:2026-10-28 16:46:06浏览:583
本文介绍如何利用jQuery脚本对网页中的特定HTML元素进行数据去重处理。通过遍历指定类名的元素集合,提取文本内容并进行两两比对,当发现重复文本时自动移除后续出现的重复节点。该方法适用于需要在前端快速清理重复显示内容的场景,代码简洁且易于集成到现有项目中。
jQuery实现HTML元素去重逻辑
项目具体需求如附图所示:
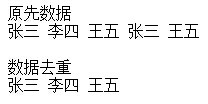
实现该功能的代码逻辑如下:
具体代码实现如下:
<!DOCTYPE html>
<html xmlns="http://www.w3.org/1999/xhtml">
<head>
<script src="jquery.js"></script>
<script type="text/javascript">
$(function(){
var divArea = $(".drop");
$.each(divArea , function () {
var Dtxid = $(this).text();
var count = 0;
$.each(divArea , function () {
var Xtxid = $(this).text();
if (Dtxid == Xtxid) {
count = count + 1;
if (count >= 2) {
$(this).remove();
                            }
                    }
                })
            })
    });
</script>
</head>
<body>
<div>原先数据</div>
<div>
<span>张三</span>
<span>李四</span>
<span>王五</span>
<span>张三</span>
<span>王五</span>
</div>
<br/>
<div>数据去重</div>
<div>
<span class="drop">张三</span>
<span class="drop">李四</span>
<span class="drop">王五</span>
<span class="drop">张三</span>
<span class="drop">王五</span>
</div>
</body>
</html>
实现过程相对直观,有类似需求的技术人员可参考此示例。需注意,此处仅展示基础逻辑,实际投入生产环境使用时,建议根据具体业务场景补充必要的健壮性处理与边界条件检查。
作者最新文章
JS在setTimeout或Ajax回调中打开新标签页失败怎么处理
2026-11-05 15:50:12
JS直播协议选型:HLS、FLV与WebRTC的延迟与兼容性对比
2026-11-05 12:16:14
JS实现回到顶部:scrollTop赋值与浏览器兼容性处理
2026-11-04 23:43:35
JS使用classList动态添加、移除和切换CSS类名
2026-11-04 23:40:58
在 D3.js 中实现平滑过渡动画的技巧
2026-11-03 23:46:09